
Die GPT-Live-1.1 API ist OpenAIs Vollduplex-Sprachmodell, bereitgestellt über v1/live/sessions. Sie öffnen eine Sitzung über WebRTC, WebSocket oder SIP, senden eine session-Konfiguration mit Modell, Anweisungen und Stimme und lassen das Modell Reasoning und Tool-Aufrufe durch Delegation an ein Backend-Responses-Modell übergeben. Es kostet 0,05 $ pro aktiver Minute und 0,02 $ pro Standby-Minute.
OpenAI hat GPT-Live-1.1 am 20. November 2026 in der API verfügbar gemacht, wie aus der Ankündigung der OpenAI Developers hervorgeht. Wer unsere Juli-Berichterstattung gelesen hat, erinnert sich: Gibt es eine GPT-Live-API? lautete die Antwort „noch nicht“. Das hat sich geändert. Dieser Leitfaden führt Sie durch eine funktionierende Sitzung, eine Delegationskonfiguration, ein Function Tool und eine Testumgebung für das Backend, das Ihr Sprachagent aufruft.
Was ist die GPT-Live-1.1 API?
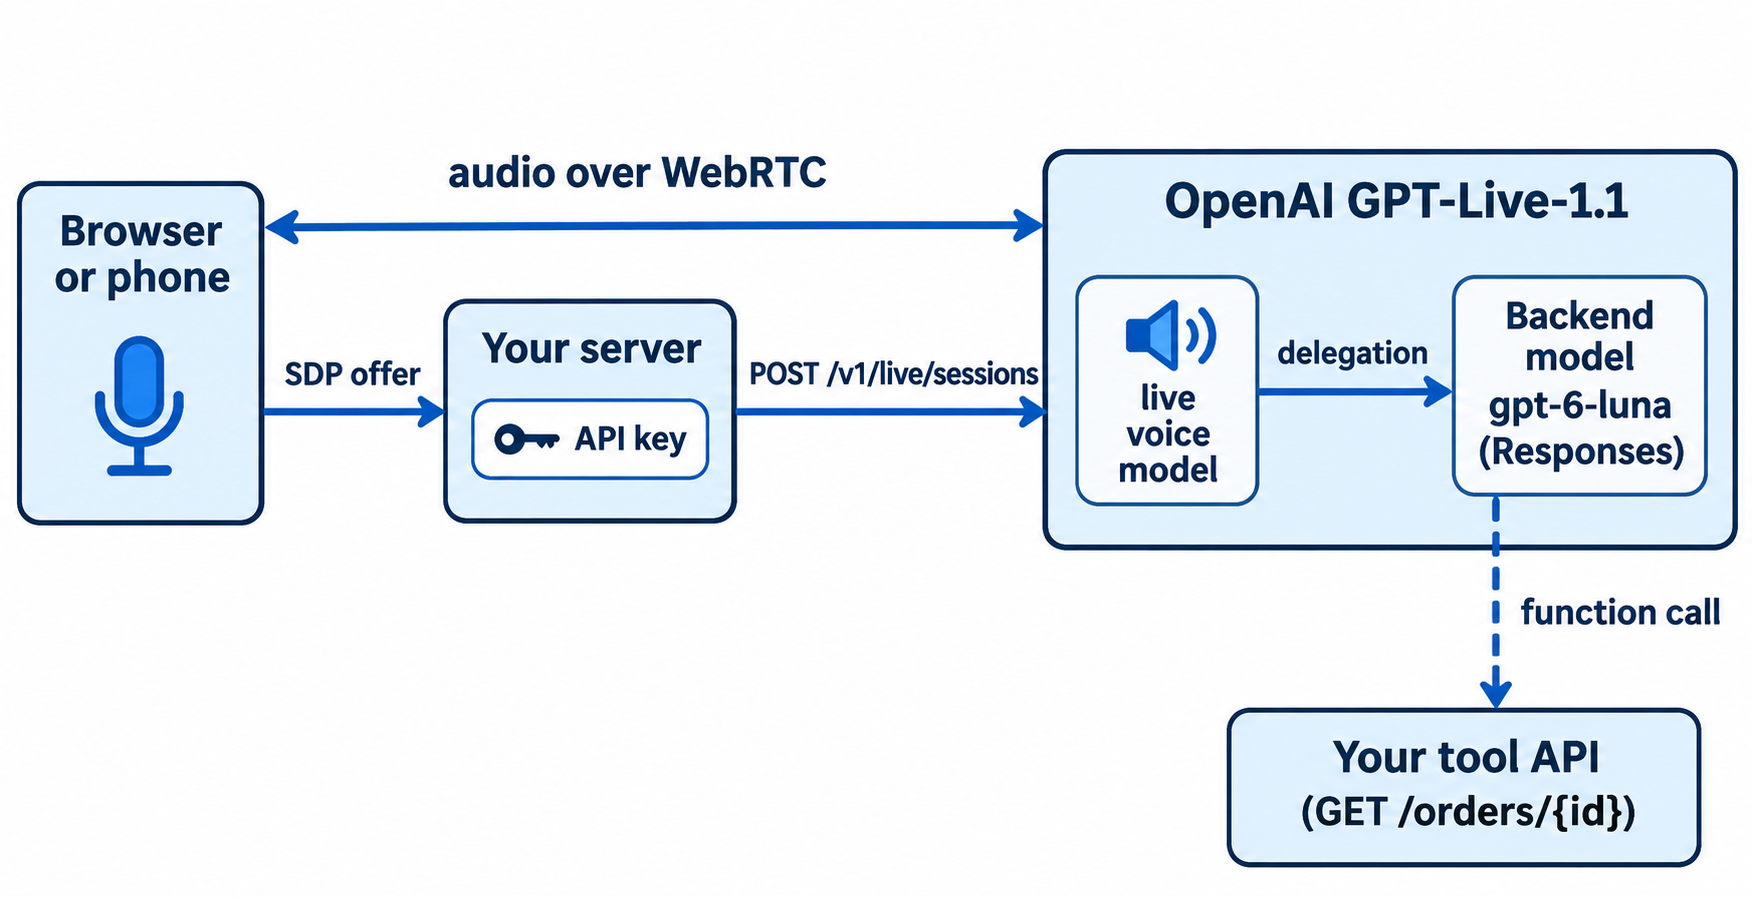
GPT-Live-1.1 ist ein Speech-in-Speech-out-Modell, das zuhört, während es spricht. Es läuft auf dem Endpunkt v1/live/sessions, nicht auf v1/realtime oder v1/responses. Seine eigentliche Aufgabe ist das Gespräch. Aufwändigeres Reasoning und Tool-Nutzung werden an ein von Ihnen konfiguriertes Backend-Modell delegiert, sodass die Stimme reaktionsschnell bleibt, während die Arbeit im Hintergrund läuft.
Dies führt die GPT-Live-1.1-Modellseite derzeit auf:
| Element | GPT-Live-1.1 |
|---|---|
| Modell-ID | gpt-live-1.1 (ein Snapshot) |
| Eingabe / Ausgabe | Audio und Text rein, Audio und Text raus |
| Endpunkt | nur v1/live/sessions |
| Transporte | WebRTC (empfohlen), WebSocket, SIP |
| Aktiver Preis | 0,05 $ pro Minute |
| Standby-Preis | 0,02 $ pro Minute (WebRTC, Inferenz pausiert) |
| Backend-Modell und Tools | Separat zu den üblichen Tarifen abgerechnet |
| Parallelität | Separates Limit gegenüber GPT-Live-1, pro Organisation |
Für den produktbezogenen Hintergrund lesen Sie was GPT-Live ist und wie es sich von GPT Realtime unterscheidet.
GPT-Live-1.1 vs. GPT-Live-1: Was hat sich geändert
Die Modellseite und der Prompting-Leitfaden nennen vier praktische Unterschiede:
- Transkription: 1.1 „transkribiert Sprache genauer“.
- Stimme: 1.1 bewahrt „eine konsistentere Betonung und Stimme über Sprachen hinweg“.
- Delegations-Prompts: 1.1 akzeptiert normale Sprache („Delegate to the backend when:“). GPT-Live-1 benötigt den
<|SpawnThinking|>-Marker in seiner Policy. - Abrechnungsformulierung: GPT-Live-1 wird pro Sekunde abgerechnet und nie auf eine ganze Minute aufgerundet. Die 1.1-Seite sagt nur „billed by duration“.
Beide Modelle teilen sich denselben Endpunkt, dieselben Preise und dieselbe Sitzungsstruktur, daher besteht der Umstieg auf 1.1 hauptsächlich aus einer Modell-String-Änderung plus einem sauberen Prompt.
So öffnen Sie eine GPT-Live-1.1-Sitzung
Der GPT-Live-Einstiegsleitfaden empfiehlt WebRTC für Browser-, Mobil- und Server-Audio. WebSocket ist der einfachere Weg für ein serverseitiges Prototyp-Setup, also beginnen wir damit:
- Öffnen Sie
wss://api.openai.com/v1/live/sessionsmitAuthorization: Bearer $OPENAI_API_KEYund ohne Query-Parameter. - Senden Sie
session.startals erste Nachricht, mit Ihrersession-Konfiguration. - Warten Sie auf
session.started, bevor Sie Audio senden. - Streamen Sie Audio im gewählten Format. Der Standard ist 24 kHz PCM.
import WebSocket from "ws";

const ws = new WebSocket("wss://api.openai.com/v1/live/sessions", {
  headers: { Authorization: `Bearer ${process.env.OPENAI_API_KEY}` },
});

ws.on("open", () => {
  ws.send(JSON.stringify({
    type: "session.start",
    event_id: "start_1",
    session: {
      model: "gpt-live-1.1",
      instructions: "You are the voice agent for Acme order support. Keep answers short.",
      audio: {
        format: { type: "audio/pcm", rate: 24000 },
        output: { voice: "marin" },
      },
    },
  }));
});

ws.on("message", (raw) => {
  const msg = JSON.parse(raw);
  if (msg.type === "session.started") console.log("Session ready");
});
Ein paar Konfigurationsregeln aus dem Gesprächsleitfaden:
instructionserlaubt bis zu 16.384 Tokens. Fügen Sie mitten in der Sitzung mehr hinzu mitsession.instructions.append(500 Tokens pro Anhang).audio.output.voiceist standardmäßigmarin. Weitere API-Namen sindquartz,stone,meridianundwillow.- WebSocket-Formate sind
audio/pcmbei 24.000 oder 16.000 Hz sowieaudio/pcmuoderaudio/pcmabei 8.000 Hz für Telefonie. storeist standardmäßigfalse. Eine Änderung vonmodelerfordert eine neue Sitzung.
Für den Produktiveinsatz im Browser wechseln Sie zu WebRTC. Ihr Server hält den API-Schlüssel und leitet das SDP-Angebot des Browsers weiter:
const res = await fetch("https://api.openai.com/v1/live/sessions", {
  method: "POST",
  headers: {
    Authorization: `Bearer ${process.env.OPENAI_API_KEY}`,
    "Content-Type": "application/json",
  },
  body: JSON.stringify({
    session: { model: "gpt-live-1.1", instructions: "..." },
    transport: { type: "webrtc", sdp: offerSdp },
  }),
});
const { session, transport } = await res.json(); // HTTP 201
// session.id looks like "live_123"; return transport.sdp to the browser
Lassen Sie audio.format bei WebRTC-Anfragen weg und senden Sie session.start nicht auf dem Data-Channel. Beachten Sie ein Abrechnungsdetail: Das Erstellen einer WebRTC-Sitzung wird während der Initialisierung mit 15 Sekunden abgerechnet, was gutgeschrieben wird, sobald die Sitzung läuft.
GPT-Live-1.1-Delegation: Lassen Sie ein Backend-Modell das Denken übernehmen
Delegation ist der Grund, warum diese API existiert. Das Sprachmodell spricht weiter, während ein Backend-Modell nachdenkt, sucht oder Tools aufruft. Sie wählen einen von zwei Modi bei der Sitzungserstellung, und ein Moduswechsel mitten in der Sitzung ist nicht möglich.
| Modus | delegation.type |
Wer betreibt das Backend | Am besten für |
|---|---|---|---|
| Responses | "responses" |
OpenAI, mit dem von Ihnen konfigurierten Modell und Tools | Die meisten Apps; gehostete Tools, Function Calling |
| Client | "client" (auch der Standard) |
Ihre App | Ihre eigene Agent-Schleife oder ein Nicht-OpenAI-Backend |
Der Delegationsleitfaden empfiehlt den Einstieg mit gpt-6-luna und für schwierigere Backend-Aufgaben gpt-6-sol auszuprobieren. Falls Sie sich noch nicht entschieden haben, behandelt unser GPT-6-Luna-Überblick die Abwägungen.
"delegation": {
  "type": "responses",
  "responses": {
    "model": "gpt-6-luna",
    "instructions": "Look up orders with get_order. Answer in one sentence.",
    "tools": [{ "type": "web_search" }],
    "tool_choice": "auto",
    "parallel_tool_calls": false
  }
}
Der responses-Block akzeptiert auch max_output_tokens (16 oder mehr), service_tier (auto, default, flex oder priority, wobei priority der Fast-Modus ist) sowie die reasoning- und text-Einstellungen, die Ihr Backend-Modell unterstützt. Sie können diese Felder mitten in der Sitzung mit session.update ändern. Die Validierung erfolgt asynchron: Eine fehlerhafte Konfiguration kommt als error mit dem Code responses_validation_failed an, und die Sitzung bleibt offen.
Dann teilen Sie dem Sprachmodell mit, wann delegiert werden soll. Bei 1.1 geschieht das in normaler Sprache in instructions:
Delegate to the backend when: the caller asks about an order, a refund or anything you must look up.
Do not delegate when: the caller greets you, asks you to repeat, or says goodbye.
While the backend works, briefly say what you are checking.
Der Prompting-Leitfaden warnt, dass ein gesprochenes „Ich prüfe das gerade“ nicht beweist, dass die Backend-Arbeit begonnen hat. Achten Sie stattdessen in Ihren Logs auf session.delegation.created.
Function Calling zu einer GPT-Live-1.1-Sitzung hinzufügen
Gehostete Tools wie die Websuche laufen bei OpenAI. Ihre eigenen Funktionen laufen in Ihrer App. Legen Sie ein Standard-Responses-Function-Tool in delegation.responses.tools ab:
{
  "type": "function",
  "name": "get_order",
  "description": "Get the shipping status of an order by its ID.",
  "parameters": {
    "type": "object",
    "properties": { "order_id": { "type": "string" } },
    "required": ["order_id"],
    "additionalProperties": false
  },
  "strict": true
}
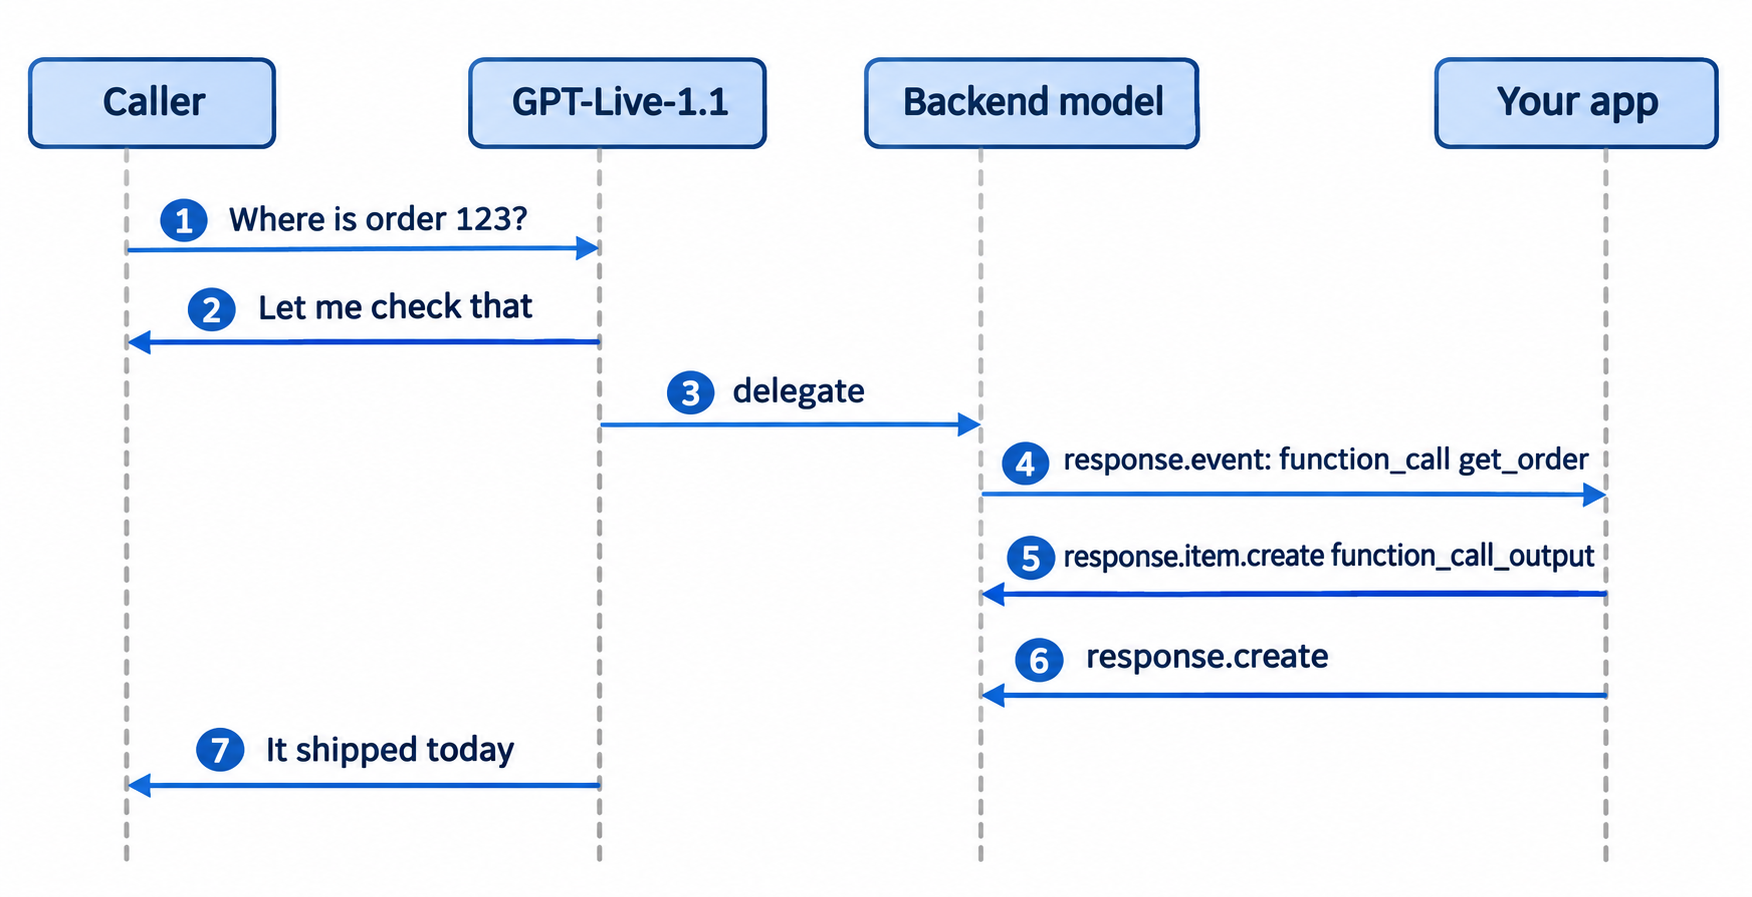
Die Ereignisse des Backends erreichen Sie verpackt in einem response.event-Envelope, der eine delegation_id und ein verschachteltes event enthält. Ein abgeschlossener Funktionsaufruf kommt als verschachteltes response.output_item.done an, dessen Item call_id, name und arguments enthält. Führen Sie die Funktion aus, senden Sie ein response.item.create mit dem Ergebnis und dann ein response.create:
ws.on("message", async (raw) => {
  const msg = JSON.parse(raw);
  if (msg.type !== "response.event") return;
  const ev = msg.event;
  if (ev.type !== "response.output_item.done" || ev.item?.type !== "function_call") return;

  const { order_id } = JSON.parse(ev.item.arguments);
  const order = await fetch(`${ORDERS_API}/orders/${order_id}`).then((r) => r.json());

  ws.send(JSON.stringify({
    type: "response.item.create",
    item: { type: "function_call_output", call_id: ev.item.call_id, output: JSON.stringify(order) },
  }));
  ws.send(JSON.stringify({ type: "response.create" }));
});
Drei Details, an denen Leute oft scheitern:
- Das bloße Anhängen des Outputs setzt das Backend nicht fort. Sie benötigen das
response.create. - Lassen Sie ein ausstehendes Ergebnis aus, erhalten Sie
function_call_outputs_required. Doppelte oder nicht übereinstimmendecall_id-Werte werden abgelehnt. - Weitergeleitete
response.completed-Ereignisse enthalten ein leeresresponse.output. Lesen Sie die einzelnen Output-Item-Ereignisse.
GPT-Live-1.1 Preise und Limits
Sprachzeit ist leicht zu kalkulieren. Ein 5-minütiger Supportanruf, der die gesamte Zeit aktiv bleibt, kostet 5 × 0,05 $ = 0,25 $ an Sprachzeit. Tausend davon ergeben 250 $, plus das, was das Backend-Modell und die Tools zu ihren üblichen Tarifen abrechnen.
| Kostenposition | Tarif |
|---|---|
| Aktive Stimme | 0,05 $ pro Minute |
| Standby-Stimme (WebRTC, Inferenz pausiert) | 0,02 $ pro Minute |
| WebRTC-Initialisierung | 15 Sekunden, gutgeschrieben, sobald die Sitzung läuft |
| Backend-Modell und Tools | Übliche Preise für dieses Modell und Tool |
Rate Limits zählen gleichzeitige Sitzungen, nicht Tokens. GPT-Live-1.1 und GPT-Live-1 haben separate Limits, die über Inferenzregionen hinweg gelten. Die GPT-Live-1-Seite listet 50, 300 und 500 gleichzeitige Sitzungen für die Stufen Build, Launch und Grow auf, ohne Zugang für die Free-Stufe. Die 1.1-Seite nennt keine Zahlen, prüfen Sie also die Limits-Seite Ihrer Organisation vor einem Launch.
Lassen Sie Ihren Coding-Agent das Tool-Backend mit Apidog CLI testen
Ihr Sprachagent ist nur so zuverlässig wie die API hinter get_order. Eine langsame oder fehlerhafte Antwort wird zu Funkstille oder einer falschen Antwort, die laut ausgesprochen wird. Testen Sie dieses Backend also, bevor ein Anrufer es hört, und lassen Sie Ihren Coding-Agent das mit Apidog CLI erledigen.
Richten Sie es einmal ein:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Geben Sie dann Claude Code, Codex oder Cursor einen Prompt:
Import ./orders-openapi.yaml into Apidog project <projectId>. Create test cases for
GET /orders/{order_id}: a known ID returns 200 with a status field in under 800 ms,
and an unknown ID returns 404 with a JSON error. Run them against the staging
environment and tell me what failed.
Der Agent liest das Schema, validiert seine Payload, erstellt die Fälle und führt sie aus:
apidog import --project <projectId> --format openapi --file ./orders-openapi.yaml
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Das 800-ms-Budget ist für Sprache wichtig: Der Anrufer hört jede Millisekunde, die Ihr Tool benötigt. Nehmen Sie das gleiche apidog run mit -r junit in die CI auf, damit eine Regression den Build fehlschlagen lässt, wie in unserem Apidog-CLI-CI/CD-Leitfaden gezeigt. Neu im Agent-Workflow? Starten Sie mit Apidog CLI in Claude Code. Apidogs Free-Plan deckt bis zu 4 Nutzer ab.
FAQ
Ist GPT-Live-1.1 in der API verfügbar? Ja. Seit dem 20. November 2026 können Sie gpt-live-1.1 auf v1/live/sessions über WebRTC, WebSocket oder SIP aufrufen. Es wird nicht auf v1/realtime, v1/responses oder Chat Completions bereitgestellt.
Wie viel kostet die GPT-Live-1.1 API? 0,05 $ pro aktiver Minute und 0,02 $ pro Standby-Minute. Backend-Modellaufrufe und Tools werden separat zu ihren eigenen Tarifen abgerechnet.
Was ist der Unterschied zwischen GPT-Live-1.1 und GPT Realtime? GPT-Live läuft auf seinem eigenen Endpunkt, rechnet nach Sprachdauer ab und übergibt Reasoning per Delegation an ein Backend-Modell. GPT Realtime läuft auf v1/realtime. Sehen Sie unseren GPT-Live-vs.-GPT-Realtime-Vergleich.
Welches Backend-Modell sollte ich für die Delegation verwenden? OpenAIs Leitfaden empfiehlt gpt-6-luna für den Einstieg und gpt-6-sol für komplexere Backend-Aufgaben. Setzen Sie service_tier auf priority, wenn Latenz wichtiger ist als Kosten.
Kann ich meinen eigenen Agenten statt eines Responses-Modells verwenden? Ja. Setzen Sie delegation.type auf client. Ihre App führt die Backend-Arbeit aus und sendet Ergebnisse mit session.commentary.append zurück. Transkripte verfolgen Sie ebenfalls selbst.
Unterstützt GPT-Live-1.1 Function Calling? Ja, über Responses-Delegation. Definieren Sie Funktionen in delegation.responses.tools, lesen Sie Aufrufe aus response.event und geben Sie Ergebnisse mit response.item.create plus response.create zurück.