
OpenAI hat ChatGPT Images 2.5 am 8. September 2026 mit zwei API-Modellen veröffentlicht: gpt-image-2.5-flare und gpt-image-2.5-sunburst. Beide werden zu den gleichen Pro-Token-Tarifen wie gpt-image-2 abgerechnet und teilen sich einen einzigen Eintrag im Preisrechner von OpenAI. Die Pro-Token-Tabelle hilft Ihnen also nicht bei der Auswahl. Was sich geändert hat, ist die darunter liegende Qualitätsabstufung, und die Umbenennung verschiebt den Preis eines Bildes mit quality: "high" um etwa das Vierfache.
Dies ist die Entscheidungsseite: Pro-Token-Tarife, Schätzungen pro Bild für alle fünf 2.5-Qualitätsstufen neben den gpt-image-2-Zahlen, die Umbenennung der Labels, ein monatliches Budget für 10.000 Bilder, das Gerücht über „2x Preisgestaltung“ und eine Migrations-Checkliste. Wenn Sie zuerst die Anforderungssyntax wünschen, lesen Sie wie man die gpt-image-2.5 API verwendet. Die OpenAI-Preisseite ist die Quelle für jeden der unten aufgeführten Tarife. Jede Pro-Bild-Angabe ist eine Schätzung des Rechners, da OpenAI warnt, dass der Token-Verbrauch „je nach Modell und Qualitätseinstellung variieren kann“; Ihre Rechnung basiert auf usage.output_tokens in der Antwort.
Pro-Token-Tarife: identisch bei allen dreien
Die Preisseite von OpenAI listet die gleichen Standard-Tarife für beide 2.5-Modelle auf, und jede Modellseite besagt, dass ihre „Token-Tarife GPT Image 2 entsprechen“. Hier ist die vollständige Tabelle, einschließlich der Batch-Zeile, die beim Start Verwirrung stiftete.
| Modell | Bildeingabe | Gecachte Bildeingabe | Bildausgabe | Texteingabe | Gecachte Texteingabe |
|---|---|---|---|---|---|
gpt-image-2.5-sunburst |
$8.00 | $2.00 | $30.00 | $5.00 | $1.25 |
gpt-image-2.5-flare |
$8.00 | $2.00 | $30.00 | $5.00 | $1.25 |
gpt-image-2 (Standard) |
$8.00 | $2.00 | $30.00 | $5.00 | $1.25 |
gpt-image-2 (Batch, 50% Rabatt) |
$4.00 | $1.00 | $15.00 | $2.50 | $0.625 |
Alle Angaben beziehen sich auf 1 Million Tokens. Die Ausgabe ist bei jedem Modell hier nur bildbasiert, sodass die Textausgabe niemals auf einer Rechnung erscheint.
Zum Gerücht über „2x Preisgestaltung“ in einigen frühen Berichten: Es entstand durch den Vergleich der 2.5 Standard-Zeile mit der gpt-image-2 Batch-Zeile, die einen Rabatt von 50 % bietet. Vergleichen Sie Standard mit Standard auf der Preisseite, und jeder Tarif bleibt unverändert.
Was jedes Bild auf jeder Qualitätsstufe kostet
Die Pro-Token-Parität ist, wo die Ähnlichkeit endet. Der Rechner von OpenAI (Stand 09.09.2026) weist diese Token-Anzahlen für die Bildausgabe unter einem gemeinsamen Eintrag, „GPT Image 2.5 (Sunburst and Flare)“, aus. Die Kosten betragen Tokens mal $30 pro 1 Million, nur Ausgabe-Tokens.
| Qualität | 1024x1024 Tokens | 1024x1024 Kosten | 1536x1024 Tokens | 1536x1024 Kosten |
|---|---|---|---|---|
| low | 196 | $0.00588 | 158 | $0.00474 |
| medium | 439 | $0.01317 | 343 | $0.01029 |
| high | 1,756 | $0.05268 | 1,372 | $0.04116 |
| xhigh | 3,122 | $0.09366 | 2,459 | $0.07377 |
| max | 7,024 | $0.21072 | 5,488 | $0.16464 |
Hier ist die gpt-image-2-Tabelle von derselben Dokumentationsseite, für dieselben Größen.
| Qualität | 1024x1024 | 1536x1024 (und 1024x1536) |
|---|---|---|
| low | $0.006 | $0.005 |
| medium | $0.053 | $0.041 |
| high | $0.211 | $0.165 |
Zwei Dinge fallen auf. Das Querformat ist in jeder Zeile günstiger als das quadratische Format, ein Muster, das in der Dokumentation von OpenAI hervorgehoben wird. Und die 2.5 high-Zeile ist nicht annähernd so wie die gpt-image-2 high-Zeile. Das ist die Umbenennung.
Prompt-Text und Referenzbilder werden zusätzlich berechnet. Ein Referenzbild, das an images/edits gesendet wird, kostet Bildeingabe-Tokens zu $8 pro 1 Million; OpenAI veröffentlicht nicht die Anzahl der Eingabe-Tokens pro Bild, lesen Sie diese also aus usage.input_tokens.
Die Qualitätsabstufung wurde umbenannt
Vergleichen Sie die Token-Budgets, und die Zuordnung ist klar. Bei 2.5 sind high 1.756 Ausgabe-Tokens, das Budget, das gpt-image-2 bei medium verwendete. Bei 2.5 sind max 7.024 Tokens, das Budget, das gpt-image-2 bei high verwendete. low bleibt unverändert bei 196 Tokens.
| 2.5 Label | Tokens (1024x1024) | 2.5 Kosten | Gleiches Budget bei gpt-image-2 | gpt-image-2 Kosten |
|---|---|---|---|---|
| low | 196 | $0.00588 | low | $0.006 |
| medium | 439 | $0.01317 | keine (unter dem alten Medium) | n. z. |
| high | 1,756 | $0.05268 | medium | $0.053 |
| xhigh | 3,122 | $0.09366 | keine (zwischen altem Medium und altem High) | n. z. |
| max | 7,024 | $0.21072 | high | $0.211 |
Eine Migration, die quality: "high" beibehält, wird pro Bild etwa 4x günstiger und rendert mit dem alten Medium-Budget. Wer das alte high-Budget wünscht, muss auf max umsteigen, praktisch zum alten Preis. xhigh ist eine neue Zwischenstufe ohne gpt-image-2-Äquivalent.
Die monatliche Berechnung, abgeleitet aus den Schätzungen des OpenAI-Rechners bei 1024x1024:
- 10.000 Bilder mit 2.5
high: 10,000 x $0.05268 = $526.80 - 10.000 Bilder mit gpt-image-2
high: 10,000 x $0.211 = $2,110 - 10.000 Bilder mit 2.5
max: 10,000 x $0.21072 = $2,107.20, praktisch derselbe Preis wie alteshigh - Streaming mit
partial_images: 3fügt 300 Tokens hinzu, oder $0.009 pro Bild, da jedes Teilbild 100 Bildausgabe-Tokens kostet
Flare vs. Sunburst: Was das Premium bietet
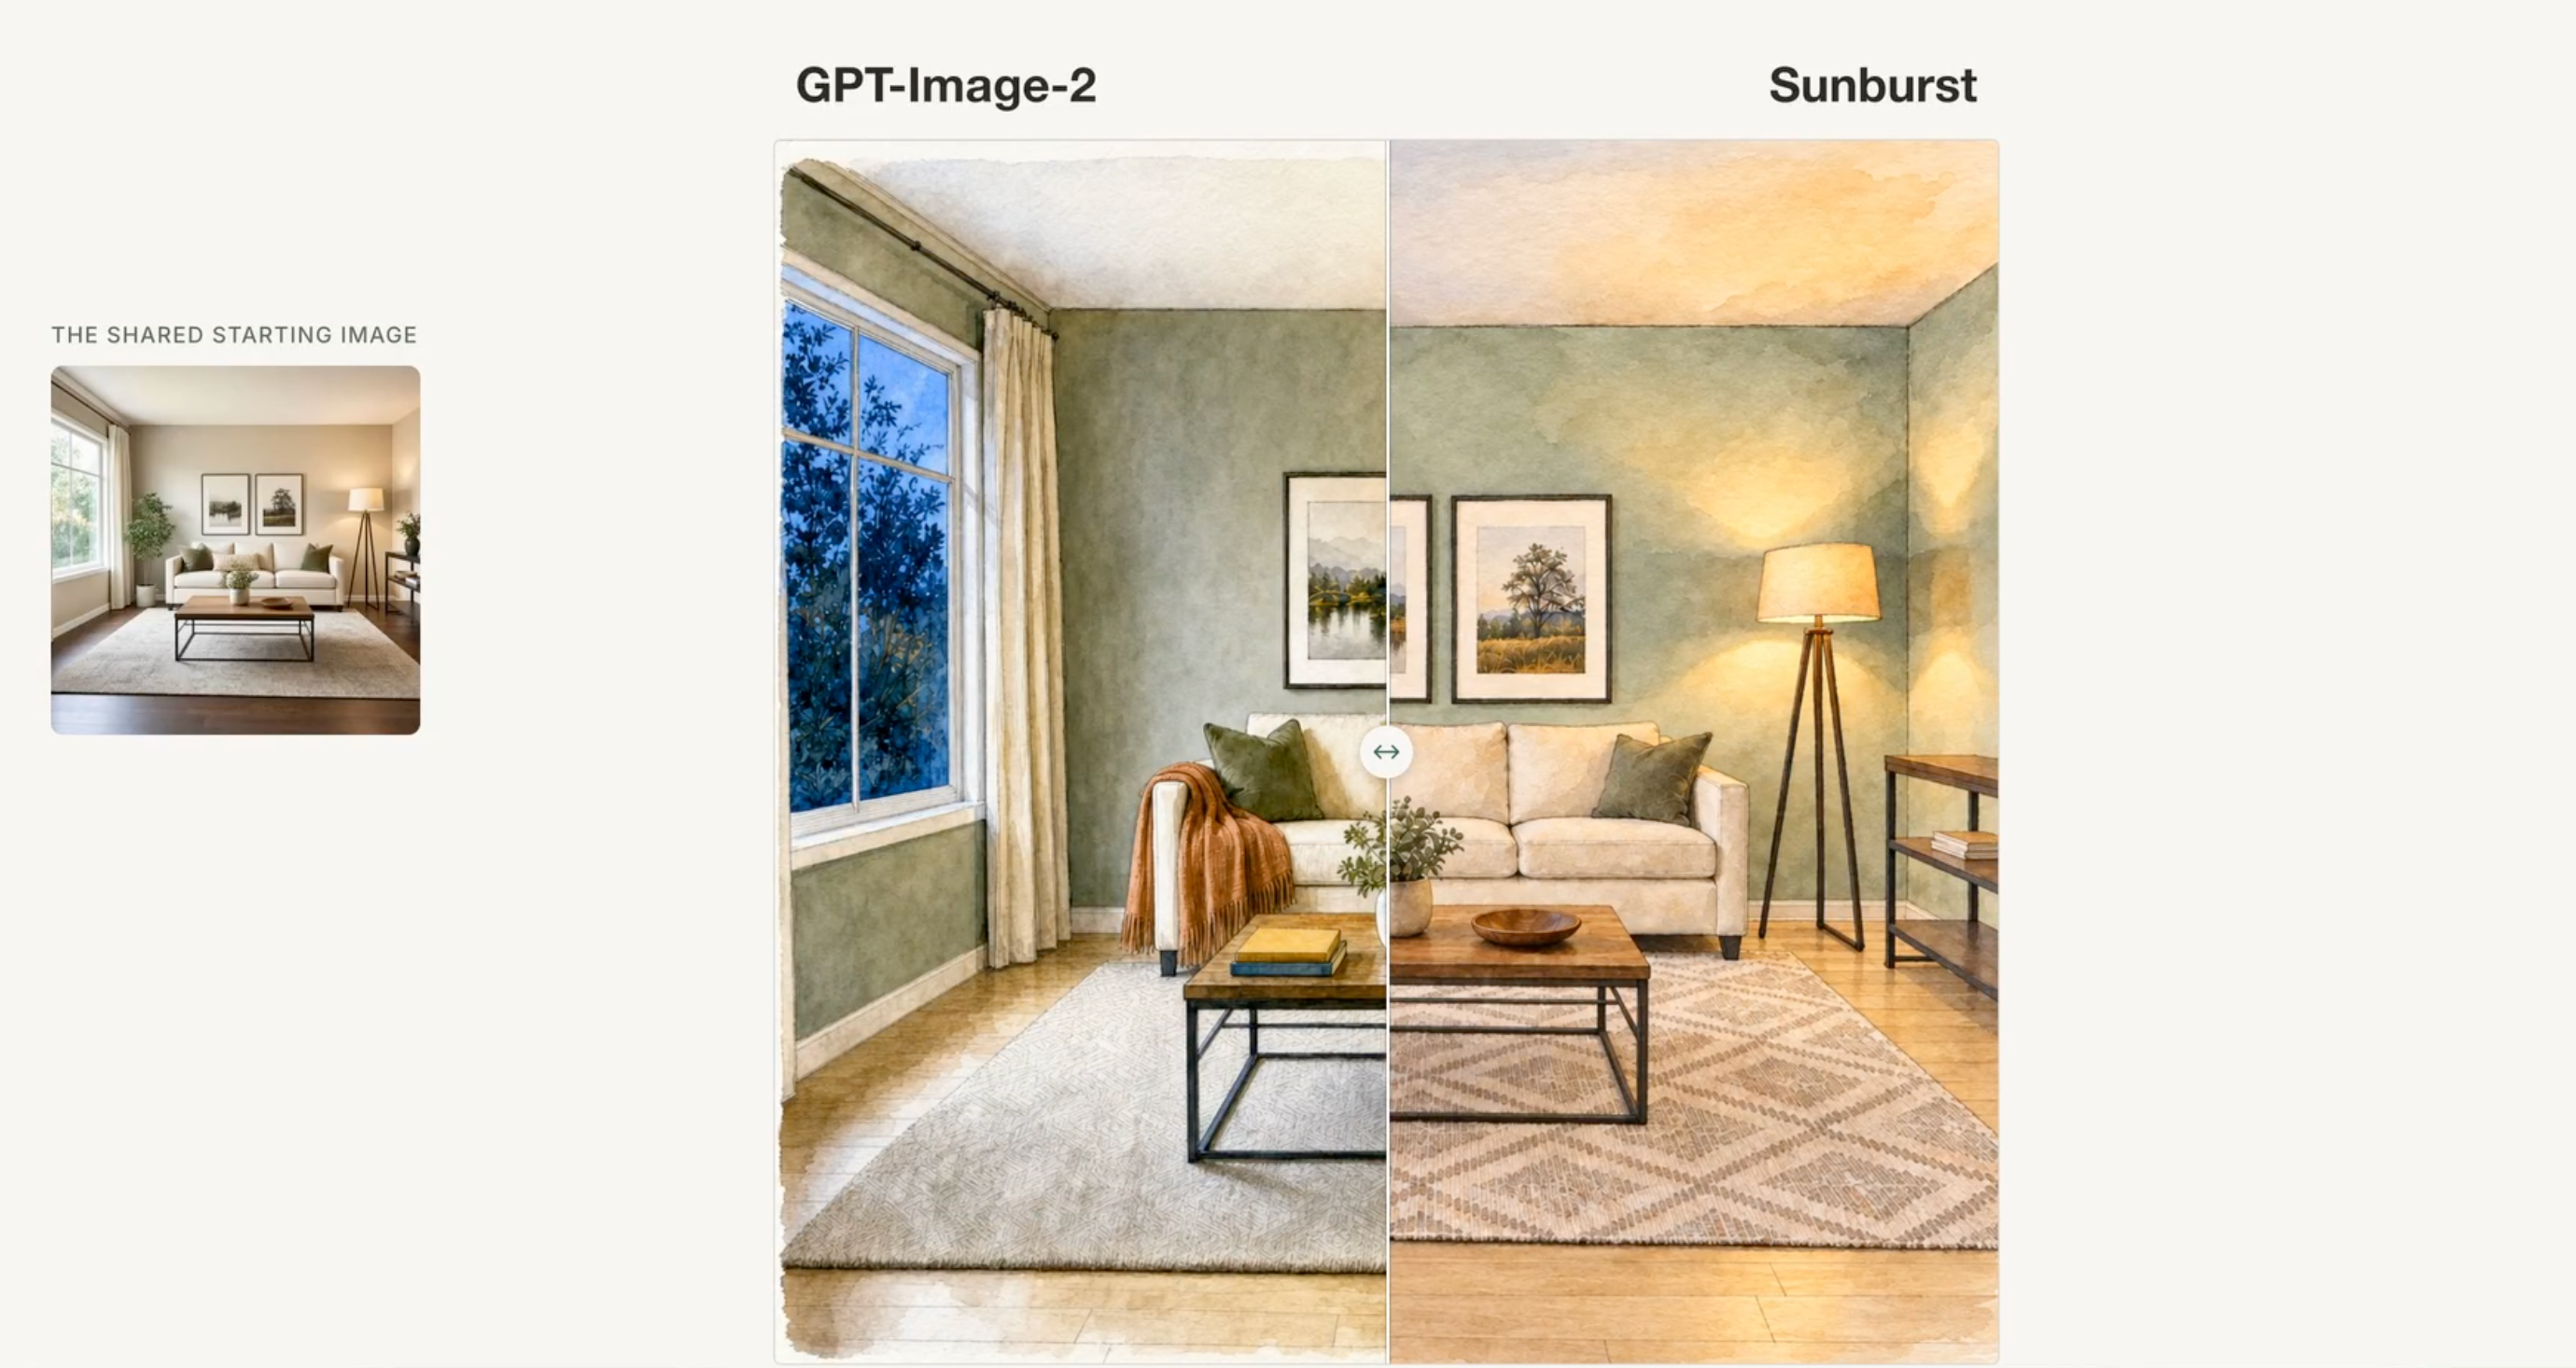
Beide Modelle teilen sich den Rechnereintrag, sodass die dokumentierten Token-Anzahlen identisch sind. Sunburst kostet pro Bild nicht mehr; der Aufpreis ist Zeit. OpenAIs Startpost richtet Flare auf „High-Volume-Generierung“ und Sunburst auf „Premium-visuelle Workflows, die von einer präziseren Kontrolle über Bearbeitungen profitieren“ aus. Die Dokumentation fasst es in einem Satz zusammen: „Wählen Sie Sunburst für Workflows, bei denen die Bearbeitungspräzision am wichtigsten ist, und Flare für schnelle, hochwertige alltägliche Bildgenerierung.“
Community-Signal, als solches gekennzeichnet:
- Im HN-Thread sagte der Benutzer jjcm, der etwa 50.000 Bilder über gpt-image-2 für ein AI-UI-Design-Tool berichtete, dass die durchschnittliche Latenzzeit bei gpt-image-2 „ungefähr 104s betrug“ und 2.5-Bilder „ungefähr 35-40s“ benötigen. Ein Datenpunkt, eine Arbeitslast; OpenAIs eigene Behauptung ist eine „bis zu 50%“ geringere Latenz.
- Die Arena Text-zu-Bild-Bestenliste (Community-Abstimmungen, aktualisiert am 7. September 2026) führt Sunburst mit 1421 auf Platz eins, Flare mit 1399 auf Platz zwei, gpt-image-2 auf Medium mit 1381 auf Platz drei, dann Microsofts mai-image-2.6 mit 1331; Nano Banana 2 liegt bei 1261. Auf der Bildbearbeitungs-Bestenliste vergrößert sich der Abstand: Sunburst 1520, Flare 1491, gpt-image-2 1461. Dies sind Bewertungen nach Nutzerpräferenz, keine OpenAI-Benchmarks.
Die Entscheidungsregel: Standardmäßig Flare verwenden. Wechseln Sie zu Sunburst für Multi-Turn-Bearbeitungsworkflows, bei denen ein Referenzobjekt mehrere Anweisungsrunden überstehen muss. Der Arena-Abstand beträgt 22 Punkte bei Text-zu-Bild und 29 bei Bearbeitungen, was OpenAIs Behauptung stützt, dass Sunburst seine Wartezeit bei Bearbeitungen verdient. Wenn dieser Unterschied bei Ihren eigenen Prompts nicht auftritt, zahlen Sie Latenzzeit umsonst.
Wann gpt-image-2 noch Sinn macht
Batch-Rabatte. Der Batch-Tab der Preisseite listet nur gpt-image-2 auf, zu $15 pro 1 Million Ausgabe-Tokens; ob /v1/batch die 2.5 IDs akzeptiert, ist zum Zeitpunkt der Erstellung dieses Artikels undokumentiert. Wenn Ihre Arbeitslast die Bearbeitungszeit der Batch API toleriert, unterbietet gpt-image-2 mit Batch medium (die Hälfte von $0.053) das 2.5 high zu Standardtarifen für dasselbe Token-Budget.
Gepinnte Snapshots. gpt-image-2-2026-04-21 ist seit April ohne Abkündigungsbenachrichtigung (Stand 09.09.2026) verfügbar. Wenn Ihre Pipeline von Ausgaben abhängt, die visuell überprüft wurden, ist ein unveränderlicher Snapshot ein Feature; unser gpt-image-2 API-Leitfaden behandelt seine Parameter. Für einen anbieterübergreifenden Vergleich: Vergleichen Sie Nano Banana 2 API-Preise und die FLUX.2 API bei gleicher Ausgabegröße; 2.5 high für ungefähr fünf Cent pro quadratischem Bild ist der Wert, den es zu schlagen gilt.
Migrations-Checkliste von gpt-image-2 zu 2.5
- Modell-ID tauschen.
gpt-image-2wird zugpt-image-2.5-flare(oder-sunburst); pinnen Siegpt-image-2.5-flare-2026-09-08für eine stabile Ausgabe. - Qualitätslabels neu zuordnen. Altes
mediumwird zu neuemhigh, alteshighwird zu neuemmax,lowbleibtlow. Tun Sie dies in der Konfiguration, nicht pro Aufrufstelle. xhighundmaxin Betracht ziehen. Beide sind neu in 2.5;xhighmit 3.122 Tokens liegt zwischen den alten Medium- und High-Budgets.- Annahmen zum „thinking“-Parameter fallenlassen. Die 2.5-Dokumentation beschreibt keinen
thinking-Parameter; entfernen Sie ihn aus Vorlagen, anstatt davon auszugehen, dass er akzeptiert oder ignoriert wird. usageneu messen. Protokollieren Sieusage.output_tokensundusage.input_tokensfür eine Woche mit echten Prompts; die Rechnerzahlen sind Schätzungen.- Batch-Berechtigung prüfen. Wenn Sie sich auf den 50% Batch-Rabatt verlassen, bestätigen Sie, dass
/v1/batchdie 2.5 IDs akzeptiert, bevor Sie umstellen.
Alle drei Modelle in Apidog mit einer gespeicherten Anfrage vergleichen
Apidog ist ein API-Client und eine Testplattform. Es sendet die images/generations-Anfrage und prüft die Antwort; es generiert keine Bilder und führt das Modell nicht aus. Das macht es zum idealen Ort, um Flare vs. Sunburst vs. gpt-image-2 mit Ihren eigenen Prompts zu vergleichen.
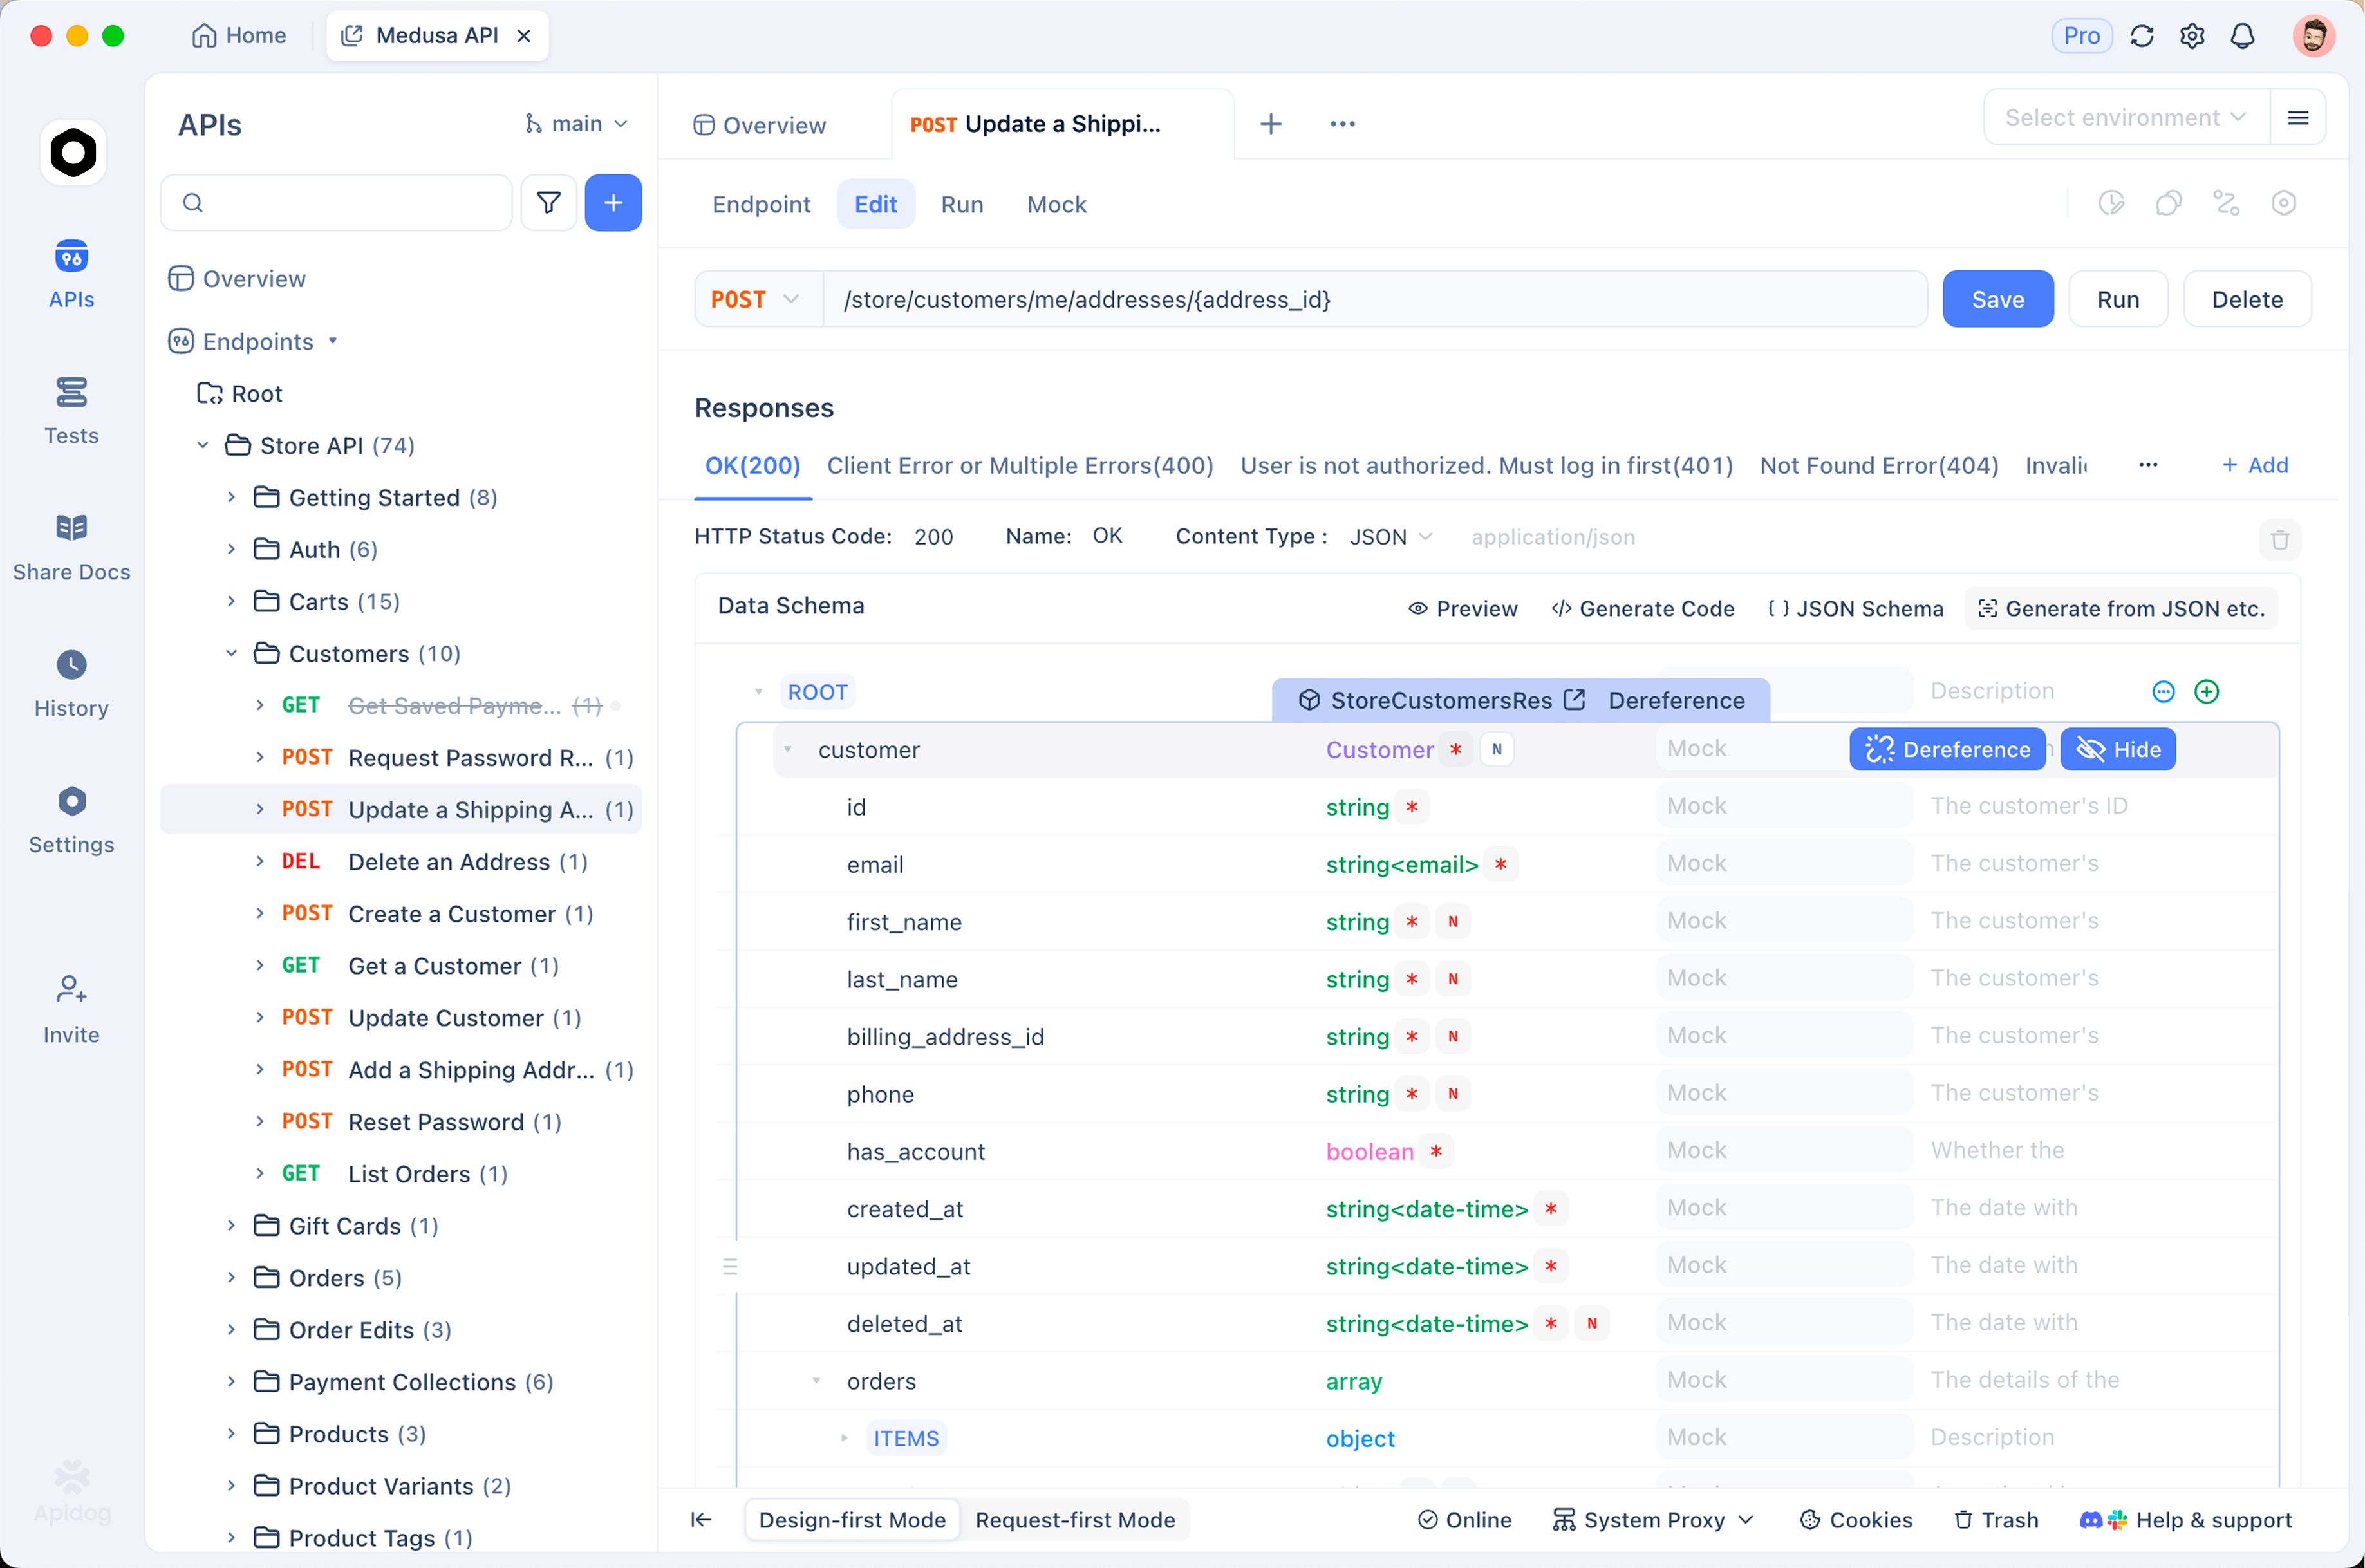
Erstellen Sie eine Anfrage an POST https://api.openai.com/v1/images/generations mit dem Modell als Variable und erstellen Sie dann drei Umgebungen namens flare, sunburst und gpt-image-2. Jede Umgebung setzt {{model}} und speichert OPENAI_API_KEY als Umgebungsvariable, sodass der Schlüssel niemals im Anfragetext landet.
{
  "model": "{{model}}",
  "prompt": "Product photo of a matte black ceramic mug on a walnut desk, soft window light",
  "size": "1024x1024",
  "quality": "high",
  "output_format": "jpeg",
  "output_compression": 80
}
Fügen Sie ein Nachbearbeitungsskript hinzu, das die Zahlen aufzeichnet und den Lauf fehlschlägt, wenn das Token-Budget überschritten wird:
const body = pd.response.json();
const tokens = body.usage.output_tokens;
pd.environment.set("last_output_tokens", tokens);
pd.environment.set("last_wall_clock_ms", pd.response.responseTime);
pd.test("output tokens within budget", () => {
  pd.expect(tokens).to.be.below(2000);
});
Führen Sie die Anfrage in jeder Umgebung aus. Die Antwortzeit von Apidog ist Ihre tatsächliche Laufzeit, last_output_tokens ist die gemessene Anzahl, die mit den 1.756 des Rechners verglichen wird, und der Unterschied zwischen den Flare- und Sunburst-Läufen ist der Sunburst-Aufpreis für Ihren Prompt. Derselbe Umgebungswechsel funktioniert für den images/edits Multipart-Aufruf; prüfen Sie dort usage.input_tokens, um zu erfahren, was ein Referenzfoto kostet. Laden Sie Apidog herunter, um den Vergleich durchzuführen, bevor Sie den Produktionscode ändern.
FAQ
Ist gpt-image-2.5 teurer als gpt-image-2? Pro Token, nein. Beide 2.5-Modelle und gpt-image-2 Standard berechnen $30 pro 1 Million Bildausgabe-Tokens, $8 pro 1 Million Bildeingabe und $5 pro 1 Million Texteingabe. Pro Bild kostet eine 2.5 high-Anfrage etwa $0.053 bei 1024x1024, verglichen mit $0.211 für gpt-image-2 high.
Kostet Sunburst mehr als Flare? Nein. Beide Modelle teilen sich einen Rechnereintrag, sodass die dokumentierten Token-Anzahlen auf jeder Qualitätsstufe und Größe identisch sind. Sunbursts Premium ist eine längere Generierungszeit, was OpenAI als „zusätzliches Präzisionsniveau“ für bearbeitungsintensive Arbeiten bezeichnet.
Welche Qualitätseinstellung ersetzt mein altes gpt-image-2 high? max. Es verwendet 7.024 Tokens bei 1024x1024, das gleiche Budget wie gpt-image-2 high, und kostet laut Rechner $0.21072. Belassen Sie high und Sie erhalten das alte Medium-Budget zu etwa einem Viertel des Preises. Der Grundlagenartikel zu ChatGPT Images 2.5 behandelt, was sich sonst noch geändert hat.
Gibt es eine kostenlose Möglichkeit, Images 2.5 auszuprobieren, bevor ich für die API bezahle? Ja. Das Modell ist in jeder ChatGPT-Stufe mit planbasierten Generierungslimits verfügbar, beschrieben unter wie man ChatGPT Images 2.5 kostenlos nutzt. Die API hat keine kostenlose Stufe für Bild-Endpunkte; low-Qualität zu etwa $0.006 pro quadratischem Bild ist der günstigste echte Weg.
Welches Modell wählen
Flare für alles, was hochvolumig oder latenzsensitiv ist, bei high für die meisten Arbeiten und max, wenn der alte gpt-image-2 high-Look eine Anforderung ist. Sunburst für Multi-Turn-Bearbeitungen, bei denen ein Referenzobjekt überleben muss, nach einem Side-by-Side-Vergleich Ihrer Prompts; gpt-image-2 für Batch-Jobs und gepinnte Pipelines, die Sie nicht erneut überprüfen möchten. Was auch immer Sie wählen, lesen Sie usage.output_tokens aus echten Antworten; drei Umgebungen in Apidog und eine gespeicherte Anfrage liefern Ihnen diese Zahl an einem Nachmittag.