Jedes Backend-Team hat eine Liste von Aufgaben, die offensichtlich mit einem Sprachmodell besser zu bewältigen wären, aber niemand hat sie je ausgeliefert. Fünf Millionen Support-Ereignisse pro Tag klassifizieren. Einen Katalog mit zwölf Millionen Zeilen anreichern. Jeden eingehenden Webhook bewerten, bevor er die Warteschlange erreicht. Der Grund ist immer derselbe: Multiplizieren Sie die Kosten pro Anfrage mit Ihrer tatsächlichen Anzahl an Anfragen, und die Zahl ist kein Rundungsfehler mehr.
GPT-6 Luna, angekündigt am 22. September 2026, kostet 0,10 $ pro Million Eingabe-Tokens und 0,50 $ pro Million Ausgabe-Tokens, verfügt über ein Kontextfenster von 1.000.000 Tokens und gewährt einen Rabatt von 90 % auf gecachte Eingabe-Lesevorgänge. Das ist günstig genug, um mehrere dieser zurückgestellten Aufgaben realisierbar zu machen, und günstig genug, um die Leute dazu zu bringen, das Rechnen einzustellen, was dazu führt, dass Sie eine fünfstellige Rechnung erklären müssen.
Hier ist also die Rechnung: drei realistische Workload-Profile, die Kosten pro Million Anfragen für jedes Profil und die drei Variablen, die Ihre Rechnung lange vor dem Listenpreis bestimmen.
Die Raten, mit denen Sie arbeiten
| Modell | API ID | Eingabe pro 1 Mio. | Cache-Lesevorgang pro 1 Mio. | Ausgabe pro 1 Mio. | Kontext |
|---|---|---|---|---|---|
| GPT-6 Luna | gpt-6-luna |
0,10 $ | 0,01 $ | 0,50 $ | 1.000.000 |
| GPT-6 Sol | gpt-6-sol |
2,00 $ | 0,20 $ | 10,00 $ | 872.000 |
| GPT-6 Astra | n. zutr. | 10,00 $ | n. zutr. | 50,00 $ | n. zutr. |
| Claude Opus 5.5 | claude-opus-5-5 |
4,00 $ | 0,20 $ (Schreiben 5,00 $) | 20,00 $ | 1.000.000 |
Die Spalte für gecachte Lesevorgänge bei Sol und Luna ist der veröffentlichte 90 %ige Rabatt auf die Eingaberate, keine separat veröffentlichte Zahl. Anthropic veröffentlicht seine Rate für gecachte Lesevorgänge direkt und berechnet außerdem 5,00 $ pro Million für das Schreiben in den Cache, was bei großem Volumen wichtig ist: Eine Arbeitslast mit hoher Präfix-Fluktuation zahlt diese Schreibkosten wiederholt.
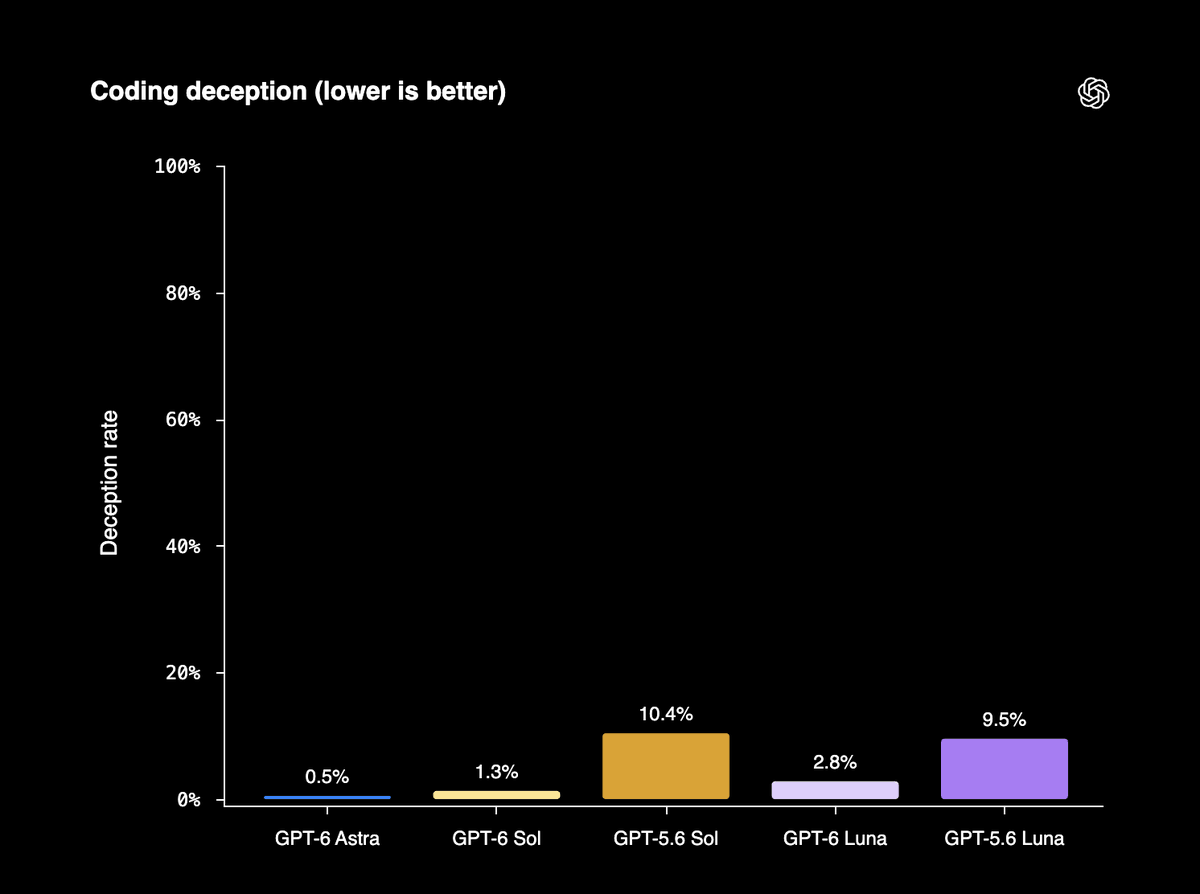
Eine Klarstellung, bevor wir zu den Zahlen kommen. OpenAI beschreibt Sol und Luna als 50 % günstiger als die Aktionspreise von GPT-5.6. „Aktion“ ist OpenAIs eigenes Wort und spielt eine wichtige Rolle: Der Vergleich erfolgt mit einem reduzierten Preis, nicht mit dem Preis, zu dem GPT-5.6 eingeführt wurde. Gegenüber dem Listenpreis von GPT-5.6 Luna von 1 $ Eingabe und 6 $ Ausgabe, den unsere Berichterstattung zur Einführung dokumentiert hat, bedeutet GPT-6 Luna eine Kürzung von 90 % bei der Eingabe und 92 % bei der Ausgabe.
Workload A: Klassifizierung mit hoher QPS
Das Muster, das die meisten Teams zuerst anstreben: ein stabiler System-Prompt, Tool-Schemas und eine Taxonomie, plus eine kleine variable Nutzlast, die ein kurzes strukturiertes Urteil zurückgibt. Angenommen werden 1.500 Tokens eines stabilen Präfixes, 500 Tokens einer variablen Nutzlast, 120 Ausgabe-Tokens und 5.000.000 Anfragen pro Tag.
| Modell | Kosten pro 1 Mio. Anfragen, kalt | Kosten pro 1 Mio. Anfragen, Präfix gecacht |
|---|---|---|
| GPT-6 Luna | 260 $ | 125 $ |
| GPT-6 Sol | 5.200 $ | 2.500 $ |
| Claude Opus 5.5 | 10.400 $ | 4.700 $ |
| GPT-6 Astra | 26.000 $ | nicht veröffentlicht |
| GPT-5.6 Luna, Listenpreis | 2.720 $ | nicht zutreffend |
Bei 5.000.000 Anfragen pro Tag sind das 625 $ auf Luna mit einem warmen Präfix, etwa 18.750 $ pro Monat. Der gleiche Traffic auf Sol ohne Caching kostet 26.000 $ pro Tag und auf Astra 130.000 $.
Aus dieser Tabelle ergeben sich zwei Dinge. Der Caching-Rabatt reduziert diese Rechnung um 52 %, obwohl sich an der Arbeitslast nichts geändert hat; der einzige Unterschied ist, ob die führenden 1.500 Tokens zwischen den Aufrufen bytgenau identisch blieben. Und der Stufenunterschied bei hohem Volumen beträgt eine Größenordnung, nicht einen Prozentsatz. Die Wahl von Luna gegenüber Sol ist hier eine zwanzigfache Entscheidung, keine geringfügige Anpassung.
Workload B: Abruf großer Kontexte
Hier ist Lunas 1.000.000-Token-Fenster nicht mehr nur eine Zeile im Datenblatt. Angenommen wird ein Wissenspaket von 200.000 Tokens, das über Anrufe hinweg stabil gehalten wird, eine Abfrage von 2.000 Tokens, 600 Ausgabe-Tokens und 50.000 Anfragen pro Tag.
| Kalt | Präfix gecacht | |
|---|---|---|
| GPT-6 Luna, pro Anfrage | 0,0205 $ | 0,0025 $ |
| GPT-6 Luna, pro Tag | 1.025 $ | 125 $ |
| GPT-6 Sol, pro Anfrage | 0,410 $ | 0,050 $ |
| GPT-6 Sol, pro Tag | 20.500 $ | 2.500 $ |
Caching reduziert die Luna-Rechnung hier um 88 %, gegenüber 52 % bei Arbeitslast A. Dieser Unterschied ist der entscheidende Punkt: Der Rabatt skaliert mit dem Verhältnis von stabilem Präfix zu neuen Tokens. Ein 200.000-Token-Präfix, das 50.000 Mal pro Tag neu gelesen wird, ist das Szenario, in dem Prompt-Caching am meisten zahlt.
Lunas Fenster ist auch größer als Sols 872.000 Tokens, sodass eine Nutzlast von 900.000 Tokens nicht in das teurere Modell passt, aber in das günstigere. Das kehrt die übliche Routing-Regel „auf ein größeres Modell hochstufen, wenn die Nutzlast wächst“ um, was in Was GPT-6 Luna tatsächlich ist detailliert behandelt wird.
Workload C: Die einmalige Nachbefüllung
Batch-Jobs sind der Bereich, in dem die neue Preisgestaltung das Mögliche verändert, nicht nur das, was günstig ist. Angenommen wird ein Anreicherungslauf von 12.000.000 Datensätzen: 900 Tokens stabiler Anweisung, 300 Tokens pro Datensatz, 250 Ausgabe-Tokens.
| GPT-6 Luna | GPT-6 Sol | |
|---|---|---|
| Eingabe, kalt | 1.440 $ | 28.800 $ |
| Ausgabe | 1.500 $ | 30.000 $ |
| Gesamt, kalt | 2.940 $ | 58.800 $ |
| Gesamt, Präfix gecacht | 1.968 $ | nicht berechnet |
Eine Nachbefüllung von zwölf Millionen Datensätzen für unter 3.000 $ oder unter 2.000 $, wenn das Anweisungspräfix „warm“ bleibt. Das ist eine Summe, die ein Team mit einer einzigen Nachricht genehmigen lassen kann. Derselbe Job auf Sol erfordert ein Budget-Gespräch.
Beachten Sie hier das Verhältnis. Die Ausgabe macht nun die Hälfte der Rechnung aus, was direkt zu dem führt, was Ihre Kosten tatsächlich bestimmt.
Die drei Variablen, die die Rechnung bestimmen
1. Ausgabe-Tokens, weil sie das Fünffache der Eingabe kosten
Lunas Ausgaberate beträgt das Fünffache ihrer Eingaberate. Bei Arbeitslast A mit gecachtem Präfix kosten Eingaben 65 $ pro Million Anfragen und 120 Ausgabe-Tokens 60 $. Wenn Sie das Antwortformat auf 400 Tokens auflockern, springt die Ausgabe auf 200 $, wodurch die Gesamtkosten von 125 $ auf 265 $ pro Million Anfragen steigen. Ein an einem Nachmittag gewähltes Antwortschema hat die Rechnung mehr als verdoppelt.
Die Lösung ist langweilig und effektiv: die Ausgabe einschränken. Geben Sie ein Enum zurück, keinen Satz. Geben Sie eine Punktzahl zurück, keine Erklärung, und rufen Sie die Erklärung nur für den kleinen Bruchteil von Fällen ab, die ein Mensch überprüft. Fixieren Sie die Form mit einem JSON-Schema, damit das Modell nicht „aufblähen“ kann:
{
  "model": "gpt-6-luna",
  "response_format": {
    "type": "json_schema",
    "json_schema": {
      "name": "triage",
      "strict": true,
      "schema": {
        "type": "object",
        "properties": {
          "category": { "enum": ["billing", "outage", "how_to", "abuse"] },
          "severity": { "type": "integer", "minimum": 1, "maximum": 4 }
        },
        "required": ["category", "severity"],
        "additionalProperties": false
      }
    }
  }
}
Bestätigen Sie die Parameternamen anhand der aktuellen Modellreferenz von OpenAI, bevor Sie auf dieser Form aufbauen. Die Modell-ID gpt-6-luna ist der Teil, der aus dem Startmaterial bestätigt wurde.
2. Cache-Trefferquote, denn es ist der einzige kostenlose Gewinn von 50 % bis 88 %, den Sie erzielen werden
Alles oben Genannte geht davon aus, dass der Präfix bytgenau identisch bleibt. In der Produktion ist dies normalerweise nicht der Fall, weil jemand eine Anfrage-ID in den System-Prompt injiziert oder das Tool-Array aus einem Wörterbuch erstellt, dessen Schlüsselreihenfolge zwischen den Prozessen wechselt. Zwei klassische Cache-Killer sind jetzt von dieser Liste gestrichen: Mit GPT-6 macht eine Änderung des Reasoning-Aufwands oder der Tool-Verfügbarkeit den Cache nicht mehr ungültig, und explizite Breakpoints lassen Sie entscheiden, wo der gecachte Präfix endet. Ein Prompt-Caching-Dashboard und ein Diagnose-Tool machen die Trefferquote zu etwas, das Sie messen, anstatt es anzunehmen, und GitHub meldet, dass über Milliarden von Anfragen hinweg mehr als 50 % weniger Prompt-Tokens eine erneute Verarbeitung benötigen. Die Mechanik wird in unserem GPT-6 Prompt-Caching-Walkthrough behandelt.
Bei hohem Volumen behandeln Sie die Trefferquote als Produktions-SLI. Ein Präfix-Refactoring, das Sie stillschweigend von 95 % auf 40 % Trefferquote zurückwirft, kostet Arbeitslast A grob 400 $ pro Tag und erzeugt keine Fehler, keine Warnungen und keine fehlschlagenden Tests.
3. Wiederholungsversuche, weil sie sich multiplizieren
Eine Wiederholungsrate von 5 % bei Arbeitslast A fügt etwa 31 $ pro Tag hinzu. Tolerierbar. Die gleichen 5 % bei Arbeitslast B kosten 50 $ pro Tag, wenn die Wiederholungsversuche den Cache verfehlen, und 6 $, wenn sie ihn treffen, und der Unterschied liegt ausschließlich darin, ob Ihr Wiederholungsversuch den Prompt von Grund auf neu aufbaut. Wiederholungsversuche, die einen Präfix neu generieren, sind die teuerste Resilienz, die Sie kaufen können. Verwenden Sie den genauen Anfragetext wieder.
Die Latenzfalle bei hohen QPS
Günstig ist nicht schnell, und bei hohen QPS rächt sich das. Messungen Dritter von Artificial Analysis beziffern GPT-6 Luna auf 153,9 Ausgabe-Tokens pro Sekunde mit einer Zeit bis zum ersten Token von 124,23 Sekunden und GPT-6 Sol auf 102,15 Sekunden. Es gelten zwei Einschränkungen, und beide sind entscheidend: Dies sind Zahlen Dritter und nicht vom Anbieter veröffentlichte, und sie werden an den Varianten mit **maximalem** Reasoning gemessen, der langsamsten verfügbaren Konfiguration.
Dennoch ist die Richtung wichtig. Zwei Minuten bis zum ersten Token sprengen ein Standard-HTTP-Client-Timeout, versetzen einen Load Balancer in den Leerlauf und überschreiten die Ausführungsgrenze der meisten Serverless-Laufzeiten. Synchrone Pfade mit hohen QPS gehören auf geringen Aufwand mit Streaming; hoher Aufwand gehört in Batch-Jobs und Warteschlangen-Worker, wo nichts auf einen Socket wartet. Passen Sie Timeouts an die gemessene Latenz auf dem von Ihnen verwendeten Aufwandsniveau an, nicht an den Preis.
Wo die Qualitätsuntergrenze liegt
Luna ist nicht das intelligenteste Modell in der Familie, und OpenAI behauptet das auch nicht. Astra ist laut OpenAI „weiterhin unser bestes Modell in allen Bereichen“. Was OpenAI veröffentlicht: Luna erzielt bei maximalem Aufwand 66,6 % auf DeepSWE 1.1, vergleichbar mit Claude Opus 5 und Claude Fable 5 bei mittlerem Aufwand, mit 93 % niedrigeren Kosten pro Aufgabe als Opus 5 und 96 % niedriger als Fable 5. Auf AutomationBench 1.0.6 übertrifft es bei hohem Aufwand seinen Vorgänger um 5,4 Punkte bei 58 % niedrigeren Kosten pro Aufgabe. Auf OSWorld 2.0 offline bei maximalem Aufwand schlägt es GPT-5.6 Sol bei mittlerem Aufwand für ein Zehntel der Kosten.
Dies sind Anbieterzahlen, gemessen an Claude Opus 5, nicht Opus 5.5, das am selben Tag veröffentlicht wurde, behandeln Sie sie daher als Richtwerte. Die operative Lesart ist, dass Luna das günstigste Modell ist, das die Anforderungen für gut spezifizierte, verifizierbare Arbeit erfüllt, und „verifizierbar“ ist das entscheidende Wort.
Bestätigen Sie das Kostenmodell, bevor Sie sich darauf festlegen
Tabellenkalkulations-Arithmetik ist eine Hypothese. Testen Sie es mit echtem Traffic: Nehmen Sie eine Stichprobe von 500 Anfragen aus Produktions-Nutzlasten, führen Sie diese gegen Luna und Sol als zwei Umgebungen aus und zeichnen Sie Token-Zählungen, Latenz und Schema-Konformität auf.
In Apidog ist dies ein gespeicherter Endpunkt mit der Modell-ID als Umgebungsvariable, ausgeführt als Testszenario gegen eine Datendatei realer Nutzlasten. Fügen Sie drei Zusicherungen hinzu, und die Suite wird zu einer Kostenschutzschiene statt zu einer Korrektheitsprüfung: Zusichern, dass die Antwort Ihrem JSON-Schema entspricht, zusichern, dass usage.completion_tokens unter Ihrem pro-Anfrage-Ausgabe-Budget bleibt, und zusichern, dass usage.prompt_tokens_details.cached_tokens ungleich Null ist, damit ein Präfix-Refactoring, das Ihre Cache-Trefferquote zerstört, CI fehlschlägt, anstatt auf der Rechnung des nächsten Monats aufzutauchen. Bestätigen Sie diese Nutzungsfeldnamen anhand der aktuellen API-Referenz, bevor Sie sie zusichern.
Diese letzte Zusicherung ist diejenige, die niemand schreibt und die jeder braucht. Der Fehlermodus einer hochvolumigen LLM-Arbeitslast ist fast nie ein Ausfall. Es ist eine 4-fache Rechnung hinter einem grünen Dashboard.
Wie sich Lunas Preisgestaltung im Vergleich zu GPT-6 Sol und Claude Opus 5.5 über die gesamte Woche verhält, sehen Sie in unserer Analyse des KI-Modell-Preiskriegs vom September 2026.
Die Kurzfassung
Leiten Sie hochvolumige, gut spezifizierte, programmatisch verifizierbare Arbeit an Luna und halten Sie den stabilen Teil Ihres Prompts bytgenau identisch. Begrenzen Sie Ausgabe-Tokens, weil sie das Fünffache der Eingabe kosten. Messen Sie die Cache-Trefferquote als Produktionsmetrik. Halten Sie hohen Aufwand von synchronen Pfaden fern, bis Sie die Zeit bis zum ersten Token mit Ihrem eigenen Traffic gemessen haben. Tun Sie das, und die Jobs, die nie ausgeliefert wurden, weil die Arithmetik nicht funktionierte, sind diese Woche wieder eine Kostenberechnung wert.