
Wenn Sie Anfang September eine Agenten-Workload auf GPT-6 Astra umgestellt haben, verfügen Sie inzwischen über drei Wochen Rechnungen und kennen bereits das Ausmaß des Problems. Astra berechnet 10 $ pro Million Input-Tokens und 50 $ pro Million Output-Tokens. Eine lang laufende Schleife mit einem umfangreichen System-Prompt und einem angehängten Tool-Schema verbraucht das schneller, als jede Tabellenkalkulation vorhergesagt hätte.
Am 22. September hat OpenAI GPT-6 Sol für 2 $ und 10 $ veröffentlicht. Dieselbe Modellfamilie, dieselbe API-Oberfläche, ein Fünftel des Preises auf jeder Rechnungsposition.
Das ist die Migration. Was sich in Ihrem Code ändert, ist fast nichts. Was sich auf Ihrer Rechnung ändert, ist alles. Und der Teil, den die meisten Berichte am Veröffentlichungstag übersprungen haben: OpenAI behauptet immer noch, Astra sei das bessere Modell, und der veröffentlichte direkte Vergleich zwischen den beiden ist nicht der Vergleich, der er zu sein scheint.
TL;DR
- Der Wechsel von
gpt-6-astrazugpt-6-solist für die meisten Aufrufer ein einfacher Austausch des Modellstrings. Kontextfenster, maximale Ausgabe, Endpunkte, integrierte Tools, unterstützte Funktionen und Ratenbegrenzungsstufen sind identisch. - Jeder Preis sinkt um exakt das Fünffache: Eingabe von 10 $ auf 2 $, zwischengespeicherte Eingabe von 1 $ auf 0,20 $, Cache-Schreibvorgänge von 12,50 $ auf 2,50 $, Ausgabe von 50 $ auf 10 $. Ihre Rechnung teilt sich durch fünf, unabhängig vom Token-Mix.
- Sol fügt einen
noneReasoning Effort (Argumentationsaufwand) hinzu. Es beschränkt auch die Funktionsaufrufe von Chat Completions aufreasoning_effort: "none", die einzige Änderung, die eine funktionierende Integration unterbrechen kann. - Der Wissensstichtag von Sol ist der 20. April 2026. Der von Astra ist der 30. April 2026.
- OpenAI sagt, Astra „ist weiterhin unser bestes Modell in allen Bereichen.“ Der veröffentlichte Sol-versus-Astra-Benchmark führt Astra auf
lowgegen Sol aufxhighaus, misst also die Kosteneffizienz und nicht die Leistungsgrenze.
Die Preistabelle
Beide Preissätze stammen von den Modellseiten von OpenAI, gpt-6-astra und gpt-6-sol, gelesen am 23. September 2026.
| Metrik, pro 1 Mio. Tokens | GPT-6 Astra | GPT-6 Sol | Änderung |
|---|---|---|---|
| Eingabe | $10 | $2 | 5x billiger |
| Zwischengespeicherte Eingabe | $1 | $0.20 | 5x billiger |
| Cache-Schreibvorgänge | $12.50 | $2.50 | 5x billiger |
| Ausgabe | $50 | $10 | 5x billiger |
Die Abrechnungsmodifikatoren stimmen bei beiden Modellen überein. Prompts mit über 272.000 Input-Tokens werden mit dem doppelten Input- und Cache-Preis und dem 1,5-fachen Output-Preis für die gesamte Anfrage berechnet. Batch und Flex sind zum halben Preis erhältlich. Der Fast-Modus ist doppelt so teuer, und bei Astra gibt es keine Latenz-SLA.
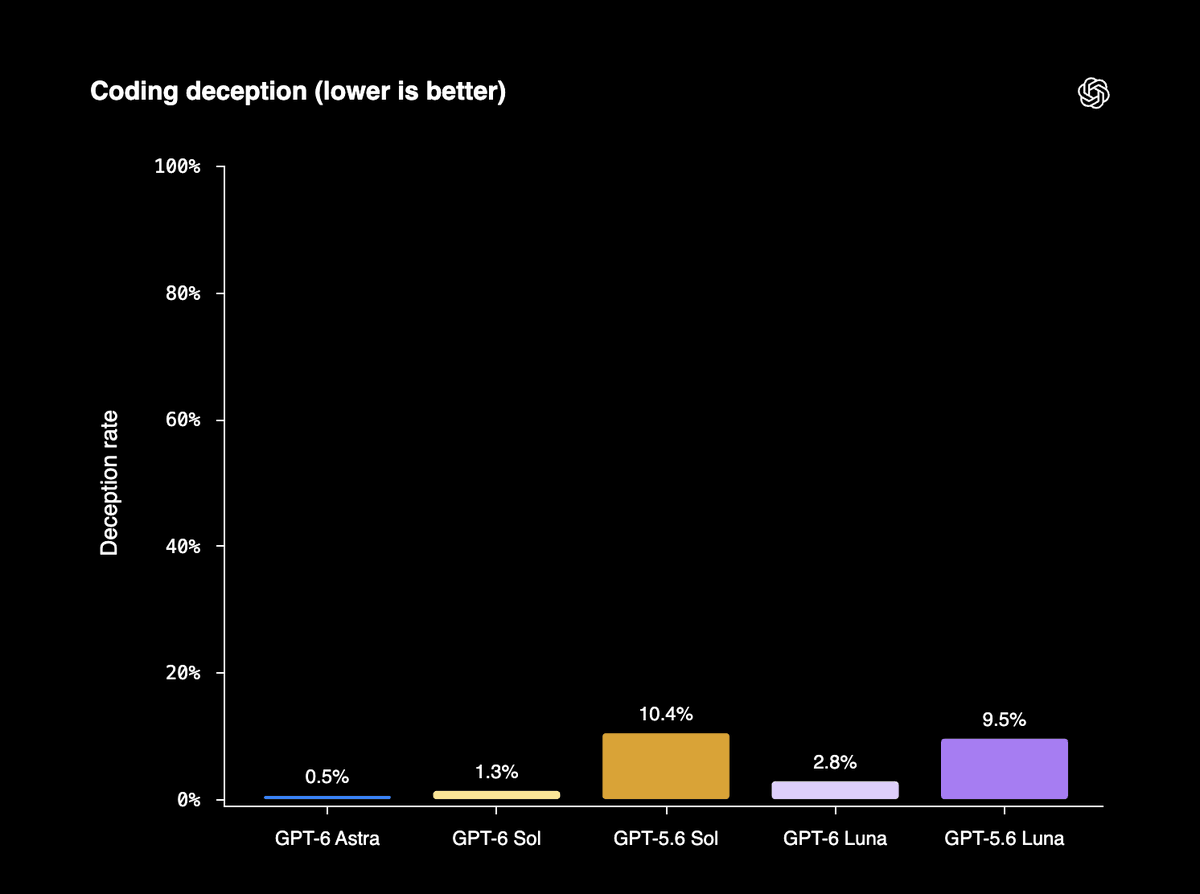
Da alle vier Raten um den gleichen Faktor sinken, müssen Sie Ihren Token-Mix nicht modellieren, um die Einsparungen vorherzusagen. Nehmen Sie eine konkrete Agenten-Workload: 10.000 Anfragen pro Tag, jede mit einem 30.000 Token großen zwischengespeicherten Präfix, 10.000 Tokens frischer Eingabe und 3.000 Tokens Ausgabe.
| Komponente | Tokens pro Tag | Astra | Sol |
|---|---|---|---|
| Zwischengespeicherte Eingabe | 300M | $300 | $60 |
| Frische Eingabe | 100M | $1,000 | $200 |
| Ausgabe | 30M | $1,500 | $300 |
| Gesamt | $2,800 | $560 |
Verschieben Sie den Mix in Richtung Ausgabe, verschieben Sie ihn in Richtung Cache, führen Sie ihn bei 272K Kontext aus und zahlen Sie den Multiplikator für lange Prompts: Das Verhältnis bleibt bei fünf.
Um zu verstehen, warum das wichtig ist: OpenAI berichtete, dass sein eigener Median-Forscher über 600 $ pro Tag für Coding-Agenten ausgibt, wobei das 90. Perzentil bei 7.000 $ pro Tag liegt. Teilen Sie diese durch fünf, und die Anzahl der Experimente, die ein Team sich leisten kann, ändert sich. Der breitere Kontext für beide Veröffentlichungen findet sich in unserer Aufschlüsselung des AI-Modell-Preiskampfes im September 2026.
Ein wichtiger Hinweis: OpenAI beschreibt Sol als 50 % günstiger als GPT-5.6, und der Vergleich bezieht sich auf die promotionalen GPT-5.6-Preise, was OpenAIs eigene Aussage ist. Im Vergleich zu den GPT-5.6-Listenpreisen, die wir damals in unserem GPT-5.6-Preisfbeitrag dokumentiert haben, ist die Reduzierung größer. Im Vergleich zu Astra ist es ein direkter Faktor 5.
Was genau gleich bleibt
Dieser Abschnitt macht die Migration günstig.
| GPT-6 Astra | GPT-6 Sol | |
|---|---|---|
| Modell-ID | gpt-6-astra |
gpt-6-sol |
| Kontextfenster | 1,050,000 | 1,050,000 |
| Max. Eingabe-Tokens | 922,000 | 922,000 |
| Max. Ausgabe-Tokens | 128,000 | 128,000 |
| Modalitäten | Text, Bild rein; Text raus | Text, Bild rein; Text raus |
| Endpunkte | Chat Completions, Responses, Batch | Chat Completions, Responses, Batch |
| Nicht unterstützt | Echtzeit, Assistenten, Fine-Tuning, Embeddings, Audio | dasselbe |
| Integrierte Tools | Websuche, Dateisuche, Bilderzeugung, Code-Interpreter, gehostete Shell, Patch anwenden, Fähigkeiten, Computernutzung, MCP, Tool-Suche | diese Liste |
| Funktionen | Streaming, strukturierte Ausgaben, Funktionsaufrufe, Dateisuche, Bildeingabe, Websuche, Prompt-Caching | diese Liste |
| Ratenbegrenzungen der Stufe 5 | 15.000 RPM, 40M TPM | 15.000 RPM, 40M TPM |
| Snapshots | gpt-6-astra |
gpt-6-sol |
Das Kontextfenster ist die Schlagzeile. Sol ist kein Modell mit kürzerem Kontext: Es bietet das gleiche 1.050.000-Token-Fenster und die gleiche 922.000-Token-Eingabegrenze wie Astra. Nichts an Ihrer Chunking-, Retrieval-Budget- oder Komprimierungsstrategie muss geändert werden.
Was sich tatsächlich in Ihrem Code ändert
Vier Dinge, in der Reihenfolge, wie sie wahrscheinlich Probleme verursachen.
1. Chat Completions Funktionsaufrufe. Bei Astra funktionieren Chat Completions, und Tool-Aufrufe erfordern die Responses API. Bei Sol unterstützt Chat Completions Funktionsaufrufe nur, wenn reasoning_effort auf "none" gesetzt ist. Wenn Sie Tools über Chat Completions mit einem anderen Aufwand aufrufen, funktioniert diese Anfrage nicht mehr wie zuvor. OpenAIs eigener GPT-6-Leitfaden empfiehlt die Verwendung von Responses für die Argumentation mit Tools. Wenn Sie bereits Responses verwenden, kostet Sie dies nichts.
2. Der none Aufwandslevel. Astra unterstützt low bis max. Sol unterstützt all diese plus none, was der Hebel ist, der es für Klassifizierungs- und Extraktionsarbeiten brauchbar macht, bei denen Reasoning-Tokens reiner Overhead sind. Standard ist bei beiden medium.
3. Wissensstichtag. Astra ist bis zum 30. April 2026 trainiert, Sol bis zum 20. April 2026. Zehn Tage sind wenig, aber wenn ein Prompt Wissen aus Ende April voraussetzt, testen Sie die Annahme.
4. Nicht unterstützte Parameter. Immer wenn der Reasoning Effort nicht none ist, müssen temperature, top_p und top_logprobs fehlen, und Chat Completions lässt auch logprobs fallen. Astra erzwingt dieselbe Regel, daher entspricht eine saubere Astra-Integration bereits den Anforderungen. Es spielt nur eine Rolle, wenn Sie zu reasoning_effort: "none" bei Sol wechseln und darüber nachdenken, temperature wieder einzufügen.
Hier ist das Vorher und Nachher für einen typischen Responses-Aufruf. Der Unterschied ist eine Zeile.
 from openai import OpenAI

 client = OpenAI()

 response = client.responses.create(
-    model="gpt-6-astra",
+    model="gpt-6-sol",
     reasoning={"effort": "xhigh"},
     tools=[{"type": "function", "name": "run_api_test", "parameters": {...}}],
     input=[
         {"role": "developer", "content": "You are a senior API engineer. Bias towards action."},
         {"role": "user", "content": "Read this OpenAPI operation and propose three negative test cases."},
     ],
 )
Beachten Sie den Aufwandslevel in diesem Beispiel. Zu Sol zu wechseln und den gleichen Aufwand beizubehalten, ist nicht die interessante Migration. Zu Sol zu wechseln und den Aufwand zu erhöhen, ist es, denn Sie haben das fünffache Budget, um für dasselbe Geld Reasoning-Tokens auszugeben.
Was Sie aufgeben
Seien Sie ehrlich in diesem Punkt, denn die Startzahlen lassen sich leicht falsch interpretieren.
OpenAI sagt, Astra ist immer noch das bessere Modell. Der Launch-Post besagt, dass Astra „weiterhin unser bestes Modell in allen Bereichen ist.“ Das ist die eigene Darstellung des Anbieters zu seiner neuen Veröffentlichung, und es ist der Satz, den man jedem zitieren sollte, der Ihnen sagt, Sol ersetzt Astra.
Der veröffentlichte direkte Vergleich ist kein Leistungsvergleich. Auf AutomationBench 1.0.6 erreicht Sol bei xhigh 33,2 % bei 0,27 $ pro Aufgabe, und Astra bei low erreicht 30,3 % bei 3,9-fachen Kosten pro Aufgabe im Vergleich zu Sol. Beachten Sie die Aufwandslevel. Sol ist voll aufgedreht, Astra ist ganz heruntergedreht. Diese Paarung demonstriert, dass Sols Obergrenze Astras Untergrenze zu etwa einem Viertel der Kosten pro Aufgabe überschreitet, was ein echtes und nützliches Ergebnis ist. Es sagt nichts über Sol bei xhigh gegenüber Astra bei max aus. Keine veröffentlichte Zahl deckt diese Konstellation ab. Wenn Ihre Workload eine war, bei der Astra mit hohem Aufwand es endlich zum Laufen brachte, ist Sol ein Test, kein Austausch.
Latenz am oberen Ende. Artificial Analysis maß die Max-Reasoning-Variante von GPT-6 Sol mit 115,2 Ausgabe-Tokens pro Sekunde bei einer Time-to-First-Token von 102,15 Sekunden. Diese Zahl stammt von einem Drittanbieter, nicht von OpenAI, und beschreibt speziell die max-Variante, sagt also nichts darüber aus, was medium oder none leisten. Betrachten Sie es als Warnung, dass das günstige Modell bei hohem Aufwand nicht automatisch das schnelle Modell ist, und messen Sie Ihren eigenen Aufwandslevel, anstatt die Zahl zu übernehmen.
Verfügbarkeit. Sol erreicht ChatGPT Work und Codex für Plus-, Pro-, Business-, Enterprise- und Edu-Benutzer und ist noch nicht in Chat verfügbar. Die API ist bereit; die Chat-Oberfläche ist es nicht.
Was Astra leistet und seine Beibehaltung in einem Teil des Stacks rechtfertigt, finden Sie in unserem zweitägigen Praxistest, dem Computernutzungs-Bericht und der Erklärung zur kritischen Cyber-Schwelle, die alle gültig sind. Das vollständige Datenblatt finden Sie in unserem GPT-6 Astra API-Leitfaden.
Entscheiden Sie mit Ihren eigenen Anfragen, nicht mit Benchmarks
AutomationBench führt Ihre Prompts nicht aus. Der einzige Vergleich, der eine Migration klärt, ist derselbe Anfragesatz, der an beide Modell-IDs gesendet und nach Ihren eigenen Kriterien bewertet wird. Richten Sie dies einmal ein, und es zahlt sich bei jeder zukünftigen Veröffentlichung aus. In Apidog legen Sie die Modell-ID in eine Umgebungsvariable, speichern die Anfrage einmal und wechseln die Umgebungen, um sie neu auszurichten:
{
  "model": "{{MODEL_ID}}",
  "reasoning": { "effort": "xhigh" },
  "input": [
    { "role": "user", "content": "{{TEST_PROMPT}}" }
  ]
}
Erstellen Sie ein Testszenario aus 20 oder 30 echten Produktions-Prompts, fügen Sie Assertions für die Antwortform hinzu, von der Ihr Parser abhängt (output_text vorhanden, Tool-Aufruf-Argumente gültig gemäß Ihrem JSON-Schema, keine Trunkierung bei max_output_tokens), und führen Sie es dann zweimal aus, einmal pro Umgebung. Apidog zeichnet den Body und die verstrichene Zeit für jede Anfrage auf, sodass Sie Korrektheit und Latenz nebeneinander erhalten, ohne ein Test-Framework schreiben zu müssen. Der usage-Block in jeder Antwort gibt Ihnen die Token-Anzahlen, um den Vergleich korrekt zu bepreisen.
Zwei Assertions sind speziell für diese Migration hinzuzufügen: Prüfen Sie, ob Tool-Aufrufe noch ankommen, wenn Sie Chat Completions verwendet haben, und beurteilen Sie dies anhand Ihres langsamsten Prompts statt Ihres durchschnittlichen, da das Latenzrisiko bei hohem Aufwand mit langen Eingaben besteht.
Migrations-Checkliste
- Bestätigen Sie, dass Sie die Responses API verwenden, wo immer Sie Tools aufrufen. Wenn Sie Tools über Chat Completions aufrufen, wechseln Sie, bevor Sie die Modelle umstellen.
- Tauschen Sie
gpt-6-astragegengpt-6-solaus und lassen Sie für den ersten Durchlauf alles andere unverändert. - Führen Sie Ihren Regressionstest erneut gegen beide IDs aus und vergleichen Sie die Ausgaben, nicht nur die Statuscodes.
- Versuchen Sie bei Sol einen Schritt mehr im Reasoning Effort. Sie haben jetzt das Budget dafür.
- Überprüfen Sie alle Prompts erneut, die auf Wissen von Ende April 2026 basieren.
- Halten Sie einen Astra-Pfad hinter einem Feature-Flag für Aufgaben bereit, bei denen die Obergrenze das war, wofür Sie bezahlt haben.
Fazit
Die Migration von Astra zu Sol ist eine seltene Migration, bei der sich die API-Oberfläche nicht ändert, das Kontextfenster nicht schrumpft und der Preis bei jeder Metrik um einen festen Faktor sinkt. Die Arbeit liegt nicht im Code. Sie liegt in den zwanzig Prompts, die Sie durch beide Modelle laufen lassen, um herauszufinden, ob Ihre schwierigste Aufgabe Astras Spielraum genutzt oder Sie nur dafür bezahlt haben.
Führen Sie diesen Vergleich durch, bevor Sie das Flag umschalten, und behalten Sie dabei OpenAIs eigenen Satz im Auge, während Sie die Ergebnisse lesen: Astra ist immer noch ihr bestes Modell. Sol ist dasjenige, das Sie sich leisten können, laufen zu lassen.