
GPT-6 Astra steigerte den MATH-500-Wert von Qwen3.5-0.8B von 7,9 % auf 48,1 %, ohne jegliches Training. Es las die Gewichte des Modells, fand eine Richtung, die das Modell in seinem Denken in eine Schleife laufen ließ, und subtrahierte sie von zwei MLP-Schichten. Diese Bearbeitung betraf 131.072 Gewichte, 0,016 % des Modells. Die Zahlen stammen aus einem Beitrag vom 2. November von vier Forschern des MIT CSAIL, und das bearbeitete Modell ist öffentlich, sodass Sie die Behauptung selbst überprüfen können.
Im Folgenden: Was Weight-Space-Programmierung ist, was Astra geändert hat, wo die Methode nicht mehr funktioniert und wie Sie Ihren Coding-Agenten beide Modelle mit der Apidog CLI vergleichen lassen.
Was ist Weight-Space-Programmierung?
Weight-Space-Programmierung bedeutet, dass ein universell einsetzbares LLM die Gewichte eines neuronalen Netzwerks direkt liest und schreibt, geleitet von einem in Alltagssprache formulierten Ziel, ohne Gradientenabstieg und ohne Trainingsschleife. Das Modell überlegt, was jeder Teil des Netzwerks berechnet, und ändert dann die Zahlen von Hand, so wie ein Programmierer Quellcode bearbeitet.
Der Begriff stammt aus Sparks of Weight-Space Programming von Rikiya Takehi, Jayden Teoh, Alex Zhang und Omar Khattab, veröffentlicht am 2. November 2026. Die Autoren bezeichnen jedes Ergebnis als „sehr früh“, und mehrere stammen aus einem oder wenigen Durchläufen. Hintergrundinformationen zum Modell, das die Bearbeitung vornimmt, finden Sie im GPT-6 Astra Hands-on-Review.
Wie GPT-6 Astra Qwen3.5-0.8B reparierte
Das Schlagzeilergebnis ist Experiment 8. Die Forscher baten GPT-6 Astra, Qwen3.5-0.8B durch Bearbeitung seiner Gewichte in Mathematik zu verbessern. Folgendes geschah Schritt für Schritt:
- Der Aufbau. Astra erhielt eine Python-Sitzung (ähnlich einem Notebook) mit geladenen Gewichten des Modells, ohne GPU, sowie 7.469 GSM8K- und 7.275 MATH-Übungsaufgaben aus den Trainingsdatensätzen. Die Testsätze sah es nie.
- Das Budget. Statt zu trainieren, konnte Astra 10, 25 oder 50 Forward-Pässe aufwenden. Ein Forward-Pass erlaubte dem Modell, bis zu 512 Probleme zu beantworten oder bis zu 1.024 Texte zu lesen.
- Die Diagnose. Astra sah, dass das Basismodell in Schleifen gerät: 85 seiner ersten 96 Übungsantworten liefen bis zum Limit von 32.768 Token, ohne eine Antwort zu erreichen. Die Autoren weisen darauf hin, dass Qwens eigene Modellkarte davor warnt, dass dieses Modell zu Denkschleifen neigt.
- Die Spur. Astra verfolgte die Schleifenbildung bis zu einer Richtung, die von den MLPs der Schichten 15 und 19 geschrieben wurde.
- Die Bearbeitung. Es subtrahierte diese Richtung von 64 Ausgabespalten von
down_projin jeder der beiden Schichten. Das sind 131.072 Gewichte von 0,8 Milliarden.
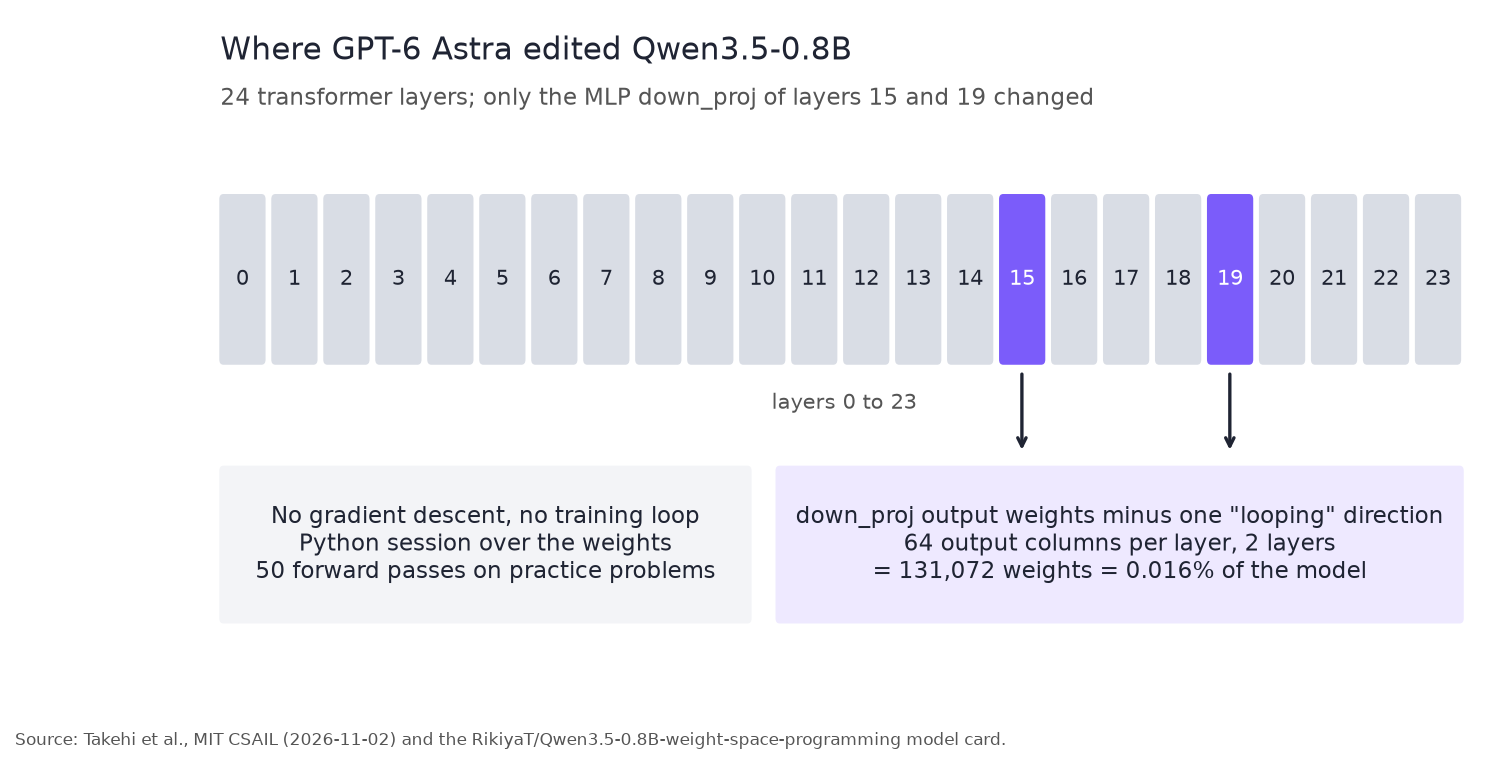
Laut der Hugging Face-Modellkarte unterscheiden sich nur diese beiden down_proj-Tensoren vom Basis-Checkpoint Qwen/Qwen3.5-0.8B, und jeder neu erstellte Tensor wird per sha256 gegen denjenigen verifiziert, den die Autoren ausgewertet haben. Das bearbeitete Modell wird unter Apache 2.0 veröffentlicht.
Ergebnisse: Basis vs. bearbeitetes Qwen3.5-0.8B
Jede Zahl hier stammt aus dem Beitrag der Autoren (Denken aktiviert, bis zu 32.768 Token, mehrere Stichproben pro Problem). „Token-Limit erreicht“ ist der Anteil der MATH-500-Antworten, bei denen die Token ausgingen.
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Token-Limit erreicht |
|---|---|---|---|---|
| Basis | 7,9 % | 13,8 % | 21,0 % | 93,0 % |
| Bearbeitet, 10 Forward-Pässe | 12,3 % | 25,7 % | 49,0 % | 87,2 % |
| Bearbeitet, 25 Forward-Pässe | 14,1 % | 25,1 % | 39,9 % | 86,4 % |
| Bearbeitet, 50 Forward-Pässe | 48,1 % | 67,1 % | 62,3 % | 33,1 % |
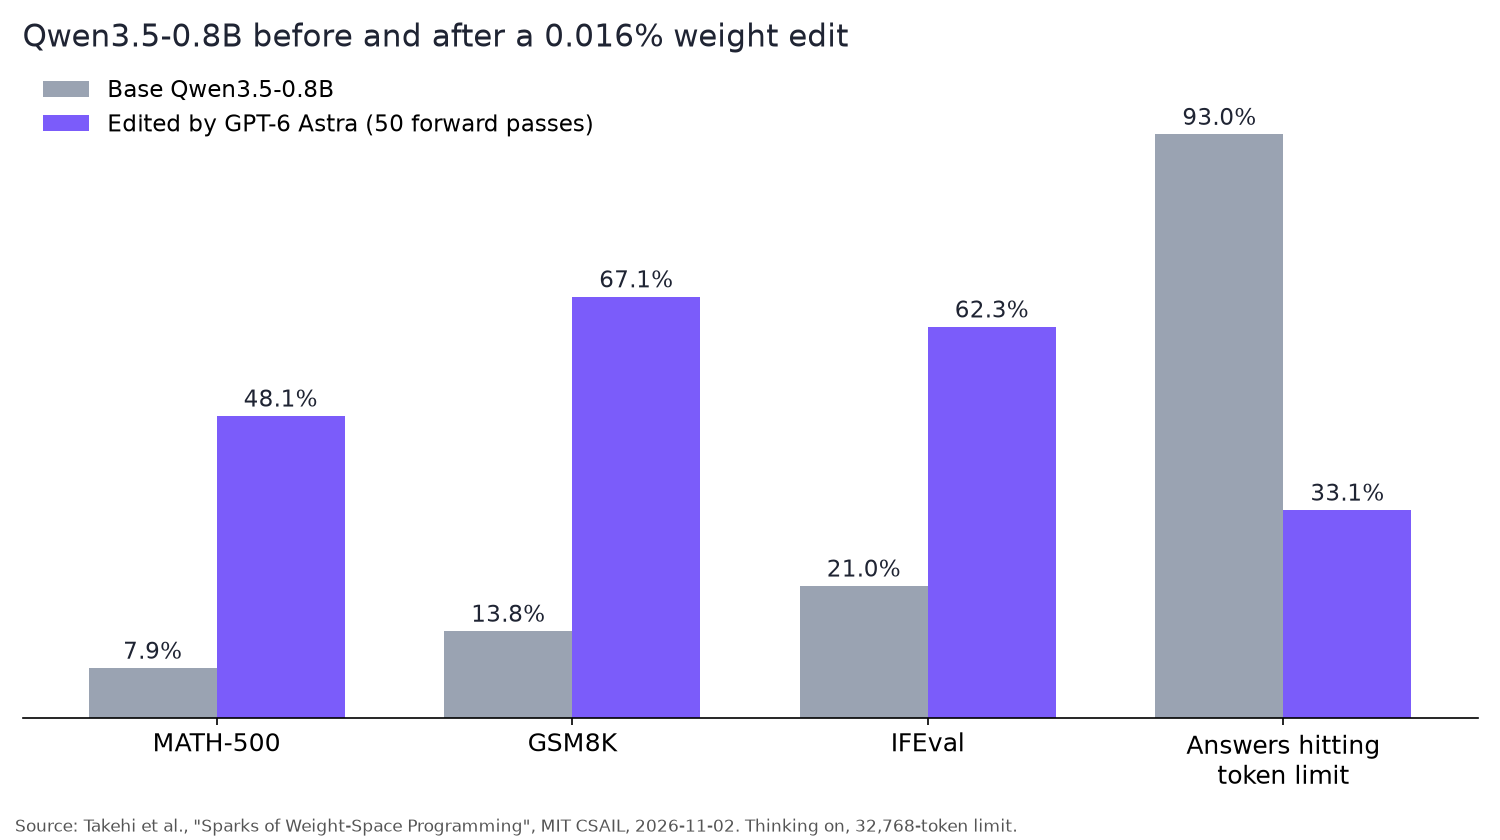
- Die Korrektur generalisierte. Schleifenbildung ist nicht mathematikspezifisch, daher verdreifachte sich IFEval ebenfalls ungefähr.
- Das Budget war entscheidend. Bei 10 oder 25 Forward-Pässen verschwanden die Schleifen kaum.
- Jemand anderes reproduzierte es. Ahsen Khaliq bei Hugging Face baute den Checkpoint aus den Logs neu auf und ließ MATH-500 vollständig erneut laufen (500 Probleme, jeweils 4 Stichproben). Das bearbeitete Modell erzielte 51,0 %, wobei 31,6 % der Antworten das Limit erreichten. Ein Smoke-Test mit 25 Problemen für das Basismodell ergab 5,0 %.
Im Demo-Space können Sie ein Problem eingeben und beiden Modellen beim Antworten zusehen.
Was das Bearbeiten von Gewichten nicht kann
Die Autoren führten eine Kontrolle durch, die wichtiger ist als das Schlagzeilergebnis. Sie versuchten denselben Ansatz bei Gemma 3 270M, einem Modell, das selten in Schleifen gerät (8,5 % seiner Antworten erreichten das Limit, gegenüber 93 % bei Qwen).
| Gemma 3 270M | MATH-500 |
|---|---|
| Basis | 6,8 % |
| Beste Bearbeitung (25 Forward-Pässe) | 7,7 % |
Gemmas Fehler waren gewöhnliche Fehler, etwa falsche Arithmetik, ohne eine einzelne Komponente, die man abschalten könnte. Die Schlussfolgerung der Autoren: Durch die Bearbeitung wurde ein Hindernis entfernt, das eine Fähigkeit verdeckte, aber sie konnte keine Fähigkeit hinzufügen, die dem Modell fehlte. Qwen konnte viele Antworten bereits erarbeiten. Es beendete sie nur nie.
Das ist also kein „Training ist vorbei“. Es ist ein Frontier-Modell, das einen Fehler findet und entfernt, der an einer einzigen Stelle sitzt.
Der Rest des Papers zur Weight-Space-Programmierung
Experiment 8 ist eines von acht. Die anderen verwenden viel kleinere Netzwerke:
- Gewichte lesen. Allein aus rohen Gewichten benannte Astra das Spiel für 4 von 4 PPO-trainierten Spielrichtlinien und die Trainingssprache für 3 von 3 kleinen zeichenbasierten Sprachmodellen.
- Eine Policy reparieren. Eine Kinetix-Auto-Policy, die in 256 von 256 Episoden fehlschlug, war in 1.024 von 1.024 erfolgreich, nachdem Astra 3,5 % ihrer Gewichte in einer einzigen Antwort bearbeitet hatte.
- Gewichte von null schreiben. Astra schrieb MinAtar-Breakout-Gewichte, die 517,4 erzielten, gegenüber 25,3 für PPO, das über 500 Millionen Schritte trainiert wurde. Bei Seaquest verlor es, 53,1 gegen 88,9.
- Go. Es schrieb aus Nullen ein 9x9-Go-Netzwerk mit 1,48 Millionen Gewichten, das mit 50 Forward-Pässen ein gleich großes PPO-Netzwerk besiegte.
- Ein Fehlschlag. Allein aus den Gewichten konnte es nicht sagen, welche von zwei Gemma 3 270M-Kopien darauf trainiert worden war, schmeichlerisch zu sein. Mit Zugriff auf Attention-Muster wählte es in allen drei Paaren den Schmeichler aus.
Die vollständigen Experimentprotokolle enthalten jeden Prompt, Astras Zusammenfassungen seiner Überlegungen und jedes Stück Code, das es ausgeführt hat.
Prüfen Sie die Behebung der Denkschleife von Qwen3.5-0.8B selbst
Der sauberste Test besteht darin, beide Checkpoints hinter derselben OpenAI-kompatiblen API zu betreiben und ihnen identische Prompts zu senden. vLLM erledigt dies mit einem Befehl pro Modell:
vllm serve Qwen/Qwen3.5-0.8B --port 8001 \
  --served-model-name qwen --max-model-len 34816 --gpu-memory-utilization 0.45

vllm serve RikiyaT/Qwen3.5-0.8B-weight-space-programming --port 8002 \
  --served-model-name qwen --max-model-len 34816 --gpu-memory-utilization 0.45
Beide Server hören auf den Namen qwen, sodass ein Anfrage-Body an beiden Ports funktioniert. --max-model-len 34816 entspricht dem Beispiel der Modellkarte.
Jede Anfrage bildet die Sampling-Einstellungen der Autoren nach und aktiviert das Denken:
{
  "model": "qwen",
  "messages": [{"role": "user", "content": "{{question}}\nPlease reason step by step, and put your final answer within \\boxed{}."}],
  "temperature": 0.6,
  "top_p": 0.95,
  "top_k": 20,
  "presence_penalty": 1.5,
  "max_tokens": 32768,
  "chat_template_kwargs": {"enable_thinking": true}
}
Der letzte \boxed{}-Wert ist die Antwort, und finish_reason gibt an, ob das Modell gestoppt hat (stop) oder die Token ausgegangen sind (length). Ein length-Abschluss ist eine Schleife.
Wenn Sie lieber keine GPU betreiben möchten, können Sie die GPT-6 Astra API auf dieselbe Weise testen oder kleine Qwen-Modelle lokal mit dem kostenlosen Qwen3.5-Ollama-Setup vergleichen.
Lassen Sie Ihren Coding-Agenten beide Modelle mit der Apidog CLI testen
Zwanzig lange Generierungen von Hand zu bewerten ist eine Aufgabe für Ihren Coding-Agenten. Apidog CLI bietet dem Agenten Umgebungen, Testszenarien, datengesteuerte Läufe und Berichte, und sie läuft auf Ihrem Rechner, sodass localhost-Endpunkte funktionieren.
Installieren Sie sie und geben Sie Ihrem Agenten den Skill:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Geben Sie dann Claude Code, Codex, Cursor oder OpenCode einen Prompt:
In Apidog project <id>, create two environments: qwen-base at http://localhost:8001
and qwen-edited at http://localhost:8002. Create a test scenario that POSTs to
/v1/chat/completions with the body in request.json, using {{question}} from the
first 10 GSM8K test questions in gsm8k-10.csv. Assert that the last \boxed{} value
equals {{answer}} and that choices[0].finish_reason is not "length". Run it against
both environments and give me a table: correct answers and length finishes per model.
Der Agent liest das Payload-Schema, validiert sein JSON und führt dann diese Befehle aus:
apidog environment create qwen-base --project <id> --base-url http://localhost:8001
apidog environment create qwen-edited --project <id> --base-url http://localhost:8002
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file scenario.json
apidog run -t <scenarioId> --project <id> -e <baseEnvId> \
  -d gsm8k-10.csv --timeout-request 1800000 -r cli,json --out-file qwen-base
apidog run -t <scenarioId> --project <id> -e <editedEnvId> \
  -d gsm8k-10.csv --timeout-request 1800000 -r cli,json --out-file qwen-edited
-d speist jede CSV-Zeile als eine Iteration ein. --timeout-request wird in Millisekunden angegeben, und eine Antwort in einer Schleife kann Minuten brauchen, um 32.768 Token zu verbrauchen. -r cli,json gibt eine Zusammenfassung aus und schreibt einen JSON-Bericht, den der Agent vergleichen kann. Die 10 Fragen stammen aus dem GSM8K-Testsplit.
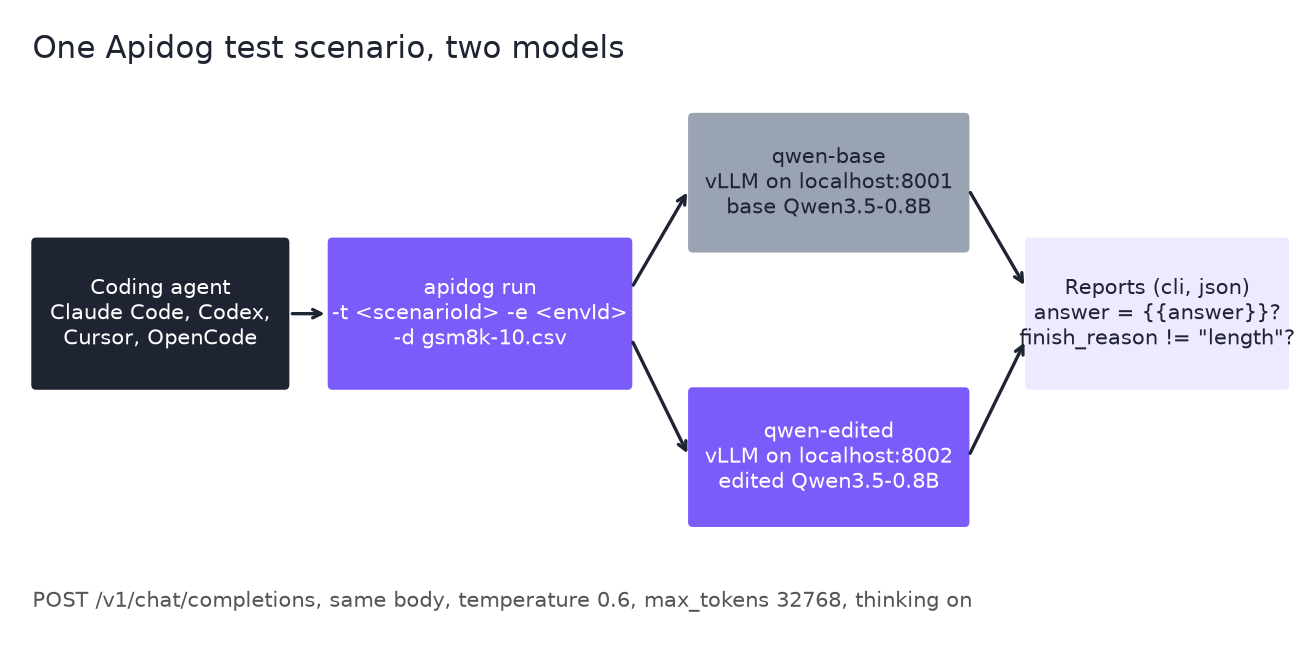
Wenn Ihr Lauf dem der Autoren ähnelt, scheitern die meisten Basisantworten an der finish_reason-Assertion und die meisten bearbeiteten Antworten bestehen sie. Zehn Fragen sind ein Smoke-Test, kein Benchmark, also behandeln Sie eine Lücke als Signal, nicht als Punktzahl. Fügen Sie --upload-report hinzu, um den Lauf in der App anzuzeigen, und lesen Sie die apidog run-Befehlsreferenz für jedes Flag.
Dasselbe Szenario funktioniert als Regressionstest für jeden Modellaustausch; der Apidog CLI CI/CD-Leitfaden zeigt das -r junit-Setup.
Was das bedeutet, wenn Sie kleine Modelle ausliefern
- Messen Sie Truncation, nicht nur Genauigkeit. Qwens 7,9 % verdeckten ein Modell, das meistens nie fertig wurde. Eine
finish_reason-Prüfung erkennt das. - Suchen Sie nach Fehlern mit einer einzigen Ursache. Schleifen und Wiederholungen können in einem schmalen Teil eines Netzwerks liegen.
- Denken Sie an den Kontrollversuch. Wenn Ihr Modell falsch statt festgefahren ist, hilft eine solche Bearbeitung nicht.
Sie wählen eine GPT-6-Stufe für Agentenarbeit aus? Siehe GPT-6 Luna vs. Sol vs. Astra.
FAQ
Hat GPT-6 Astra Qwen3.5-0.8B trainiert? Nein. Die Autoren erlaubten weder Gradientenabstieg noch eine Trainingsschleife. Astra bearbeitete Gewichte in einer Python-Sitzung und beobachtete das Modell nur über 10, 25 oder 50 Forward-Pässe.
Wie viele Gewichte hat die Bearbeitung geändert? 131.072 Gewichte, was die Autoren mit 0,016 % des Modells angeben. Die Änderungen befinden sich in den down_proj-Matrizen der MLPs in den Schichten 15 und 19, jeweils 64 Ausgabespalten.
Ist das bearbeitete Modell verfügbar? Ja, als RikiyaT/Qwen3.5-0.8B-weight-space-programming auf Hugging Face unter Apache 2.0, mit Hashes der beiden geänderten Tensoren und einem unabhängigen erneuten Lauf (51,0 % bei MATH-500).
Warum sind die Mathematikwerte so stark gestiegen? Weil das Basismodell in Schleifen geriet. Bei MATH-500 erreichten 93,0 % seiner Antworten das Limit von 32.768 Token. Die Bearbeitung senkte das auf 33,1 %, sodass das Modell Antworten beendete, die es bereits erarbeiten konnte. Es lernte keine neue Mathematik.
Funktioniert Weight-Space-Programmierung bei jedem Modell? Laut den Autoren selbst noch nicht. Bei Gemma 3 270M, das selten in Schleifen gerät, verschob die beste Bearbeitung MATH-500 von 6,8 % auf 7,7 %. Die Autoren bezeichnen alle ihre Ergebnisse als sehr früh.
Kann ich das bearbeitete Modell testen, ohne Code zu schreiben? Ja. Der Hugging Face-Demo-Space führt beide Modelle mit einem von Ihnen eingegebenen Problem aus. Für eine wiederholbare Prüfung verwenden Sie vLLM plus Apidog CLI wie oben gezeigt.