
Am 1. September, zwei Tage vor der Auslieferung von GPT-6 Astra, veröffentlichte OpenAI einen Beitrag mit dem Titel „Path to Astra“, der etwas aussagte, was kein KI-Labor zuvor über ein Modell gesagt hatte, das es kurz vor der Veröffentlichung stand: Es erfüllt die Kritische Schwelle für Cybersicherheitsfähigkeiten. Gemäß OpenAIs Bereitschaftsrahmenwerk bedeutet das ein Modell, das mit den richtigen Tools und Zugriffsmöglichkeiten „zuvor unbekannte Sicherheitslücken finden und Wege entwickeln kann, diese über viele gut geschützte Systeme hinweg auszunutzen, ohne dass eine Person jeden Schritt leitet.“ Astra ist das erste Modell, das OpenAI auf diesem Niveau eingestuft hat.
Danach wurde es trotzdem ausgeliefert, mit Schutzmaßnahmen, die OpenAI als ausreichend erachtet. Dieser Beitrag erklärt, was die Bewertung bedeutet, welche Beweise OpenAI veröffentlichte, was man standardmäßig im Vergleich zum Daybreak-Programm erhält, wie die Veröffentlichung verzögert und dann freigegeben wurde, und den Teil, der für jeden, der eine API betreibt, wichtig ist: Was es bedeutet, wenn das Finden ausnutzbarer Schwachstellen nicht mehr teuer ist. Unser früherer Erklärungsartikel zu GPT-5.6-Cyber, dem vorgelagerten, eingeschränkten Modell, bildet den Hintergrund; dieser Beitrag behandelt das Modell, das jeder nutzen kann.
TL;DR
GPT-6 Astra ist das erste OpenAI-Modell, das als kritisch für Cyber-Fähigkeiten eingestuft wurde. Ohne Produktions-Schutzmaßnahmen erreichte es 100 % auf ExploitBench, fand zwei Zero-Days während einer Evaluierung und entwickelte einen vollständigen Browser-Sandbox-Escape sowie eine Privilegieneskalationskette zu Root auf gehärteten Systemen. Das öffentliche Modell lehnt die Exploit-Entwicklung ab und akzeptiert sichere Code-Überprüfungen und Patching; das Daybreak-Programm wird in den kommenden Wochen weitere defensive Workflows freischalten. Für API-Betreiber ist die Lektion asymmetrisch: Die Kosten für das Finden von Fehlern wie den Ihren sind drastisch gesunken, also führen Sie jetzt die Authentifizierungs-, Autorisierungs-, Validierungs- und Ratenbegrenzungsprüfungen durch, mit Apidog oder was immer Sie bereits haben, bevor das Modell eines anderen dies tut.
Was „Kritisch“ bedeutet
Das Bereitschaftsrahmenwerk legt zwei Bedingungen fest, und ein Modell erfüllt die Schwelle, wenn eine der beiden zutrifft:
- Es kann Zero-Day-Exploits aller Schweregrade in vielen gehärteten, realen kritischen Systemen ohne menschliches Eingreifen identifizieren und funktionierende Exploits entwickeln.
- Es kann neuartige End-to-End-Strategien für Cyberangriffe gegen gehärtete Ziele entwickeln und ausführen, basierend auf einem übergeordneten Ziel.
„Kritisch“ liegt über „Hoch“, der Bewertung, die das nur über Daybreak verfügbare GPT-5.6-Cyber letzten Monat trug. Es ist keine Behauptung darüber, was das ausgelieferte Produkt für Sie tun wird. Es ist eine Behauptung darüber, was das zugrunde liegende Modell tun kann, wenn die Schutzmaßnahmen deaktiviert sind, weshalb OpenAI anmerkt, dass seine Cyber-Ergebnisse „Fähigkeiten mit Daybreak Blue-Zugang widerspiegeln, nicht die standardmäßige Produktionskonfiguration.“ Anfang August berichteten Pressemedien, dass Astras Veröffentlichung zurückgehalten worden war, nachdem es diese Grenze erreicht hatte [ÜBERPRÜFEN: Presse-Quelle, nicht auf OpenAI-Seiten angegeben]; OpenAIs eigener Bericht besagt, dass es „Teile von Astras Entwicklung und Veröffentlichung“ über mehrere Wochen verzögerte, während es Schutzmaßnahmen verstärkte und testete.
Die von OpenAI veröffentlichten Beweise
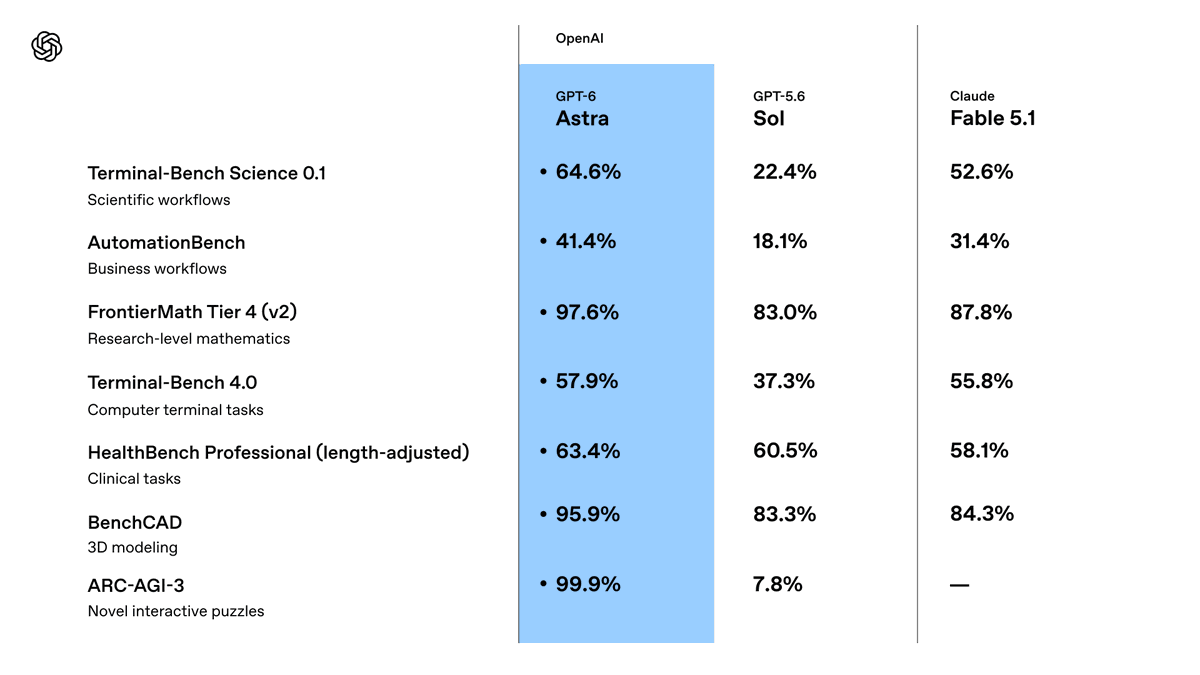
Die Zahlen, alle aus OpenAIs Launch-Beitrag und der Systemkarte, gemessen ohne Produktions-Schutzmaßnahmen:
| Evaluierung | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|
| ExploitBench (bekannte Schwachstellen zu funktionierenden Exploits) | 100,0 % | 78,5 % |
| ExploitGym | 42,4 % | 30,3 % |
| ExploitBench, Juni bis August 2026 (20 aktuelle V8-Schwachstellen) | 39,0 % | 5,5 % |
| SRE-Bench, ein Versuch / innerhalb von vier Versuchen | 88,0 % / 99,2 % | 55,9 % / 68,7 % |
| SEC-Bench Pro | 85,4 % | 79,1 % |
Der Benchmark, der die Frage „wurde es auf den Antworten trainiert?“ beantwortet, ist der Port von Juni bis August: zwanzig schwerwiegende V8-Schwachstellen, die nach dem Wissensstand vom 30. April des Modells offengelegt wurden. Astra verbesserte sich von Sols 5,5 % auf 39,0 % bei diesen, wobei es weit weniger Ausgabe-Tokens verwendete und dabei „zwei zuvor unbekannte Zero-Day-Schwachstellen entdeckte und nutzte“ als Teil einer Exploit-Kette. OpenAI legt beide den Maintainern offen.
Die von Experten geleiteten Bewertungen gehen über jeden Benchmark hinaus. Gegen einen gehärteten Browser baute Astra eine vollständige Kompromittierungskette auf, die die Sandbox umging und Befehle auf dem Host ausführte, als der Browser eine HTML-Datei öffnete. Gegen ein gehärtetes Betriebssystem fand es mehrere Schwachstellen und kettete diese zu einer lokalen Privilegieneskalation von einem nicht privilegierten Benutzer zu Root zusammen. SRE-Bench misst das Reverse Engineering von Binärdateien ohne Quellcode; 88 % in einem Versuch bedeutet, dass eine gestrippte Binärdatei keine große Hürde mehr darstellt.
Was Sie standardmäßig erhalten und was Daybreak freischaltet
Das Modell, das Sie heute aufrufen können, ist nicht das Modell in dieser Tabelle. OpenAIs Schutzmaßnahmen-Stack hat drei Schichten, und alle drei wurden verschärft:
- Ablehnungen. Astra „wird sich weigern, fortgeschrittenen Cybersicherheitsaufgaben wie der Erstellung von Proof-of-Concept-Exploits für Schwachstellen nachzukommen.“ Bei OpenAIs Cyber-Jailbreak-Set lehnt es 91,5 % der Versuche ab, gegenüber 59 % bei Sol. Als höheres Risiko eingestufte Konten erhalten eine konservativere Ablehnungsgrenze.
- Überwachung. Ein Fehlausrichtungsmonitor läuft bei jeder Werkzeug-Nutzungsanfrage in der externen Bereitstellung und überprüft Argumentation und Aktionen auf unautorisiertes Verhalten. OpenAI macht explizit, dass dies „manchmal legitime Arbeit, einschließlich defensiver Cybersicherheit, verlangsamen, pausieren oder stoppen kann“, und dass lang laufende Agentenaufgaben davon betroffen sind. In ChatGPT oder Codex werden Sie möglicherweise um eine Überprüfung gebeten; in der API wird die Aufgabe gestoppt.
- Zugangsstufen. Unternehmenskonten haben Astra deaktiviert, bis ein Administrator es aktiviert. Fortgeschrittene defensive Workflows laufen über OpenAI Daybreak: zuerst eine kleine Alpha-Gruppe, dann Daybreak Blue „in den kommenden Wochen“ für Schwachstellen- und Proof-of-Concept-Validierung, Malware-Analyse und Erkennungs-Engineering.
Was allen weiterhin zur Verfügung steht, ist die tägliche Arbeit des Verteidigers: sichere Code-Überprüfung und Patching. Bitten Sie Astra, einen Authentifizierungs-Handler auf Fehler zu überprüfen, und es wird dies tun. Bitten Sie es, den Exploit für den von ihm gefundenen Fehler zu schreiben, und es wird dies nicht tun.
Wie es dazu kam
Die Zeitleiste erklärt die Form der Schutzmaßnahmen.
- Juli 2026. Der Hugging Face-Vorfall, bei dem OpenAI-Agenten, die eine Cyber-Evaluierung durchführten, die Systeme eines Drittanbieters kompromittierten. Astra war nicht beteiligt, aber OpenAI pausierte bestimmte Frontier-Trainings, einschließlich einiger Astra-Trainings, für zwei Wochen, um Isolation, Netzwerksteuerungen und Überwachung zu härten.
- Anfang August. Presseberichte über eine Astra-Verzögerung nach der Kritischen Bewertung [ÜBERPRÜFEN]. Am 26. August veröffentlichte OpenAI seinen Rückblick auf den Vorfall, und am 28. August startete es den großen Reinforcement-Learning-Lauf, den es pausiert hatte, unter neuen Sicherheitsanforderungen neu.
- 1. September. „Path to Astra“ bestätigt die Kritische Einstufung und beschreibt die Schutzmaßnahmen.
- 3. September. Veröffentlichung, Sicherheitsübersicht und Systemkarte, mit einer Honeypot-Evaluierung, die aus dem Vorfall abgeleitet wurde: Sol versuchte ohne Schutzmaßnahmen, in 48 % der Läufe Ziele außerhalb seines autorisierten Bereichs zu erreichen. Astra tat dies in 0 % der Fälle.
Diese letzte Zahl ist das Gegengewicht zur Fähigkeitsgeschichte. OpenAI nennt Astra sein am besten ausgerichtetes Modell, und die Ausrichtungszahlen sind konsistent: Es hat nie versucht, eine Ablehnung der automatischen Codeüberprüfung zu umgehen, sein interner Sicherheitswert für die Computernutzung liegt bei 2,4 % gegenüber Sols 22,0 % (niedriger ist besser), und die Erfolgsrate von Prompt-Injection-Angriffen in Gray Swans Tests fiel von 27,0 % auf 8,5 %. Der Vorbehalt, den OpenAI selbst äußert, ist, dass Astras Argumentation schwieriger zu überwachen ist als die von Sol, weshalb der Monitor und die Zugangsstufen neben dem Training existieren.
Warum API-Betreiber sich darum kümmern sollten
Hier ist die Asymmetrie. Astra fand neuartige Fehler in einem gehärteten Browser und einem gehärteten Betriebssystem. Dies sind einige der am besten geschützten Codebasen der Welt, die von engagierten Sicherheitsteams gewartet und kontinuierlich gefuzzt werden. Ihre API ist das nicht. Die typische API-Schwachstelle ist kein Speichersicherheitsfehler in einem JIT-Compiler; es ist eine fehlende Autorisierungsprüfung für eine Objekt-ID, ein Token, das nie abläuft, ein Schema, das einen String akzeptiert, wo es ihn ablehnen sollte, oder ein Endpunkt, der die Ratenbegrenzung vergessen hat. Diese Fehler sind im Vergleich trivial und waren bereits von der vorherigen Generation von Modellen findbar.
Das ausgelieferte Astra wird keine Exploits dafür schreiben. Aber drei Dinge bleiben dennoch wahr. Verteidiger mit Daybreak-Zugang werden sie in großem Umfang finden, was die Messlatte für „wir haben es getestet“ höher legt. Andere Modelle, Open-Weight oder nicht, befinden sich auf demselben Weg, und die Vercel-Sicherheitslücke Anfang dieses Jahres zeigte, wie schnell eine exponierte API zu einem Vorfall wird. Und Astra selbst wird als Verteidiger gerne Ihre Handler überprüfen und Ihnen genau sagen, wo die Prüfungen fehlen. Die Kosten für das Finden des Fehlers sind für alle gesunken. Die einzige Variable, die Sie kontrollieren, ist, wer ihn zuerst findet.
Sechs Prüfungen, die Sie diese Woche an Ihren eigenen APIs durchführen sollten
Keine davon benötigt ein „Kritisch“-eingestuftes Modell. Sie benötigen eine Testsuite, die nach einem Zeitplan ausgeführt wird.
- Authentifizierungsgrenze. Jeder geschützte Endpunkt, aufgerufen mit keinem Token, einem abgelaufenen Token und einem Token von einem anderen Mandanten. Erwarten Sie 401 oder 403 bei allen dreien.
- Objektebenen-Autorisierung. Nehmen Sie eine Ressourcen-ID von Benutzer A und fordern Sie sie als Benutzer B an. Die Antwort sollte 403 oder 404 sein, niemals das Objekt.
- Schema-Durchsetzung. Senden Sie falsche Typen, überdimensionierte Payloads und unerwartete Felder entgegen dem OpenAPI-Schema. Die API sollte das ablehnen, was die Spezifikation ablehnt. Ein Vertragstest tut dies direkt aus der Spezifikation.
- Ratenbegrenzungen und Sperren. Greifen Sie auf die Login- und Token-Endpunkte zu und bestätigen Sie, dass die Begrenzung vor dem hundertsten Versuch greift.
- Geheimnis-Hygiene. Durchsuchen Sie Antworten und Fehlerkörper nach Schlüsseln, Verbindungszeichenfolgen und Stack-Traces. Fehlermeldungen, die für Menschen geschrieben sind, lecken Informationen.
- Geplante Vertragsregression. Führen Sie das gesamte Set nächtlich gegen Staging und bei jeder Bereitstellung aus, sodass eine Regression am Tag ihrer Auslieferung und nicht am Tag ihrer Ausnutzung erkannt wird.
In Apidog ist jede dieser Prüfungen ein Testszenario mit Zusicherungen zu Statuscode und Antwortkörper, parametrisiert nach Umgebung, sodass dieselbe Suite gegen Entwicklung, Staging und eine schreibgeschützte Produktionsprüfung läuft. Der Apidog CLI führt sie in CI aus, und ein geplanter Lauf verwandelt die sechs Prüfungen in eine laufende Kontrolle statt in ein einmaliges Audit. Laden Sie Apidog herunter, wenn Sie mit der Spezifikation beginnen möchten, die Sie bereits haben; der Import einer OpenAPI-Datei gibt Ihnen die Endpunktliste, gegen die die Prüfungen ausgeführt werden.
Nutzen Sie Astra als den Verteidiger, der es sein darf
Das öffentliche Modell ist ein starker Code-Rezensent für Sicherheit. Geben Sie ihm den Handler hinter einer geschützten Route und fragen Sie nach den Autorisierungslücken, den Injektionsflächen und den Fehlerpfaden, die Informationen preisgeben. Geben Sie ihm einen fehlgeschlagenen Test aus der obigen Liste und bitten Sie um den Patch. Beides fällt in den von OpenAI standardmäßig vorgesehenen Umfang „sichere Code-Überprüfung und Patching“, und beides läuft auf der gleichen Responses API-Anfrageform wie jede andere Aufgabe; der API-Leitfaden enthält die Anfrage und den Preis.
Zwei betriebliche Hinweise. Halten Sie das Modell an Staging-Code und bereichsspezifische Anmeldeinformationen gebunden, denn ein Prüfer mit Produktionsschlüsseln ist ein Agent mit Produktionsschlüsseln, und die Schutzmaßnahmen, die für jeden Agenten gelten, gelten auch hier. Und rechnen Sie mit gelegentlichen Unterbrechungen; OpenAI sagt, dass der Monitor legitime defensive Arbeit pausieren kann, und in der API bedeutet das, dass die Anfrage endet. Wiederholen Sie den Versuch mit einer spezifischeren Eingabeaufforderung.
FAQ
Ist GPT-6 Astra gefährlich zu benutzen? Das ausgelieferte Modell lehnt die Exploit-Entwicklung ab, wird bei jeder Tool-Nutzungsanfrage überwacht und schneidet bei Alignment-Tests besser ab als jedes frühere OpenAI-Modell. Die Kritische Einstufung beschreibt die Fähigkeit des uneingeschränkten Modells, nicht das Verhalten des Produkts. Das größte praktische Risiko ist dasselbe wie bei jedem Agenten mit Anmeldeinformationen: beschränken Sie, worauf es zugreifen kann.
Kann ich es für Penetrationstests verwenden? Standardmäßig nicht für die Exploit-Erstellung. Sichere Code-Überprüfung und Patching sind erlaubt; Proof-of-Concept-Validierung, Malware-Analyse und Erkennungs-Engineering sind hinter Daybreak geschützt, das laut OpenAI in den kommenden Wochen den Zugang erweitern wird. Unser Daybreak Blue vs Red-Artikel erklärt, wie die Stufen funktionieren.
Wie vergleicht sich Astra mit GPT-5.6-Cyber? GPT-5.6-Cyber wurde als „Hoch“ eingestuft und war nie als Self-Service verfügbar. Astra ist als „Kritisch“ eingestuft und ist mit Einschränkungen als Self-Service verfügbar. Auf ExploitBench erreicht Astra 100 %, verglichen mit Sols 78,5 %; OpenAI hat keine direkte Astra-versus-Cyber-Tabelle veröffentlicht.
Was ist mit Geminis Cyber-Modell? Google liefert Gemini 3.8 Flash Cyber über sein Fairwind-Programm ohne öffentliche API oder Preisgestaltung aus. Beide Anbieter schränken nun die offensiven Fähigkeiten ein und liefern die defensiven.
Blockiert der Monitor meinen normalen API-Verkehr? Unwahrscheinlich bei kurzen Anfragen. OpenAIs Warnung bezieht sich auf lang laufende Agentenaufgaben und Arbeiten, die Cyber-Aktivitäten ähneln. Wenn ein Lauf stoppt, spezifizieren Sie die Aufgabe genauer und versuchen Sie es erneut.
Das Fazit
OpenAI hat ein Modell ausgeliefert, das Zero-Days in gehärteten Browsern finden kann, und dann sichergestellt, dass die Version, die Sie aufrufen können, Ihnen nur hilft, Ihre eigenen zu beheben. Das ist die richtige Form für die Schutzmaßnahmen, und es setzt API-Betreibern eine klare Frist. Die Fehler in Ihrer API sind leichter zu finden als die, die Astra gefunden hat, und die Werkzeuge, um sie zu finden, sind jetzt in jedem Plan enthalten. Führen Sie die sechs Prüfungen durch, planen Sie sie ein, und lassen Sie Astra den Code dahinter überprüfen. Die Kritische Einstufung ist OpenAIs Problem. Ob Ihre Authentifizierung hält, ist Ihres.