
Bei GPT-6.2 Astra vs. Claude Fable 5.2 läuft es auf Folgendes hinaus: beide kosten 8 $ pro Million Eingabe-Tokens und 40 $ pro Million Ausgabe-Tokens, beide bieten etwa eine Million Tokens Kontext und 128K Ausgabe, und beide zielen auf langes agentisches Coding ab. Die Unterschiede, die über Ihre Wahl entscheiden, sind Cache-Preise, Abrechnung bei langem Kontext, API-Eigenheiten, die Ihr Agent-Harness behandeln muss, und das Verhalten der Modelle bei Ihren eigenen Aufgaben.
OpenAI hat GPT-6.2 Astra am 17. November 2026 veröffentlicht, acht Tage nachdem Anthropic Claude Fable 5.2 ausgeliefert hatte. Dieser Leitfaden behandelt die Spezifikationen, die Kosten einer echten Agent-Session, die Anfragefehler, die einen Harness für das jeweils andere Modell lahmlegen, und wie Sie beide mit der Apidog CLI testen.
GPT-6.2 Astra vs. Claude Fable 5.2: das schnelle Fazit
Wählen Sie Claude Fable 5.2, wenn Ihr Agent lange Prompts sendet und einen großen gecachten Kontext wiederholt liest, denn dessen Cache-Lesezugriffe kosten nur die Hälfte, und das volle 1M-Fenster wird zum Standardpreis abgerechnet. Wählen Sie GPT-6.2 Astra, wenn Ihr Stack bereits auf der OpenAI Responses API basiert und Sie die gehosteten Tools wie apply_patch, gehostete Shell und Multi-Agent-Subagents nutzen möchten. Für alles andere: Testen Sie beide Modelle an Ihren eigenen Aufgaben, bevor Sie sich festlegen.
Frühe Bewertungen neigen bei der reinen Leistungsfähigkeit zu Fable. Simon Willison schrieb am Tag der Veröffentlichung, dass Astra „bei verschiedenen Benchmarks nicht ganz so hoch abschneidet wie Fable 5.2“ und dass manche Tester seinen Kommunikationsstil als verwirrend empfinden. Betrachten Sie das als Aufforderung zum Testen, nicht als Urteil.
Wie schneiden GPT-6.2 Astra und Claude Fable 5.2 bei Spezifikationen und Preis ab?
Beide Modelle listen denselben Basispreis, daher liegt der Vergleich im Detail. Alle Zahlen unten stammen von der GPT-6.2-Astra-Modellseite und der Claude-Fable-5.2-Übersicht, geprüft am 18. November 2026.
| Spezifikation | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|
| API-Modell-ID | gpt-6.2-astra |
claude-fable-5-2 |
| Veröffentlicht | 17. Nov. 2026 | 9. Nov. 2026 |
| Eingabe / Ausgabe pro 1M Tokens | 8 $ / 40 $ | 8 $ / 40 $ |
| Gecachte Eingabe (Cache-Lesezugriff) | 0,40 $ | 0,20 $ |
| Cache-Schreibzugriff | 10 $ (30 Min.), 20 $ (12 Std.) | 10 $ (5 Min.), 16 $ (1 Std.) |
| Kontextfenster | 1.050.000 (max. 922.000 Eingabe) | 1M |
| Max. Ausgabe | 128.000 | 128K |
| Lange Prompts | Über 272K Eingabe: Eingabe 2x, Ausgabe 1,5x | Volle 1M zum Standardpreis |
| Batch | 50 % Rabatt | 50 % Rabatt |
| Wissensstand | 18. Mai 2026 | Juni 2026 |
| Reasoning-Steuerung | reasoning.effort (none wird abgelehnt) |
effort, Standard high, Thinking immer aktiv |
Beide Preise sind gegenüber der vorherigen Generation um 20 % gesunken. GPT-6 Astra und Claude Fable 5 lagen beide bei 10 $ / 50 $, wie Willison anmerkt. Wenn Sie noch beim älteren Modell sind, behandeln der GPT-6-Astra-API-Leitfaden und die Claude-Fable-5.2-Preisübersicht, was sich geändert hat.
Was kostet eine Coding-Agent-Session wirklich?
Eine Coding-Agent-Session sendet selten nur einen kurzen Prompt. Bei jedem Durchlauf werden der Repo-Kontext, die Tool-Definitionen und der Gesprächsverlauf neu geladen, daher sind Cache-Lesezugriffe und Lang-Prompt-Regeln wichtiger als der Preis in der Überschrift.
Hier sind zwei Beispiel-Workloads, berechnet auf Grundlage der offiziellen Preislisten, bei Standard-Verarbeitung.
| Workload | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|
| Agent-Session: 150K Tokens in den Cache geschrieben, 1,35M Cache-Lesezugriffe, 150K Ausgabe (jede Anfrage unter 272K) | 1,50 $ + 0,54 $ + 6,00 $ = 8,04 $ | 1,50 $ + 0,27 $ + 6,00 $ = 7,77 $ |
| Eine lange Anfrage: 400K Eingabe, 8K Ausgabe, ohne Cache | 6,40 $ + 0,48 $ = 6,88 $ | 3,20 $ + 0,32 $ = 3,52 $ |
Die Session-Kosten liegen nahe beieinander, weil die Ausgabe dominiert: 150K Ausgabe-Tokens kosten bei beiden Modellen 6,00 $. Die Differenz bei den Cache-Lesezugriffen spart hier 27 Cent und wächst bei längeren Sessions.
Bei der einzelnen langen Anfrage gehen die Rechnungen auseinander. Sobald eine Astra-Anfrage 272K Eingabe-Tokens überschreitet, verdoppelt OpenAI den Eingabesatz auf 16 $ und erhöht die Ausgabe auf 60 $ für die gesamte Anfrage. Fable 5.2 berechnet einen 400K-Prompt zum gleichen Satz von 8 $ wie einen 4K-Prompt.
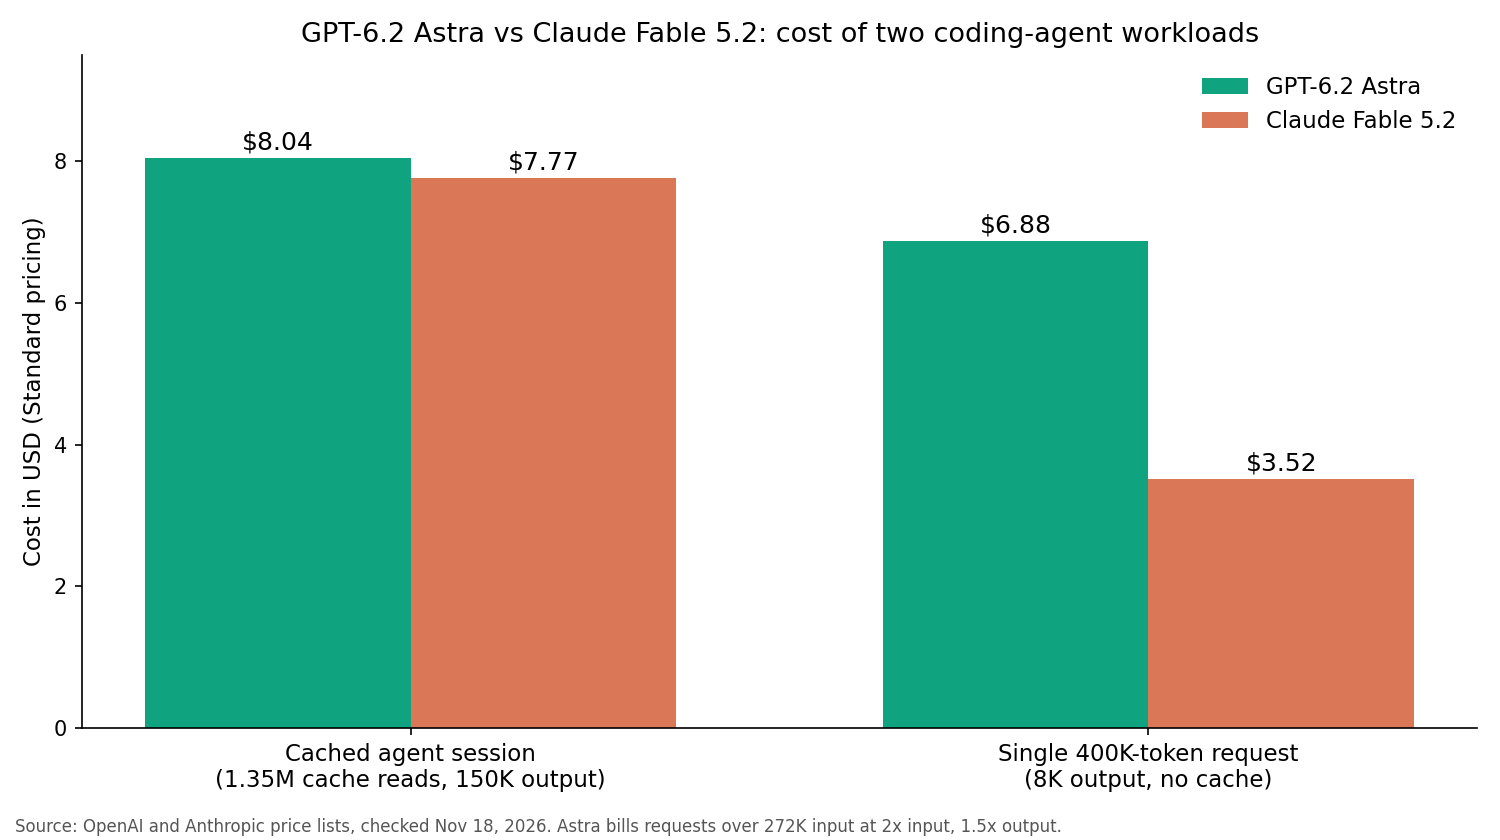
Wenn Ihr Agent ein großes Monorepo oder lange Logs in eine einzige Anfrage packt, halten Sie sie auf Astra unter 272K, oder rechnen Sie mit fast dem Doppelten.
Welche API-Eigenheiten legen einen Harness für das jeweils andere Modell lahm?
Der Modellwechsel besteht aus mehr als dem Ändern des Modell-Strings. Jede API lehnt Einstellungen ab, die die andere akzeptiert, und beide Fehler kommen als HTTP-400-Fehler zurück.
Claude Fable 5.2 lehnt ab:
- Erzwungene Tool-Nutzung. Wenn
tool_choiceaufanyodertoolgesetzt ist, gibt es einen 400er-Fehler, laut Anthropics Fable-5.2-Hinweisen. - Sampling-Parameter. Lassen Sie
temperature,top_pundtop_kweg; die von Anthropic gelisteten Werte führen zu einem 400er-Fehler. - Deaktivieren von Thinking. Adaptive Thinking ist immer aktiv, daher ist der Effort-Parameter Ihr einziger Stellhebel für Tiefe, Latenz und Kosten.
GPT-6.2 Astra lehnt ab:
reasoning.effortaufnone(Responses API) oderreasoning_effort: "none"(Chat Completions), laut OpenAIs Reasoning-Leitfaden.- Realtime-, Assistants- und Fine-Tuning-Endpunkte, die die Modellseite als nicht unterstützt listet.
Wenn Ihr Harness eine Tool-Aufruf erzwingt, um strukturierte Ausgaben zu erhalten, funktioniert das auf Astra und schlägt auf Fable fehl; verlagern Sie die Struktur in den Prompt oder das Tool-Schema. Wenn er temperature: 0 setzt, entfernen Sie es für Fable.
Auch die Datenverarbeitung unterscheidet sich. Anthropic gibt an, dass Fable 5.2 eine 30-tägige Datenaufbewahrung erfordert und nicht mit Zero-Data-Retention verfügbar ist, sofern Anthropic dies nicht ausdrücklich autorisiert. Prüfen Sie das gegen Ihre Sicherheitsrichtlinie, bevor Sie Produktionscode darüber leiten.
Wo hat GPT-6.2 Astra die Nase vorn?
Astras Stärke ist der Werkzeugkasten rund um das Modell. In der Responses API listet OpenAI apply_patch, hosted_shell, computer_use, code_interpreter, mcp, skills und tool_search als unterstützte Tools auf. Eine Multi-Agent-Beta erlaubt es Astra, Arbeit an Subagents zu delegieren.
Das ist relevant, wenn Sie nicht selbst einen Patch-Anwender und Shell-Runner bauen möchten.
Theo Brownes Feedback vor der Veröffentlichung, das Willison zitiert, besagt, dass Astra bei langen Aufgaben „viele Subagents einbinden und ziemlich gut verwalten“ kann, aber manchmal anhält, um nach internen Details zu fragen, die ein Nutzer nicht beantworten kann. Geben Sie ihm klare Abbruchbedingungen.
Astra bietet außerdem mehr Kostenebenen: Batch mit 50 % Rabatt, Fast Mode zum Doppelten des Standards und Background-Windows mit 30 % unter dem Standard für Fertigstellung in 2 Stunden und 40 % darunter für Fertigstellung in 8 Stunden. Übernächtliche Testgenerierung kann davon zu geringeren Kosten profitieren.
Wo hat Claude Fable 5.2 die Nase vorn?
Fable punktet bei langem, cache-lastigem Kontext. Seine Cache-Lesezugriffe kosten 0,20 $ pro Million Tokens, also 2,5 % des Eingabepreises, und das volle 1M-Fenster wird zum Standardpreis ohne Lang-Prompt-Multiplikator abgerechnet.
Anthropic positioniert Fable 5.2 für Agent-Sessions, die über Stunden laufen. Die Effort-Steuerung reicht von low bis max; Anthropic empfiehlt, mit high (Standard) zu beginnen und nur dann auf xhigh zu erhöhen, wo ein Gewinn messbar ist.
Außerdem fällt die frühe Resonanz bei anspruchsvollem kreativem Coding positiver aus. In Willisons Launch-Test, einem Three.js-Animations-Prompt auf beiden neuen OpenAI-Modellen mit Ultra-Effort in der Codex CLI, kam keines an das Ergebnis von Fable 5.2 heran.
Fable läuft auch auf Amazon Bedrock, Google Cloud und Microsoft Foundry, und sein Fast Mode liefert bis zu 2,5x höhere Ausgabe-Geschwindigkeit bei 16 $ / 80 $ pro Million Tokens. Beispielanfragen finden Sie im Claude-Fable-5.2-API-Leitfaden.
Wie testen Sie GPT-6.2 Astra und Claude Fable 5.2 an Ihrem eigenen API-Workload?
Benchmarks messen die Aufgaben anderer. Führen Sie stattdessen dieselben Prompts durch beide APIs:
- Wählen Sie 5 bis 10 echte Prompts aus dem Verlauf Ihres Agents, z. B. einen Bugfix, ein Refactoring und eine Testaufgabe.
- Schreiben Sie pro Modell eine Anfrage mit identischem Inhalt im jeweils eigenen Format der API.
- Prüfen Sie auf Status 200, eine nicht leere Antwort und die Struktur, die Ihr Agent parst.
- Führen Sie jede Anfrage mehrmals aus und vergleichen Sie Tokens, Latenz und Erfolgsquote.
Beide Aufrufe sind einfaches HTTP. Hier ist die Astra-Anfrage an die Responses API:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "gpt-6.2-astra", "reasoning": {"effort": "high"},
       "input": "Review this diff and list the bugs."}'
Fable 5.2 läuft über Anthropics Messages API mit claude-fable-5-2 als Modell und ohne temperature-Feld.
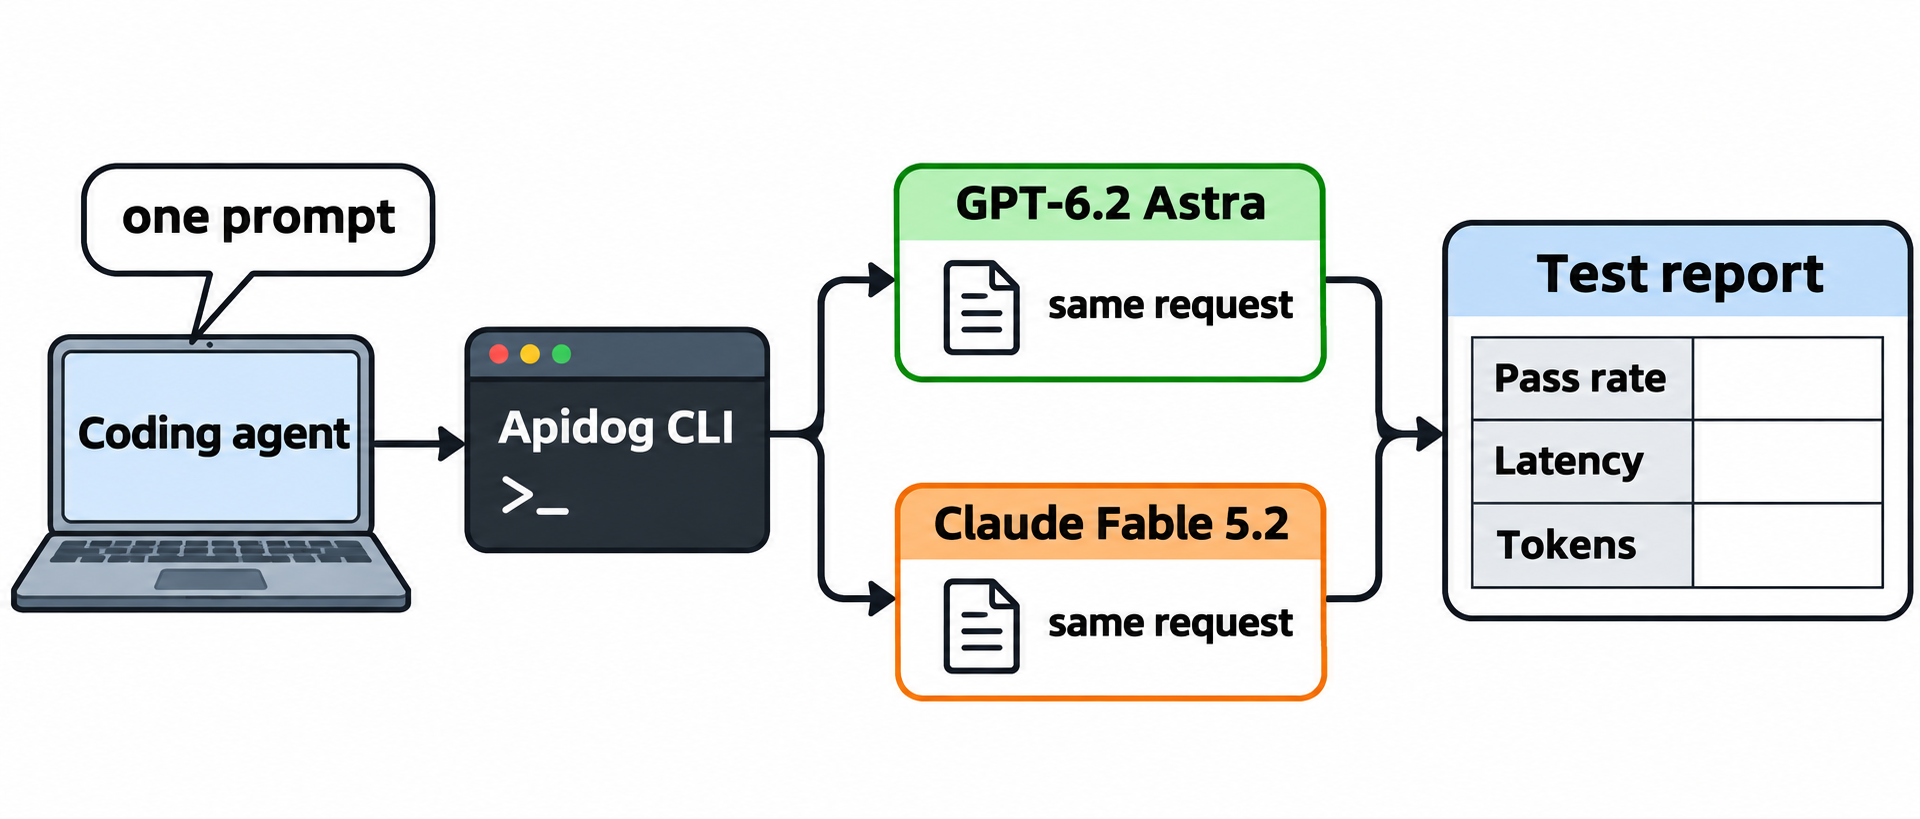
Lassen Sie Ihren Coding-Agenten den A/B-Test mit der Apidog CLI ausführen
Anfragepaare von Hand auszuführen wird schnell mühsam. Lassen Sie stattdessen Claude Code, Codex oder Cursor die Apidog CLI steuern. Das Setup umfasst drei Befehle:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Geben Sie Ihrem Agenten dann einen Prompt:
In Apidog project <PROJECT_ID>, create two test cases: one that sends
our code-review prompt to gpt-6.2-astra through the OpenAI Responses
API, and one that sends the same prompt to claude-fable-5-2 through
the Claude Messages API with no temperature field. Keep both API keys
in private environment variables. Assert a 200 status and a non-empty
answer, record token usage and response time, run each case 5 times
and summarize cost per run. Validate every payload before you write it.
Der Agent prüft das Payload-Schema, schreibt die Fälle und führt sie aus. Die folgenden Flags stammen aus apidog run --help der CLI 2.2.12:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <ASTRA_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
apidog run --test-case <FABLE_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
-n 5 wiederholt jeden Fall fünfmal, sodass eine langsame Antwort nicht über das Ergebnis entscheidet. Fügen Sie --upload-report hinzu, um die Läufe in der Apidog-App anzusehen. Dies ist eine Workflow-Vorlage; wir haben sie auf dieser Maschine nicht gegen Astra ausgeführt.
Auch den Abschnitt zu den Eigenheiten können Sie in Tests umwandeln. Lassen Sie den Agenten einen Negativfall erstellen, der tool_choice: any an Fable sendet und einen 400er erwartet, und einen, der effort: none an Astra sendet und einen 400er erwartet. Wenn ein Anbieter die Regel ändert, meldet Ihre Suite es, bevor Ihr Agent es tut. Der Leitfaden zur Apidog CLI in Claude Code und der Leitfaden zur Apidog CLI in Codex behandeln das Agent-Setup.
Apidogs kostenloser Plan umfasst bis zu 4 Nutzer, was ausreicht, um diesen Vergleich durchzuführen.
FAQ
Ist GPT-6.2 Astra günstiger als Claude Fable 5.2? Der Basispreis ist identisch: 8 $ Eingabe und 40 $ Ausgabe pro Million Tokens. Fable ist günstiger bei Cache-Lesezugriffen (0,20 $ vs. 0,40 $) und bei jeder Anfrage über 272K Eingabe-Tokens, wo Astra seinen Eingabesatz verdoppelt.
Welches Modell hat das größere Kontextfenster? Astra listet 1.050.000 Tokens Kontext mit einem Eingabe-Limit von 922.000 Tokens. Fable 5.2 listet 1M Tokens. Beide begrenzen die Ausgabe auf 128K Tokens pro Anfrage.
Kann ich erzwungene Tool-Aufrufe mit Claude Fable 5.2 verwenden? Nein. Ein tool_choice von any oder tool führt zu einem 400er-Fehler. Lassen Sie das Modell die Tools selbst wählen und beschreiben Sie die erwartete Struktur im Prompt oder Tool-Schema.
Kann ich Reasoning bei GPT-6.2 Astra deaktivieren? Nein. Die API lehnt reasoning.effort auf none mit einem 400er-Fehler ab. Wählen Sie stattdessen eine niedrigere unterstützte Effort-Stufe für schnelle, günstige Aufrufe.
Auf welchem Modell sollte ich meinen Coding-Agenten betreiben? Beginnen Sie mit Ihrem Workload. Lange, cache-lastige Prompts sprechen für Fable 5.2, während OpenAI-native Stacks, die gehostete Patch-, Shell- und Subagent-Tools wollen, zu Astra tendieren. Führen Sie beide an 5 bis 10 echten Prompts aus, bevor Sie wechseln.