
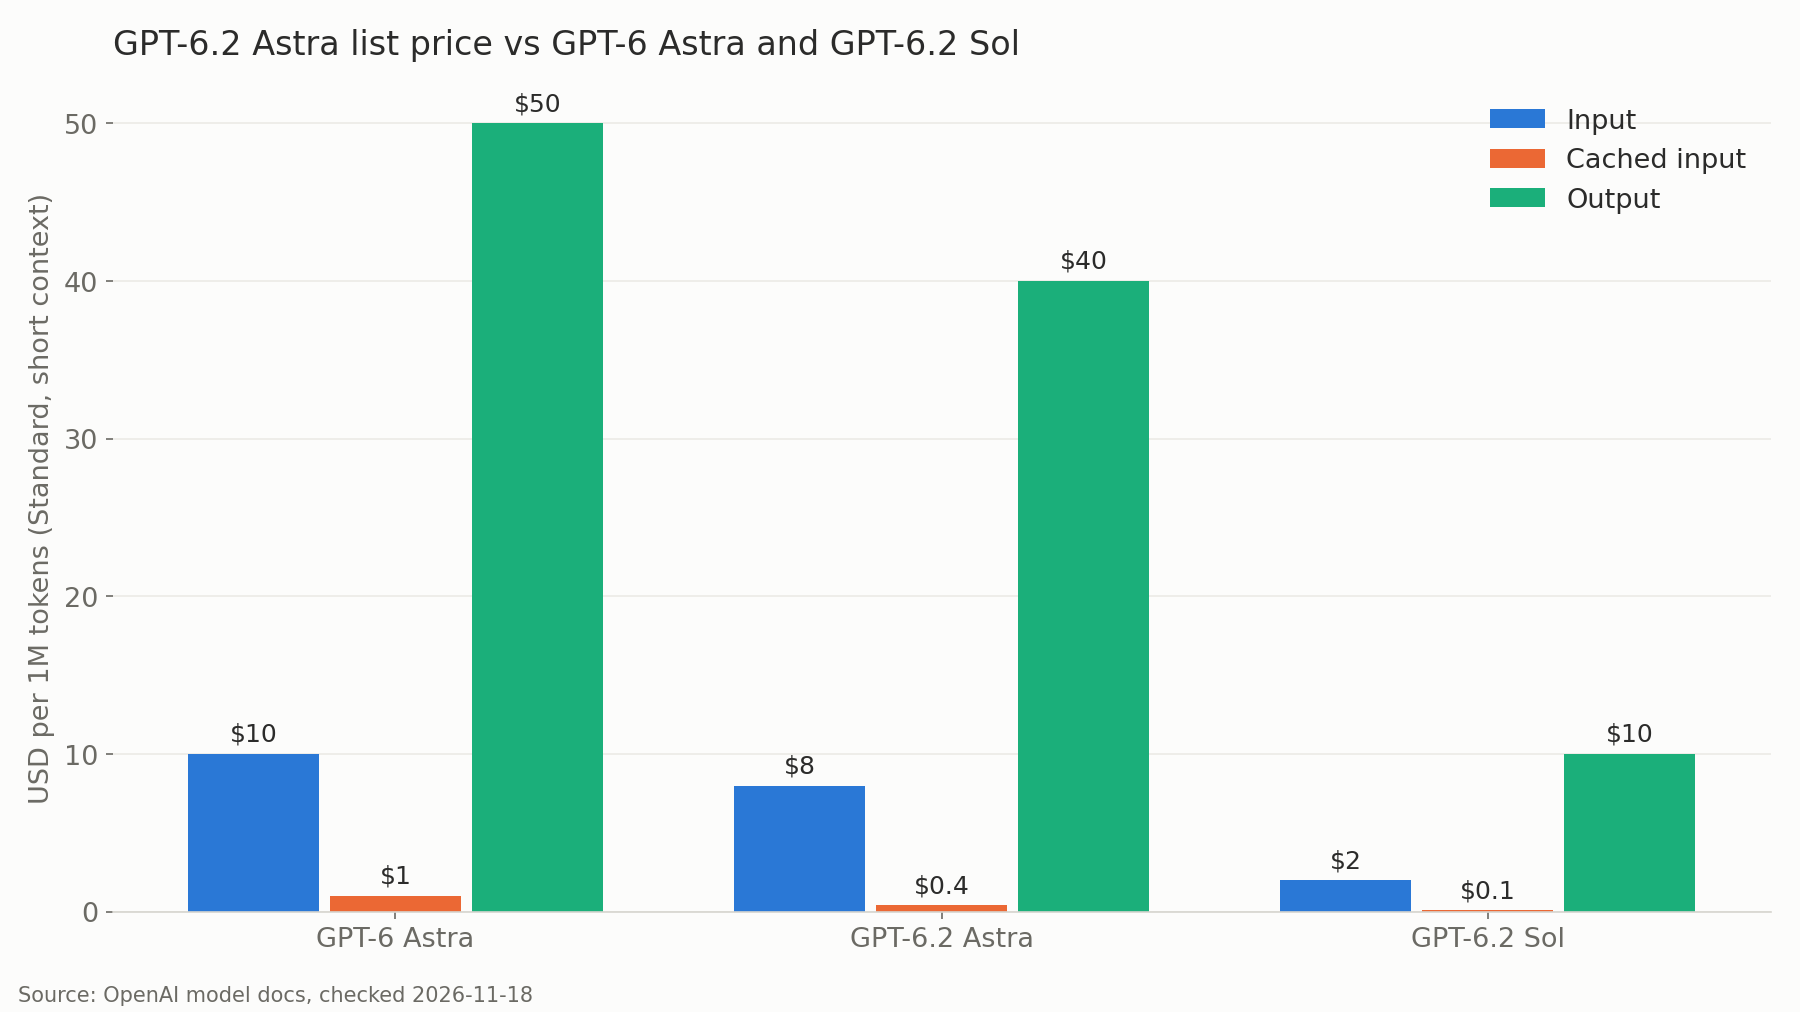
GPT-6.2 Astra kostet im Standard-Tarif von OpenAI 8 $ pro 1 Mio. Eingabe-Token und 40 $ pro 1 Mio. Ausgabe-Token, mit gecachten Eingaben zu 0,40 $/1 Mio. Das liegt 20 % unter GPT-6 Astra (10 $/50 $), und der Cache-Lesetarif ist um 60 % gesunken. Das Schwestermodell, GPT-6.2 Sol, kostet 2 $ für Eingaben und 10 $ für Ausgaben pro 1 Mio. Token.
OpenAI hat beide Modelle am 17. November 2026 als gpt-6.2-astra und gpt-6.2-sol veröffentlicht.
GPT-6.2 Astra Preise auf einen Blick
GPT-6.2 Astra ist OpenAIs Frontier-Modell für lange, anspruchsvolle Projekte: Coding, Computer-Nutzung und Dokumentenarbeit, mit einem Kontextfenster von 1.050.000 Token und bis zu 128.000 Ausgabe-Token. Im Standard-Tarif werden 8 $ pro 1 Mio. Eingabe-Token, 0,40 $ pro 1 Mio. gecachte Eingabe-Token und 40 $ pro 1 Mio. Ausgabe-Token abgerechnet – für Prompts bis 272K Token.
| Tarif (pro 1 Mio. Token, Standard) | GPT-6.2 Astra | GPT-6.2 Sol | GPT-6 Astra |
|---|---|---|---|
| Eingabe | 8,00 $ | 2,00 $ | 10,00 $ |
| Gecachte Eingabe | 0,40 $ | 0,10 $ | 1,00 $ |
| Cache-Schreibzugriff (30 Minuten) | 10,00 $ | 2,50 $ | 12,50 $ |
| Cache-Schreibzugriff (12 Stunden) | 20,00 $ | 5,00 $ | 25,00 $ |
| Ausgabe | 40,00 $ | 10,00 $ | 50,00 $ |
Reasoning-Token werden als Ausgabe-Token abgerechnet. Das ist bei Astra relevant, weil das Modell Anfragen ablehnt, bei denen der Reasoning-Aufwand auf none gesetzt ist – jede Anfrage verursacht also zusätzliche Reasoning-Kosten über der sichtbaren Antwort.
API-Kosten von GPT-6.2 Astra pro Token
Ein Eingabe-Token kostet 0,000008 $ und ein Ausgabe-Token 0,00004 $. Ausgaben sind 5-mal so teuer wie Eingaben – was das Modell schreibt, inklusive verborgenem Reasoning, macht also den Großteil Ihrer Rechnung aus.
Eine typische Chat-Anfrage mit 3.000 Eingabe-Token und 800 Ausgabe-Token kostet:
- GPT-6.2 Astra: 0,024 $ Eingabe + 0,032 $ Ausgabe = 0,056 $
- GPT-6.2 Sol: 0,006 $ + 0,008 $ = 0,014 $
- GPT-6 Astra: 0,030 $ + 0,040 $ = 0,070 $
Skaliert man das auf eine App, die täglich 20.000 solcher Anfragen bedient, ergibt das über 30 Tage 600.000 Anfragen: rund 33.600 $ mit GPT-6.2 Astra, 8.400 $ mit GPT-6.2 Sol und 42.000 $ mit GPT-6 Astra. Sol behält denselben Listenpreis von 2 $/10 $ wie GPT-6 Sol und GPT-6.1 Sol – wer bereits für Sol budgetiert, sieht keine Änderung.
Cache-Preise von GPT-6.2 Astra: die größte Änderung
Die Hauptsenkung beträgt 20 %, aber die Cache-Senkung fällt größer aus. Gecachte Lesezugriffe bei GPT-6.2 Astra kosten 0,40 $ pro 1 Mio., also das 0,05-Fache des Eingabetarifs. GPT-6 Astra verlangte 1,00 $, das 0,1-Fache. Der OpenAI-Leitfaden zum Prompt-Caching bestätigt, dass der 0,05-fache Lesetarif für GPT-6.2 Astra, GPT-6.2 Sol, GPT-6.1 Sol und GPT-6.1 Terra gilt.
Drei Regeln bestimmen Ihre Kosten:
- Schreibzugriffe ersetzen die Eingabe, sie stapeln sich nicht. Ein in den Cache geschriebener Token wird zum Schreibtarif statt zum Eingabetarif abgerechnet, nie beides. Ein 30-Minuten-Schreibzugriff kostet das 1,25-Fache der Eingabe (10 $ bei Astra), ein 12-Stunden-Schreibzugriff das 2,5-Fache (20 $).
- Das Minimum-Präfix beträgt 1.024 Token. Kürzere Prompts werden nie gecacht.
- Lesezugriffe kosten in beiden Laufzeiten dasselbe. Wählen Sie 12-Stunden-Schreibzugriffe nur für stabile System-Prompts und Referenzdokumente, die über lange Zeiträume hinweg wiederverwendet werden.
Zu diesen Tarifen lohnt sich Caching bereits bei der ersten Wiederverwendung. Ein 30-Minuten-Schreibzugriff plus ein Lesezugriff kostet das 1,30-Fache des ungecachten Preises eines Präfix, gegenüber dem 2-Fachen beim doppelten Senden. Über zehn Anfragen sind es das 1,70-Fache gegenüber dem 10-Fachen.
Simon Willison nannte den gecachten Preis „groartige Nachrichten für länger laufende agentische Sitzungen“ in seinem Artikel zum Launch-Tag. Für Tactics siehe unseren Leitfaden zum GPT-6 Prompt-Caching.
Was eine 50-Runden-Agenten-Sitzung kostet
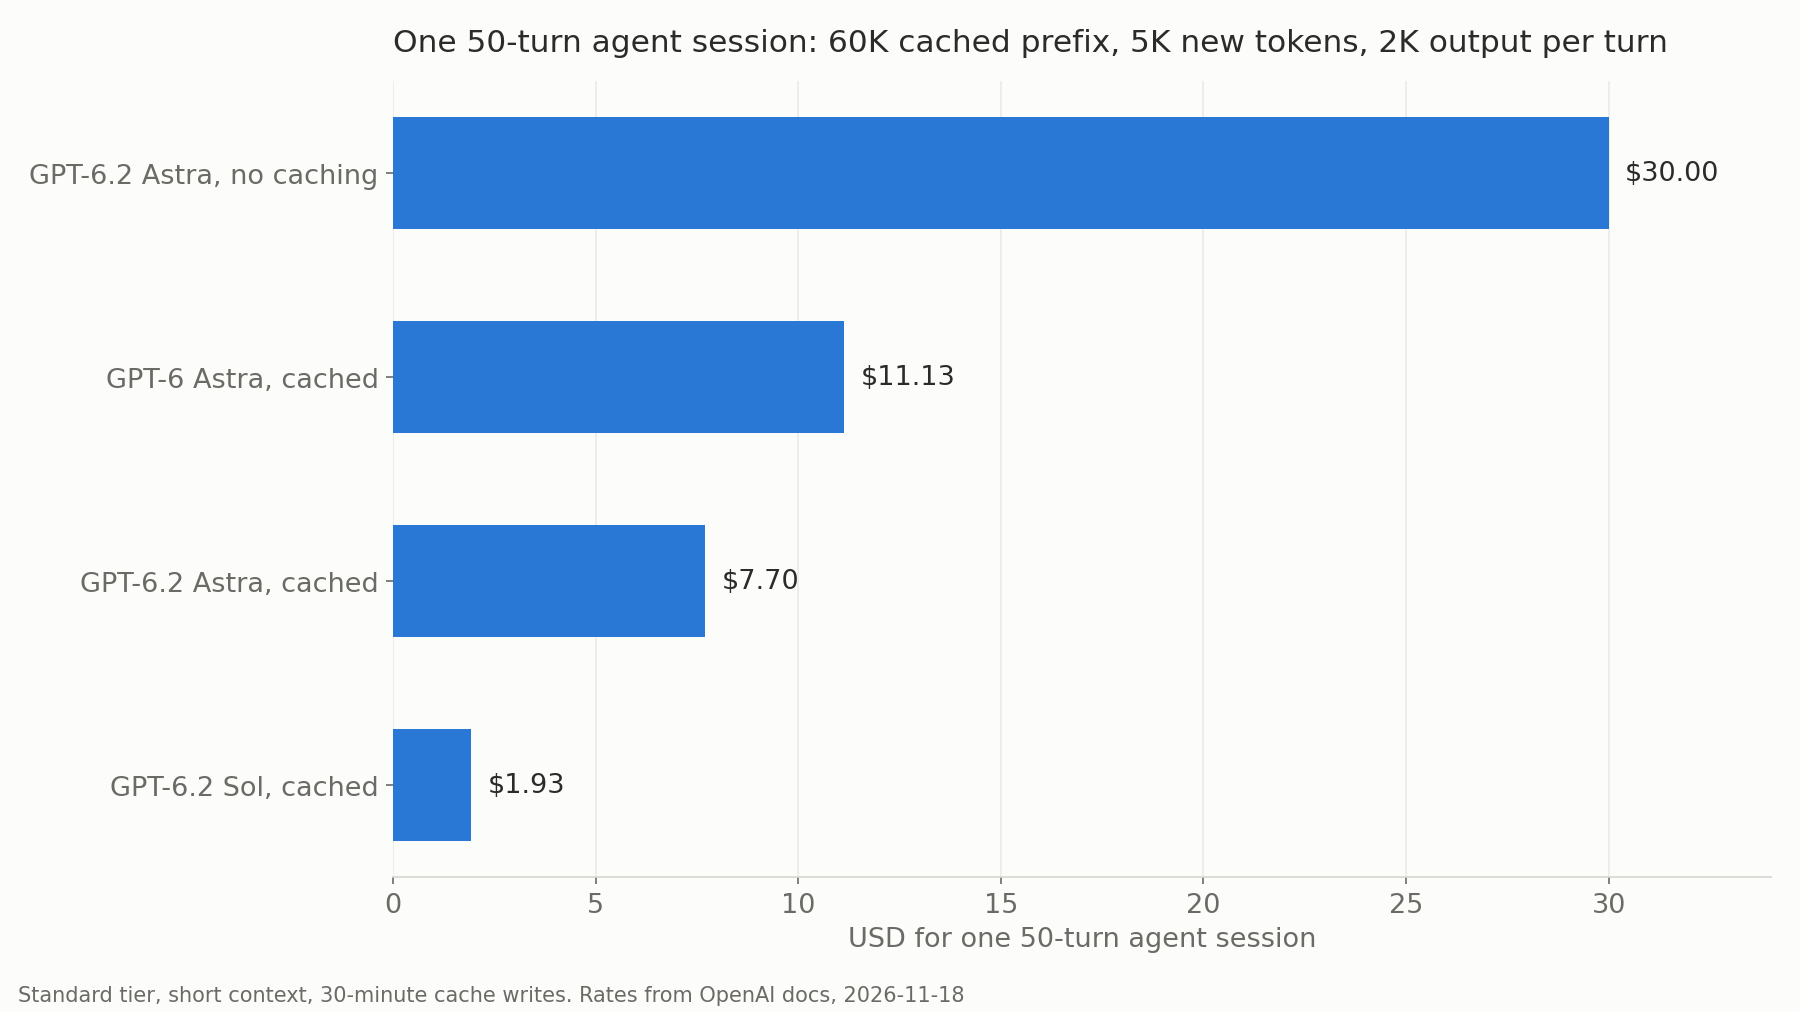
Nehmen wir einen Coding-Agenten, der 50 Runden läuft. In jeder Runde liest er ein 60K-Token-Präfix aus dem Cache, schreibt 5K neue Token in einen 30-Minuten-Cache und erzeugt 2K Ausgabe-Token.
| Modell und Setup | Kosten pro Runde | Kosten pro Sitzung |
|---|---|---|
| GPT-6.2 Astra, ohne Caching | 0,600 $ | 30,00 $ |
| GPT-6 Astra, gecacht | 0,223 $ | 11,13 $ |
| GPT-6.2 Astra, gecacht | 0,154 $ | 7,70 $ |
| GPT-6.2 Sol, gecacht | 0,039 $ | 1,93 $ |
Caching senkt die GPT-6.2-Astra-Sitzung um 74 %. Gegenüber GPT-6 Astra mit demselben Caching ist das neue Modell pro Sitzung 31 % günstiger – mehr als die 20 %ige Listenpreis-Senkung, weil das gecachte Präfix den größten Anteil der Eingabe ausmacht.
Preise für langen Kontext oberhalb von 272K Token
GPT-6.2 Astra akzeptiert bis zu 922.000 Eingabe-Token, aber der Preis ändert sich bei 272K. Sobald die Eingabe einer Anfrage 272K Token überschreitet, verdoppeln sich Eingabe- und Cache-Tarife und die Ausgabe steigt auf das 1,5-Fache – für die gesamte Anfrage, nicht nur für den Überschuss.
| Tarif (pro 1 Mio. Token) | Bis 272K Eingabe | Über 272K Eingabe |
|---|---|---|
| Eingabe | 8,00 $ | 16,00 $ |
| Gecachte Eingabe | 0,40 $ | 0,80 $ |
| Cache-Schreibzugriff (30 Minuten) | 10,00 $ | 20,00 $ |
| Ausgabe | 40,00 $ | 60,00 $ |
Eine einzelne Codebase-Überprüfung mit 400K Token und 4K Ausgabe kostet 6,40 $ + 0,24 $ = 6,64 $. Kürzt man dieselbe Überprüfung auf 250K Token, sinkt sie auf 2,00 $ + 0,16 $ = 2,16 $. Führt man die 400K-Überprüfung wiederholt durch, mit 380K Token aus dem Cache und 20K neu geschriebenen Token, kostet das etwa 0,94 $ pro Durchlauf.
Retrieval und Kürzen lohnen sich, wenn ein Prompt knapp über 272K liegt.
Batch, Background-Fenster, Fast und Ultrafast
OpenAIs Preisseite führt GPT-6.2 Astra unter vier Verarbeitungstarifen, plus vergünstigte Background-Fenster. GPT-6.2 erscheint nicht in der Flex-Tabelle, sodass die Background-Fenster diese Rolle für Arbeit übernehmen, die warten kann.
| Tarif (kurzer Kontext) | Astra Eingabe / Ausgabe | Sol Eingabe / Ausgabe |
|---|---|---|
| Standard | 8 $ / 40 $ | 2 $ / 10 $ |
| Batch (50 % Rabatt) | 4 $ / 20 $ | 1 $ / 5 $ |
| Background, 8-Stunden-Fenster (40 % Rabatt) | 4,80 $ / 24 $ | 1,20 $ / 6 $ |
| Background, 2-Stunden-Fenster (30 % Rabatt) | 5,60 $ / 28 $ | 1,40 $ / 7 $ |
| Fast (2x) | 16 $ / 80 $ | 4 $ / 20 $ |
| Ultrafast, bis 28. Februar 2027 (3x) | 24 $ / 120 $ | 6 $ / 30 $ |
| Ultrafast, ab 1. März 2027 (6x) | 48 $ / 240 $ | 12 $ / 60 $ |
Die Background-Fenster sind eine öffentliche Beta über die Responses API. Man setzt background auf true und background_options.completion_window auf 2h oder 8h und lässt Streaming deaktiviert. Der Leitfaden zum Background-Modus weist auf zwei Haken hin: Diese Anfragen teilen sich das Batch-Ratenlimit, und Standard-Anfragen können keine Cache-Einträge wiederverwenden, die 2h- oder 8h-Anfragen erstellt haben.
Hier ein nächtlicher Job, der 10.000 Dokumente zusammenfasst, jeweils mit 4K Eingabe- und 500 Ausgabe-Token:
| Tarif | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Standard | 520 $ | 130 $ |
| Background, 2-Stunden | 364 $ | 91 $ |
| Background, 8-Stunden | 312 $ | 78 $ |
| Batch | 260 $ | 65 $ |
Ultrafasts 3-facher Tarif ist eine Promotion; ab dem 1. März 2027 verdoppelt er sich auf das 6-Fache – planen Sie Ihr Budget also nicht darauf.
GPT-6.2 Astra vs. GPT-6.2 Sol und rivalisierende Flaggschiffe
Astra kostet auf jeder Position exakt das 4-Fache von Sol. Sols Modellseite listet denselben Kontext von 1.050.000 Token, dasselbe Ausgabe-Limit von 128.000, dieselben Tools und dieselben Ratenlimits. Die Wahl hängt also von der Qualität pro Aufgabe ab, nicht von Funktionen.
| Modell (pro 1 Mio. Token) | Eingabe | Gecachter Lesezugriff | Ausgabe |
|---|---|---|---|
| GPT-6.2 Astra | 8,00 $ | 0,40 $ | 40,00 $ |
| Claude Fable 5.2 | 8,00 $ | 0,20 $ | 40,00 $ |
| Claude Opus 5.5 | 4,00 $ | 0,20 $ | 20,00 $ |
| GPT-6.2 Sol | 2,00 $ | 0,10 $ | 10,00 $ |
Die Claude-Preise stammen von Anthropics Preisseite, geprüft am 18. November 2026. GPT-6.2 Astra und Claude Fable 5.2 haben denselben Listenpreis von 8 $/40 $; bei Fable 5.2 kosten Cache-Treffer 0,20 $, und die Schreibtarife folgen Anthropics 5-Minuten- und 1-Stunden-Laufzeiten, nicht OpenAIs 30-Minuten- und 12-Stunden-Laufzeiten – vergleichen Sie also die realisierten Kosten auf Ihrem eigenen Traffic.
Frühe Bewertungen sind bei der Qualität gemischt. Willison stellt fest, dass GPT-6.2 Astra „bei verschiedenen Benchmarks nicht ganz so gut abschneidet wie Fable 5.2“ – führen Sie also Ihre eigene Evaluierung durch, bevor Sie sich festlegen. Wenn Sie von der vorherigen Generation kommen, behandelt unser GPT-6-Astra-API-Leitfaden die Anfragestruktur, und die Migration von GPT-6 Astra zu Sol erklärt, wann das günstigere Modell ausreicht.
Beide Modelle teilen sich dieselben Standard-Ratenlimits: 5.000 Anfragen und 1 Mio. Token pro Minute im Build-Tarif, bis zu 15.000 Anfragen und 40 Mio. Token pro Minute im Grow-Tarif.
Lassen Sie Codex Ihre GPT-6.2-Astra-Kosten mit der Apidog CLI prüfen
Preistabellen helfen nur, wenn Ihre Anfragen den Cache tatsächlich treffen und unter 272K bleiben. Ihr Coding-Agent kann das bei jedem Build mit der Apidog CLI prüfen.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Dann geben Sie Ihrem Agenten einen einzigen Prompt:
Create an Apidog test case in project <id> for POST /v1/responses with model
gpt-6.2-astra. Send the same 2,000-token system prompt twice. Assert both calls
return 200, usage.input_tokens stays under 272000, and the second call reports
usage.input_tokens_details.cached_tokens above 0. Run it against the openai
environment and summarize any failures.
Der Agent liest das Schema, validiert seine Payload, erstellt den Testfall und führt ihn aus:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Wenn eine Prompt-Änderung das Caching bricht oder eine Anfrage über 272K pusht, schlägt der Lauf fehl, bevor die Rechnung kommt. Derselbe apidog run mit -r junit lässt sich in CI integrieren; unser Leitfaden zur Apidog-CLI-CI/CD-Pipeline enthält ein Copy-Paste-Setup, und Apidog CLI in Codex behandelt die Agenten-Seite. Apidogs kostenloser Plan deckt bis zu 4 Nutzer ab.
FAQ
Wie viel kostet GPT-6.2 Astra pro 1 Mio. Token? 8 $ pro 1 Mio. Eingabe-Token, 0,40 $ pro 1 Mio. gecachter Eingabe-Token und 40 $ pro 1 Mio. Ausgabe-Token im Standard-Tarif, für Anfragen bis 272K Eingabe-Token.
Ist GPT-6.2 Astra günstiger als GPT-6 Astra? Ja. Eingabe und Ausgabe sind 20 % niedriger (8 $/40 $ vs. 10 $/50 $), gecachte Lesezugriffe 60 % (0,40 $ vs. 1,00 $). Unsere gecachte Agenten-Sitzung fiel um 31 % günstiger aus.
Wie viel kostet GPT-6.2 Sol? 2 $ pro 1 Mio. Eingabe-Token, 0,10 $ gecacht und 10 $ Ausgabe – derselbe Listenpreis wie GPT-6.1 Sol und GPT-6 Sol. Das ist auf jeder Position ein Viertel von Astras Preis.
Berechnet GPT-6.2 Astra mehr für lange Prompts? Ja. Oberhalb von 272K Eingabe-Token verdoppeln sich Eingabe- und Cache-Tarife und die Ausgabe steigt auf das 1,5-Fache für die gesamte Anfrage: 16 $ Eingabe, 0,80 $ gecacht und 60 $ Ausgabe pro 1 Mio. Token.
Kann ich einen Rabatt auf GPT-6.2 Astra bekommen? Batch kostet 50 % des Standard-Tarifs. Background-Anfragen über die Responses API erhalten 30 % Rabatt mit 2-Stunden-Fenster oder 40 % Rabatt mit 8-Stunden-Fenster (öffentliche Beta). Caching senkt wiederholte Präfixe auf das 0,05-Fache des Eingabetarifs.
Zählen Reasoning-Token auf der GPT-6.2-Astra-Rechnung? Ja. Reasoning-Token werden zum Ausgabetarif von 40 $ pro 1 Mio. abgerechnet, und das Modell lehnt den Reasoning-Aufwand none ab – planen Sie also bei jedem Aufruf Reasoning-Kosten ein.