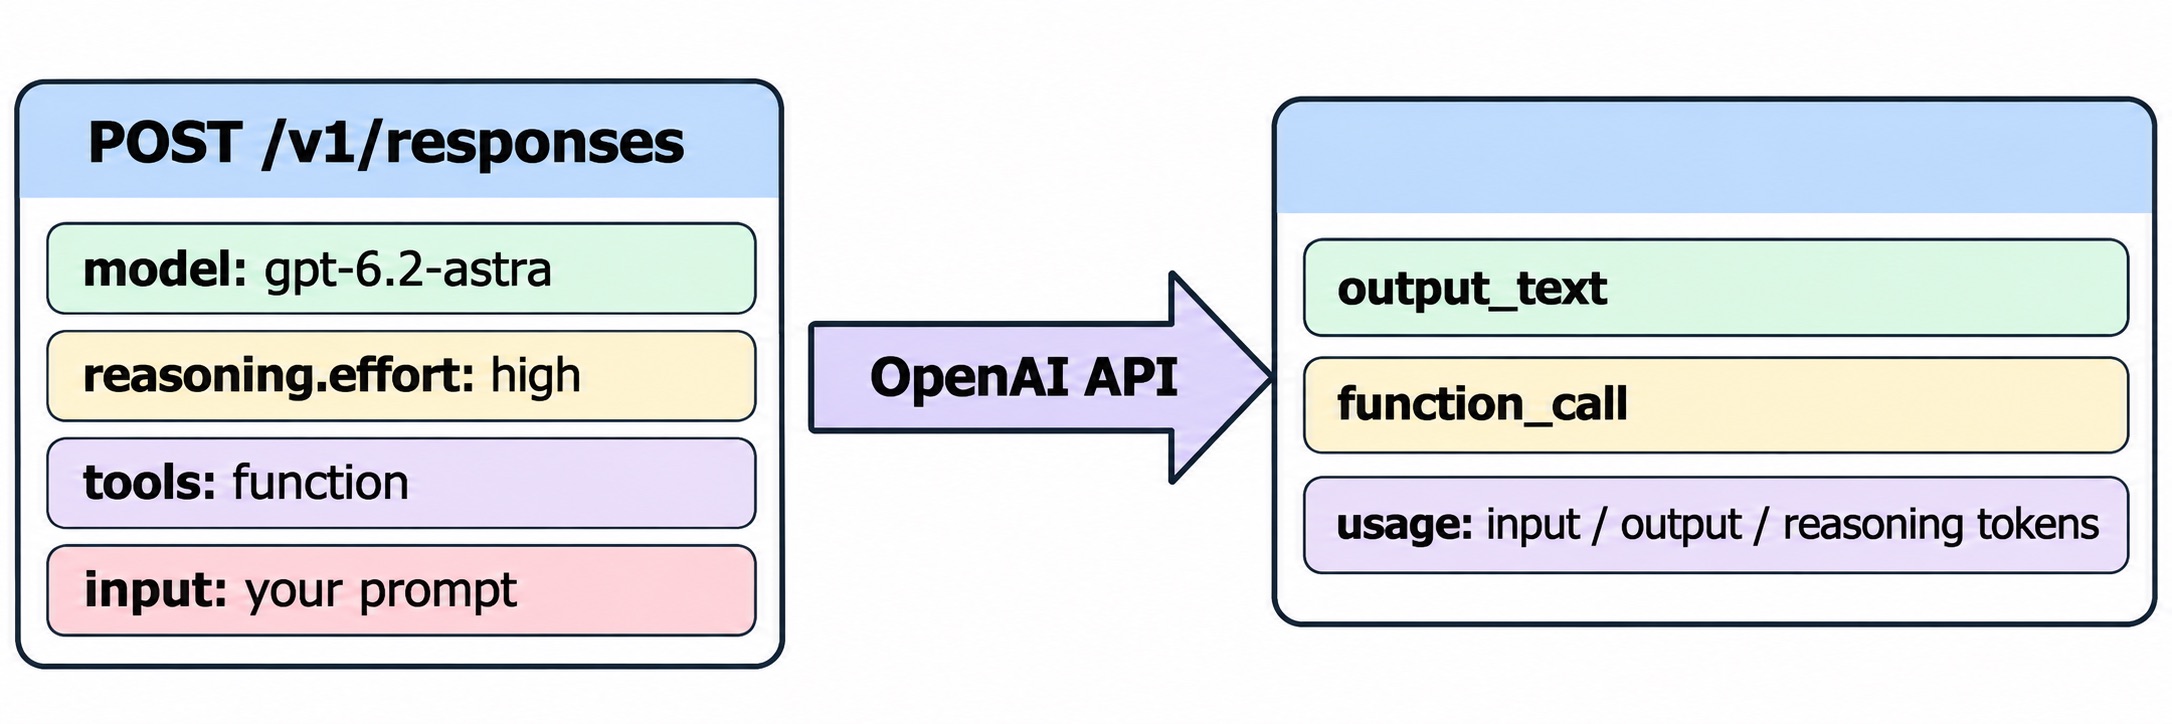
Kurze Antwort: Um die GPT-6.2-Astra-API zu nutzen, senden Sie eine Anfrage an OpenAIs Responses-Endpunkt (POST /v1/responses) mit "model": "gpt-6.2-astra", einem Reasoning-Effort wie "high" und Ihrer Eingabe. Sie kostet 8 $ pro Million Input-Tokens und 40 $ pro Million Output-Tokens, nimmt bis zu 922K Input-Tokens entgegen und liefert bis zu 128K zurück. Setzen Sie den Effort nicht auf none: Die API weist dies zurück.
OpenAI hat GPT-6.2 Astra und sein günstigeres Geschwistermodell GPT-6.2 Sol am 17. November 2026 veröffentlicht. Wenn Sie bereits GPT-6 Astra aufgerufen haben, lässt sich der Großteil Ihres Codes übernehmen. Dieser Leitfaden führt Sie durch die GPT-6.2-Astra-API – von Ihrer ersten Anfrage über Tool-Aufrufe und Effort-Abstimmung bis hin zu Preisfallen und einem wiederholbaren Test, den Ihr Coding-Agent für Sie ausführen kann.
Was Sie vor Ihrem ersten GPT-6.2-Astra-API-Aufruf benötigen
Sie benötigen vier Dinge, und drei davon haben Sie vermutlich bereits:
- Einen OpenAI-API-Schlüssel aus dem Plattform-Dashboard, exportiert als
OPENAI_API_KEY. - Eine kostenpflichtige Nutzungsstufe. OpenAIs Modellseite listet Astra-Rate-Limits ab der Build-Stufe auf (5.000 Anfragen und 1M Tokens pro Minute).
- Die Modell-ID
gpt-6.2-astra. Das günstigere Modell istgpt-6.2-sol. - Einen unterstützten Endpunkt: Responses, Chat Completions oder Batch. Realtime, Assistants und Fine-Tuning unterstützen keines der beiden Modelle.
Diese Spezifikationen stammen von OpenAIs GPT-6.2-Astra-Modellseite, geprüft am 18. November 2026.
| Spezifikation | GPT-6.2 Astra |
|---|---|
| Modell-ID | gpt-6.2-astra |
| Kontextfenster | 1.050.000 Tokens |
| Max. Input | 922.000 Tokens |
| Max. Output | 128.000 Tokens |
| Wissensstand | 18. Mai 2026 |
| Endpunkte | Responses, Chat Completions, Batch |
| Funktionen | Streaming, Function Calling, strukturierte Ausgaben, Bildeingabe, Prompt-Caching |
So stellen Sie Ihre erste GPT-6.2-Astra-API-Anfrage
Die Responses-API ist der Endpunkt, für den OpenAI neue Funktionen entwickelt – beginnen Sie also dort. Hier sind die Schritte:
- Exportieren Sie Ihren Schlüssel:
export OPENAI_API_KEY=sk-... - Senden Sie eine Anfrage mit der Modell-ID und einem Effort-Level.
- Lesen Sie
output_textfür die Antwort undusagefür die Token-Anzahl.
Mit curl:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.2-astra",
    "reasoning": { "effort": "high" },
    "input": "Review this migration plan and list the three biggest risks."
  }'
Mit dem offiziellen Python SDK (pip install --upgrade openai):
from openai import OpenAI

client = OpenAI()  # reads OPENAI_API_KEY

response = client.responses.create(
    model="gpt-6.2-astra",
    reasoning={"effort": "high"},
    input="Review this migration plan and list the three biggest risks.",
)

print(response.output_text)
print(response.usage)
Mit Node.js (npm install openai):
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.responses.create({
  model: "gpt-6.2-astra",
  reasoning: { effort: "high" },
  input: "Review this migration plan and list the three biggest risks.",
});

console.log(response.output_text);
Prüfen Sie den usage-Block bei jedem frühen Aufruf. Astra gibt Reasoning-Tokens aus, bevor es ein einziges Wort schreibt, und diese werden als Output abgerechnet. Eine kurze Antwort kann also trotzdem mehr kosten, als Sie erwarten.
Den passenden Reasoning-Effort für GPT-6.2 Astra wählen
Der Reasoning-Effort ist der größte Stellhebel sowohl für Qualität als auch für Kosten. OpenAIs Reasoning-Leitfaden listet die Werte none, minimal, low, medium, high, xhigh und max auf und weist darauf hin, dass jedes Modell nur eine Teilmenge davon unterstützt. Für GPT-6.2 Astra und Sol gilt die einzige bestätigte Regel, dass none abgelehnt wird – jedes Modell führt also zumindest etwas Reasoning durch.
| Effort | Einsatzbereich |
|---|---|
low / medium |
Einfache Bearbeitungen, Extraktion, kurze Antworten |
high |
Code-Reviews, Planung, die meisten anspruchsvollen Prompts. Ein sinnvoller Standard für den Einstieg ins Testen |
xhigh |
Lange Agent-Läufe und asynchrone Aufgaben, nur wenn Evals einen klaren Vorteil zeigen |
max |
Ihre schwierigsten Probleme, wo eine bessere Antwort das Mehrfache an Tokens wert ist |
OpenAI gibt den Standard-Effort für Astra nicht an, setzen Sie ihn daher bei jeder Anfrage explizit. So bleiben Ihre Rechnungen und Testergebnisse reproduzierbar.
Wie stark verändert der Effort die Rechnung? Simon Willison führte am Releasetag denselben Bild-Prompt mit jedem Modell auf drei Effort-Levels aus und veröffentlichte die Kosten. Astra kostete 11,55 Cent bei high, 17,70 Cent bei xhigh und 88,71 Cent bei max. Der Wechsel von high zu max verachtfachte die Kosten beinahe.
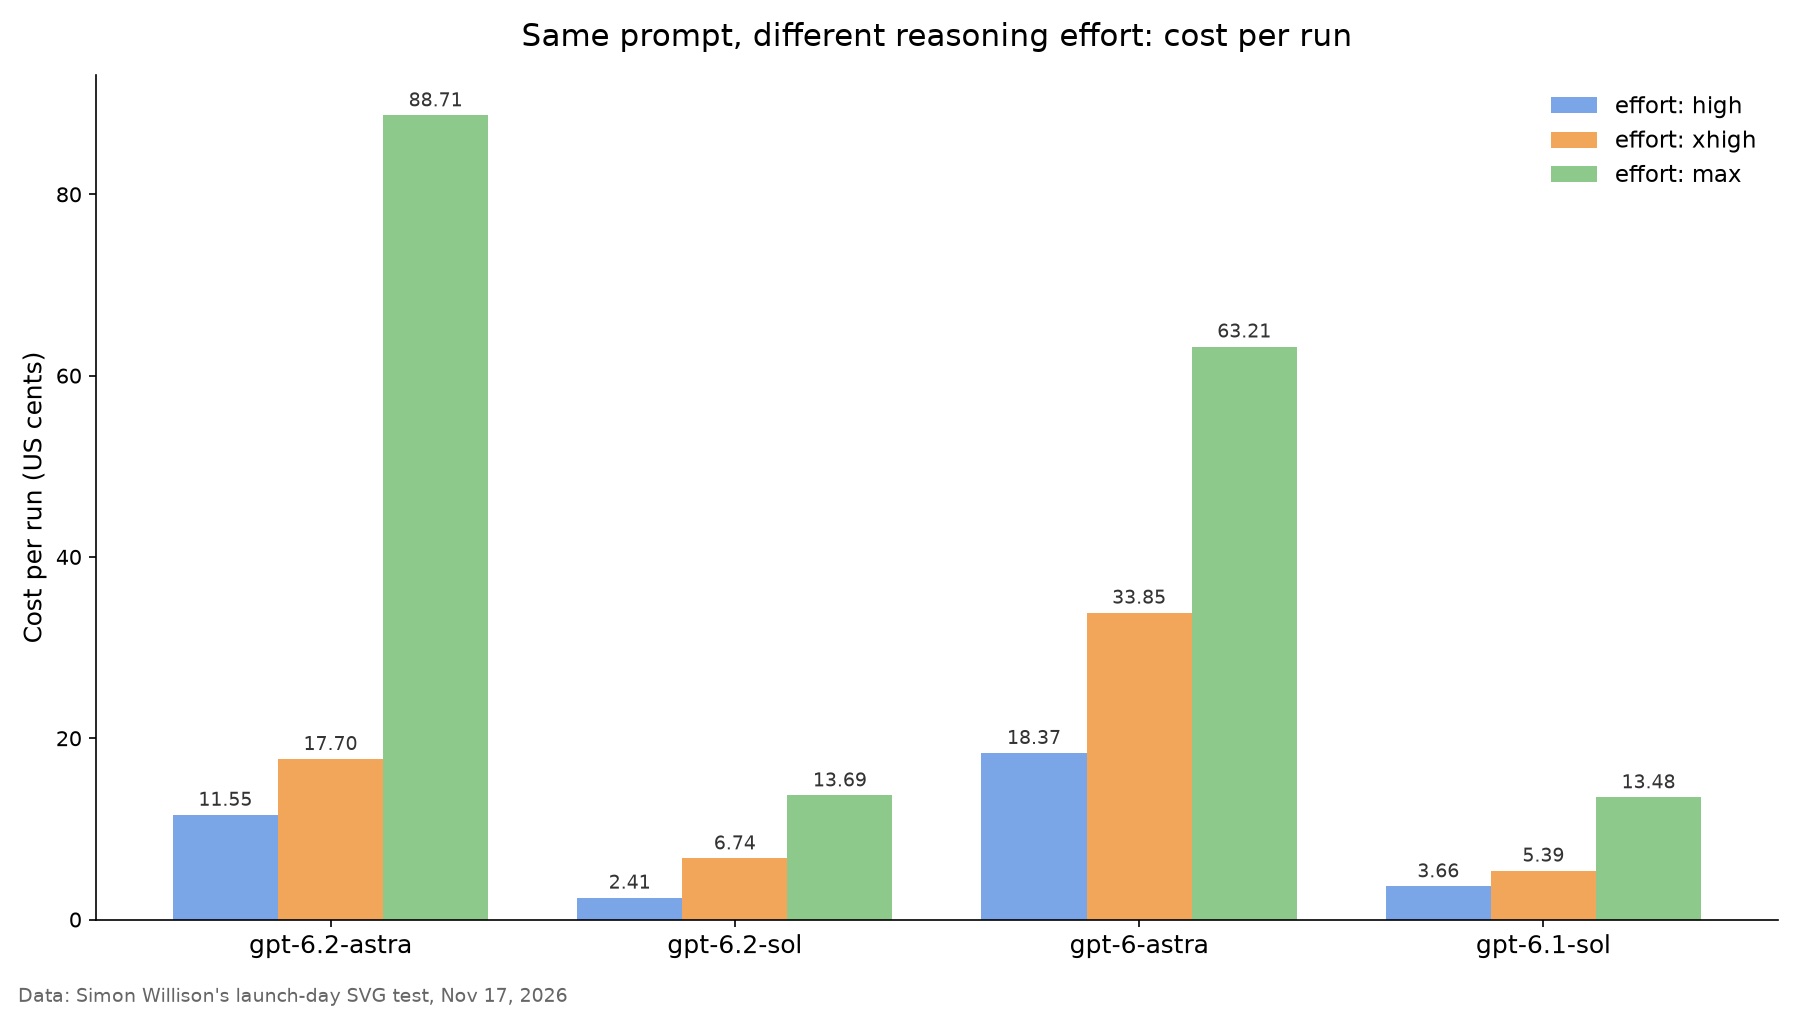
Beachten Sie, dass GPT-6.2 Astra bei high und xhigh günstiger war als GPT-6 Astra, bei max aber teurer. Der Preis pro Token sank um 20 %, doch der max-Effort denkt länger. Messen Sie die Kosten pro abgeschlossener Aufgabe, nicht die Kosten pro Million Tokens.
Tools und strukturierte Ausgaben mit der GPT-6.2-Astra-API nutzen
Astra unterstützt Function Calling, strukturierte Ausgaben und eine lange Liste gehosteter Tools in der Responses-API: Websuche, Dateisuche, Bildgenerierung, Code Interpreter, gehostete Shell, Apply Patch, Skills, Computer Use, MCP und Tool Search.
Ein Function-Tool sieht genauso aus wie bei GPT-6 Astra:
response = client.responses.create(
    model="gpt-6.2-astra",
    reasoning={"effort": "high"},
    tools=[{
        "type": "function",
        "name": "get_order_status",
        "description": "Look up an order by its ID.",
        "parameters": {
            "type": "object",
            "properties": {"order_id": {"type": "string"}},
            "required": ["order_id"],
        },
    }],
    input="Where is order A-1042?",
)

for item in response.output:
    if item.type == "function_call":
        print(item.name, item.arguments)
Führen Sie die Funktion selbst aus und senden Sie das Ergebnis dann als function_call_output-Element mit der passenden call_id zurück. Astra formuliert daraus die endgültige Antwort.
Für maschinenlesbare Ausgaben übergeben Sie ein JSON-Schema in text.format mit "type": "json_schema" und "strict": true. Das Modell gibt dann JSON zurück, das Ihrem Schema entspricht, sodass Sie es ohne Rätselraten parsen können.
Zwei Gewohnheiten helfen bei einem so fähigen Modell. Erstens: Geben Sie jedem Tool eine präzise Beschreibung und ein strenges Schema; Rezensenten am Releasetag berichteten, dass Astra bei langen, offenen Aufgaben vom Ziel abweichen kann. Zweitens: Setzen Sie max_output_tokens bei Agent-Schleifen, damit kein durchgehender Schritt Ihr Budget aufzehren kann. Hintergrundinformationen zum Endpunkt selbst finden Sie in unserem Leitfaden zur OpenAI-Responses-API.
GPT-6.2-Astra-API: Preise und Rate-Limits
Astra wird pro Million Tokens abgerechnet, mit einem Aufschlag für sehr lange Prompts. Diese Preise stammen von der Modellseite:
| Posten | GPT-6.2 Astra | GPT-6 Astra (zur Referenz) |
|---|---|---|
| Input | 8,00 $ | 10,00 $ |
| Cached Input | 0,40 $ | 1,00 $ |
| Cache-Schreibvorgänge (30 Min. Speicherung) | 10,00 $ | n/a |
| Output | 40,00 $ | 50,00 $ |
Die Falle ist die Long-Context-Regel. Sobald eine Anfrage 272K Input-Tokens überschreitet, verdoppeln sich die Input- und Cache-Preise, und Output kostet das 1,5-Fache – für die gesamte Anfrage. Ein 300K-Token-Prompt wird also mit 16 $ Input und 60 $ Output abgerechnet, nicht nur die Tokens jenseits der Grenze. Wenn Sie Astra ganze Repositories füttern, chunken oder cachen Sie unterhalb von 272K, wo immer möglich.
Batch-Jobs eignen sich für Evals und Backfills, die warten können; VentureBeat berichtet, dass Batch zum halben Preis läuft.
Standard-Rate-Limits nach Stufe:
| Stufe | Anfragen/Min. | Tokens/Min. |
|---|---|---|
| Build | 5.000 | 1.000.000 |
| Launch | 10.000 | 4.000.000 |
| Grow | 15.000 | 40.000.000 |
Behandeln Sie 429-Antworten mit exponentiellem Backoff. Ein langer Agent-Lauf bei xhigh kann ein Build-Stufen-Token-Budget schnell verbrauchen.
Migration von GPT-6 Astra zu GPT-6.2 Astra
Die meisten Codes benötigen nur eine Änderung: die Modell-Zeichenkette. Bevor Sie sie in der Produktion umstellen, prüfen Sie Folgendes:
- Modell-ID:
gpt-6-astrawird zugpt-6.2-astra. - Effort
none: Wenn ein Codepfad ihn sendet, schlägt er nun fehl. Wechseln Sie zum niedrigsten Wert, den Ihre Evals akzeptieren. - Prompt-Caching: Cached Input ist von 1,00 $ auf 0,40 $ gesunken, daher lohnt sich das Caching stabiler System-Prompts und Tool-Listen jetzt.
- Lange Prompts: Prüfen Sie Anfragen nahe 272K Tokens erneut gegen die oben genannte Long-Context-Regel.
- Sicherheit: OpenAI gibt an, dass beide GPT-6.2-Modelle seine „Critical“-Schwelle im Bereich Cybersicherheit erreichen und mit strengeren Schutzmaßnahmen ausgeliefert werden. Security-Tooling-Prompts können Ablehnungen erhalten, die es zuvor nicht gab.
Die ersten Rezensionen sind gemischt – testen Sie also, bevor Sie umstellen. Ethan Mollick nannte Astra „very uneven & weird“, und Dan Shipper sagte, es bräche bei End-to-End-Builds oft vorzeitig ab, so VentureBeat in seiner Zusammenfassung. Andere lobten sein Code-Review und Computer Use. Ihre eigenen Prompts sind der einzige Benchmark, der zählt. Der Leitfaden zur GPT-6-Astra-API behandelt, was aus der vorherigen Generation übernommen wird, und wenn der Großteil Ihres Traffics Routine ist, zeigt der Leitfaden zur GPT-6.1-Sol-API die Anfragestruktur der günstigeren Stufe.
Ihren Coding-Agenten GPT-6.2 Astra mit der Apidog CLI testen lassen
Prompts in ein Terminal einzugeben, zeigt Ihnen, wie Astra heute abgeschnitten hat. Es zeigt Ihnen nicht, wann ein Update nächsten Monat Ihr Schema bricht. Lassen Sie Ihren Coding-Agenten stattdessen den Test aufbauen und mit der Apidog CLI ausführen; Sie schreiben nur einen Prompt.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Geben Sie dann Claude Code, Codex oder Cursor einen Prompt:
In Apidog project <projectId>, create a test case for POST https://api.openai.com/v1/responses
with model "gpt-6.2-astra", reasoning effort "high" and a get_order_status function tool.
Assert status 200, that the output contains a function_call named get_order_status,
that its arguments parse as JSON with an order_id, and that usage.output_tokens is under 4000.
Read the API key from the OPENAI_API_KEY variable in environment <envId>, then run it.
Der Agent liest das Payload-Schema, prüft seine Datei, erstellt den Testfall und führt ihn aus:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Speichern Sie den Schlüssel in der Apidog-Umgebung, nicht im Prompt, damit er nie im Kontext Ihres Agenten landet. Fügen Sie --upload-report hinzu, um den Lauf in der Apidog-App zu überprüfen, oder -n 5, um ihn zu wiederholen und zu sehen, wie stabil Astras Tool-Aufrufe sind. Tauschen Sie -r junit in einer Pipeline ein, und der Test läuft bei jedem Deployment erneut; der Leitfaden zur Apidog CLI in CI/CD zeigt das Setup, und Apidog CLI in Claude Code behandelt die Agent-Seite. Apidogs kostenloser Plan deckt Teams von bis zu 4 Nutzern ab.
FAQ
Was ist die Modell-ID der GPT-6.2-Astra-API? gpt-6.2-astra. Das günstigere Geschwistermodell ist gpt-6.2-sol. Beide funktionieren auf den Endpunkten Responses, Chat Completions und Batch.
Wie viel kostet die GPT-6.2-Astra-API? 8 $ pro Million Input-Tokens, 0,40 $ pro Million gecachte Input-Tokens und 40 $ pro Million Output-Tokens. Anfragen über 272K Input-Tokens zahlen das Doppelte für Input und das 1,5-Fache für Output – für die gesamte Anfrage.
Warum schlägt meine GPT-6.2-Astra-Anfrage mit dem Reasoning-Effort „none“ fehl? Beide GPT-6.2-Modelle weisen "effort": "none" zurück. Setzen Sie high oder das niedrigste Level, das Ihre Tests für Ihre Aufgabe als funktionierend erweisen.
Wie groß ist das Kontextfenster von GPT-6.2 Astra? 1.050.000 Tokens insgesamt, mit bis zu 922.000 Input-Tokens und 128.000 Output-Tokens.
Kann ich GPT-6.2 Astra mit der Chat-Completions-API nutzen? Ja. Es wird unterstützt, aber gehostete Tools wie Websuche, Computer Use und Apply Patch sind für die Responses-API gelistet – nutzen Sie daher Responses für Agent-Arbeiten.
Ist GPT-6.2 Astra kostenlos verfügbar? Nicht in der API; jeder Aufruf wird abgerechnet. In ChatGPT Work und Codex ist es in den Plus-, Pro-, Enterprise- und Edu-Plänen enthalten, laut OpenAIs Release-Ankündigung.