
OpenAI stellte GPT-5.6 am 9. Juli 2026 allgemein zur Verfügung, und die erste Entscheidung, die es erzwingt, hat nichts damit zu tun, ob man ein Upgrade durchführen soll. Es ist eine Menüauswahl. Die Veröffentlichung erfolgt in Form von drei Modellen, gpt-5.6-sol, gpt-5.6-terra und gpt-5.6-luna, die an drei Punkten der Kosten-Leistungs-Kurve liegen. Wählt man zu hoch, zahlt man Sol-Tarife für Aufgaben, die Terra problemlos bewältigt. Wählt man zu niedrig, stagniert der Agent bei Aufgaben, für die Luna nie konzipiert war.
Die Namen folgen einem System: Die Zahl markiert die Generation, während Sol, Terra und Luna dauerhafte Stufen sind, die sich in ihrem eigenen Tempo weiterentwickeln. Unser GPT-5.6 Namens-Erklärer behandelt diese Struktur ausführlich, daher überspringt dieser Leitfaden die Geschichte. Hier finden Sie die Kaufentscheidung: was jede Stufe gut kann, wo die Preisfalle lauert und wie Sie die Wahl mit Ihren eigenen Prompts anstelle von Charts am Starttag treffen können.
Die 30-Sekunden-Antwort
| Modell | Preis pro 1 Mio. Tokens | Wählen Sie es, wenn |
|---|---|---|
gpt-5.6-sol |
$5 Eingabe / $30 Ausgabe | Die Aufgabe wirklich schwierig ist: agentische Codierung, mehrstufige Tool-Orchestrierung, tiefgehende Forschung |
gpt-5.6-terra |
$2.50 Eingabe / $15 Ausgabe | Fast alles andere. Die Standardeinstellung für Produktionsarbeiten |
gpt-5.6-luna |
$1 Eingabe / $6 Ausgabe | Volumen und Latenz entscheidend sind: Klassifizierung, Extraktion, Routing, erste Entwürfe |
Terra ist die vernünftige Standardeinstellung. OpenAI positioniert es als konkurrenzfähig zu GPT-5.5 zu etwa dem halben Preis, was bedeutet, dass die Modellklasse, auf der die meisten Produktionsanwendungen letzten Monat liefen, jetzt nur noch die Hälfte kostet. Sol verdient seinen Aufpreis nur, wenn die Aufgabe schwierig genug ist, um eine messbare Lücke aufzuweisen. Luna gewinnt immer dann, wenn Sie die Token-Preise mit Millionen von Anfragen multiplizieren.
Wenn Sie lieber testen als vertrauen, ist das ein guter Instinkt. Alle drei Modelle akzeptieren dieselben Responses API-Aufrufe, sodass Sie einen Satz von Prompts gegen jede Stufe in Apidog ausführen und die Ergebnisse die Argumente klären lassen können. Die Einrichtung dauert zehn Minuten; mehr dazu weiter unten.
Wofür jede Stufe gebaut ist
Alle drei Modelle sind in der API für jedes Konto live. Der Zugriff ist selbstbedient und ohne Planbeschränkungen, und die oben genannten Modell-IDs stammen direkt aus den Entwickler-Dokumenten von OpenAI. Die frühe Dokumentationsabdeckung meldet ein Kontextfenster von 1 Mio. Tokens, eine maximale Ausgabe von 128K und einen Wissensstand-Stichtag vom 16. Februar 2026 für die gesamte Familie; behandeln Sie diese als gemeldete Zahlen, bis die Modellseite von OpenAI sie für Ihr Konto bestätigt.
Sol: das Flaggschiff für schwierige Probleme
Sol ist die Stufe für tiefgehende Schlussfolgerungen, und die Start-Benchmarks konzentrieren ihre Gewinne genau dort, wo man es erwarten würde: bei langfristigen, agentischen Aufgaben. Laut OpenAI erzielt Sol etwa 53 Punkte beim Agents’ Last Exam gegenüber 46,9 für GPT-5.5, erreicht 88,8 % bei Terminal-Bench 2.1 und springt von 47,5 auf 62,6 bei OSWorld 2.0. Dies sind Angaben vom Starttag, also sollte man sie mit Vorsicht genießen. Aber das Muster ist konsistent: Planung, Werkzeugnutzung und Fehlerbehebung verbesserten sich weit mehr als die routinemäßige Textqualität.
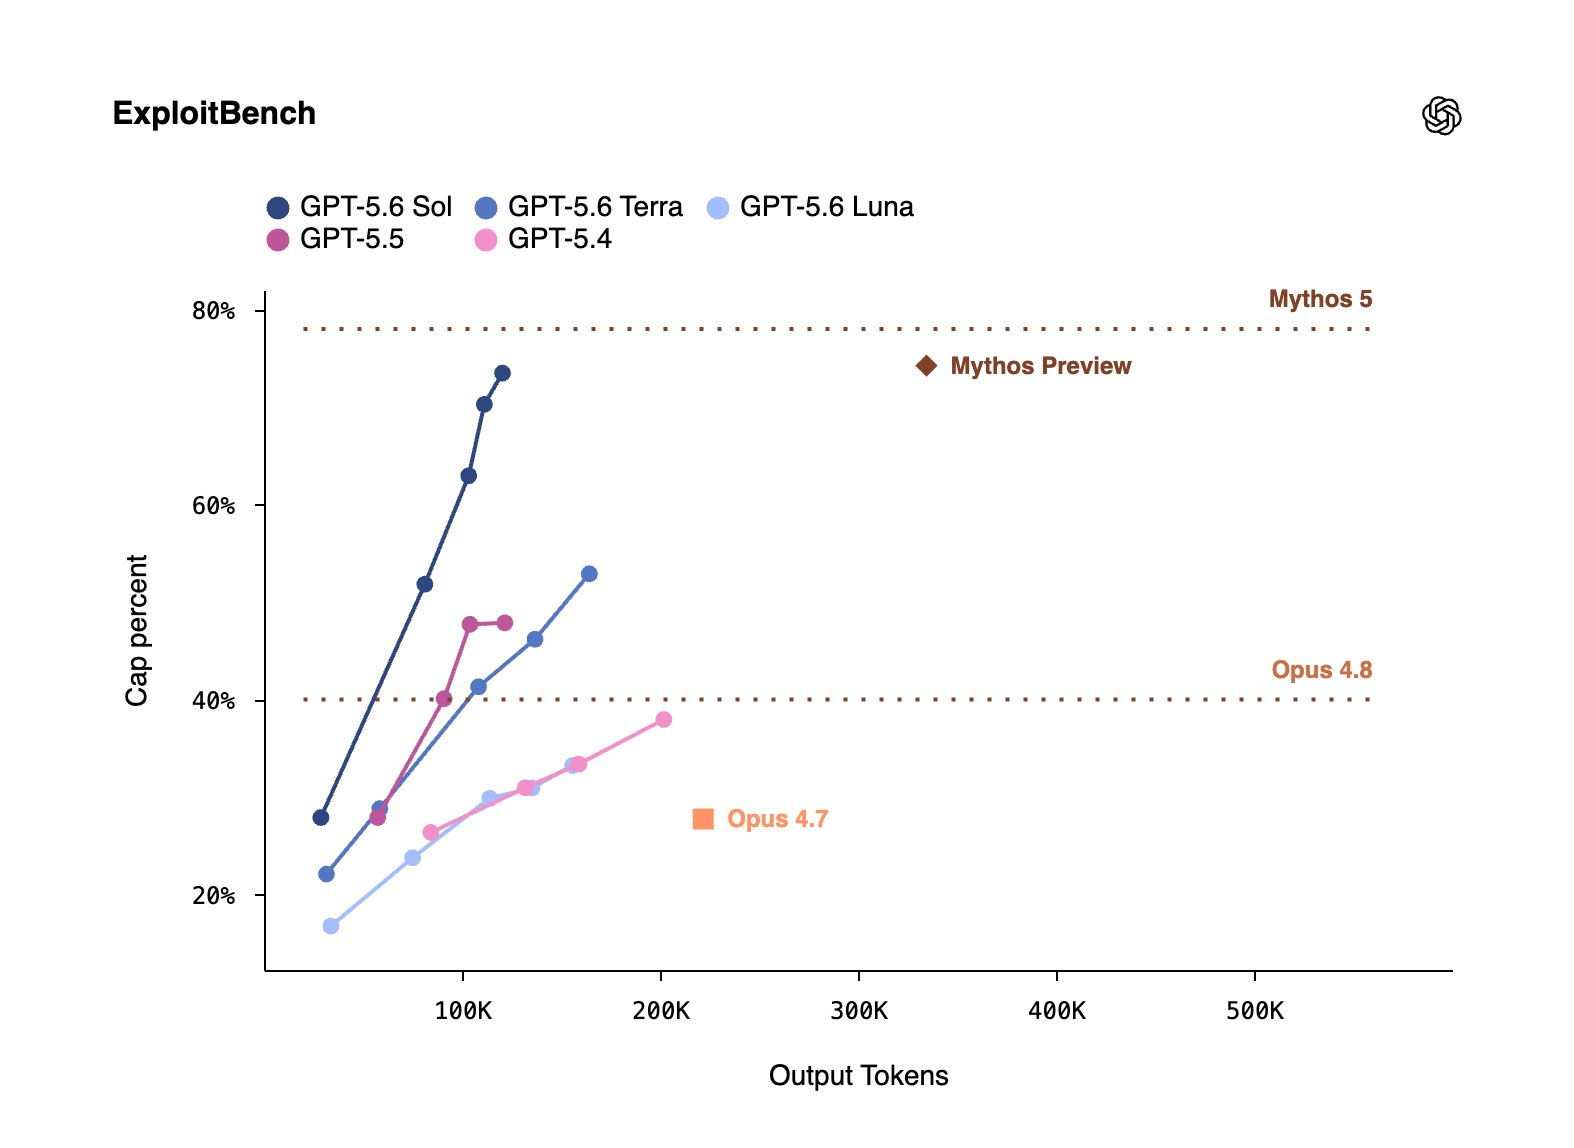
Es ist kein durchschlagender Erfolg. Bei SWE-Bench Pro führt Claude Fable 5 mit 80,3 % gegenüber Sols 64,6 %, also bedeutet „Flaggschiff“ nicht „der Beste in allem“. Wir schlüsseln auf, wo die Zahlen am stärksten und schwächsten aussehen, in unserer GPT-5.6 Sol Benchmark-Analyse.
Terra: der Standard für Produktionsarbeiten
Terras Argument ist eher wirtschaftlich als heroisch. OpenAI positioniert es als GPT-5.5-konkurrenzfähig zu etwa dem halben Preis, und diese Formulierung entscheidet die meisten realen Arbeitslasten von selbst. Wenn Ihr Produkt gut auf GPT-5.5 lief, bietet Ihnen Terra dieselbe Leistungsklasse zum halben Preis. Chat-Assistenten, Zusammenfassungen, Content-Pipelines, die meisten RAG-Setups: Dies ist die Stufe, mit der Sie beginnen sollten, und diejenige, aus der Sie sich herausargumentieren müssen.
Luna: Stückkosten und Geschwindigkeit
Luna erledigt Arbeiten, bei denen niemand die Begründung liest: Klassifizierung, Entitätsextraktion, Anforderungs-Routing, erste Entwürfe, die ein Mensch oder ein größeres Modell überarbeitet. Mit $1 Eingabe / $6 Ausgabe kostet es ein Fünftel von Sol auf beiden Seiten des Zählers und ist das schnellste der drei. Der häufige Fehler ist emotional, nicht technisch: Teams überspringen Luna, weil „am billigsten“ wie „am schlechtesten“ klingt, und zahlen dann Terra-Tarife für Aufgaben mit Ein-Wort-Ausgaben.
Die Falle in der Standardeinstellung
Hier ist das Detail, das die Rechnungen still und heimlich in die Höhe treibt: Der bloße Alias gpt-5.6 leitet zu Sol weiter. Greifen Sie nach dem offensichtlichen Modell-String und Sie haben die teuerste Stufe gewählt, ohne es jemals entschieden zu haben.
Geben Sie die Stufe in jedem Aufruf explizit an:
{
  "model": "gpt-5.6-terra",
  "input": "Classify this support ticket by urgency and product area.",
  "reasoning": { "effort": "medium" }
}
Der Unterschied summiert sich schnell. Ein Dienst, der 50 Mio. Eingabe- und 10 Mio. Ausgabe-Tokens pro Monat verarbeitet, zahlt etwa $275 für Terra, $550 für Sol und $110 für Luna. Derselbe Traffic, eine 5-fache Spanne, entschieden durch einen einzigen String. Die vollständige Preisliste, einschließlich Cache-Rabatte, finden Sie in unserer GPT-5.6 Preisübersicht. Simon Willisons Einführungsbericht ist auch Ihre Zeit wert als erster unabhängiger Entwickler-Eindruck zur Veröffentlichung.
Passen Sie das Modell an Ihre Arbeitslast an
Drei Szenarien decken den größten Teil des Entscheidungsbereichs ab.
Eine agentische Codierungs-Pipeline. Wählen Sie Sol. Hier landen die Benchmark-Gewinne, und so auch die GA-Funktionen: Programmatischer Tool-Aufruf ermöglicht es dem Modell, JavaScript zu schreiben, das Ihre Tool-Aufrufe orchestriert, ausgeführt in einer isolierten V8-Laufzeitumgebung ohne Netzwerkzugriff, und persistierte Schlussfolgerungen tragen den Kontext über mehrere Runden. Wenn ein Lauf 40 Schritte dauert und eine schlechte Entscheidung bei Schritt 12 die nächsten 28 verschwendet, ist die Modellqualität der günstigste Posten in der Pipeline. Das vollständige Sol-Profil behandelt weitere Änderungen des Flaggschiffs.
Ein Produktions-Chat-Assistent. Wählen Sie Terra. Benutzer beurteilen Latenz und Hilfsbereitschaft, nicht Benchmark-Deltas, und bei Routinefragen können sie Sol nicht von Terra unterscheiden. Leiten Sie die seltene schwierige Anfrage an Sol hinter einer Heuristik weiter, wenn Ihre Protokolle beweisen, dass Sie sie benötigen; zahlen Sie keine Flaggschiff-Tarife für „wie setze ich mein Passwort zurück“.
Eine Dokumenten-Pipeline mit hohem Volumen. Wählen Sie Luna und legen Sie dann Caching darüber. GPT-5.6 unterstützt explizite Cache-Haltepunkte (prompt_cache_options.mode: "explicit" mit einem ttl-Feld); Cache-Lesevorgänge behalten den 90%igen Rabatt, Schreibvorgänge werden zum 1,25-fachen des Eingaberates abgerechnet, und gecachte Inhalte bleiben mindestens 30 Minuten erhalten. Für Extraktionsaufträge, die einen langen System-Prompt über Tausende von Dokumenten hinweg wiederverwenden, liegt Luna plus explizites Caching in einer anderen Kostenklasse als die beiden Geschwister. Die neuen Vision-Detail-Einstellungen (original und auto) bewahren auch die Abmessungen des Quellbildes, was wichtig ist, wenn Sie Felder aus Scans ziehen.
Anstrengungsstufen ändern die Rechnung
Die Stufe ist nur die halbe Miete. GPT-5.6 bietet sechs verschiedene Schlussfolgerungs-Anstrengungsstufen für jede Stufe: none, low, medium, high, xhigh und max. Das verwandelt drei Modelle in ein Raster, und der interessanteste Zellenvergleich ist nicht Sol gegen Terra bei derselben Einstellung. Es ist Terra auf high gegen Sol auf medium. Terra mit mehr Denkzeit kann einen Großteil der Qualitätslücke zum halben Token-Preis schließen, und ob es für Ihre Aufgaben ausreichend geschlossen wird, ist eine empirische Frage, keine Spezifikationsfrage.
Die Migrationsanleitung von OpenAI weist in dieselbe Richtung: Betrachten Sie den Wechsel als Tuning-Durchlauf, nicht als Modell-Slug-Austausch. Benchmarker Sie zuerst repräsentative Aufgaben und testen Sie Ihr aktuelles Anstrengungsniveau zusammen mit einem niedrigeren Niveau. Eine weitere Prompt-Anmerkung aus den Docs: GPT-5.6 schreibt merklich kürzere Antworten mit weniger generischen Einleitungen, also entfernen Sie den „sei prägnant“-Boilerplate aus übernommenen Prompts, sonst erhalten Sie Antworten, die so knapp sind, dass sie unhilfreich werden.
Für qualitätsorientierte Arbeiten, bei denen Sie lieber warten als neu ausführen möchten, ist der Pro-Modus (reasoning.mode: "pro") für alle drei Modelle verfügbar. Es ist eine Einstellung, kein separates Modell, sodass Sie ihn auf Terra genauso einfach aktivieren können wie auf Sol.
Testen Sie alle drei, bevor Sie sich festlegen
Die ehrliche Antwort auf die Frage „welches Modell sollten Sie verwenden“ lautet: das, das bei Ihren Prompts gewinnt. Benchmarks sind OpenAIs Aufgaben; Ihr Produktions-Traffic ist es nicht.
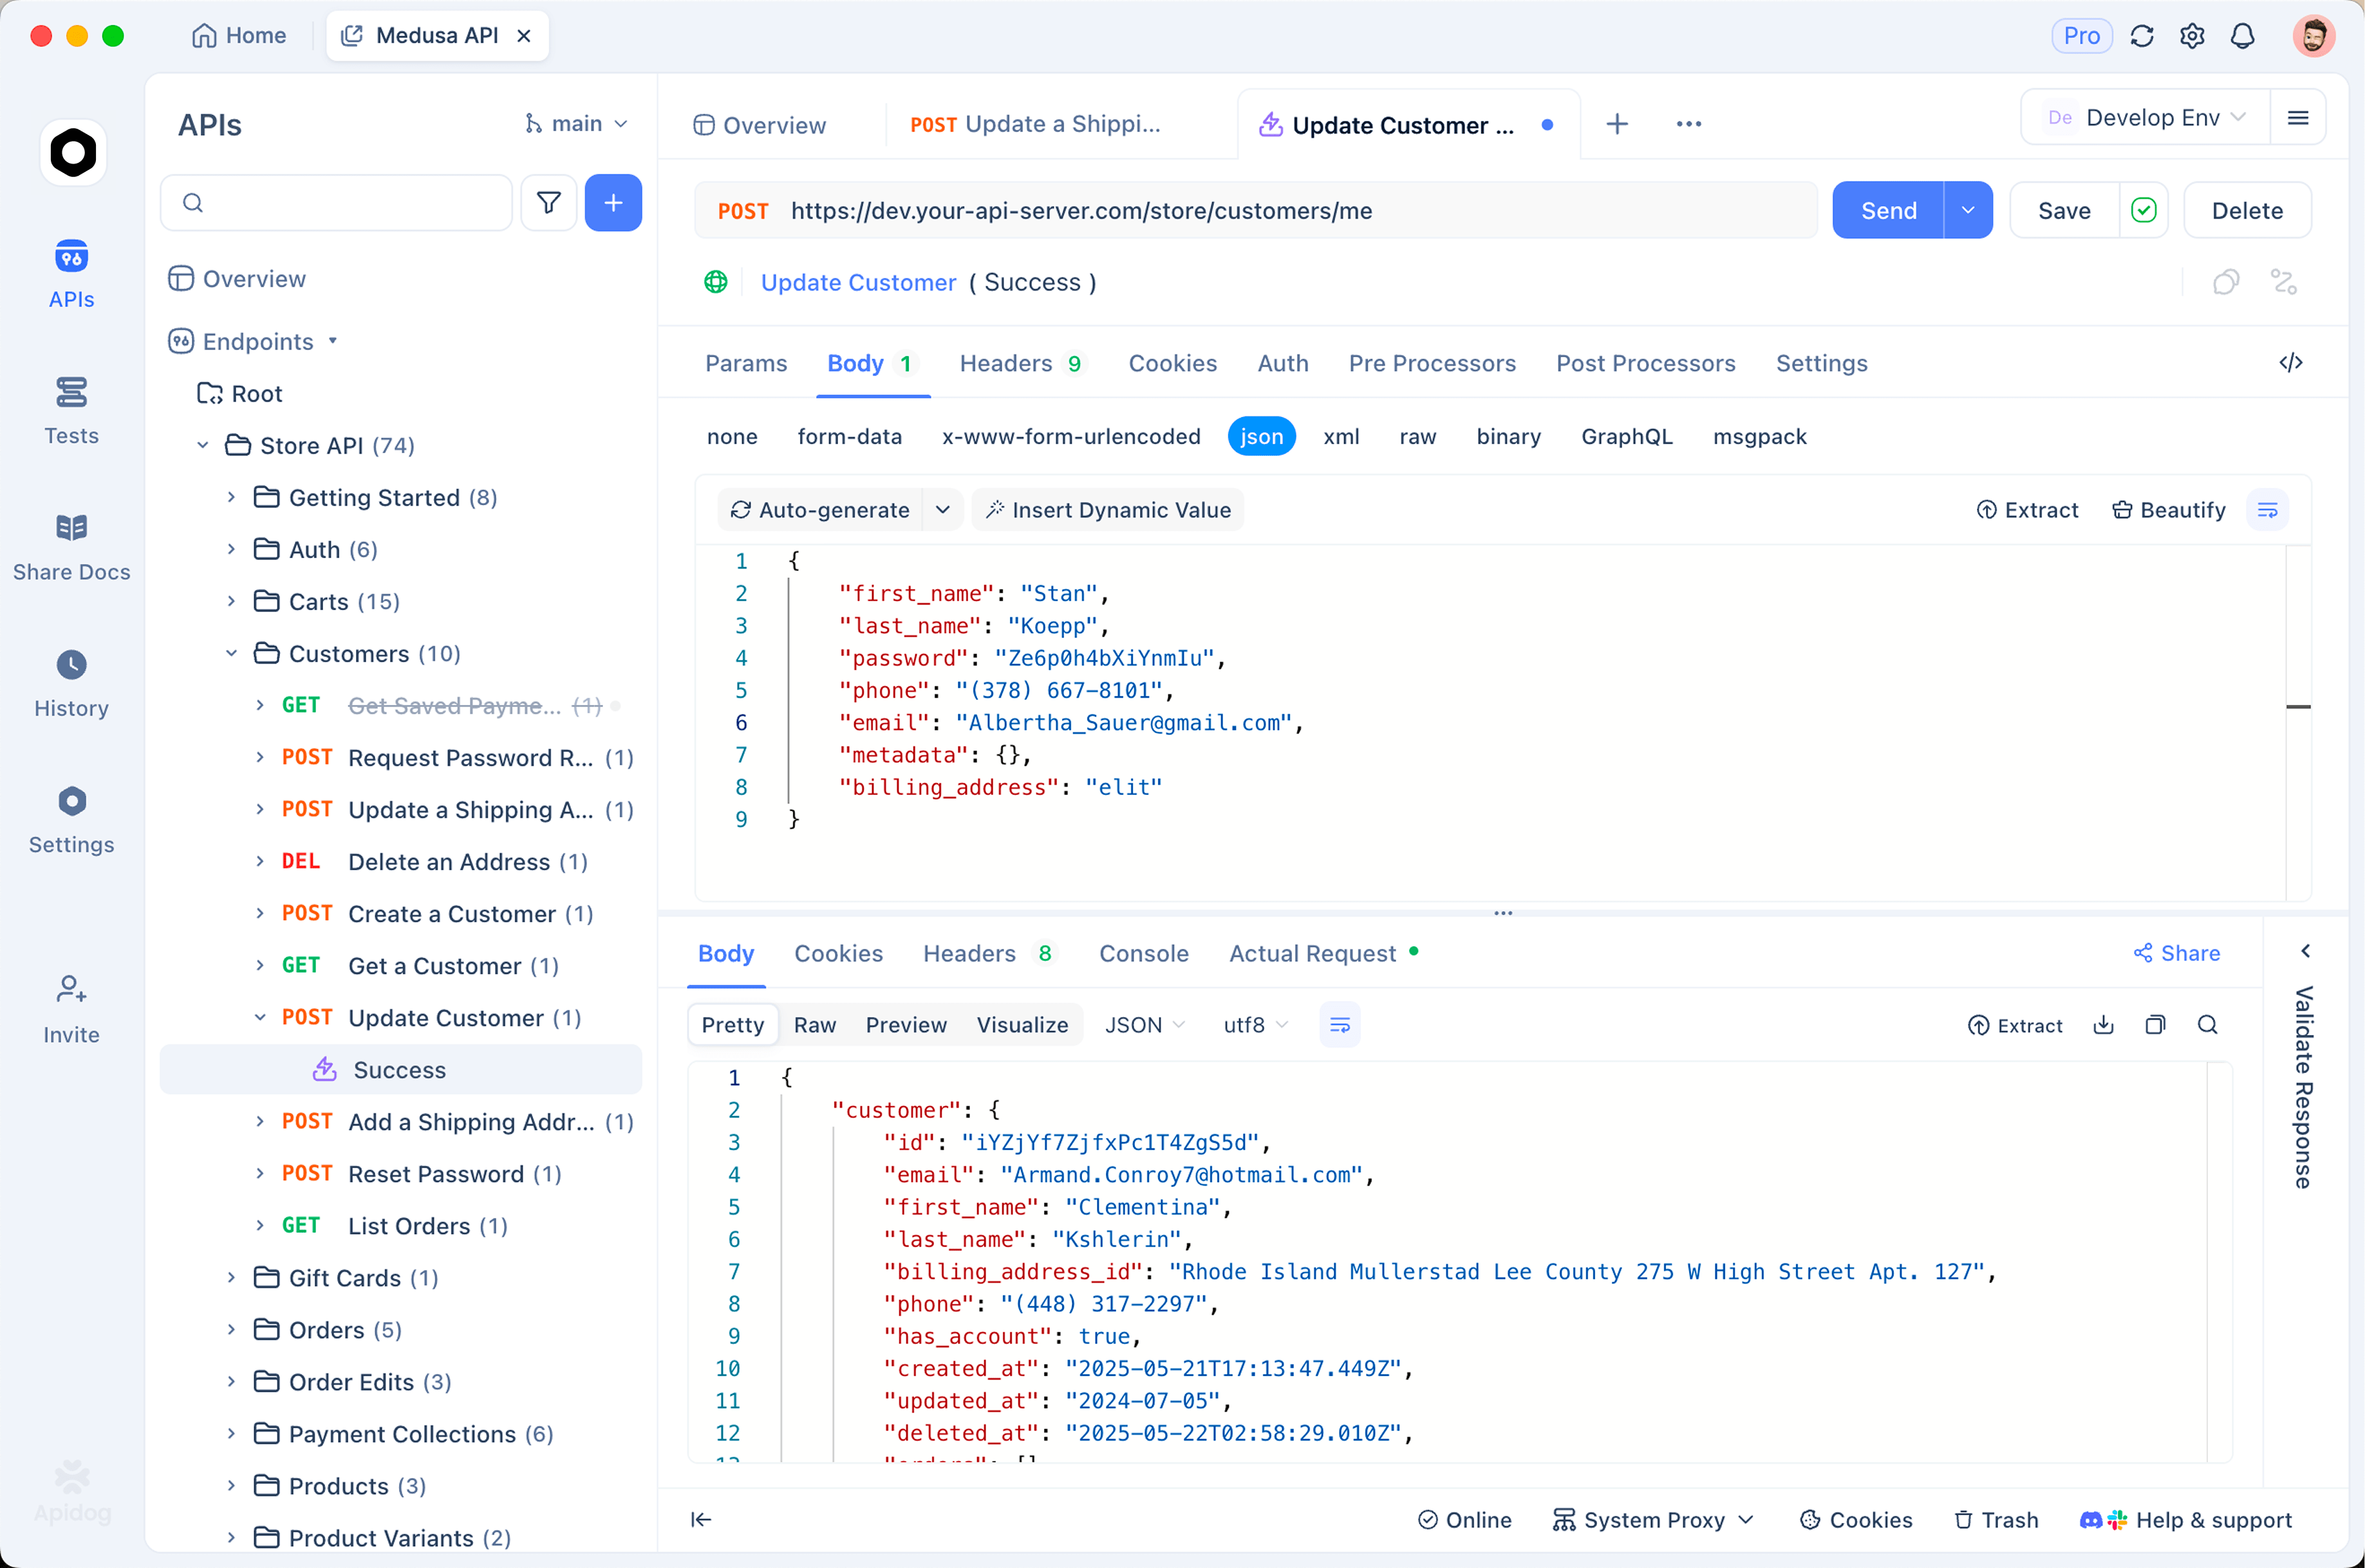
Der Test ist günstig durchzuführen. Sammeln Sie 10 bis 20 echte Aufgaben aus Ihren Logs, einschließlich der unschönen. Laden Sie Apidog herunter, speichern Sie die OpenAI-Basis-URL und den API-Schlüssel einmal, und legen Sie dann die Modell-ID in einer Umgebungsvariablen ab, sodass eine Anfragedefinition alle drei Stufen abdeckt. Wechseln Sie {{model}} zwischen gpt-5.6-sol, gpt-5.6-terra und gpt-5.6-luna, führen Sie denselben Prompt-Satz aus und vergleichen Sie zwei Dinge nebeneinander: die Ausgabequalität gegen Ihre eigene Messlatte und die usage-Token-Anzahlen in jeder Antwort. Multiplizieren Sie diese Anzahlen mit der Preisliste, und die Kosten-pro-Aufgabe-Tabelle schreibt sich von selbst.
Zwei Ergebnisse zeigen sich in den meisten dieser Vergleiche. Terra entspricht Sol bei einem größeren Anteil der Aufgaben, als die Preisdifferenz vermuten lässt. Und Luna überlebt Aufgaben mit strukturierter Ausgabe, den Klassifizierungs- und Extraktionsbereich, weitaus häufiger, als sein Preis vermuten lässt. Sie erfahren nur, wo Ihre Arbeitslast dieses Muster durchbricht, indem Sie es ausführen.
Wo Ultra passt
Ultra ist die einzige Option in dieser Reihe, die keine API-Modell-ID ist. Es ist eine Multi-Agenten-Einstellung, die standardmäßig vier Agenten parallel ausführt und bewusst mehr Tokens ausgibt, um schnellere reale Ergebnisse bei schwierigen Problemen zu erzielen. Laut OpenAI hebt Ultra Sols Terminal-Bench 2.1-Score von 88,8 % auf 91,9 %.
Die Verfügbarkeit ist auf der Produktseite planabhängig: Ultra ist in ChatGPT Work auf Pro- und Enterprise-Plänen sowie in Codex ab Plus aufwärts verfügbar. Das Chat-Produkt hat seine eigene Stufenübersicht, laut OpenAIs Hilfezentrum:
| ChatGPT-Plan | GPT-5.6 Zugriff |
|---|---|
| Kostenlos / Go | Terra |
| Plus | Sol, Terra und Luna mit anstrengungsbasierter Steuerung pro Modell (Sol ab mittlerer Anstrengung aufwärts) |
| Pro / Business / Enterprise | Alles oben Genannte, plus Sol Pro |
| ChatGPT Work (Pro / Enterprise), Codex (Plus und höher) | Ultra |
Wenn Ihre parallele Agenten-Arbeitslast eher im Code als im Chat liegt, beobachten Sie die Multi-Agenten-Beta in der Responses API; es ist das API-seitige Gegenstück derselben Idee.
FAQ
Ist gpt-5.6-terra gut genug, um GPT-5.5 in der Produktion zu ersetzen?
Für die meisten Arbeitslasten ja. OpenAI positioniert Terra als konkurrenzfähig zu GPT-5.5 zu etwa dem halben Preis, und die gleiche Responses API-Oberfläche bedeutet, dass der Wechsel risikoarm ist. Führen Sie Ihre Evaluierungen vor der Umstellung durch und achten Sie auf die Ausgabelänge, da GPT-5.6-Antworten designbedingt kürzer sind.
Was passiert, wenn ich den bloßen gpt-5.6-Alias aufrufe?
Ihre Anfrage wird an Sol weitergeleitet und zu Sol-Tarifen abgerechnet: $5 pro 1 Mio. Eingabe-Tokens und $30 pro 1 Mio. Ausgabe-Tokens. Nichts geht kaputt, was das Problem ist; die Kosten erscheinen später auf der Rechnung. Geben Sie gpt-5.6-terra oder gpt-5.6-luna explizit an, wo immer eine günstigere Stufe die Aufgabe erledigt.
Kann ich die Stufen wechseln, ohne meine Integration zu ändern?
Ja. Sol, Terra und Luna teilen dieselbe Responses API-Oberfläche, sodass ein Wechsel zwischen ihnen eine Ein-Zeilen-Modellstring-Änderung ist. Anstrengungsstufen und Pro-Modus funktionieren auch bei allen dreien. Unser Leitfaden zur Verwendung der GPT-5.6 API führt Sie Schritt für Schritt durch die Anforderungsform.
Benötige ich einen spezifischen ChatGPT-Plan, um diese Modelle in der API zu verwenden?
Nein. Der API-Zugriff ist für jedes API-Konto selbstbedient und ohne Planbeschränkungen für keines der drei Modelle. ChatGPT-Pläne steuern nur das Chat-Produkt, und Ultra ist die einzige Funktion, die produktseitig (ChatGPT Work und Codex) bleibt, anstatt als API-Modell ausgeliefert zu werden.
Ihre erste Stunde mit den Stufen
Beginnen Sie mit Terra und lassen Sie die anderen Stufen sich beweisen. Eskalieren Sie nur dann zu Sol, wenn Ihre eigenen Evaluierungen eine Lücke zeigen, für die es sich lohnt, den doppelten Preis zu zahlen, was normalerweise agentische und langfristige Aufgaben bedeutet. Wechseln Sie zu Luna, wo immer die Ausgaben kurz und das Volumen hoch sind. Geben Sie überall explizite Modell-IDs an, damit der standardmäßige Sol-Alias niemals für Sie wählt, und passen Sie die Anstrengungsstufen an, bevor Sie die Stufen wechseln, denn Terra auf high ist das günstigste Qualitäts-Upgrade in der Produktreihe.
Hören Sie dann auf zu lesen und messen Sie. Laden Sie Ihre zehn schwierigsten Produktions-Prompts in Apidog, richten Sie eine Anfrage mit einer Umgebungsvariable an alle drei Modell-IDs und lassen Sie Ihre eigenen Token-Zählungen und Ausgaben die Entscheidung treffen. Die gesamte Übung kostet weniger als einen Dollar an API-Ausgaben und trifft eine Entscheidung, die sich jeden Monat summiert.
Schaltfläche