
Innerhalb weniger Wochen im Sommer 2026 lieferten OpenAI und Google jeweils ein sicherheitsspezialisiertes Modell aus, das die meisten Entwickler nicht nutzen können. OpenAIs GPT-5.6-Cyber wurde am 10. August veröffentlicht. Googles Gemini 3.5 Flash Cyber erschien am 21. Juli. Beide finden Software-Schwachstellen. Beide sind nur mit Genehmigung zugänglich. Und beide verweigern Ihnen einen normalen API-Schlüssel.
Es handelt sich jedoch nicht um dieselbe Art von Werkzeug. Eines ist eher defensiv ausgerichtet, das andere offensiv, und sie gehören zu sehr unterschiedlichen Modellstufen. Wenn Sie versuchen, die beiden zu verstehen, erfahren Sie hier, wie sie sich tatsächlich vergleichen lassen und warum ein direkter Benchmark-Wettkampf zwischen ihnen nicht möglich ist.
Nebeneinander
| GPT-5.6-Cyber | Gemini 3.5 Flash Cyber | |
|---|---|---|
| Anbieter | OpenAI | |
| Veröffentlichung | 10. August 2026 | 21. Juli 2026 |
| Basiert auf | GPT-5.6 Sol (Flaggschiff-Stufe) | Gemini Flash (schnelle, günstige Stufe) |
| Ausrichtung | Offensiv: Exploit-Ketten, Zero-Day-Entdeckung | Defensiv: Schwachstellen finden und beheben |
| Zugang | Daybreak Red (geprüfte Sicherheitsteams) | Begrenzte Pilotphase (Regierungen, vertrauenswürdige Partner) |
| Öffentliche API | Nein | Nein |
| Öffentliche Preisgestaltung | Nein | Nein |
| Programm | OpenAI Daybreak | Google CodeMender |
Das Fazit in einem Satz: GPT-5.6-Cyber ist ein offensives Forschungsmodell der Spitzenklasse, und Gemini 3.5 Flash Cyber ist ein defensives Patching-Modell einer leichteren Stufe. Dieser Unterschied in der Ausrichtung erklärt fast alles andere.
Unterschiedliche Modellstufen
Die deutlichste technische Trennung ist das Basismodell. GPT-5.6-Cyber basiert auf GPT-5.6 Sol, OpenAIs leistungsfähigstem Denkmodell. Die reale Schwachstellenforschung erfordert ein kontinuierliches Denken über große, unbekannte Codebasen hinweg, und OpenAI hat sein Top-Modell unter Cyber gelegt, um dies zu erreichen.
Gemini 3.5 Flash Cyber basiert auf der Flash-Stufe, Googles schnellem und kostengünstigem Arbeitstier und nicht auf seinem Pro-Flaggschiff. Das ist eine bewusste Anpassung an seine Aufgabe. CodeMender, das dahinterstehende Google-Programm, scannt Code, um Fehler in großem Maßstab zu finden und zu beheben, was Geschwindigkeit und Kosteneffizienz gegenüber maximaler Denk-Tiefe bei einmaligen Aufgaben belohnt. Beachten Sie auch die Versionsbesonderheit: Das allgemeine Flash-Modell wechselte zu 3.6, aber Cyber blieb bei 3.5, da die beiden auf unterschiedlichen Veröffentlichungsspuren sind.
Unterschiedliche Ausrichtung: Offensive vs. Defensive
Das ist der eigentliche Unterschied. Wenn man die jeweilige Darstellung der Anbieter liest, wird die Trennung deutlich.
OpenAI hat GPT-5.6-Cyber darauf trainiert, Ablehnungen zu reduzieren bei risikoreicheren Dual-Use-Aufgaben und besser darin zu werden, Zero-Days zu finden und Exploit-Ketten zu erstellen, gemäß seiner Daybreak-Erweiterungsankündigung. Es wird über Daybreak Red bereitgestellt, die Stufe, die explizit für „autorisierte Schwachstellenforschung, Exploit-Validierung und Sicherheitstests“ vorgesehen ist. Die Beweise zur Einführung waren offensiv: zwei verkettete V8-Schwachstellen in Chrome, zugewiesen CVE-2026-15903, sowie gemeldete Funde in einem mobilen Betriebssystem, einer Datenbank und einem OS-Kernel.
Google hat Gemini 3.5 Flash Cyber um das Thema Finden und Beheben herum konzipiert. Angekündigt in seinem Update der Gemini-Modelle, ist es Teil von CodeMender, einer Initiative, die darauf abzielt, Sicherheitslücken im Code zu erkennen und Patches dafür vorzuschlagen. Der Schwerpunkt liegt auf der Behebung, dem Schließen von Lücken, nicht auf deren Bewaffnung.
Das macht das eine nicht „sicher“ und das andere „gefährlich“. Ein starker Schwachstellenfinder ist immer dual-use, egal wie er formuliert wird, genau deshalb sind beide eingeschränkt zugänglich. Aber wenn man den Bereich kartiert, drängte OpenAI stärker auf offensive Forschung, und Google blieb näher an defensiven Patches.
Unterschiedliche Transparenz
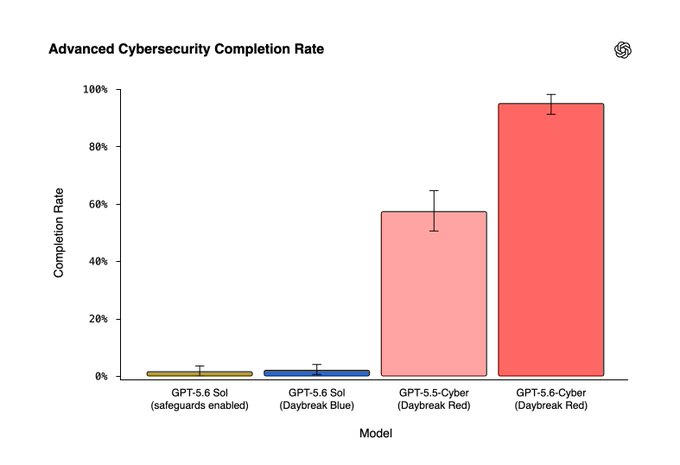
OpenAI veröffentlichte mehr Zahlen. Es gab eine interne Metrik zur Abschlussrate bekannt (GPT-5.6-Cyber beantwortet 95,0 % der fortgeschrittenen Cyber-Prompts im Vergleich zu 1,5 % für das Basis-Sol-Modell), nannte Benchmarks wie ExploitGym, meldete eine tatsächlich zugewiesene CVE und gab eine Preparedness Framework-Bewertung von „Hoch“, aber unter „Kritisch“ an. Für eine vollständige Aufschlüsselung, wer worauf zugreifen kann, siehe Daybreak Blue vs Red.
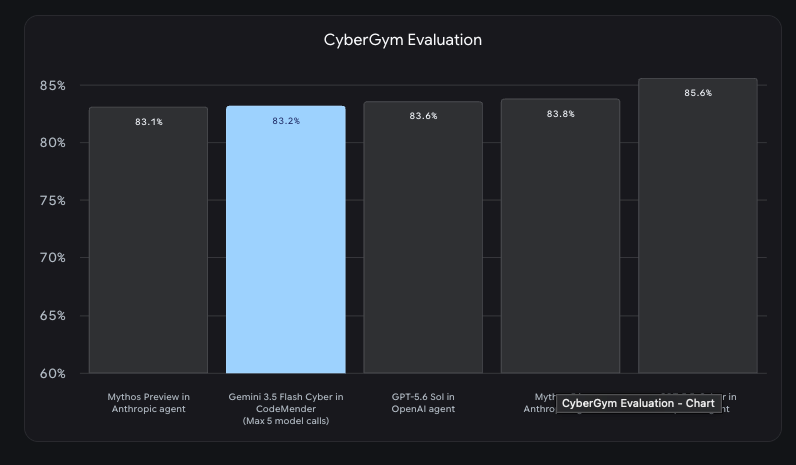
Google war bei der Einführung vager. Es bestätigte die Existenz des Modells, seinen defensiven Zweck und seinen eingeschränkten Status, ohne vergleichbare Abschlussraten pro Aufgabe oder Benchmark-Tabellen zu veröffentlichen. Sie können also zwar beide Modelle beschreiben, sie aber nicht in derselben Tabelle gegenüberstellen. Es gibt keinen gemeinsamen Benchmark, den einer der Anbieter direkt gegeneinander ausgeführt hätte, und ihre Zielaufgaben (Exploit-Entwicklung vs. Patch-Generierung) überschneiden sich kaum.
Was sie gemeinsam haben
Nimmt man die Unterschiede weg, erzählen die beiden Modelle dieselbe Geschichte darüber, wohin die KI-Sicherheitstools sich entwickeln:
- Eingeschränkter Zugang, keine offene API. Keines ist selbstbedienbar. Beide erfordern eine Genehmigung, und der Zugang ist auf geprüfte Organisationen beschränkt.
- Keine öffentlichen Preise. Da es keinen offenen Zugang gibt, gibt es auch keine veröffentlichten Preise pro Token für beide. Jede Preisliste, die Sie im Umlauf finden, ist unbestätigt.
- Dieselbe Dual-Use-Logik. Beide Anbieter argumentieren, dass ein Modell, das gut darin ist, Schwachstellen zu finden, von Natur aus gut darin ist, Schwachstellen zu finden. Daher beginnen sie eng mit vertrauenswürdigen Partnern und beobachten, bevor sie den Zugang erweitern.
- Eine verwirrende Versionsgeschichte. OpenAIs Modell läuft unter der Sol/Terra/Luna-Namensgebung; Googles blieb bei 3.5, während sein Geschwistermodell zu 3.6 wechselte.
Wenn Sie zu einem der beiden gekommen sind, um einen API-Schlüssel zu erhalten, lautet die Antwort dieselbe: nicht heute, und vielleicht nicht in der Form, die Sie erwarten.
Welches ist für Sie relevant? Wahrscheinlich keines, noch nicht
Hier ist die praktische Einschätzung. Wenn Sie nicht bei einem zugelassenen Sicherheitsanbieter oder einem Regierungspartner sind, können Sie keines der Modelle derzeit nutzen. Sie zu beobachten ist nützlich, um die Entwicklungsrichtung zu verstehen, aber keines gehört in diesem Quartal in Ihren Stack.
Was jedoch in Ihren Stack gehört, ist das Testen der Sicherheit der APIs, die Sie tatsächlich besitzen. Beide Modelle existieren, weil Schwachstellen teuer sind; die günstigsten zu verhindern sind die langweiligen Grenzfehler in Ihren eigenen Diensten. Dafür brauchen Sie kein fortschrittliches Cyber-Modell.
Mit einem API-Client wie Apidog können Sie die Prüfungen durchführen, die mit geringstem Aufwand das meiste erfassen:
- Authentifizierungsgrenzen. Senden Sie Anfragen mit fehlenden, abgelaufenen und gültigen Token und stellen Sie sicher, dass jede den richtigen Status zurückgibt. Dieselbe Disziplin des geringsten Privilegs gilt für Ihre Agenten; sehen Sie, was der API-Schlüssel Ihres KI-Agenten tatsächlich tun kann.
- Transportsicherheit. Überprüfen Sie, ob Client-Zertifikate und mTLS ordnungsgemäß funktionieren und dass einfache Anfragen abgelehnt werden.
Das ist Arbeit, die Sie heute beginnen können, mit Tools, auf die Sie tatsächlich zugreifen können. Laden Sie Apidog herunter und beginnen Sie mit den Authentifizierungsfällen.
Häufig gestellte Fragen
Welches ist besser, GPT-5.6-Cyber oder Gemini 3.5 Flash Cyber? Sie sind für unterschiedliche Aufgaben konzipiert, daher hängt „besser“ von der jeweiligen Aufgabe ab. GPT-5.6-Cyber ist ein Modell der Spitzenklasse, das für offensive Forschung (Exploit-Entwicklung, Zero-Day-Entdeckung) optimiert ist. Gemini 3.5 Flash Cyber ist ein Modell einer leichteren Stufe, das für defensive Patching-Aufgaben optimiert ist. Keiner der Anbieter hat einen direkten Vergleichs-Benchmark veröffentlicht, daher ist ein direkter Punktevergleich nicht möglich.
Kann ich eines davon über eine API nutzen? Nein. Beide sind eingeschränkt. GPT-5.6-Cyber erfordert die Genehmigung von Daybreak Red; Gemini 3.5 Flash Cyber ist ein begrenztes Pilotprojekt für Regierungen und vertrauenswürdige Partner. Keines bietet eine Self-Service-API-Modell-ID.
Warum sind beide Modelle eingeschränkt? Dual Use. Ein Modell, das gut darin ist, Schwachstellen zu finden, hilft Verteidigern beim Patchen und Angreifern beim Ausnutzen. Beide Anbieter beschränken den Zugang auf geprüfte Partner, während sie die reale Nutzung überwachen.
Was ist der Unterschied bei den Basismodellen? GPT-5.6-Cyber basiert auf GPT-5.6 Sol, OpenAIs Flaggschiff-Denkstufe. Gemini 3.5 Flash Cyber basiert auf Googles schnellerer, günstigerer Flash-Stufe, was zu seinem Scan-und-Fix-Zweck passt.
Was sollte ich stattdessen verwenden? Um Ihre eigenen APIs zu sichern, führen Sie Authentifizierungs-, Transport- und Vertragstests mit einem Client wie Apidog durch. Kein eingeschränktes Modell erforderlich.