
Z.ai verkauft jetzt zwei Modelle mit nahezu gleichem Namen, demselben 1M-Token-Kontextfenster und einem neunfachen Preisunterschied. Die Namensgebung hilft nicht bei der Auswahl. „Flash“ impliziert eine kleinere, schnellere, schwächere Variante, und nur eines dieser drei Wörter ist zutreffend.
Hier ist die Kurzversion: GLM-5.3-Flash ist günstiger, verarbeitet Bilder nativ und gewährt Nutzern des Coding-Plans die dreifache Quote. GLM-5.3 ist etwas intelligenter und generiert fast doppelt so schnell. Für die meisten Workloads ist Flash die richtige Standardeinstellung, und die Beweislast liegt bei der Wahl des teureren Modells.
Dieser Beitrag erläutert, wo diese Regel nicht mehr gilt.
Die Vergleichstabelle
| GLM-5.3-Flash | GLM-5.3 | |
|---|---|---|
| Intelligenzindex (Künstliche Analyse) | 57 | 60 |
| Mischpreis pro 1 Million Tokens | $0.10 | $0.90 |
| Listenpreis Eingabe / Ausgabe pro 1 Million | $0.15 / $0.50 | $1.40 / $4.40 |
| Ausgabegeschwindigkeit | ~49 Tokens/Sek. | ~86 Tokens/Sek. |
| Zeit bis zum ersten Token | 1.52s | 1.57s |
| Kontextfenster | 1.048.576 | 1.048.576 |
| Native Bildeingabe | Ja | Nein, Adapter-basiert |
| Parameter | 320B gesamt / 18B aktiv | Größer, nicht vollständig offengelegt |
| Lizenz | MIT, offene Gewichte | Offene Gewichte |
| Coding-Plan-Quote | 3x | 1x |
Geschwindigkeits- und Intelligenzwerte sind Messungen von Artificial Analysis. Die Preisgestaltung entspricht der Z.ai-Preisliste vor dem unten besprochenen Einführungsrabatt.
Woher der neunfache Preisunterschied kommt
GLM-5.3-Flash ist ein 320B Mixture-of-Experts-Modell, das 18B Parameter pro Token aktiviert und auf einer neuen Basis mit hybrider linearer und sparsamer Aufmerksamkeit aufgebaut ist. Z.ai berichtet über etwa dreimal weniger Aufmerksamkeitsberechnung als GLM-5.3 und einen KV-Cache, der etwa 4,4-mal kleiner ist.
Die Größe des KV-Caches ist der Faktor, der die Bereitstellung langer Kontexte teuer macht. Die Reduzierung um das 4,4-fache ist der Hauptgrund, warum Z.ai ein 1M-Token-Fenster zu einem Zehntel des Preises anbieten kann. Sie zahlen nicht weniger für einen kürzeren Kontext oder ein schwächeres Modell. Sie zahlen weniger, weil der Bereitstellungs-Footprint pro Anfrage tatsächlich kleiner ist.
Das ist ein echtes technisches Ergebnis und kein Aktionsrabatt, was wichtig ist für die Frage, ob der Preis Bestand hat.
Was die dreipunktige Intelligenzlücke bedeutet
57 versus 60 auf dem Artificial Analysis Intelligence Index ist in absoluten Zahlen ein geringer Unterschied. Zum Vergleich: Das Medianmodell mit offenen Gewichten vergleichbarer Größe erreicht 27 Punkte, sodass beide weit über dem Durchschnitt liegen.
Drei Punkte sind jedoch nicht nichts. Indexlücken dieser Größe zeigen sich typischerweise als: etwas schlechtere Leistung bei mehrstufigen Schlussfolgerungsketten, etwas mehr Abweichung bei sehr langen agentenbasierten Aufgaben und eine höhere Empfindlichkeit gegenüber mehrdeutigen Anweisungen. Sie treten selten bei einfacher Extraktion, Klassifizierung, Zusammenfassung oder Einzeldateicodebearbeitung auf.
Der praktische Test ist, ob Ihre Aufgabe eine überprüfbare Antwort hat. Wenn Sie die Ausgabe programmatisch überprüfen können, ist Flashs gelegentlicher Fehler günstig zu erkennen und günstig zu wiederholen, und zu einem Neuntel des Preises können Sie viel wiederholen. Wenn Ihre Aufgabe Prosa erzeugt, die ein Mensch lesen und beurteilen muss, ist der Qualitätsunterschied schwerer zu beheben und der Preisunterschied weniger wichtig als das Ergebnis.
Geschwindigkeit ist der einzige Bereich, in dem Flash tatsächlich verliert
Dies ist der Teil, bei dem der Name irreführend ist. GLM-5.3 generiert mit etwa 86 Tokens pro Sekunde. GLM-5.3-Flash schafft etwa 49. Das größere, teurere Modell ist fast doppelt so schnell bei der Ausgabeerzeugung.
Die Zeit bis zum ersten Token ist mit 1,52 gegenüber 1,57 Sekunden praktisch gleich, sodass sich beide zu Beginn einer Antwort gleichermaßen reaktionsschnell anfühlen.
Die Konsequenz hängt ausschließlich von der Ausgabelänge ab:
- Kurze Antworten. Irrelevant. Beide beginnen in etwa 1,5 Sekunden und sind fertig, bevor jemand den Durchsatzunterschied bemerkt.
- Lange Generierungen. Eine Antwort mit 4.000 Tokens dauert auf Flash etwa 82 Sekunden und auf GLM-5.3 etwa 47 Sekunden. In einem interaktiven Tool ist das ein signifikanter Unterschied.
- Batch-Jobs mit Parallelität. Auch weitgehend irrelevant, da Sie mit parallelen Anfragen statt mit der Geschwindigkeit pro Stream skalieren und der Preisunterschied viel Parallelität ermöglicht.
Wenn Sie lange Ausgaben an jemanden streamen, der wartet, bietet GLM-5.3 die bessere Erfahrung. Das ist der klarste Fall, neunmal mehr zu bezahlen.
Multimodalität ist die wahre Trennlinie
GLM-5.3-Flash akzeptiert Bilder, Videos und Dateien als Inhaltsblöcke in derselben Chat-Vervollständigungsanfrage wie Ihr Text. GLM-5.3 tut dies nicht nativ; die Bildverarbeitung erfolgt über separate Adapter.
Wenn Ihre Anwendung ein Modell benötigt, das etwas betrachtet, ist dies kein Vergleich, sondern eine Anforderung. Flash ist das einzige der beiden Modelle, das dies in einem Aufruf, in einem Kontextfenster und auf einer Abrechnungszeile erledigt.
Diese Fähigkeit kombiniert sich mit dem 1M-Kontext auf eine Weise, die für diese Modellfamilie wirklich neu ist: Ein langes Spezifikationsdokument und ein Screenshot des erstellten Ergebnisses können denselben Prompt belegen. Die Eigenpositionierung von Z.ai spricht von der Beobachtung von Schnittstellen und der Wiedergabe von Ergebnissen, was eher eine Agenten-Codierungs-Rahmung als eine Bildbeschreibungs-Rahmung ist.
Unser Vision-Leitfaden behandelt die Nutzlast und die Workflows. Die älteren dedizierten Vision-Modelle werden im API-Leitfaden von GLM-5V-Turbo behandelt, falls Sie etwas pflegen, das auf diesem Weg aufgebaut ist.
Der Blickwinkel des Coding-Plans
Für Abonnenten des GLM Coding Plans ist die Berechnung anders und einfacher. Flash ist im Plan enthalten und bietet Berichten zufolge die dreifache nutzbare Quote von GLM-5.3. Z.ai weist auch darauf hin, dass Anrufe außerhalb der Spitzenzeiten die Hälfte der Standardpunkte verbrauchen.
Wenn Sie Claude Code oder Cline gegen Ihr Planziel ausführen, sind dreimal mehr Anfragen für einen dreipunktigen Indexrückgang ein einfacher Kompromiss für Routinearbeiten. Behalten Sie GLM-5.3 für die schwierigen Probleme und lassen Sie Flash das Volumen absorbieren. Die Einrichtung für beide Harnesses finden Sie in unserem Claude Code und Cline Leitfaden.
Überprüfen Sie den Quotenmultiplikator auf z.ai, bevor Sie damit planen, da sich die Planbedingungen häufiger ändern als die Modellspezifikationen.
Die Preisfrist
Ein 50%iger Einführungsrabatt auf GLM-5.3-Flash gilt bis zum 9. September 2026. Bis dahin betragen die effektiven Raten 0,075 $ Eingabe und 0,25 $ Ausgabe pro Million, was die Lücke zu GLM-5.3 auf etwa das Achtzehnfache vergrößert.
Nach Ablauf des Rabatts gelten die Listenpreise von 0,15 $ und 0,50 $, und der Unterschied verringert sich wieder auf etwa das Neunfache. In jedem Fall ist Flash deutlich günstiger. Die Frist ist wichtig für die Festlegung von Kostenprognosen, nicht für die Wahl zwischen den beiden Modellen. Unsere Preisübersicht enthält die berechneten Zahlen.
Eine Entscheidungsregel
Verwenden Sie GLM-5.3-Flash, wenn:
- Ihre Eingaben Bilder, Videos oder Dateien umfassen.
- Die Kosten pro Token die Einschränkung sind, die Sie optimieren.
- Sie Extraktion, Klassifizierung oder Routing mit hohem Volumen durchführen.
- Sie den Coding Plan nutzen und Ihre Quote besser ausschöpfen möchten.
- Sie MIT-lizenzierte, offene Gewichte möchten, die Sie selbst hosten können. Der lokale Betrieb deckt die Hardware ab.
Verwenden Sie GLM-5.3, wenn:
- Sie lange Antworten an einen wartenden Menschen streamen und der Durchsatz das gefühlte Erlebnis ist.
- Ihre Arbeit langwieriges Denken erfordert, bei dem sich drei Indexpunkte über mehrere Schritte summieren.
- Die Ausgabequalität von einer Person beurteilt und nicht durch einen Test überprüft wird.
Verwenden Sie beide, wenn: Sie routen können. Leiten Sie den Großteil des Verkehrs an Flash und eskalieren Sie bei Fehlern, geringem Vertrauen oder Aufgabentyp zu GLM-5.3. Der neunfache Preisunterschied macht einen Router lohnenswert, und da beide Modelle hinter demselben OpenAI-kompatiblen Endpunkt sitzen, ist das Routing ein Modell-ID-Tausch statt einer Integration.
Zwischen ihnen migrieren
Wenn Sie bereits GLM-5.3 nutzen und einen Wechsel evaluieren, ist der mechanische Teil trivial und der Validierungsteil ist die eigentliche Arbeit.
Was sich nicht ändert. Die Basis-URL, das Authentifizierungsschema, die Anforderungs- und Antwortstrukturen, Streaming-Semantiken und Tool-Calling-Schemas. Beide Modelle befinden sich hinter derselben OpenAI-kompatiblen Oberfläche. Der Austausch ist ein Modell-ID-String.
Was sich ändert. Die Kosten pro Aufruf sinken um etwa das Neunfache. Die Generierung verlangsamt sich um etwa die Hälfte. Die Schlussfolgerungsqualität verschiebt sich um drei Indexpunkte. Und Sie erhalten eine Bildeingabe, die zuvor nicht verfügbar war.
Was vor der Festlegung zu prüfen ist. Führen Sie Ihre realen Prompts durch beide Modelle und vergleichen Sie diese anhand von vier Achsen: Korrektheit der Ausgabe in überprüfbaren Fällen, End-to-End-Latenz einschließlich Generierungszeit statt nur des ersten Tokens, Token-Zählungen aus dem usage-Objekt jeder Antwort und Verhalten bei Ihrem längsten realistischen Kontext.
Der vierte Punkt fängt die meisten Probleme auf. Modelle, die bei kurzen Prompts gleichwertig erscheinen, können merklich abweichen, wenn der Kontext voll ist, und eine Benchmark-Tabelle wird Ihnen das niemals über Ihre eigenen Daten verraten.
Wenn Sie mit dem Basismodell begonnen haben, behandelt was GLM-5.3 ist es in eigenen Worten, und der GLM-5.3 API-Leitfaden enthält die Einrichtung, von der Sie migrieren.
Testen Sie es, anstatt der Tabelle zu vertrauen
Jede Zahl oben ist entweder eine Anbieterangabe oder ein Drittanbieter-Benchmark, der auf der Arbeitslast eines anderen durchgeführt wurde. Keines davon sagt Ihnen, wie sich diese beiden Modelle bei Ihren Prompts verhalten.
Der Tausch ist ein einzelner String. Richten Sie einen OpenAI-kompatiblen Client auf https://api.z.ai/api/paas/v4/ aus, führen Sie Ihre realen Prompts durch glm-5.3-flash und glm-5.3 und vergleichen Sie Ausgaben, Latenz und Token-Zählungen für den Traffic, der Ihnen wichtig ist. Der API-Leitfaden enthält die Einrichtung.
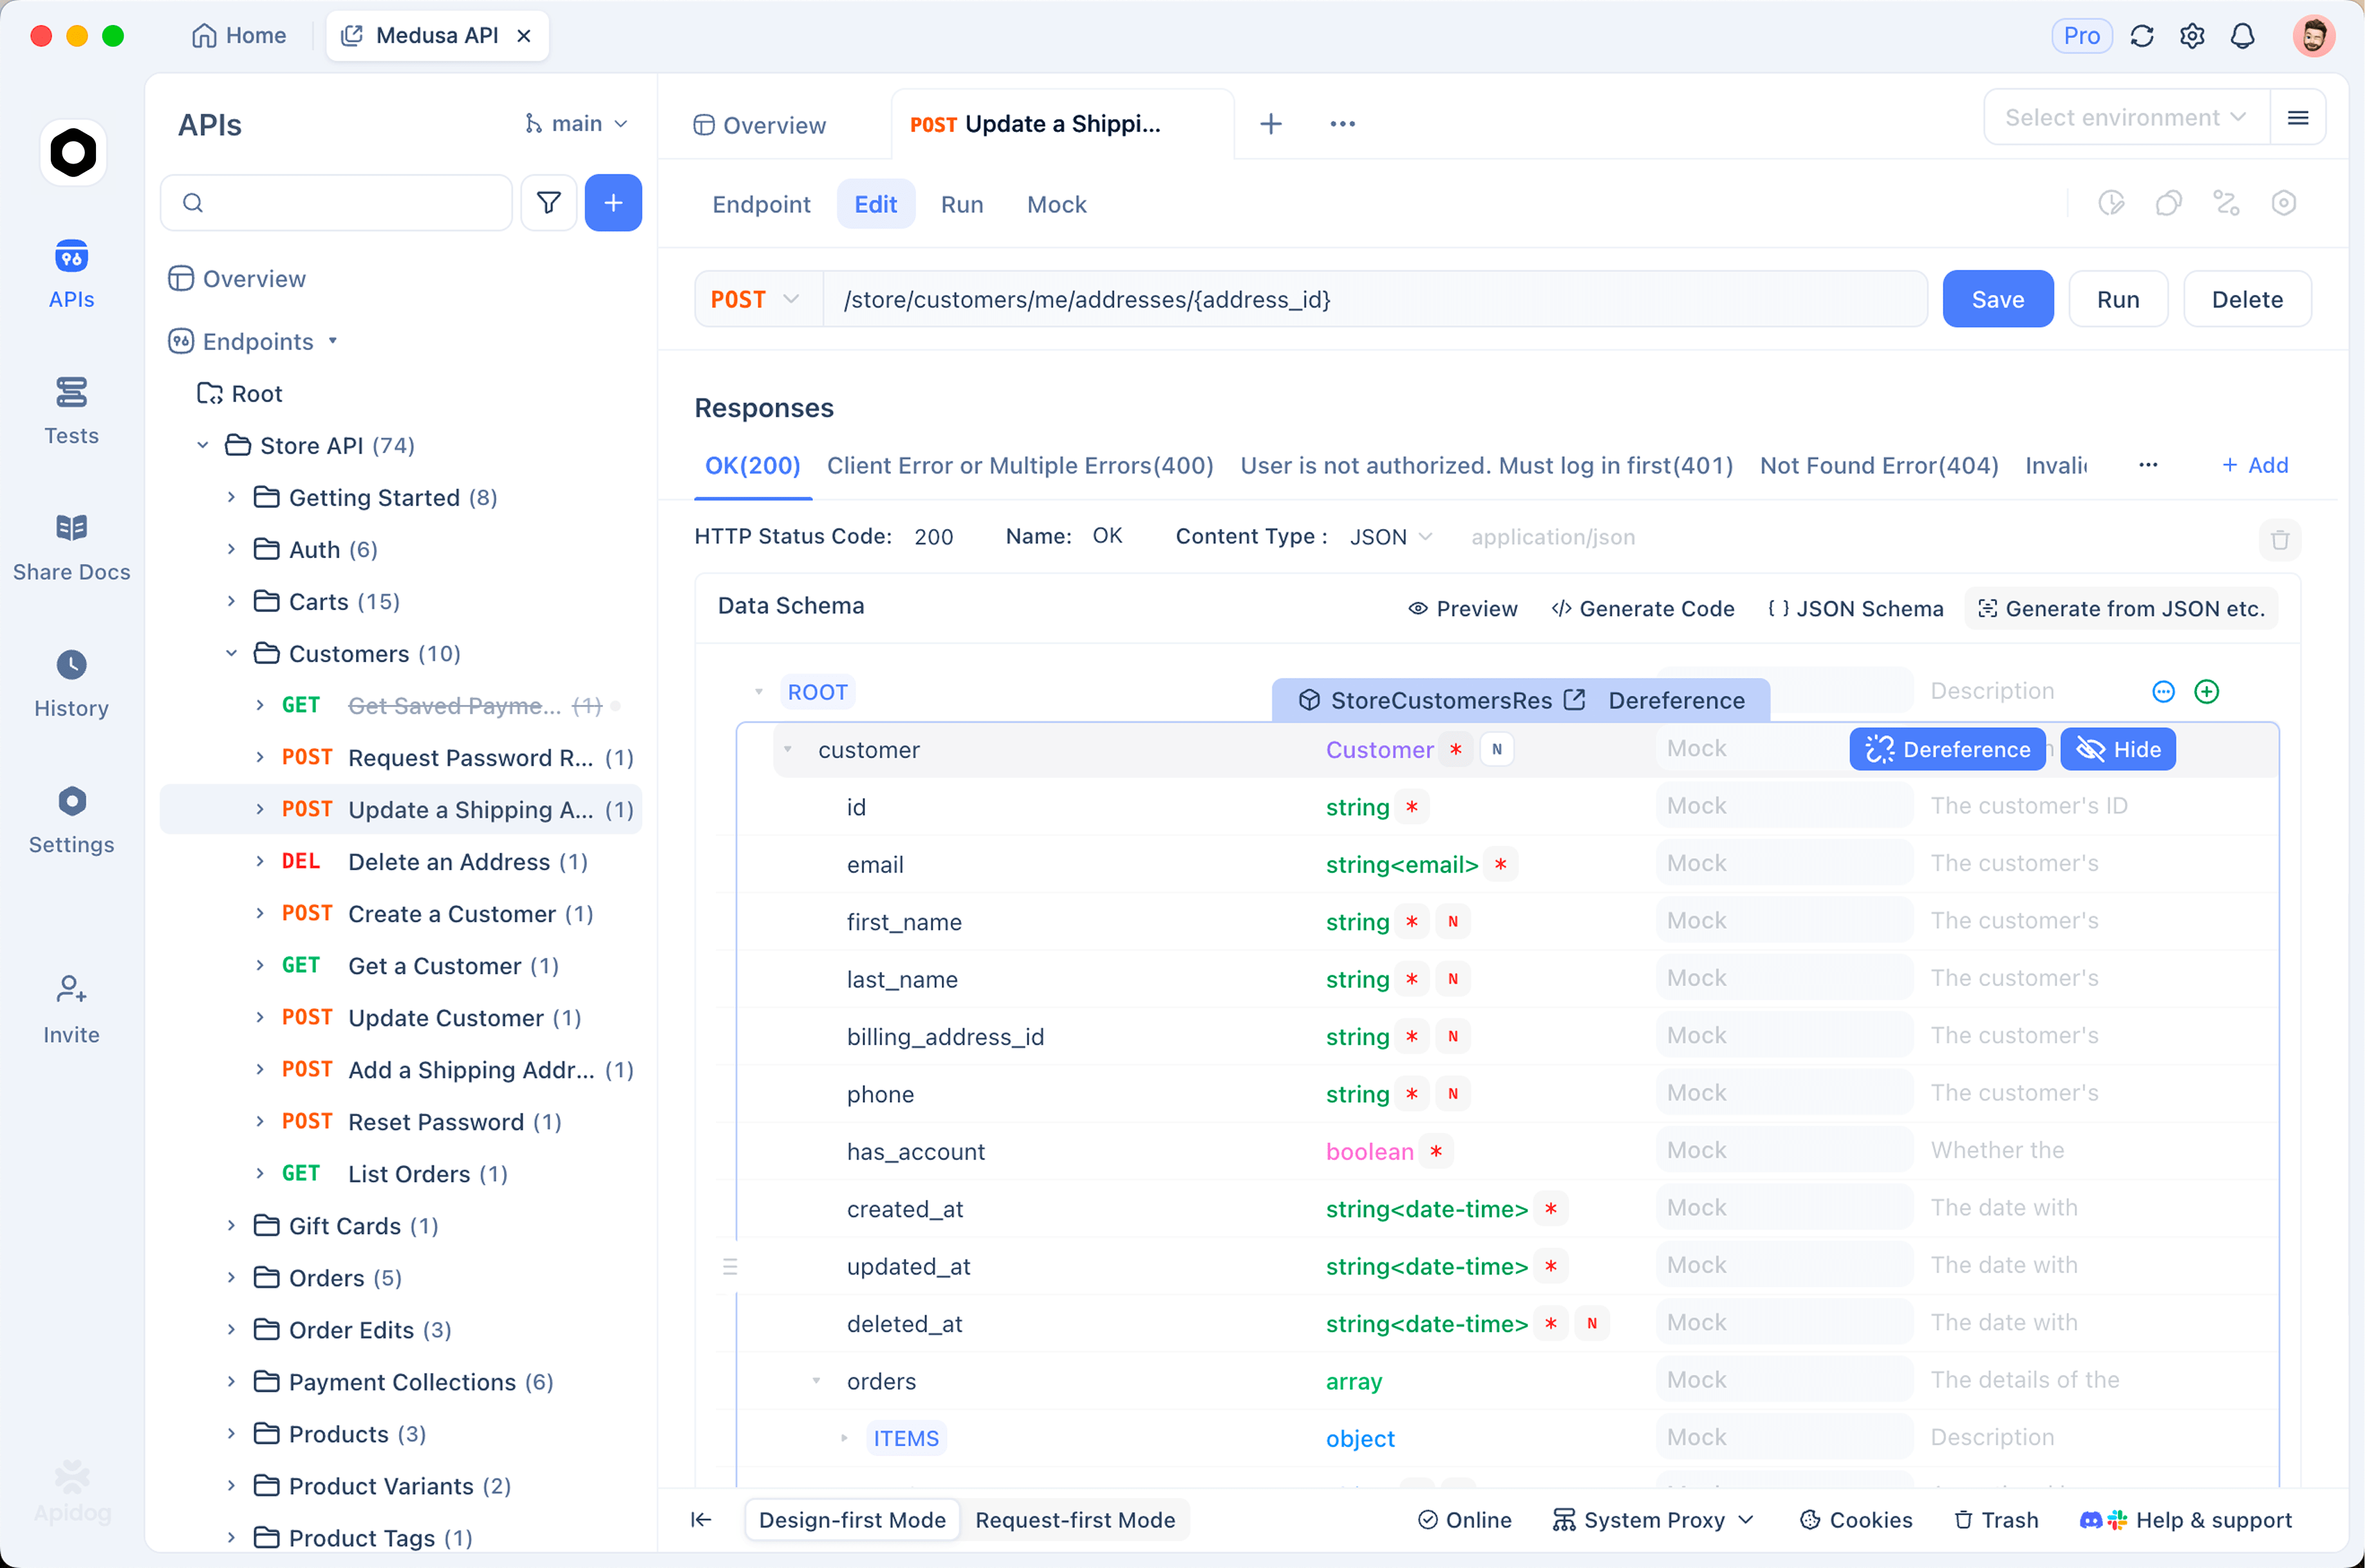
Hier zahlt es sich aus, den Vergleich als wiederholbare Suite zu speichern. In Apidog können Sie beide Aufrufe in einer Sammlung mit der Modell-ID als Umgebungsvariable speichern, Assertions an die Felder anhängen, die Ihre Anwendung liest, und das Ganze erneut ausführen, wenn der Rabatt abläuft oder Z.ai die nächste Revision ausliefert. Eine Modellwahl, die Sie in dreißig Sekunden erneut testen können, ist eine Entscheidung, die Sie überdenken können; eine, die in einer Shell-Historie lebt, ist es nicht.
FAQ
Ist GLM-5.3-Flash nur ein kleineres GLM-5.3? Nein. Es ist ein separat trainiertes Basismodell mit einer anderen Aufmerksamkeitsarchitektur, keine Destillation oder eine beschnittene Variante.
Haben sie dasselbe Kontextfenster? Ja, 1.048.576 Tokens für beide.
Welches ist besser für die Codierung? Flash erreicht laut Z.ai 84,3 Punkte bei Terminal-Bench 2.1 und 63,4 bei DeepSWE, was stark ist. GLM-5.3 ist bei der allgemeinen Schlussfolgerung etwas stärker. Für Nutzer des Coding-Plans entscheidet meist die 3-fache Quote.
Kann ich ohne Codeänderungen zwischen ihnen wechseln? Ja. Derselbe OpenAI-kompatible Endpunkt, unterschiedliche Modell-ID. Nur die Bildeingabe ist Flash-exklusiv.
Wird der günstigere Preis Bestand haben? Der Preis spiegelt einen kleineren KV-Cache und eine geringere Aufmerksamkeitsberechnung wider und ist keine Promotion, daher sollte der strukturelle Vorteil bestehen bleiben. Der zusätzliche 50%ige Einführungsrabatt läuft am 9. September 2026 ab.