
Die Gemini Decisions API ist ein neuer Google-Endpunkt, der geschlossene Fragen beantwortet, anstatt Text zu generieren. Sie senden eine gemeinsame Eingabe (Text, Bilder, Audio, Video oder PDF) plus bis zu 1.000 typisierte Fragen, und Gemini Decision 1 (gemini-decision-1) liefert für jede eine kalibrierte Wahrscheinlichkeit und einen Confidence-Score. Die Kosten betragen 0,10 $ pro 1M Eingabe-Tokens, der Output liegt immer bei 0 Tokens, und Google gibt 150 bis 250 ms Ende-zu-Ende an.
Google hat sie am 11. November 2026 als v1beta-Endpunkt eingeführt. Für die praktische Umsetzung sehen Sie sich how to use the Gemini Decisions API an.
Was Google mit Gemini Decision 1 veröffentlicht hat
Gemini Decision 1 ist ein Modell, das einen festen Satz von Kandidaten-Antworten in einem einzigen Forward-Pass bewertet, statt Text Token für Token zu dekodieren. Die Decisions API stellt es bereit, und Ihr Code erhält Zahlen, mit denen er verzweigen kann.
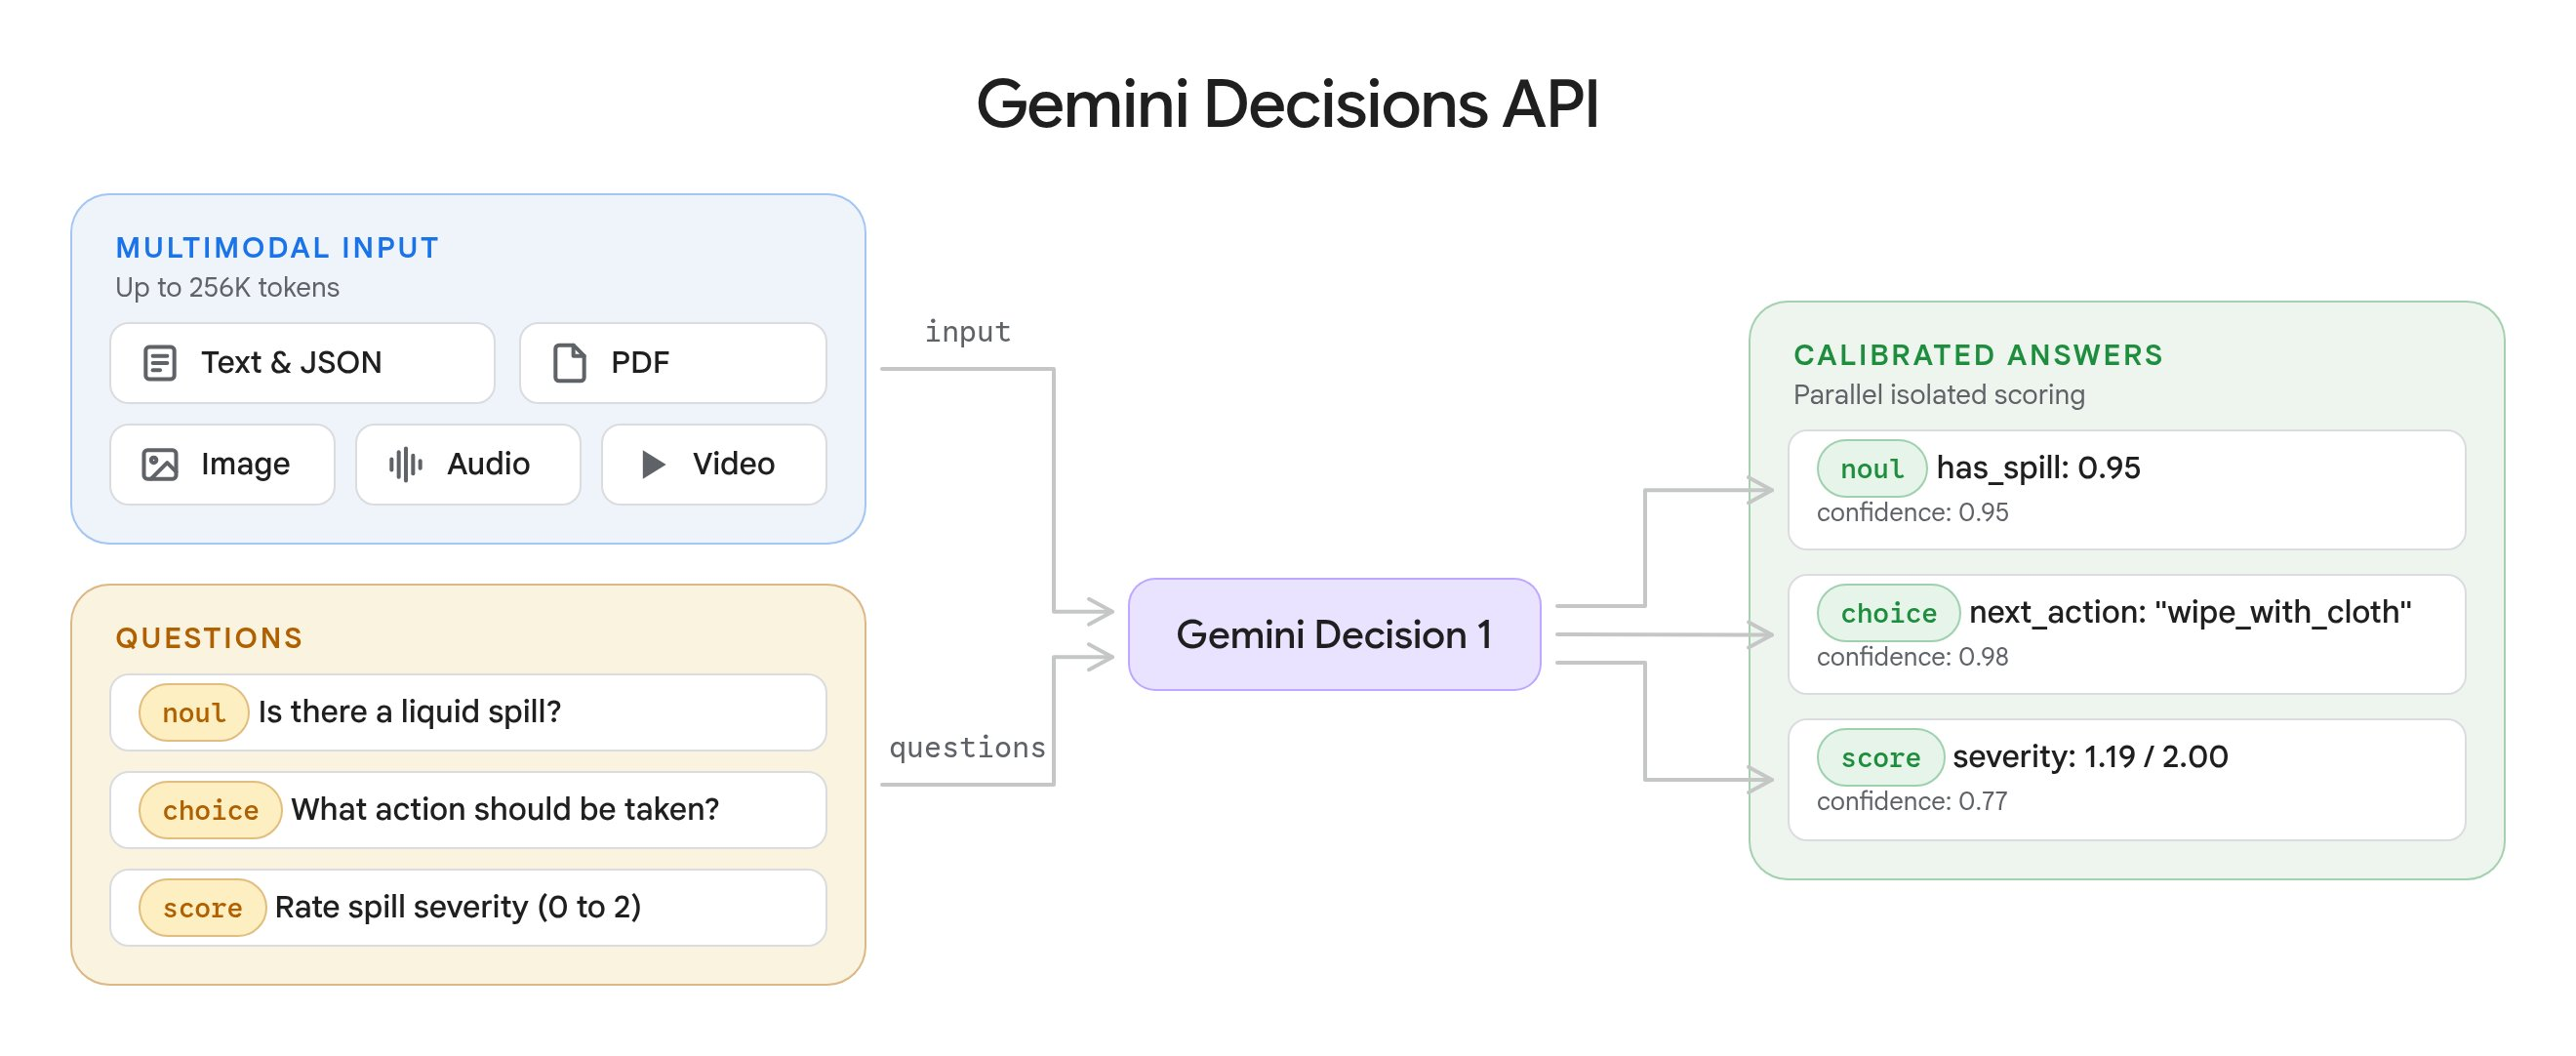
Der Launch-Beitrag „Gemini Decisions API: Fast, calibrated multimodal decisions“ nennt die wichtigsten Fakten:
- Modell-ID
gemini-decision-1, verfügbar über die Gemini API und Google AI Studio - Eine multimodale Eingabe pro Anfrage, mit einem Kontextfenster von bis zu 262.144 Tokens, das sich Eingabe und alle Fragen teilen
- 1 bis 1.000 unabhängige Fragen pro Anfrage, in drei Typen:
noul,choiceundscore - 0,10 $ pro 1M Eingabe-Tokens, 0 $ Output, plus eine kostenfreie Stufe für Prototyping
- SDK-Unterstützung in
google-genai3.2 oder neuer (client.decisions.create(...)), mit Integrationen für OpenRouter, LangChain, Vercel AI SDK und LiteLLM, die ausgerollt werden
Gemini in Google Cloud (Vertex AI) wird als „coming soon“ gelistet – derzeit läuft es also nur über die Developer API.
Warum ein Decision-Endpunkt statt eines Chat-Aufrufs
Die meisten „Klassifiziere das“-Codes rufen ein generatives Modell auf, fordern JSON an und parsen die Antwort. Sie zahlen für Output- und Thinking-Tokens, und der Parser bricht zusammen, sobald das Modell kreativ wird.
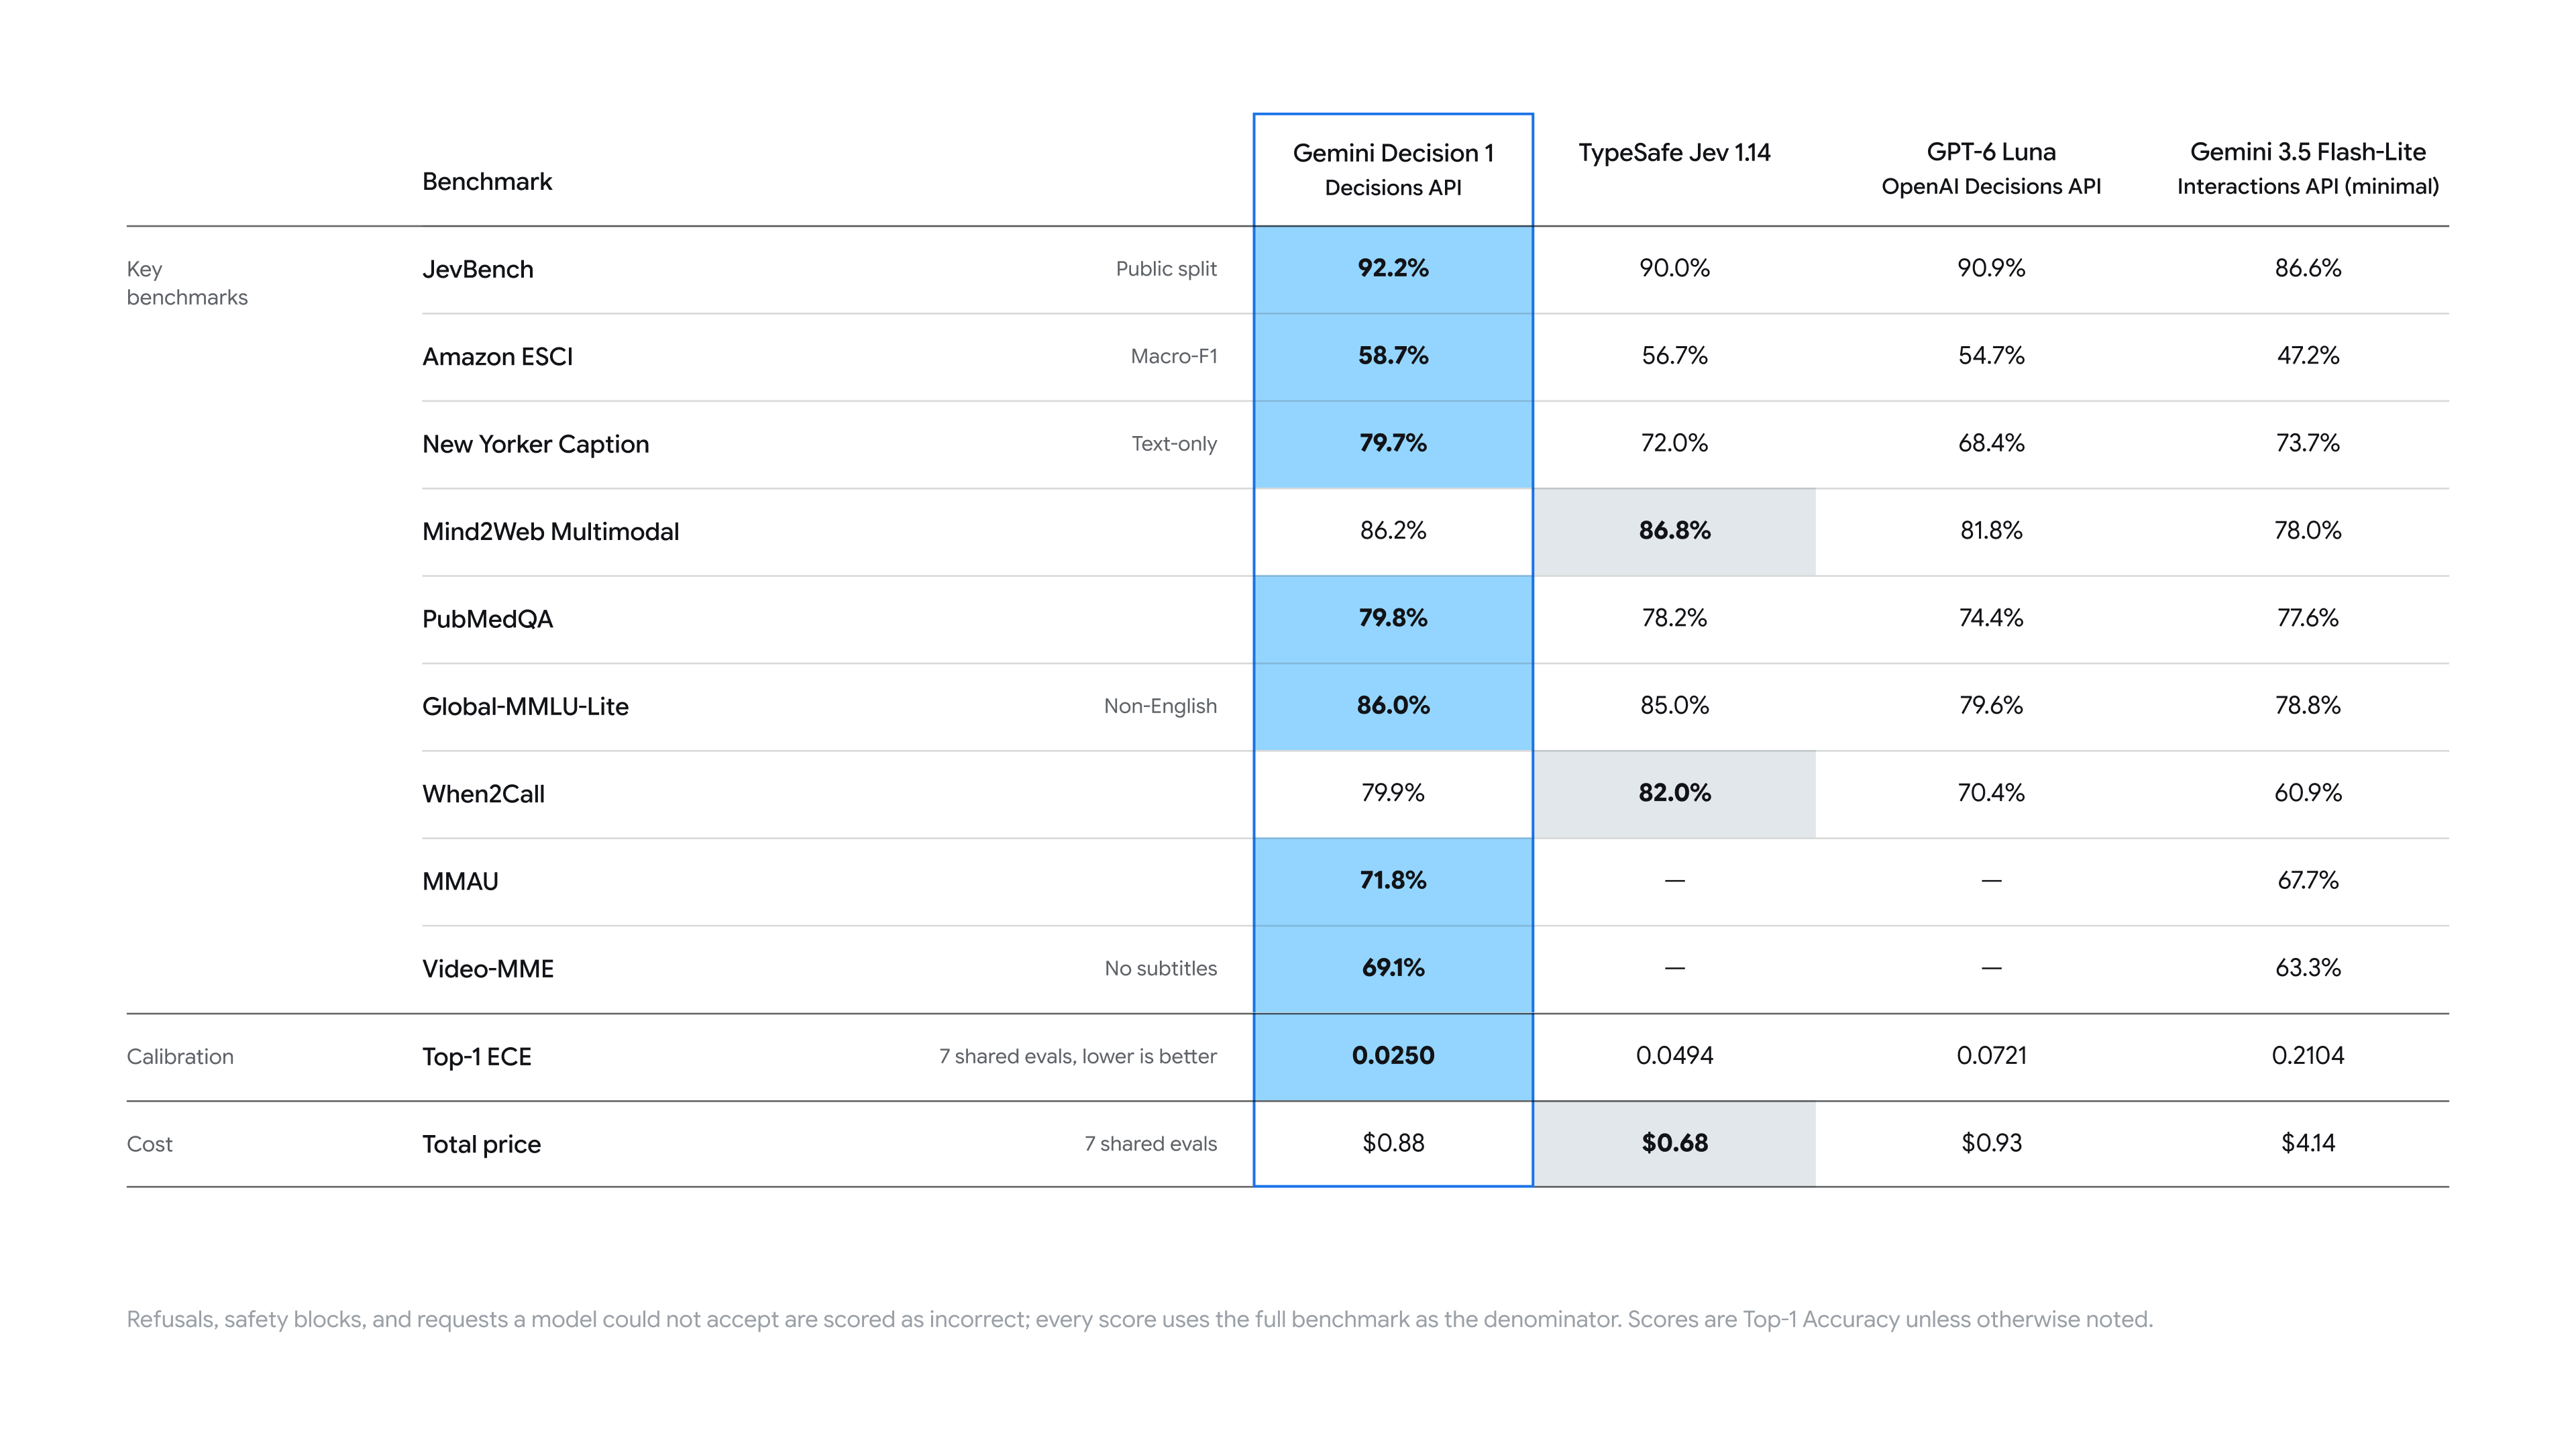
Die Decisions API entfernt den Generierungsschritt. Google bringt es in der Dokumentation auf den Punkt: Sie „generiert null Text-Tokens, die Output-Token-Nutzung ist also immer 0.“ Daraus ergeben sich drei Design-Entscheidungen:
- Paralleles, isoliertes Scoring. Jede Frage wird in einem Durchgang gegen die gemeinsame Eingabe geprüft. Fragen können einander nicht sehen, sodass das Hinzufügen oder Entfernen einer Frage die anderen Antworten nicht verändert.
- Wert plus Confidence. Der Wert sagt Ihrem Code, was zu tun ist. Die Confidence sagt ihm, ob es automatisch ausgeführt oder eskaliert werden soll.
- Atomare Prüfungen, im Code kombiniert. Sie stellen enge Fragen und kombinieren die Antworten mit normalen
if-Anweisungen und Gewichtungen.
Für generierten Text, schema-basierte Extraktion, Tool-Aufrufe oder mehrstufiges Reasoning verweist Google weiterhin auf die Interactions API.
Die drei Fragetypen
Jede Frage hat einen type, instructions und, bei zwei Typen, criteria. Das Modell sieht Ihre Frage-Keys nie, also schreiben Sie die vollständige Frage in instructions.
| Typ | Verwenden Sie ihn, um | Kriterien | Rückgabe |
|---|---|---|---|
noul |
Prüfen, ob eine Aussage zutrifft | Optionale true_description / false_description |
noul (0,01 bis 0,99), confidence |
choice |
Eine Option aus einer festen Liste auswählen | Pflicht-Map von Options-ID zu Beschreibung, 2 bis 255 Optionen | choice, probabilities (summieren sich zu 1), confidence |
score |
Die Eingabe anhand einer geordneten Rubrik bewerten | Pflicht-Array von Stufen, aufsteigend, 2 bis 255 (2 bis 10 empfohlen) | score, probabilities, legend, confidence |
Ein paar Verhaltensweisen sollten Sie kennen, bevor Sie Schwellenwerte festlegen:
noulerreicht nie 0 oder 1. Die Wahrscheinlichkeiten bleiben zwischen 0,01 und 0,99, eine Prüfung auf „über 0,99“ greift also nie.choice-Keys werden alphabetisch sortiert, bevor bewertet wird – nutzen Sie daher einen Sammel-Key wieotherund nichtnone_of_the_above, das nach vorne sortiert würde.choiceverteilt die Wahrscheinlichkeit immer auf Ihre Optionen, selbst wenn keine passt. Kombinieren Sie ihn daher mit einernoul-Scope-Prüfung oder einem Confidence-Schwellenwert.scoreist ein gewichteter Durchschnitt der Stufen-Indizes; 1,12 bedeutet also „überwiegend Stufe 1, teilweise Stufe 2“.
Confidence ist überall gleich definiert: als Wahrscheinlichkeit des Top-Ergebnisses, bzw. max(noul, 1 - noul) bei Ja/Nein-Fragen.
Eine Beispielanfrage und was zurückkommt
Der REST-Endpunkt lautet POST https://generativelanguage.googleapis.com/v1beta/decisions, authentifiziert über einen x-goog-api-key-Header. Diese Anfrage stellt eine Ja/Nein-Frage und eine Auswahl-Frage zu einer Support-Nachricht:
curl -X POST "https://generativelanguage.googleapis.com/v1beta/decisions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-decision-1",
    "input": "Audio cuts out on the left earcup. Fix it today or I cancel my membership.",
    "questions": {
      "is_defect": {
        "type": "noul",
        "instructions": "Does the message describe a hardware defect?"
      },
      "department": {
        "type": "choice",
        "instructions": "Which department should handle this request?",
        "criteria": {
          "billing": "Payments, invoices, and refunds.",
          "technical": "Problems using the product.",
          "shipping": "Delivery and tracking.",
          "other": "Anything outside these categories."
        }
      }
    }
  }'
Die Antwort enthält zwei Felder auf oberster Ebene: answers (gekeyt nach Ihren Frage-IDs) und usage:
{
  "answers": {
    "is_defect": { "type": "noul", "noul": 0.94, "confidence": 0.94 },
    "department": {
      "type": "choice",
      "choice": "technical",
      "probabilities": { "technical": 0.9, "other": 0.05, "billing": 0.03, "shipping": 0.02 },
      "confidence": 0.9
    }
  },
  "usage": { "total_input_tokens": 120, "total_output_tokens": 0, "total_tokens": 120 }
}
Die Zahlen sind illustrativ und entsprechen im Format den Beispielen in Googles Decisions-API-Dokumentation.
Für nicht-textliche Eingaben wird input zu einem Array von Inhaltsblöcken nach demselben Schema wie die Interactions API: text, image, audio, video und document (PDF). Medien können als Inline-Base64 (bis 100 MB pro Anfrage), als Files-API-URI oder als HTTPS-URL (jeweils bis 15 MB) übergeben werden. Bild- und Video-Blöcke nehmen eine resolution-Einstellung entgegen, um Detailgrad gegen Tokens einzutauschen.
Wenn ein Eingabe-Sicherheitsfilter eine Anfrage blockiert, erhalten Sie HTTP 400 mit einem error.code wie safety oder prohibited_content statt answers.
Preise, Latenz und Rate Limits der Gemini Decisions API
Die Abrechnung erfolgt nur für die Eingabe: 0,10 $ pro 1M Eingabe-Tokens im bezahlten Tarif, kostenfrei im Free-Tarif, und keine Output-Position, da der Output immer 0 Tokens beträgt. Das stammt von Googles Preisübersicht für die Gemini Developer API, geprüft am 12. November 2026. Dieselbe Seite weist darauf hin, dass Inhalte aus dem Free-Tarif zur Verbesserung von Googles Produkten genutzt werden, Inhalte aus dem Bezahl-Tarif jedoch nicht.
Zwei Abrechnungsdetails sind wichtig:
- Die gemeinsame Eingabe wird pro Anfrage einmal abgerechnet, egal wie viele Fragen Sie stellen. Jede Frage bringt nur ihre eigenen Instruction- und Criteria-Tokens ein.
- Context Caching, Batch API oder Flex/Priority-Inferenz gibt es für diesen Endpunkt nicht – dieselbe Eingabe, die in zwei Anfragen gesendet wird, wird also doppelt abgerechnet.
Grobe Überschlagsrechnung: Ein Support-Ticket mit 2.000 Tokens plus 20 Fragen à etwa 40 Tokens ergibt rund 2.800 Eingabe-Tokens, also etwa 0,00028 $ pro Decision-Aufruf im Bezahl-Tarif.
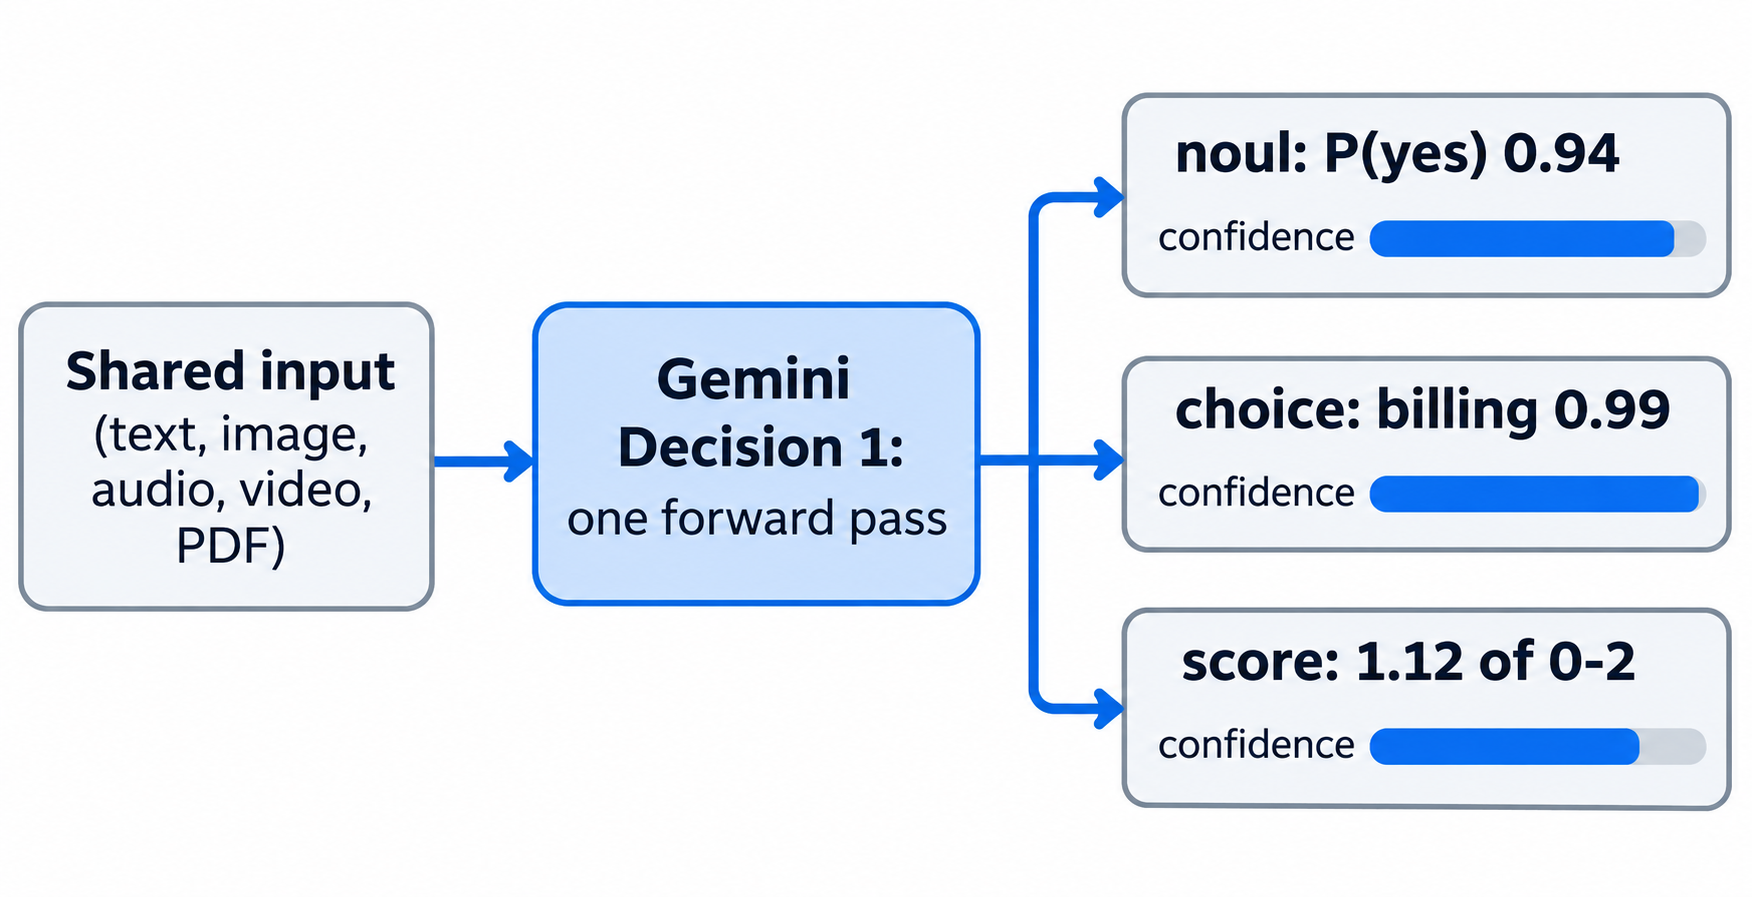
Die Latenzangaben stammen von Google selbst: median 50 bis 100 ms Modell-Compute, 150 bis 250 ms Ende-zu-Ende, nahezu konstant von 1 bis 100 Fragen bei Eingaben bis 16K Tokens. Google behauptet zudem den niedrigsten Kalibrierungsfehler seiner Benchmark-Suite und Kosten, die fast 5-mal niedriger liegen als bei Gemini 3.5 Flash-Lite über die Interactions API. Betrachten Sie beides als Herstellerangaben, bis Sie Ihren eigenen Traffic gemessen haben.
Rate Limits laut Googles Rate-Limits-Seite, geprüft am 12. November 2026:
| Nutzungsstufe | Anfragen/Min. | Tokens/Min. | Anfragen/Tag |
|---|---|---|---|
| Free | 200 | 50.000 | 10.000 |
| Tier 1 | 1.500 | 1.000.000 | 50.000 |
| Tier 2 | 5.000 | 4.000.000 | Unbegrenzt |
| Tier 3 | 15.000 | 10.000.000 | Unbegrenzt |
Der Free-Tarif wird ausführlich in Gemini Decisions API for free behandelt.
Wofür sich die Decisions API eignet
Googles Dokumentation nennt fünf Muster, auf die auch interne Teams von Google setzen:
- Model-Routing. Gemini Notebook leitet Anfragen an eine Modellstufe und ein Thinking-Level weiter – laut Google mit bis zu 40 % niedrigerer Latenz bei alltäglichen Anfragen.
- Policy-Prüfungen. Viele Regeln gegen eine Eingabe in einem einzigen Aufruf; Google Search nutzt sie als Sicherheitsschicht für MCP-Tools.
- Agenten-Steuerung. Welche Tools geladen werden sollen oder ob kompaktiert, eskaliert oder gestoppt werden soll.
- Bewertung und Ranking. Kandidaten oder abgerufene Chunks anhand einer Rubrik bewerten.
- Echtzeit-Medien. CC aus Google Labs wählt aus über 200 Optionen ein Emoji aus.
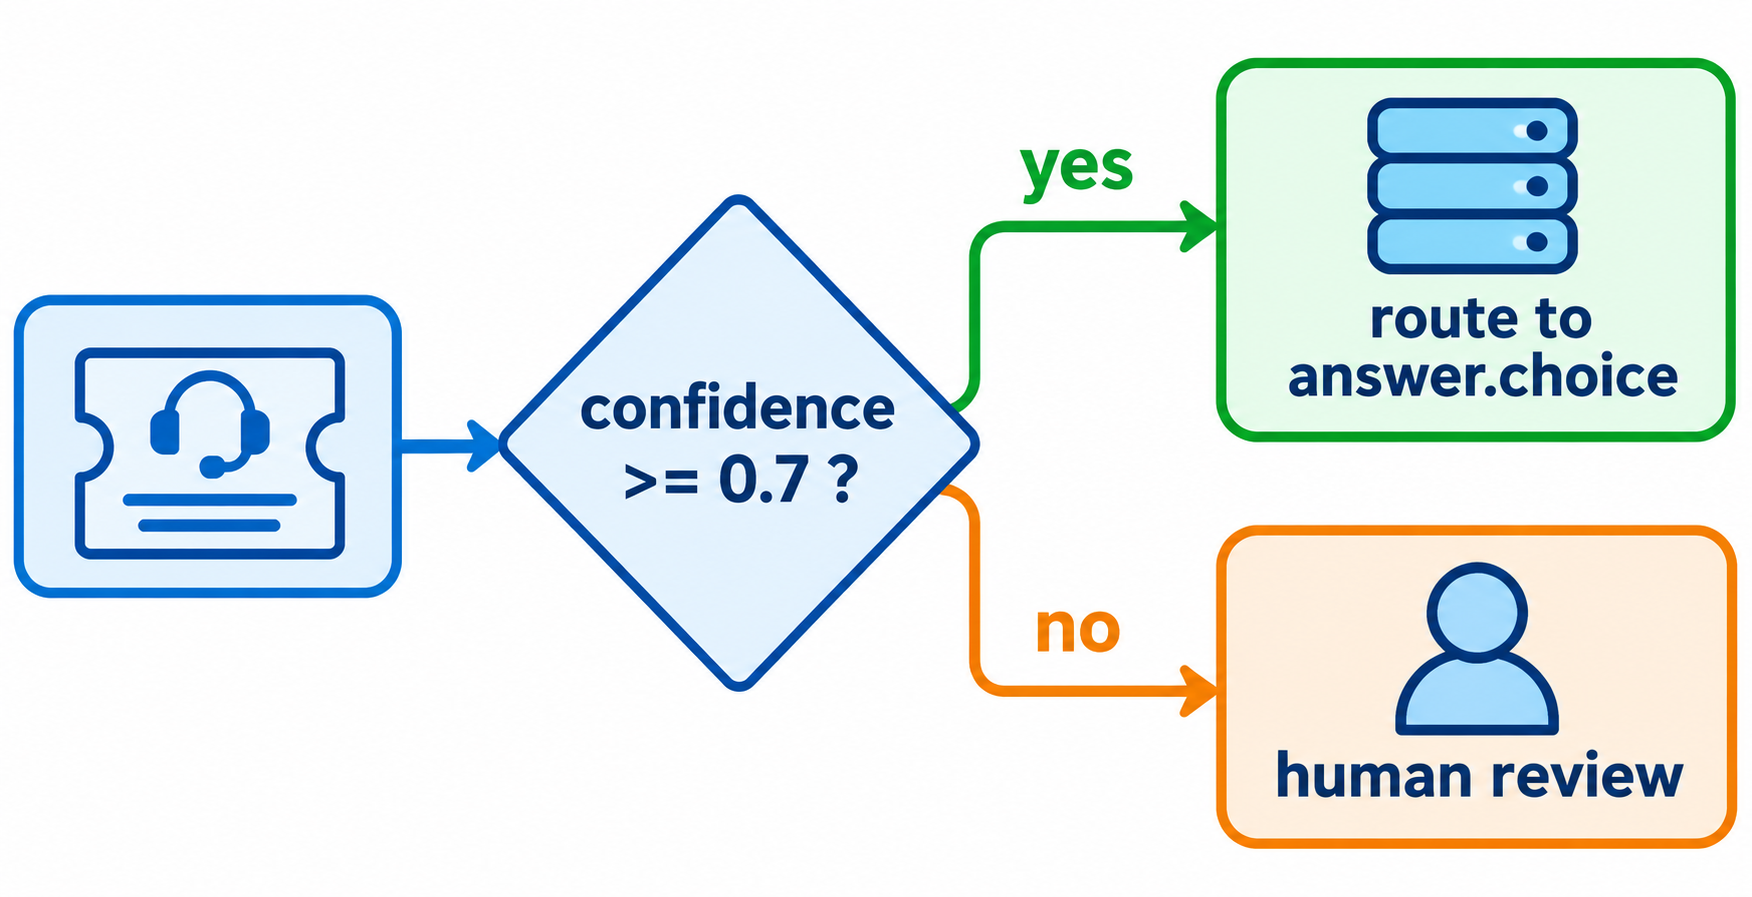
Googles Empfehlung: Legen Sie diesen Schwellenwert anhand gelabelter Beispiele aus Ihrem eigenen Traffic fest und wägen Sie die Kosten eines False Positive gegen die eines False Negative ab.
OpenAI hat im Oktober einen ähnlichen Endpunkt auf GPT-6 Luna veröffentlicht, mit predicate-, choice- und score-Fragen; unser OpenAI Decisions API explainer behandelt ihn. Der direkte Vergleich von Limits, Modalitäten und Preisen findet sich in Gemini Decisions API vs OpenAI Decisions API.
Grenzen und offene Fragen
Was die Dokumentation heute festhält:
v1betaüber die Gemini Developer API, nur mit Gemini Decision 1- Frage-Instructions sind reiner Text; Medien in Fragen werden nicht unterstützt
- Konversationsverlauf, Thought- und Tool-Call-Blöcke sind keine gültige Eingabe; serialisieren Sie Mehrturn-Kontext als Text
Ein GA-Datum, Regionen oder Daten-Residenz-Bedingungen hat Google noch nicht veröffentlicht. Es warnt außerdem, dass Nutzertext für die eigene Klassifizierung argumentieren kann – behalten Sie daher bei hochriskanten Aktionen wie Auszahlungen eine menschliche Kontrolle bei.
Lassen Sie Ihren Coding-Agenten sie mit Apidog CLI testen
Ein Decision-Endpunkt ist nur nützlich, wenn sein Vertrag hält: jede Confidence zwischen 0 und 1, jedes choice innerhalb Ihres Sets. Ihr Coding-Agent kann diesen Regressionstest mit der Apidog CLI schreiben und ausführen, während Sie weiterarbeiten.
Einmalig einrichten:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
Dann geben Sie Ihrem Agenten einen einzigen Prompt:
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and a secret variable GEMINI_API_KEY.
Define POST /v1beta/decisions with header x-goog-api-key: {{GEMINI_API_KEY}}
and the support-ticket body from this article. Add a test case asserting:
status 200, usage.total_output_tokens == 0, every answers.*.confidence is
between 0 and 1, answers.department.choice is one of billing|technical|shipping|other,
and answers.is_defect.noul is between 0.01 and 0.99. Run it and summarize failures.
Der Agent validiert jede Payload gegen ihr Schema und erstellt und führt dann den Testfall aus:
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get environment-update
apidog environment update <envId> --project <projectId> --file env.json
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file decisions-endpoint.json
apidog endpoint create --project <projectId> --file decisions-endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file decisions-case.json
apidog test-case create --project <projectId> --file decisions-case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Um den Key aus der gespeicherten Umgebung herauszuhalten, übergeben Sie ihn stattdessen zur Laufzeit mit --env-var "GEMINI_API_KEY=...". Derselbe apidog run-Aufruf mit -r junit lässt sich in CI integrieren; die apidog run command reference listet jedes Flag auf, und Apidog CLI in Claude Code zeigt das komplette Agenten-Setup. Apidogs Free-Plan deckt bis zu 4 Nutzer ab.
FAQ
Ist die Gemini Decisions API kostenlos? Ja, innerhalb des Free-Tarifs: 200 Anfragen pro Minute, 50.000 Tokens pro Minute und 10.000 Anfragen pro Tag. Bezahlte Nutzung kostet 0,10 $ pro 1M Eingabe-Tokens.
Wie viele Fragen kann ich in einer Anfrage stellen? Von 1 bis 1.000, begrenzt durch das Kontextfenster von 262.144 Tokens, das sich Eingabe und jede Frage teilen.
Was bedeutet noul? Es ist der Ja/Nein-Fragetyp. Er liefert die Wahrscheinlichkeit, dass die Antwort Ja ist, zwischen 0,01 und 0,99, plus einen Confidence-Score.
Kann ich sie auf Vertex AI nutzen? Noch nicht. Google listet Gemini-in-Google-Cloud-Support als „coming soon“; derzeit läuft sie über die Gemini Developer API (v1beta).
Unterstützt sie Batch oder Context Caching? Nein. Context Caching, die Batch API sowie Flex- oder Priority-Inferenz werden nicht unterstützt, daher wird wiederholte Eingabe voll abgerechnet.