
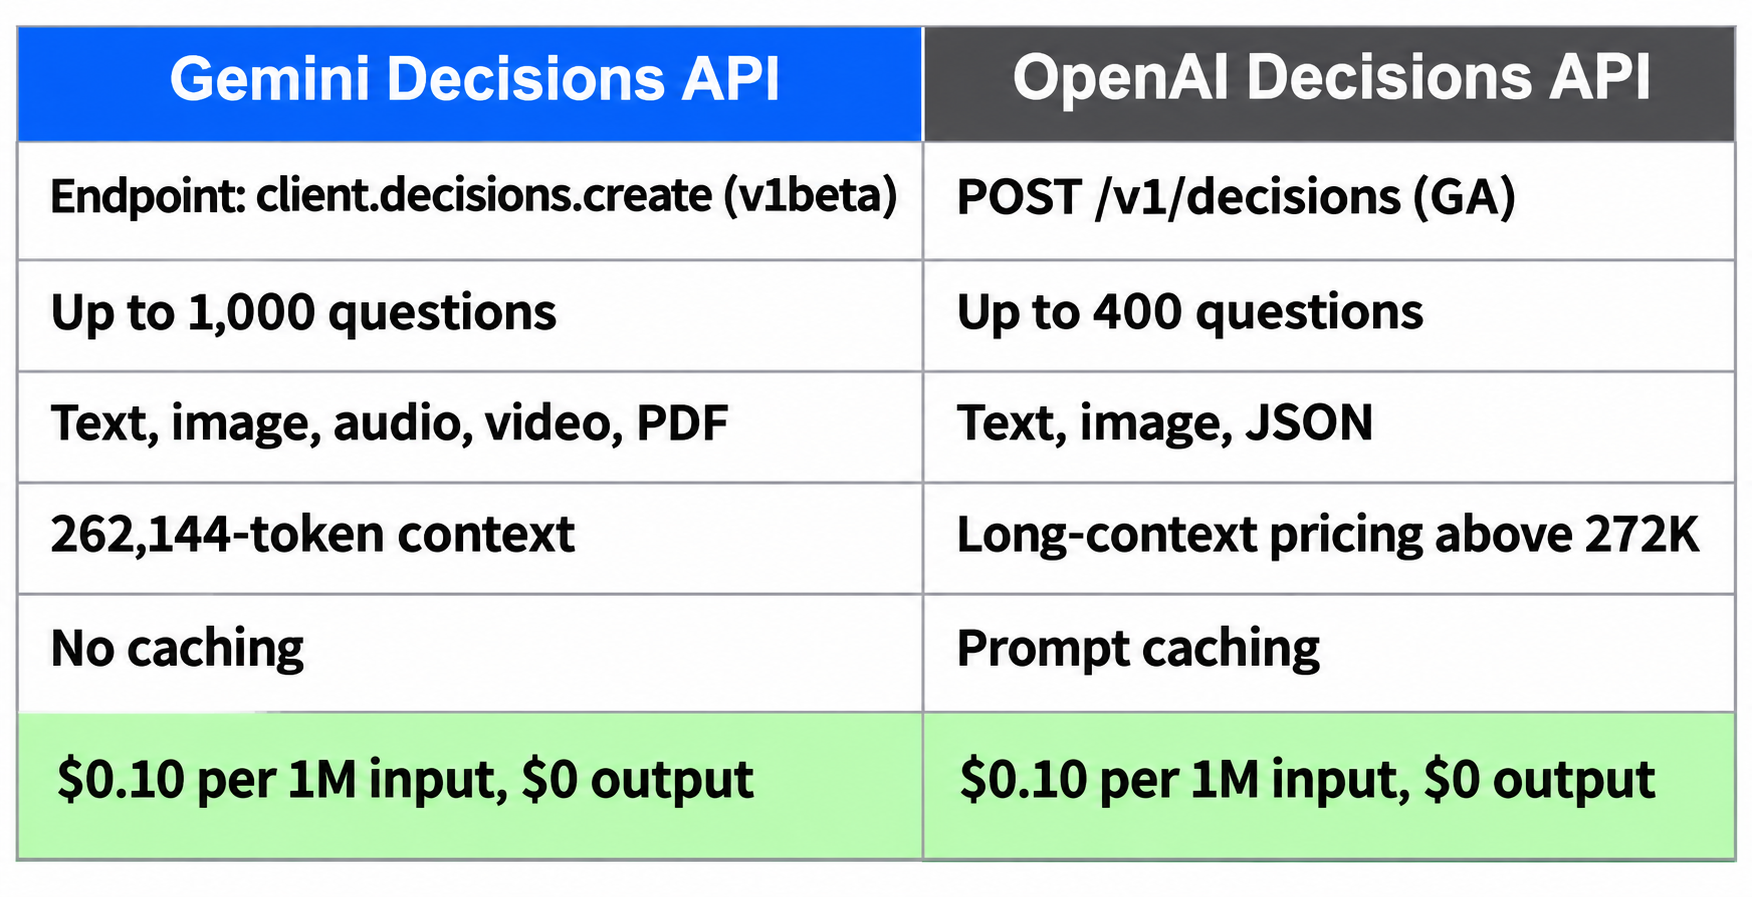
Bei der Frage „Gemini Decisions API vs. OpenAI Decisions API" geht es um Eingaben und Limits, nicht um den Preis. Beide kosten $0,10 pro 1M Eingabe-Tokens und nichts für die Ausgabe. Wählen Sie Gemini, wenn Sie Audio-, Video- oder PDF-Eingaben, mehr als 400 Fragen pro Anfrage oder ein kostenloses Kontingent benötigen. Wählen Sie OpenAI, wenn Sie einen GA-Endpunkt, Prompt-Caching, JSON- und Tool-Call-Evidenz oder ZDR- und HIPAA-Bedingungen brauchen.
Was eine Decisions API macht
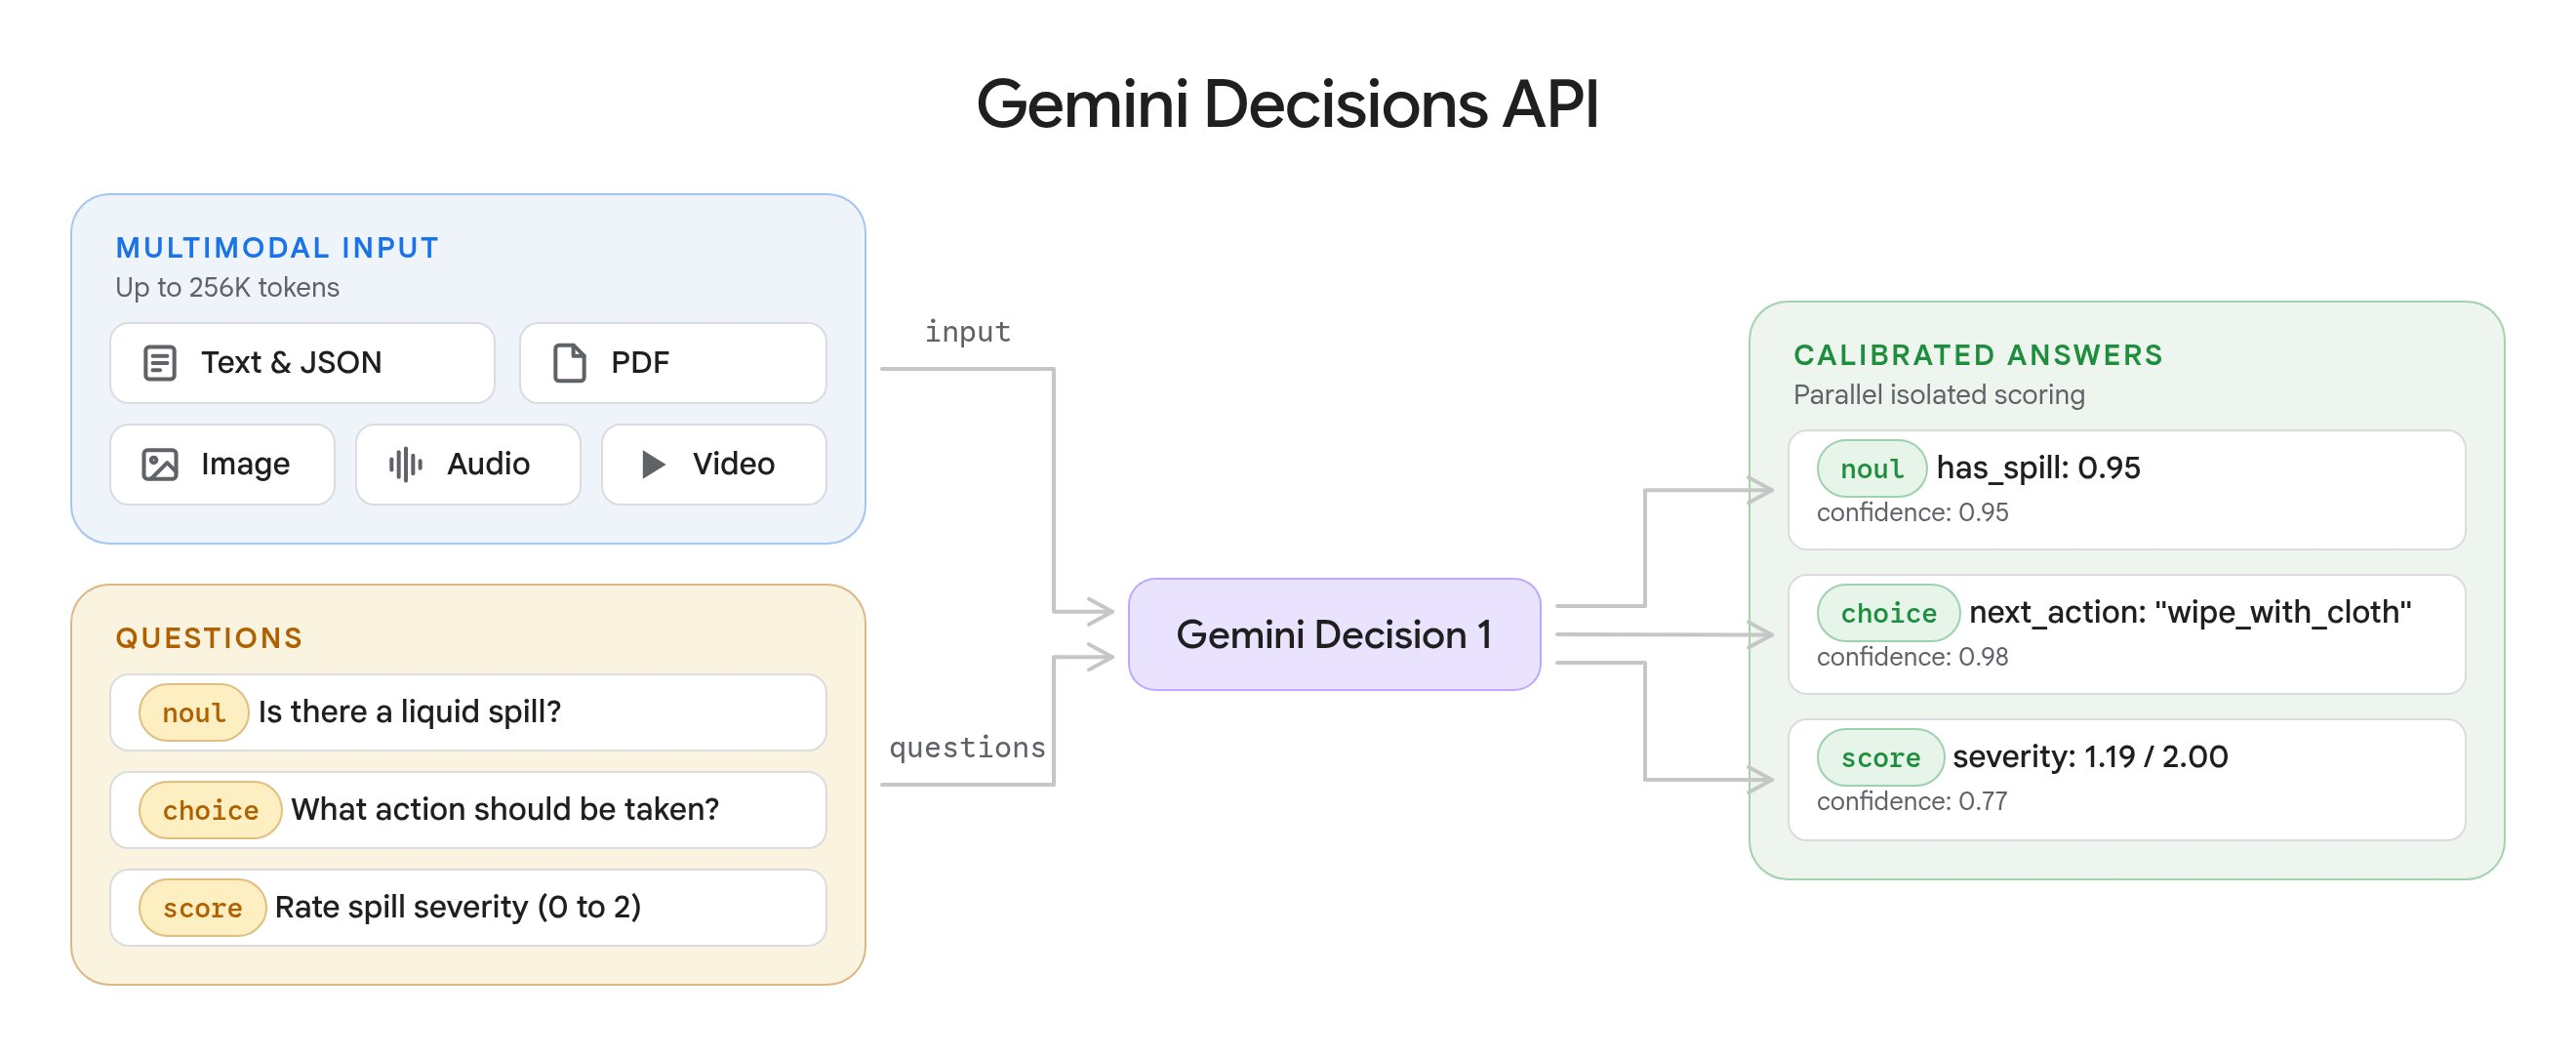
Eine Decisions API ist ein Endpunkt, der geschlossene Fragen zu Ihrer Eingabe beantwortet, anstatt Text zu generieren. Sie senden gemeinsame Evidenz plus eine Liste typisierter Fragen (Ja/Nein, Auswahl einer Option, Bewertung auf einer Skala) und erhalten Wahrscheinlichkeiten und einen Confidence-Score pro Antwort zurück. Ausgabe-Tokens kosten nichts, Sie zahlen also nur für die Eingabe.
OpenAI hat die erste geliefert. Ihre Decisions API ging am 22. Oktober 2026 mit gpt-6-luna an den Start (GA). Google antwortete am 11. November 2026 mit der Gemini Decisions API, angetrieben von einem neuen Modell, gemini-decision-1.
Beide zielen auf Routing, Tool-Auswahl, Richtlinienprüfungen und Rubric-Bewertung ab. Sie unterscheiden sich darin, was Sie ihnen füttern können und wie weit eine einzelne Anfrage reicht.
Gemini Decisions API vs. OpenAI Decisions API auf einen Blick
Jede Zeile stammt aus der Dokumentation des jeweiligen Anbieters, gelesen am 12. November 2026. „Nicht dokumentiert" bedeutet, dass die Dokumentation dazu nichts sagt.
| Gemini Decisions API | OpenAI Decisions API | |
|---|---|---|
| Modell | gemini-decision-1 (einzige Option) |
gpt-6-luna (einzige Option) |
| Status | v1beta in der Gemini Developer API |
GA seit 22. Oktober 2026 |
| Aufruf | client.decisions.create(...), SDK 3.2+ |
POST /v1/decisions |
| Fragen pro Anfrage | 1 bis 1.000 | 1 bis 400 |
| Form der Fragen | Map mit Ihren eigenen IDs als Schlüssel | Array, jede mit optionalem name |
| Ja/Nein-Typ | noul (0,01 bis 0,99) |
predicate (0 bis 1) |
| Auswahlmöglichkeiten | 2 bis 255 | 2 bis 255 |
| Score-Stufen | 2 bis 255 (2 bis 10 empfohlen) | 2 bis 10 |
| Eingabetypen | Text, Bild, Audio, Video, PDF | Text, Bild, input_json, Tool-Calls und -Ausgaben |
| Medien im Fragetext | Nein, nur Text | Ja, Bilder in instructions |
| Kontextfenster | 262.144 Tokens | Für den Endpunkt nicht dokumentiert; Long-Context-Preise oberhalb von 272K |
| Eingabepreis | $0,10 / 1M | $0,10 / 1M (2x oberhalb von 272K) |
| Ausgabepreis | $0 | $0 |
| Caching | Nicht unterstützt | Prompt-Caching, $0,01 / 1M gecachte Eingabe |
| Batch / Flex | Nicht unterstützt | Nicht dokumentiert |
| Kostenloses Kontingent | Ja, in Google AI Studio | Für diesen Endpunkt nicht dokumentiert |
| Veröffentlichte Latenz | 150 bis 250 ms End-to-End (Angabe von Google) | „Etwa 10x schneller als die Responses API" |
| Rate Limits | Pro Tier veröffentlicht | Pro Organisation, nicht pro Endpunkt veröffentlicht |
| ZDR / HIPAA | Nicht dokumentiert | Für berechtigte Kunden unterstützt |
| Regionale Verarbeitung | Nicht dokumentiert | USA und EU, 10 % Aufpreis |
Anfrageformat: dieselbe Idee, anderes JSON
Die beiden APIs sehen ähnlich aus, bis Sie das Payload schreiben. Gemini versieht Fragen mit Ihren eigenen IDs als Schlüssel und nennt seinen Ja/Nein-Typ noul:
result = client.decisions.create(
    model="gemini-decision-1",
    input="I was charged twice for my order.",
    questions={
        "department": {
            "type": "choice",
            "instructions": "Which department should handle this request?",
            "criteria": {"billing": "Payments and refunds.", "other": ""},
        },
    },
)
OpenAI erwartet ein geordnetes Array, verwendet predicate für Ja/Nein und listet Auswahlmöglichkeiten als value- und description-Objekte. Unser Schritt-für-Schritt-Leitfaden zu OpenAI enthält die vollständige Anfrage.
Drei Unterschiede sind im Produktionscode relevant:
- Antwort-Lookup. Gemini gibt eine Map zurück, die mit Ihren Frage-IDs verschlüsselt ist. OpenAI gibt ein Array zurück, das Sie über
namezuordnen. - Verweigerungen. OpenAI kann für eine einzelne Frage eine
refusal-Antwort zurückgeben, während die anderen Fragen trotzdem beantwortet werden. Gemini blockiert die gesamte Anfrage mit HTTP 400 und einemsafety- oderprohibited_content-Code, wenn Eingabefilter anschlagen. - Reihenfolge der Auswahlmöglichkeiten. Gemini sortiert Optionsschlüssel alphabetisch vor der Bewertung, sodass ein Schlüssel wie
none_of_the_abovevorshippinglandet. Verwenden Sie bei Geminiotherals Sammeloption.
Geminis noul-Wahrscheinlichkeiten liegen zwischen 0,01 und 0,99, sodass ein Schwellenwert von > 0,99 nie auslöst. Das Drei-Typen-Fragenmodell kommt Ihnen bekannt vor, wenn Sie unseren OpenAI-vs.-Jev-Vergleich gelesen haben.
Eingaben und Limits: wo Gemini die Nase vorn hat
Geminis Eingabe verwendet die Content-Blöcke der Interactions API: text, image, audio, video und document (PDF). Kombinieren Sie einen Anrufmitschnitt mit Kontometadaten und stellen Sie dazu 1.000 Fragen. Inline-Daten umfassen bis zu 100 MB pro Anfrage (50 MB für PDFs); Files-API-URIs und HTTPS-URLs funktionieren bis zu je 15 MB. Bild- und Video-Blöcke akzeptieren eine resolution-Einstellung, um Detailtiefe gegen Tokens einzutauschen.
OpenAI deckt weniger Medien ab, aber mehr Struktur. Laut dem OpenAI-Decisions-Leitfaden akzeptiert input Text, Bilder und input_json-Teile sowie den Konversationsverlauf mit Funktionsaufrufen und deren Ausgaben. Dateien und Audio werden nicht unterstützt. Die instructions jeder Frage können ein eigenes Bild enthalten – praktisch, um viele Kandidaten gegen eine Referenz zu vergleichen.
Die Aufteilung:
- Audio, Video oder gescannte PDFs als Evidenz: Gemini.
- Tool-Call-Transkripte oder rohes JSON: OpenAI nativ; bei Gemini müssen sie in Text serialisiert werden.
- Bilder pro Frage: nur OpenAI.
Preise: gleicher Aufkleber, unterschiedliche Rechnungen
Beide listen $0,10 pro 1M Eingabe-Tokens ohne Ausgabegebühr, und beide berechnen die gemeinsame Eingabe einmal pro Anfrage. Die Rechnungen weichen bei wiederholter Eingabe ab.
Geminis Dokumentation stellt klar, dass die Decisions API kein Context-Caching, Batch, Flex oder Priority unterstützt und dass „wiederholte Eingaben über Anfragen hinweg voll in Rechnung gestellt werden". OpenAI hat Prompt-Caching zum GA-Zeitpunkt hinzugefügt. Ein gemeinsames input-Präfix von mindestens 1.024 Tokens kann den Cache zum Preis von $0,01 pro 1M treffen, wobei Cache-Schreibvorgänge zu Lunas Standardtarifen abgerechnet werden ($0,125 pro 1M für 30-Minuten-Schreibvorgänge). Prüfen Sie OpenAIs Preisseite für die aktuellen Cache-Tarife.
Ein Rechenbeispiel (unsere Arithmetik, keine Anbieterangabe): Jede Anfrage prüft dasselbe 10.000-Token-Richtliniendokument mit 20 Fragen à 50 Tokens, eine Million Mal pro Monat.
- Gemini: 11.000 Tokens x 1M Anfragen = 11 Mrd. Tokens x $0,10 pro 1M = $1.100.
- OpenAI, alle Cache-Treffer: 10 Mrd. gecachte Tokens x $0,01 pro 1M = $100, plus 1 Mrd. nicht gecachte Frage-Tokens x $0,10 pro 1M = $100, also rund $200 plus Cache-Schreibvorgänge.
Bei frischer Eingabe bei jeder Anfrage – etwa einem neuen Ticket oder Foto – kann Caching nicht helfen, und beide kosten pro Token dasselbe. OpenAI wendet oberhalb von 272K Eingabe-Tokens zudem einen 2x-Multiplikator und einen 10-%-Aufpreis für regionale Verarbeitung an.
Geminis Trumpf ist das kostenlose Kontingent. Google Preisseite listet die Gemini-Decision-Eingabe dort als „kostenlos", aber Daten aus dem kostenlosen Kontingent werden zur Verbesserung von Googles Produkten verwendet. Daten aus bezahlten Tarifen nicht.
Geschwindigkeit und Rate Limits
Google sagt, dass Gemini Decision 1 Optionen in einem einzigen Forward-Pass bewertet: 50 bis 100 ms mediane Modellrechenzeit, 150 bis 250 ms End-to-End, nahezu konstant von 1 bis 100 Fragen, bei Eingaben bis zu 16K Tokens. Das sind Googles Behauptungen, bis Sie sie selbst messen.
OpenAI veröffentlicht ein Verhältnis statt einer Zahl: „etwa 10x schneller als die Responses API." Unsere Analyse von Decisions vs. Responses API erläutert, was das bedeutet.
Die Rate Limits folgen demselben Muster. Googles Rate-Limit-Seite listet die Gemini-Decision-Limits pro Tier auf:
| Tier | RPM | TPM | RPD |
|---|---|---|---|
| Kostenlos | 200 | 50.000 | 10.000 |
| Tier 1 | 1.500 | 1.000.000 | 50.000 |
| Tier 2 | 5.000 | 4.000.000 | Unbegrenzt |
| Tier 3 | 15.000 | 10.000.000 | Unbegrenzt |
OpenAI veröffentlicht kein Decisions-spezifisches Limit; prüfen Sie die Limits-Seite Ihrer Organisation.
Wann Sie welches wählen sollten
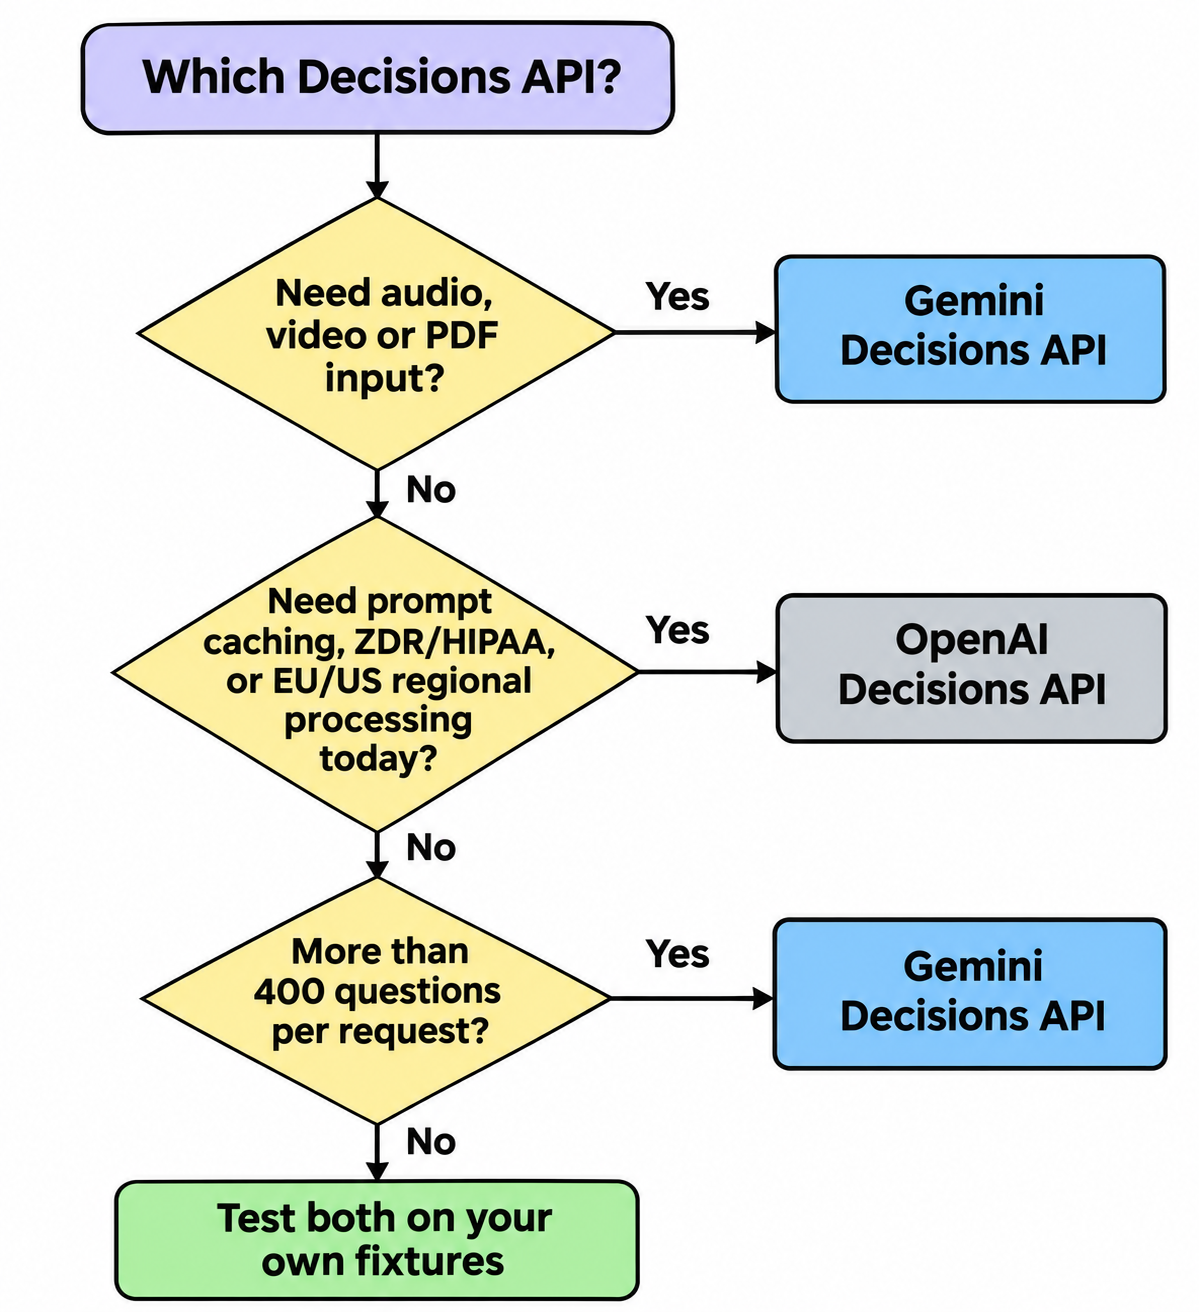
Wählen Sie die Gemini Decisions API, wenn:
- Ihre Evidenz Audio, Video oder PDF ist, ohne Transkriptions- oder OCR-Schritt.
- Sie mehr als 400 Fragen pro Anfrage benötigen.
- Sie für $0 in Google AI Studio prototypisieren wollen.
Wählen Sie die OpenAI Decisions API, wenn:
- Sie heute einen GA-Endpunkt benötigen. Geminis ist
v1beta, und Vertex-AI-Unterstützung „kommt bald". - Sie eine große gemeinsame Eingabe wiederverwenden und per Caching die Rechnung drücken wollen.
- Ihre Evidenz aus Agent-Verlauf mit Tool-Calls oder rohem JSON besteht.
- Sie ZDR, HIPAA-Berechtigung oder regionale Verarbeitung in den USA und der EU benötigen.
- Sie bereits GPT-6 Luna oder GPT-Live einsetzen; OpenAI dokumentiert einen nativen GPT-Live-Trigger für Decisions.
Wenn none davon die Entscheidung bringt: Testen Sie beide.
Lassen Sie Ihren Coding-Agent den A/B-Test mit Apidog CLI ausführen
Anbieter-Benchmarks zeigen nicht, wie eines der Modelle mit Ihren Tickets umgeht. Ein fixture-basierter A/B-Test schon – und Ihr Coding-Agent kann ihn mit Apidog CLI erstellen und ausführen.
Einmalige Einrichtung:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick Claude Code, Codex, Cursor or OpenCode
Dann geben Sie Ihrem Agenten einen einzigen Prompt:
In Apidog project <id>, create two endpoints: Gemini Decisions
(take the REST path from Google's Decisions API docs, model
gemini-decision-1) and OpenAI Decisions (POST /v1/decisions,
model gpt-6-luna). Both ask the same "department" choice question
(billing, technical, shipping, other) about {{ticket}}.
Build a test scenario that calls both for each row of fixtures.csv,
asserts HTTP 200, saves each answer, confidence and response time,
and flags rows where the two answers disagree. Run it and summarize.
Der Agent validiert seine Payloads, schreibt die Ressourcen und führt das Szenario einmal pro Fixture-Zeile aus:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file gemini-decisions.json
apidog endpoint create --project <id> --file gemini-decisions.json
apidog endpoint create --project <id> --file openai-decisions.json
apidog cli-schema get test-scenario-create
apidog test-scenario create --project <id> --file decisions-ab.json
apidog run -t <scenarioId> --project <id> -e <envId> -d fixtures.csv -r cli,json
Das Flag -d liefert eine CSV-Zeile pro Iteration, sodass 200 gelabelte Tickets zu 200 gepaarten Aufrufen werden, und der JSON-Bericht stellt Antworten, Confidence und Timing gegenüber. Vergleichen Sie sie mit Ihren Labels, und Sie haben Genauigkeit und Latenz auf Ihren eigenen Daten. Bewahren Sie beide API-Keys in der Apidog-Umgebung auf, nicht im Prompt. Siehe die Referenz zum Befehl apidog run und Apidog CLI in Claude Code.
Apidogs kostenloser Plan deckt bis zu 4 Nutzer ab.
FAQ
Ist die Gemini Decisions API günstiger als die OpenAI Decisions API? Beim Listenpreis nicht: Beide verlangen $0,10 pro 1M Eingabe-Tokens. OpenAI wird günstiger bei großer wiederverwendeter Eingabe ($0,01 pro 1M gecacht). Gemini ist zum Prototypisieren günstiger dank des kostenlosen Kontingents.
Kann die OpenAI Decisions API Audio oder PDFs lesen? Nein. Sie akzeptiert Text, Bilder und JSON. Gemini bietet zusätzlich Audio, Video und PDFs.
Ist die Gemini Decisions API produktionsreif? Sie erscheint als v1beta; Google-Cloud-Unterstützung „kommt bald". OpenAIs Endpunkt ist seit dem 22. Oktober 2026 GA.
Wie viele Fragen kann ich pro Anfrage stellen? Gemini erlaubt 1 bis 1.000, begrenzt durch sein 262.144-Token-Kontextfenster. OpenAI erlaubt 1 bis 400.
Kann ich zwischen ihnen wechseln, ohne Code umzuschreiben? Nicht direkt: Frage-Maps vs. Arrays, noul vs. predicate, unterschiedliche Formate für Auswahlmöglichkeiten. Schalten Sie einen dünnen Adapter davor und testen Sie beide an denselben Fixtures.