Gemini 4 Neon vs. GPT-6.2 Astra vs. Claude Fable 5.2, in einer Zeile: Fable 5.2 erzielt die höchste Punktzahl, Neon kostet am wenigsten pro Token, und Astra erledigt eine unabhängige Benchmark-Aufgabe für das geringste Geld. Neon ist mit 3 $ / 15 $ pro 1 Mio. Input-/Output-Token gelistet, während Astra und Fable beide mit 8 $ / 40 $ gelistet sind. Alle drei bieten rund 1 Mio. Token Kontext.
Drei Frontier-Modelle sind in zehn Tagen erschienen: Claude Fable 5.2 am 9. November 2026, GPT-6.2 Astra am 17. November und Gemini 4 Neon am 18. November. Unten finden Sie Preis, Spezifikationen, unabhängige Bewertungen, Kosten pro Aufgabe und einen Weg, alle drei mit der Apidog CLI zu testen.
Gemini 4 Neon vs. GPT-6.2 Astra vs. Claude Fable 5.2: das Kurzurteil
Entscheiden Sie nach Workload, nicht nach Leaderboard-Rang:
- Gemini 4 Neon für komplexes Coding und Analysen, die Sie den ganzen Tag laufen lassen. Es ist 62,5 % günstiger pro Token als die beiden anderen und belegt Platz zwei im Vals Index.
- GPT-6.2 Astra, wenn Ihr Stack auf der OpenAI Responses API läuft. Es schreibt pro Aufgabe deutlich weniger Token, was es trotz seines Preises von 8 $ / 40 $ zum günstigsten der drei pro Artificial-Analysis-Aufgabe macht.
- Claude Fable 5.2 für die härtesten langfristigen Arbeiten, bei denen ein fehlgeschlagener Lauf mehr kostet als die Token. Es führt beide unabhängigen Indizes an – bei den höchsten Kosten pro Aufgabe.
Falls Sie vom Vorgänger im Oktober kommen: Unser Vergleich Gemini 4 Argon vs. GPT-6 Astra vs. Claude Opus 5.5 behandelt die vorherige Generation.
Wie schneiden die drei Modelle bei Preis und Spezifikationen ab?
Beim Preis fällt Neon aus dem Rahmen. Die Zahlen stammen aus Googles Gemini 4 Neon Launch-Post und der Preisseite, der GPT-6.2 Astra Modellseite und Anthropics Claude Fable 5.2 Übersicht.
| Spezifikation | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| API-Modell-ID | gemini-4-neon |
gpt-6.2-astra |
claude-fable-5-2 |
| Veröffentlicht | 18. Nov. 2026 | 17. Nov. 2026 | 9. Nov. 2026 |
| Input / Output pro 1 Mio. | 3 $ / 15 $ | 8 $ / 40 $ | 8 $ / 40 $ |
| Gecachter Input pro 1 Mio. | 0,15 $ (nur implizit) | 0,40 $ | 0,20 $ |
| Kontextfenster | 1.048.576 (mit Output geteilt) | 1.050.000 (max. 922.000 Input) | 1 Mio. |
| Max. Output pro Anfrage | 65.536 | 128.000 | 128K |
| Lange Prompts | Pauschalpreis über 1 Mio. | Über 272K Input: Input 2x, Output 1,5x | Pauschalpreis über 1 Mio. |
| Batch-Rabatt | 50 % (Batch und Flex) | 50 % | 50 % |
| Reasoning-Steuerung | thinking_level: low bis xhigh, Standard high |
reasoning.effort, none wird abgelehnt |
effort, Standard high |
| Kostenlose API-Stufe | Nein | Nein | Nein |
Zwei Details verändern echte Rechnungen. Neons Caching ist implizit: Den Preis von 0,15 $ erhalten Sie nur, wenn Google ein wiederholtes Prompt-Präfix erkennt. Und Neon liefert höchstens 65.536 Token pro Anfrage zurück, sodass sehr lange Ausgaben Googles Long Decode oder eine Fortsetzungsschleife benötigen.
Die vollständigen Preistabellen finden Sie in unseren Analysen zu Gemini 4 Neon Pricing, GPT-6.2 Astra Pricing und Claude Fable 5.2 Pricing.
Welches Modell gewinnt bei unabhängigen Benchmarks?
Benchmark-Tabellen der Anbieter enthalten selten dieselben Tests. Zwei unabhängige Leaderboards bewerten alle drei auf einer einzigen Suite – und sie sind sich beim zweiten Platz uneinig.
| Metrik | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| Artificial Analysis Intelligence Index | 61 (xhigh) | 62 (max) | 65 (max) |
| Vals Index | 70,87 %, #2 | 67,66 %, #8 | 71,31 %, #1 |
| AA-Kosten pro Index-Aufgabe | 6,44 $ | 4,00 $ | 26,54 $ |
| AA-Zeit pro Index-Aufgabe | 21,5 Min. | 13,9 Min. | 41,8 Min. |
| AA-Output-Geschwindigkeit | 110 Tok/s | 49 Tok/s | 109 Tok/s |
| Output-Token über den AA-Index | 283 Mio. | 65,8 Mio. | 275 Mio. |
Quellen: die Artificial Analysis-Modellseiten der einzelnen Modelle, geprüft am 19. November 2026, und der Vals Index mit Stand vom 18. November 2026.
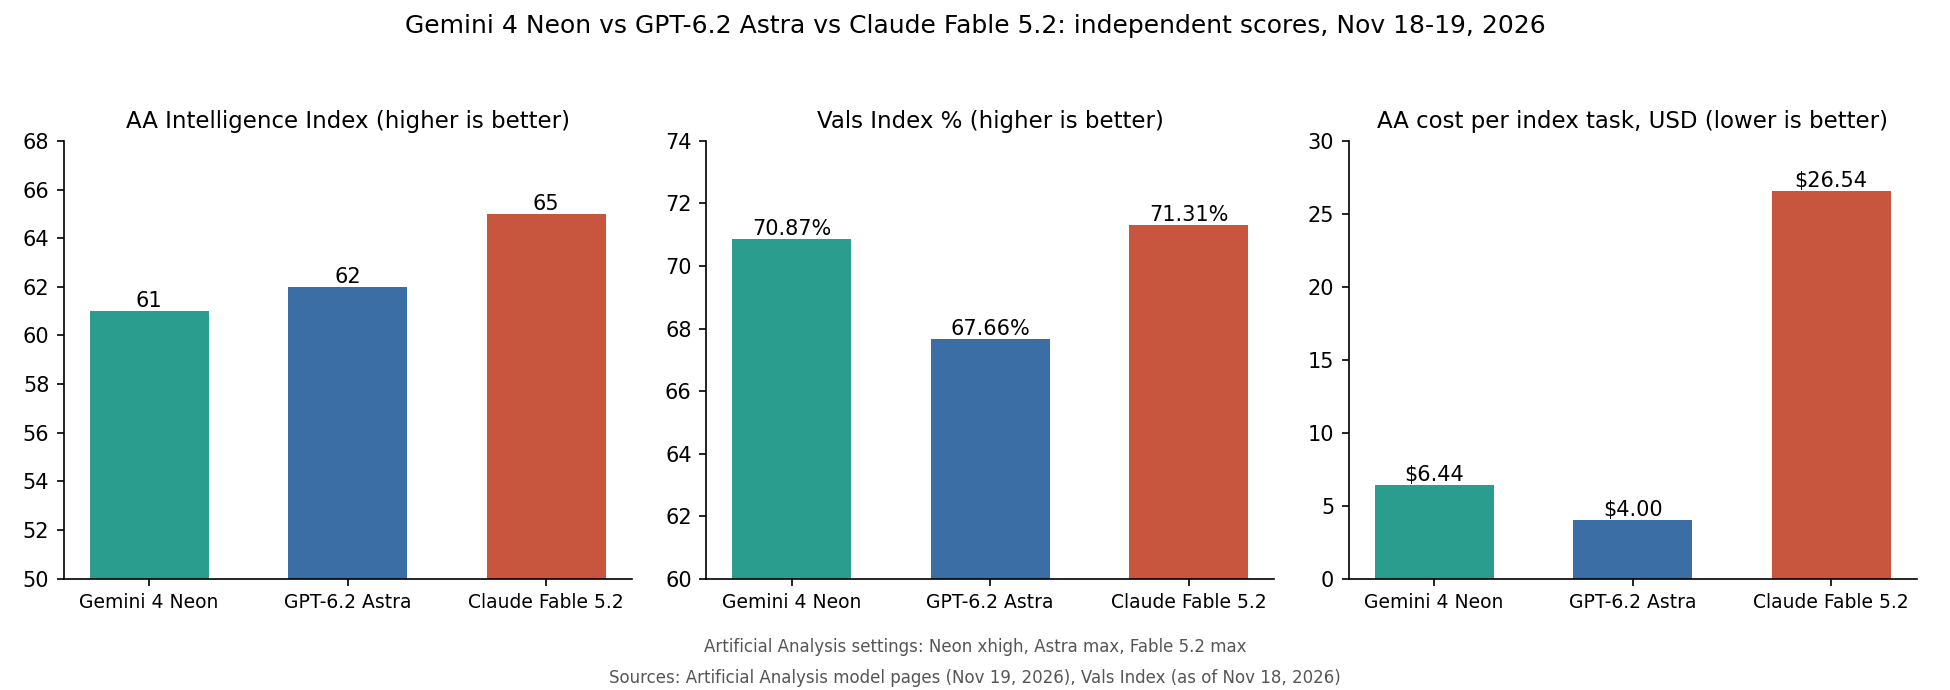
Fable 5.2 führt beide Ranglisten an, und im Vals Index liegt Neon nur 0,44 Punkte dahinter. Artificial Analysis setzt Astra einen Punkt vor Neon; Vals setzt Neon mehr als 3 Punkte vor Astra.
Googles Launch-Post platzierte Neon auf Platz 3 bei Artificial Analysis; am 19. November listet dieselbe Seite es auf Platz 6 von 96. Ränge vom Launch-Tag ändern sich schnell, und eine Lücke von einem Punkt ist Rauschen. Die Kosten- und Geschwindigkeitszeilen verraten Ihnen mehr darüber, wie sich die einzelnen Modelle in Ihrem Agenten anfühlen werden.
Warum kosten die teuersten pro Token am wenigsten pro Aufgabe?
Der Preis pro Token macht die Hälfte der Rechnung aus; die andere Hälfte ist, wie viele Token ein Modell schreibt, bevor es antwortet. In der Artificial-Analysis-Suite generierte Astra 65,8 Mio. Output-Token. Neon generierte 283 Mio. und Fable 275 Mio. – mehr als viermal so viele. Astras Output-Preis von 40 $ auf einen viel kleineren Haufen angewendet, ergab Kosten pro Aufgabe von 4,00 $, unter Neons 6,44 $, obwohl Neons Output-Preis 62,5 % niedriger ist.
Die Einstellungen spielen eine Rolle. Artificial Analysis führte Neon mit xhigh aus; mit high erzielt es 60 Punkte bei 123 Mio. Output-Token statt 283 Mio. – ein Punkt für weniger als die Hälfte der Token. Unser Gemini 4 Neon Thinking-Levels-Leitfaden zeigt die vollständige Kurve.
Fables 26,54 $ ergeben sich aus einem hohen Output-Preis in Kombination mit hoher Ausführlichkeit: der Preis für die Spitzenpunktzahl.
Was kostet ein echter Agent-Workload pro Modell?
Zwei Workloads zu Listenpreisen unter der Annahme identischer Token-Zahlen bei jedem Modell (das werden sie nicht sein – lesen Sie das also als Preisvergleich, nicht als Prognose).
| Workload | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| Agent-Sitzung: 150K frischer Input, 1,35M Cache-Reads, 150K Output | 0,45 $ + 0,20 $ + 2,25 $ = 2,90 $ | 1,50 $ + 0,54 $ + 6,00 $ = 8,04 $ | 1,50 $ + 0,27 $ + 6,00 $ = 7,77 $ |
| Eine lange Anfrage: 400K Input, 8K Output, kein Cache | 1,20 $ + 0,12 $ = 1,32 $ | 6,40 $ + 0,48 $ = 6,88 $ | 3,20 $ + 0,32 $ = 3,52 $ |
Astra und Fable berechnen die ersten 150K als Cache-Write zu 10 $ pro 1 Mio.; Neon hat keine Write-Gebühr. Die lange Anfrage zeigt Astras 272K-Regel: Jenseits dieser Grenze berechnet OpenAI für die gesamte Anfrage 16 $ Input und 60 $ Output pro 1 Mio.
Wenn Neon bei Ihren Prompts dreimal so viele Token schreibt wie Astra, kann seine 2,90-$-Sitzung mehr kosten als die von Astra. Messen Sie die Output-Token, bevor Sie nach dem Preis entscheiden.
Welche API-Unterschiede bringen Ihren Agent-Harness zum Scheitern?
Jede API weist Einstellungen zurück, die die anderen akzeptieren:
- Gemini 4 Neon: Der alte Parameter
thinking_budgetliefert HTTP 400, ebensofrequency_penaltyundpresence_penalty. Benutzerdefinierte Werte fürtemperature,top_kundtop_pwerden ignoriert, so der Cloud-Developer-Guide von Google. - GPT-6.2 Astra:
reasoning.effortaufnonegesetzt liefert einen 400, und die Modellseite listet Realtime, Assistants und Fine-Tuning als nicht unterstützt. - Claude Fable 5.2: Erzwungene Tool-Nutzung (
tool_choiceaufanyodertool) und Sampling-Parameter wietemperatureliefern einen 400, und Thinking lässt sich nicht abschalten.
Unser GPT-6.2 Astra vs. Claude Fable 5.2 Leitfaden behandelt die Eigenheiten von Astra und Fable im Detail, und der Gemini 4 Neon API-Leitfaden behandelt Neons Anfrageformat.
Wo passt welches Modell am besten?
Gemini 4 Neon ist für häufige, komplexe Arbeit gebaut. Google zufolge reduziert es redundante Dateizugriffe und kann planen, während günstigere Gemini 4 Hydrogen Subagenten die Schritte ausführen; in Google Antigravity führt /swarm Agenten parallel aus.
GPT-6.2 Astra bringt den OpenAI-Werkzeugkasten mit: apply_patch, gehostete Shell, Computer Use, MCP und eine Multi-Agent-Beta in der Responses API. Es ist das schnellste der drei bei Artificial Analysis, mit 13,9 Minuten pro Aufgabe. Simon Willison merkte am Launch-Tag an, dass es in mehreren Benchmarks etwas unter Fable 5.2 liegt.
Claude Fable 5.2 ist die Wahl, wenn Qualität die Kosten aufwiegt: lange Agent-Sitzungen, harte Refactorings, Rechercheaufgaben. Seine Cache-Reads zu 0,20 $ und die pauschale 1-Mio.-Preisgestaltung mildern den Output-Preis von 40 $.
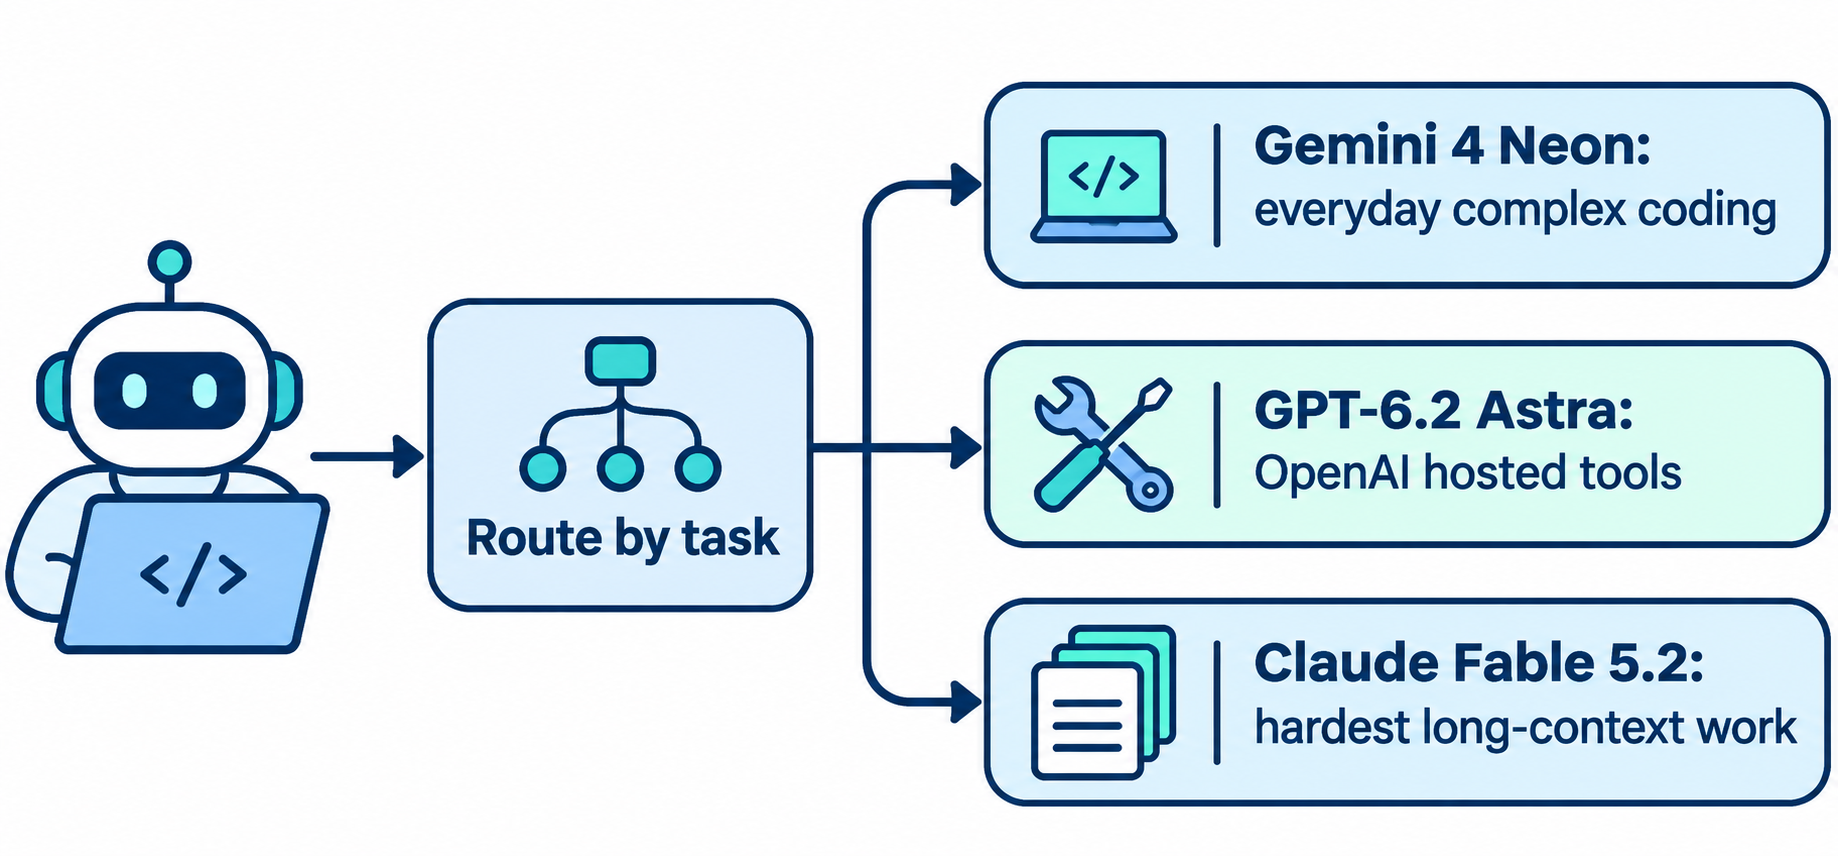
Sie müssen sich nicht für eines entscheiden. Schicken Sie den Großteil der Agent-Schritte an Neon und die wenigen Aufgaben, die dort scheitern, an Fable oder Astra; Ihre durchschnittlichen Kosten bleiben nahe bei denen von Neon.
Wie testen Sie alle drei Modelle mit Ihrem eigenen Workload?
Leaderboards messen die Aufgaben von jemand anderem. Schicken Sie 5 bis 10 echte Prompts aus dem Verlauf Ihres Agenten an alle drei APIs und vergleichen Sie Bestehensrate, Token und Latenz. Diese Anfragen von Hand auszuführen, wird schnell mühsam – lassen Sie also Claude Code, Codex oder Cursor die Apidog CLI steuern. Die Einrichtung erfordert drei Befehle:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Dann geben Sie Ihrem Agenten einen Prompt:
In Apidog project <PROJECT_ID>, create three test cases that send the
same code-review prompt to gemini-4-neon (Gemini Interactions API,
thinking_level high), gpt-6.2-astra (OpenAI Responses API, effort high)
and claude-fable-5-2 (Claude Messages API, no temperature field).
Keep each API key in a private environment variable. Assert a 200
status and a non-empty answer, record token usage and response time,
run each case 5 times and summarize cost per run at list prices.
Validate every payload against its schema before you write it.
Der Agent prüft jedes Payload-Schema, schreibt die Testfälle und führt sie aus. Diese Flags stammen aus apidog run --help in CLI 2.2.12:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file neon-case.json
apidog test-case create --project <PROJECT_ID> --file neon-case.json
apidog test-case create --project <PROJECT_ID> --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <NEON_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir abc-results
Wiederholen Sie den letzten Befehl mit den Case-IDs für Astra und Fable. -n 5 führt jeden Testfall fünfmal aus, und --upload-report zeigt die Läufe in der Apidog-App. Dies ist eine Workflow-Vorlage; wir haben sie von dieser Maschine aus nicht gegen alle drei APIs ausgeführt.
Fügen Sie Negativ-Testfälle für die oben genannten 400er hinzu, damit eine Änderung der Anbieter-Regeln zuerst in Ihrer Suite auftaucht. Der Apidog CLI in Claude Code Leitfaden behandelt die Agent-Einrichtung, und der Free-Plan von Apidog deckt bis zu 4 Nutzer ab.
FAQ
Ist Gemini 4 Neon besser als GPT-6.2 Astra? Das hängt vom Leaderboard ab: Neon führt im Vals Index (70,87 % vs. 67,66 %), Astra führt mit einem Punkt im Artificial Analysis Intelligence Index (62 vs. 61). Neon kostet 3 $ / 15 $ pro 1 Mio. Token gegenüber 8 $ / 40 $ bei Astra.
Welches der drei ist am günstigsten? Pro Token Gemini 4 Neon mit 3 $ Input und 15 $ Output pro 1 Mio. Pro Artificial-Analysis-Aufgabe GPT-6.2 Astra mit 4,00 $, weil es deutlich weniger Token schreibt als Neon (6,44 $) oder Fable 5.2 (26,54 $).
Welches Modell erzielt die höchste Punktzahl? Claude Fable 5.2 führt sowohl den Artificial Analysis Intelligence Index (65) als auch den Vals Index (71,31 %) mit Stand vom 18.–19. November 2026 an.
Hat eines davon eine kostenlose API-Stufe? Nein. Google listet keine kostenlose Stufe für Neon, und Astra und Fable 5.2 sind kostenpflichtige API-Modelle. Abonnenten von Google AI Pro und Ultra können Neon in der Gemini-App und in Antigravity nutzen. Die 0-$-Optionen finden Sie in unserem Gemini 4 Neon Free-Leitfaden.
Kann ich mehr als eines im selben Agenten verwenden? Ja. Leiten Sie Routine-Schritte an Neon und die Aufgaben, bei denen es scheitert, an Fable 5.2 oder Astra. Testen Sie jede Route zuerst: Die Token-Zahlen pro Aufgabe unterscheiden sich zwischen den Modellen um mehr als das Vierfache.