
Gemini 4 Neon vs. Carbon ist jetzt eine echte Entscheidung für jedes Team auf der Gemini API. Google hat Neon im November 2026 als mittleres Modell hinzugefügt, das zwischen Hydrogen und Carbon sitzt. Alle drei teilen sich ein Request-Schema, ein 1-Million-Token-Kontextfenster und dieselben integrierten Tools. Der Unterschied liegt darin, wie intensiv sie denken, wie schnell sie fertig werden und was jedes Token kostet.
Kurz gesagt: Verwenden Sie standardmäßig Gemini 4 Hydrogen ($1,50 Input / $7,50 Output pro 1M Token, kostenloser Tier verfügbar) für alltägliche Coding-Aufgaben und Agent-Worker. Wechseln Sie zu Gemini 4 Neon ($3 / $15, nur kostenpflichtiger Tier), wenn eine Aufgabe komplex ist und häufig ausgeführt wird – etwa Multi-File-Refactorings oder dichte Dokumentenanalyse. Reservieren Sie Gemini 4 Carbon ($2 / $10 bis zum 30. November 2026, danach $4 / $20) für Ihre schwierigsten Architektur-, Debugging- und Sicherheitsprobleme.
Gemini 4 Neon vs. Carbon vs. Hydrogen auf einen Blick
Gemini 4 Neon ist Googles mittleres Gemini-4-Modell, entwickelt für komplexe Softwareentwicklung, Wissensarbeit und wissenschaftliche Aufgaben, die häufig ausgeführt werden. Es argumentiert tiefer als Hydrogen, wird schneller fertig und benötigt weniger Output-Tokens als Carbon, und kostet $3 pro 1M Input-Tokens und $15 pro 1M Output-Tokens – nur im kostenpflichtigen Tier.
Hier der direkte Vergleich, basierend auf Googles Choosing a model guide und der Gemini API pricing page (beide am 19. November 2026 geprüft):
| Gemini 4 Hydrogen | Gemini 4 Neon | Gemini 4 Carbon | |
|---|---|---|---|
| Modell-ID | gemini-4-hydrogen |
gemini-4-neon |
gemini-4-carbon |
| Positionierung | Schneller Standard | Komplexe, häufige Aufgaben | Stärkstes Reasoning |
| Geschwindigkeit (Googles Bezeichnung) | Schnell | Moderat | Überlegt |
| Input / Output pro 1M | $1,50 / $7,50 | $3,00 / $15,00 | $2,00 / $10,00 bis 30. Nov., danach $4,00 / $20,00 |
| Gecachter Input pro 1M | $0,075 | $0,15 | $0,10, danach $0,20 |
| Thinking-Levels | low, medium, high (Standard), xhigh | low, medium, high (Standard), xhigh | low, medium (Standard), high |
| Kostenloser API-Tier | Ja | Nein | Nein |
| Kontextfenster | 1.048.576 Tokens, vereinheitlicht | 1.048.576 Tokens, vereinheitlicht | 1.048.576 Tokens, vereinheitlicht |
Alle drei akzeptieren Text-, Bild-, Video-, Audio- und PDF-Input und unterstützen Function Calling, strukturierte Outputs, Code-Ausführung, Computer Use und Google Search Grounding. Jedes hat eine synchrone Output-Obergrenze von 65.536 Tokens und kann mit long decode darüber hinaus bis zu 1M Tokens erreichen.
Welches Gemini-4-Modell sollten Sie verwenden?
Googles eigene Empfehlung ist kurz und eignet sich gut als Ausgangspunkt:
- Starten Sie mit Hydrogen für die meisten neuen Projekte: alltägliche Coding-Aufgaben, interaktive Apps, toolnutzende Agenten und multimodale Dokumenten-Pipelines. Google gibt an, dass es erfundene Aussagen im Vergleich zu Gemini 3.8 Flash um mehr als das Fünffache reduziert.
- Wechseln Sie zu Neon, wenn Hydrogen nicht ausreicht und Sie Carbons zusätzliche Verifizierung nicht benötigen: Repository-weites Debugging, Multi-File-Refactorings sowie Rechts-, Finanz- und Wissenschaftsanalysen, die mehrmals täglich laufen.
- Reservieren Sie Carbon für Systemarchitektur, Multi-File-Debugging, formale Beweise, Sicherheitsaudits oder jede Aufgabe, bei der ein schnelleres Modell nicht weiterkommt.
- Greifen Sie zu Gemini 3.5 Flash-Lite ($0,30 / $2,50) für Textarbeit mit hohem Volumen wie Übersetzung, Extraktion und Zusammenfassung.
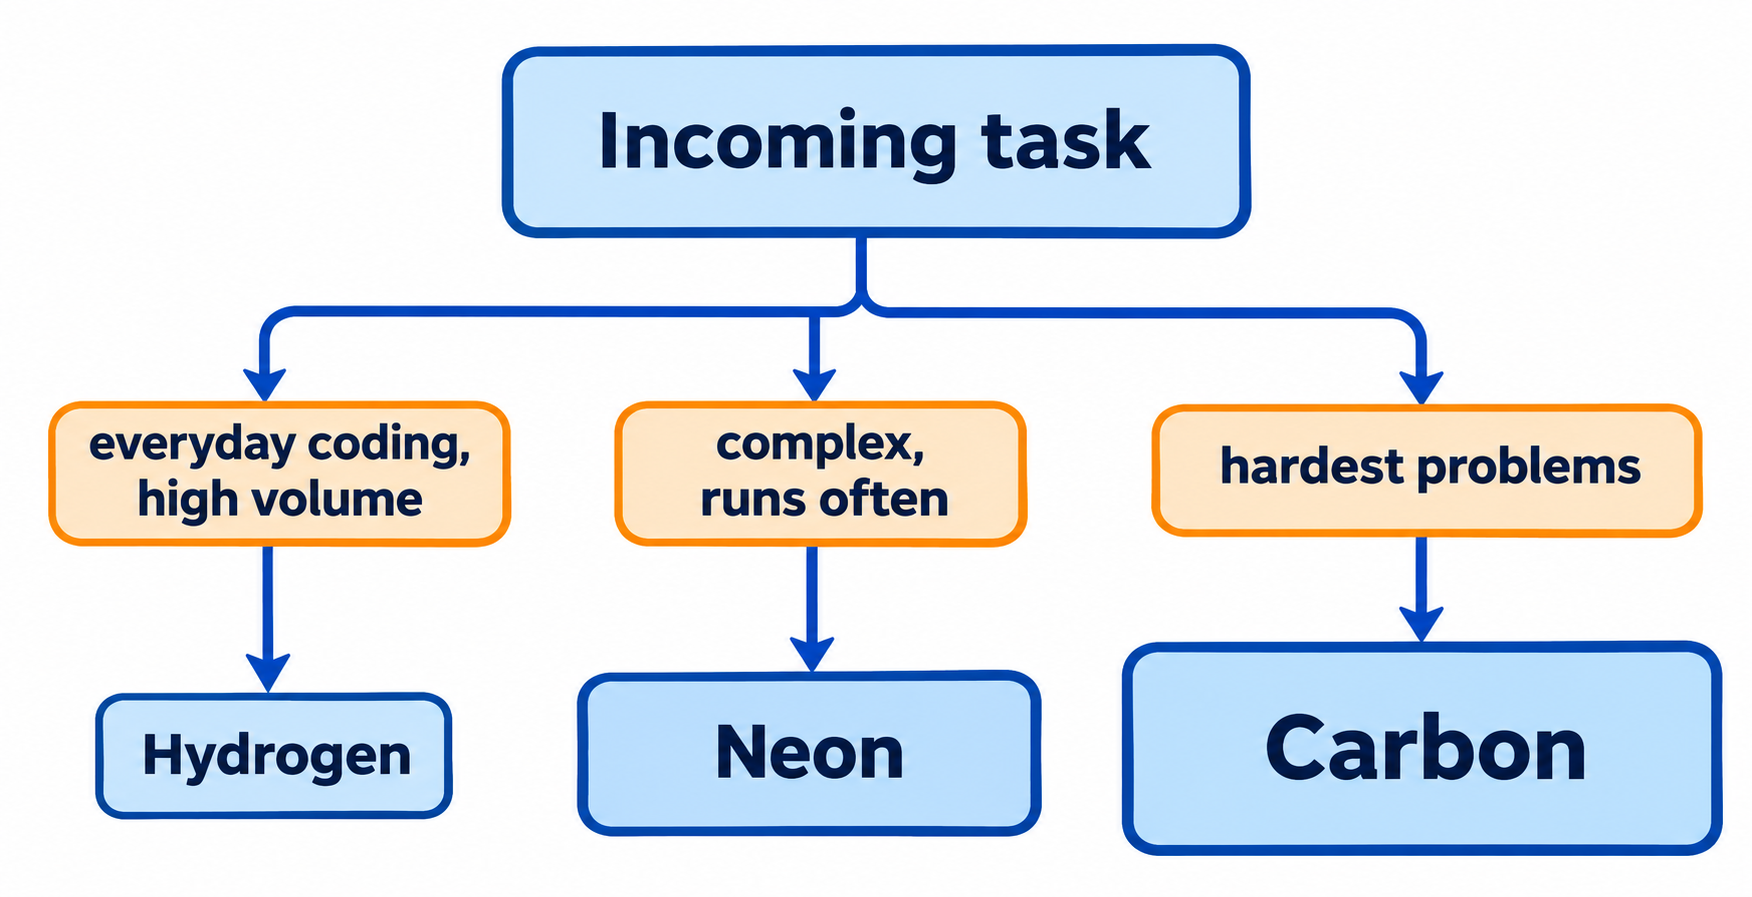
Das Schlüsselwort für Neon ist „häufig“. Ein vierteljährliches Sicherheitsaudit kann Carbons langsameres Reasoning verkraften. Ein Refactoring-Agent, der 200 Pull Requests pro Woche bearbeitet, braucht etwas, das schnell fertig wird und trotzdem die schwierigen Teile richtig hinbekommt.
Gemini 4 Neon vs. Carbon: Preis und Reasoning-Tiefe
Das ist der Vergleich, der den meisten Teams wichtig ist, denn Neon und Carbon zielen beide auf anspruchsvolle Arbeit ab.
Reasoning-Stil. Carbon verbraucht mehr Thinking-Tokens pro Durchgang, um Hypothesen zu prüfen, Grundursachen repository-übergreifend einzugrenzen und Fixes gegen Tests zu verifizieren. Neon zielt auf Frontier-Qualität mit schlankerem Tokenverbrauch. Laut Googles Seite What’s new in Gemini 4 Neon löst es repository-weites Debugging in weniger Schritten, reduziert redundante Datei-Lesevorgänge in langen Tool-Calling-Sitzungen und bewältigt Kontext-Komprimierung zuverlässig.
Unterschiedliche Standardeinstellungen. Carbon verwendet standardmäßig medium thinking und hat als Maximum high. Neon nutzt standardmäßig high und bietet zusätzlich xhigh für die schwierigsten mehrstufigen Probleme. Wenn Sie Carbon durch Neon ersetzen, ohne thinking_level zu setzen, ändern Sie auch, wie intensiv das Modell denkt.
Der Preis kippt am 1. Dezember. Bis zum 30. November 2026 ist Carbons Einführungspreis ($2 / $10) pro Token tatsächlich günstiger als Neon ($3 / $15). Ab dem 1. Dezember verdoppelt sich Carbon auf $4 / $20, und Neon wird pro Token 25 % günstiger. Neon hat keinen Einführungspreis, daher bleibt sein Satz unverändert.
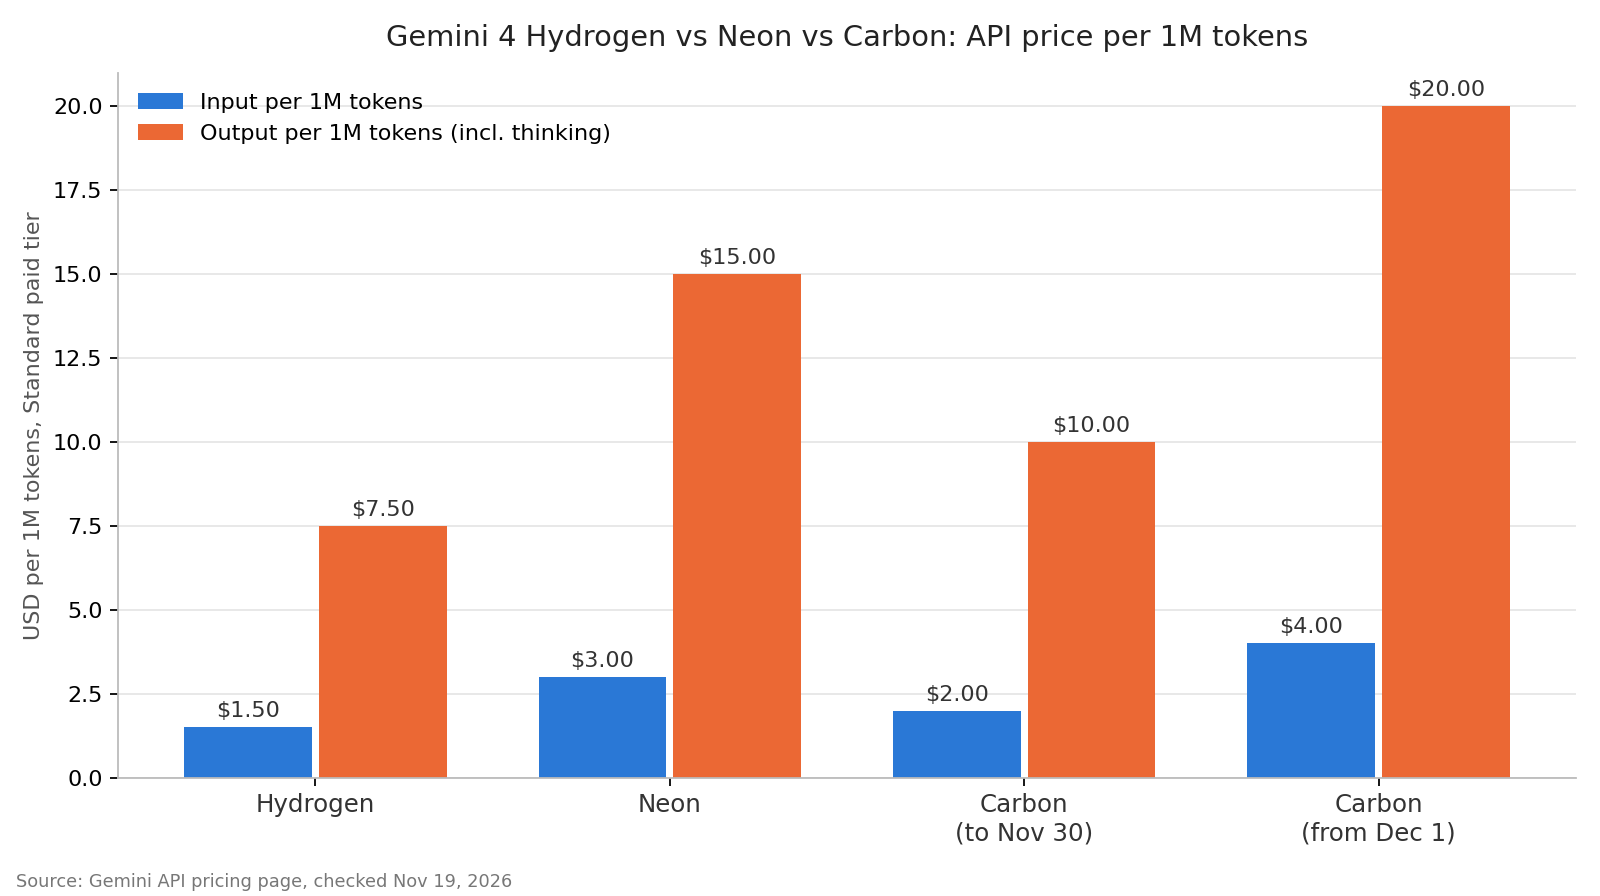
Der Preis pro Token ist aber nur die halbe Rechnung: Die Output-Preisgestaltung umfasst Thinking-Tokens, und Carbon ist darauf ausgelegt, mehr zu denken.
Gemini 4 Neon vs. Hydrogen: wann sich das Upgrade lohnt
Hydrogen und Neon sehen auf dem Papier ähnlich aus: dieselben Thinking-Levels, derselbe Standard, dasselbe Kontextfenster, dieselben Tools. Neon kostet genau doppelt so viel pro Token.
Das Upgrade lohnt sich, wenn Hydrogens Antwort einen erneuten Versuch erzwingt. Wenn Hydrogen drei Anläufe braucht, um ein Multi-File-Refactoring zu schaffen, das Neon in einem schafft, ist das günstigere Modell das teure.
Zwei praktische Unterschiede:
- Kostenloser Tier. Hydrogen hat einen kostenlosen API-Tier für Prototyping. Neon nicht – Sie benötigen ein Projekt im kostenpflichtigen Tier, bevor Sie den ersten Aufruf tätigen. In diesem kostenlosen Tier darf Google Ihre Daten zur Verbesserung seiner Produkte verwenden.
- Batch-Preise. Beide halbieren ihren Preis im Batch-Modus: Hydrogen sinkt auf $0,75 / $3,75 und Neon auf $1,50 / $7,50. Ein nächtlicher Neon-Batch-Job kostet pro Token genauso viel wie ein Echtzeit-Aufruf von Hydrogen.
Wenn Sie Hydrogen bereits als schnellen Worker unter Carbon als Planner einsetzen, sehen Sie sich unsere Analyse des Gemini-4-Hydrogen-Orchestrator-Musters an. Neon gibt diesem Setup eine dritte Spur für die Schritte mittlerer Schwierigkeit.
Kosten pro Aufgabe: ein durchgerechnetes Beispiel
Hier eine Agent-Aufgabe mit 40.000 Input-Tokens und 8.000 Output-Tokens (Thinking eingeschlossen), bewertet zu Standard-Preisen des kostenpflichtigen Tiers:
| Modell | Input-Kosten | Output-Kosten | Pro Aufgabe | Pro 1.000 Aufgaben |
|---|---|---|---|---|
| Hydrogen | $0,060 | $0,060 | $0,12 | $120 |
| Neon | $0,120 | $0,120 | $0,24 | $240 |
| Carbon (bis 30. Nov.) | $0,080 | $0,080 | $0,16 | $160 |
| Carbon (ab 1. Dez.) | $0,160 | $0,160 | $0,32 | $320 |
Diese Tabelle geht davon aus, dass jedes Modell die gleiche Anzahl an Tokens verbraucht – was sie nicht tun werden. Google gibt an, dass Carbon mehr Thinking-Tokens pro Durchgang verbraucht und dass Neon mit weniger Output-Tokens fertig wird als Carbon. Wenn Carbon für dieselbe Aufgabe 12.000 Output-Tokens benötigt, steigen seine Dezember-Kosten auf $0,40 pro Aufgabe, und der Abstand zu Neon wächst von $0,08 auf $0,16. Diese Token-Zahlen sind illustrativ; messen Sie Ihre eigenen, bevor Sie budgetieren.
Drei Hebel senken die Rechnung:
- Implizites Caching. Es läuft standardmäßig bei Prompts mit mindestens 4.096 Tokens und reduziert gecachten Input um 95 %. Setzen Sie stabile System-Prompts und Tool-Definitionen an den Anfang, damit sie den Cache treffen.
- Thinking-Level. Google empfiehlt, Ihre Evals auf allen vier Stufen auszuführen und die niedrigste zu wählen, die Ihre Qualitätsschwelle erfüllt.
xhighkostet die meisten Tokens und Latenz. - Batch-Modus. Nicht dringende Aufgaben gehören in den Batch-Modus zum halben Standardpreis.
Die vollständige Carbon-Preis-Timeline finden Sie in unserem Gemini-4-Carbon-Preis-Leitfaden.
Wechsel zwischen den dreien: was sich in Ihrem Code ändert
Der Wechsel zwischen Gemini-4-Modellen erfordert keine Änderungen am Request-Schema. Sie ändern den model-String und üblicherweise den thinking_level:
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Find the race condition in this retry queue and propose a fix.",
    "generation_config": { "thinking_level": "high" }
  }'
Wenn Sie eine Workload verschieben:
- Setzen Sie
thinking_levelexplizit. Carbons Standard istmedium; bei Neon und Hydrogen ist eshigh. Ein Wechsel ohne explizite Festlegung ändert Kosten und Latenz. - Verwenden Sie ein Projekt im kostenpflichtigen Tier für Neon und Carbon. Keys des kostenlosen Tiers erreichen nur Hydrogen und Flash-Lite.
- Lassen Sie Sampling-Parameter weg. Neons Migrations-Leitfaden sagt, dass
temperature,top_pundtop_kinnerhalb des gültigen Bereichs ignoriert werden und außerhalb einen400-Fehler zurückgeben. - Verketten Sie Modelle mit
previous_interaction_id. Da alle drei ein Schema teilen, können Sie mit Carbon planen, mit Hydrogen implementieren und die heiklen mittleren Schritte an Neon senden – alles in einer Konversation.
Lassen Sie Ihren Coding-Agenten sie mit Apidog CLI vergleichen
Der schnellste Weg, Neon vs. Carbon vs. Hydrogen zu klären, ist, denselben Prompt an alle drei zu senden und Status, Latenz und Tokenverbrauch zu vergleichen. Ihr Coding-Agent kann diesen Test mit Apidog CLI erstellen und ausführen, während Sie weiterarbeiten.
Installieren Sie die CLI und geben Sie Ihrem Agenten die Apidog-Skill:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Dann geben Sie Claude Code, Codex oder Cursor einen Prompt:
In Apidog project <id>, create a test scenario named "Gemini 4 model compare"
that POSTs to https://generativelanguage.googleapis.com/v1beta/interactions
with model {{model}}, thinking_level "high" and the prompt in {{prompt}}.
Assert status 200 and a non-empty output, and save the usage block to a variable.
Run it once each for gemini-4-hydrogen, gemini-4-neon and gemini-4-carbon,
then give me a table of latency and token usage per model.
Der Agent liest das Payload-Schema, validiert seine Datei, erstellt das Szenario und führt es dreimal aus – nur das Modell wird ausgetauscht:
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file scenario.json
apidog run -t <scenarioId> --project <id> -e <envId> --env-var "model=gemini-4-hydrogen" -r cli,json
apidog run -t <scenarioId> --project <id> -e <envId> --env-var "model=gemini-4-neon" -r cli,json
apidog run -t <scenarioId> --project <id> -e <envId> --env-var "model=gemini-4-carbon" -r cli,json
Bewahren Sie GEMINI_API_KEY in der Apidog-Umgebung auf. Fügen Sie --upload-report hinzu, um jeden Lauf in der App anzusehen, und setzen Sie denselben Befehl mit -r junit in CI ein, um Regressionen zu erkennen, wenn Google ein Modell aktualisiert. Unser Leitfaden zu Apidog CLI in Claude Code behandelt das Setup von Anfang bis Ende. Apidogs kostenloser Plan deckt Teams von bis zu 4 Nutzern ab.
FAQ
Ist Gemini 4 Neon besser als Gemini 4 Carbon? Nicht pauschal. Carbon ist Googles stärkstes Reasoning-Modell. Neon tauscht etwas Tiefe gegen schnellere Fertigstellung und weniger Output-Tokens, was zu komplexer Arbeit passt, die häufig ausgeführt wird.
Ist Gemini 4 Neon kostenlos? Nein. Neon gibt es nur im kostenpflichtigen Tier der Gemini API sowie in Google AI Studio mit den Google AI Pro- und Ultra-Plänen. Hydrogen ist das Gemini-4-Modell mit einem kostenlosen API-Tier.
Ist Neon günstiger als Carbon? Pro Token erst ab dem 1. Dezember 2026. Bis zum 30. November unterbietet Carbons Einführungspreis von $2 / $10 Neons $3 / $15. Danach kostet Carbon $4 / $20, und Neon ist pro Token 25 % günstiger – noch bevor Carbons intensiveres Denken eingerechnet wird.
Haben Gemini 4 Neon, Carbon und Hydrogen dasselbe Kontextfenster? Ja. Alle drei teilen sich ein vereinheitlichtes Fenster von 1.048.576 Tokens für Input, Thinking und Output, mit einer synchronen Output-Obergrenze von 65.536 Tokens und long decode bis zu 1M Tokens.
Kann ich Neon, Carbon und Hydrogen im selben Workflow verwenden? Ja. Sie teilen sich ein Request-Schema, sodass Sie previous_interaction_id vom Zug eines Modells an ein anderes übergeben können. Planen Sie mit Carbon, implementieren Sie mit Hydrogen und geben Sie Neon die Schritte dazwischen.
Welches Gemini-4-Modell ist das schnellste? Hydrogen. Google bezeichnet Hydrogen als schnell, Neon als moderat und Carbon als überlegt.