
Die Thinking-Level von Gemini 4 Neon bieten vier Einstellungen dafür, wie intensiv das Modell nachdenkt, bevor es antwortet: low, medium, high und xhigh. Bei Neon ist high der Standard. Google empfiehlt, für die meisten komplexen Aufgaben bei high zu bleiben und nur dann auf xhigh zu wechseln, wenn high bei schwierigen mehrstufigen Problemen nicht ausreicht, denn xhigh verbraucht mehr Tokens und dauert länger.
Was sind die Thinking-Level von Gemini 4 Neon?
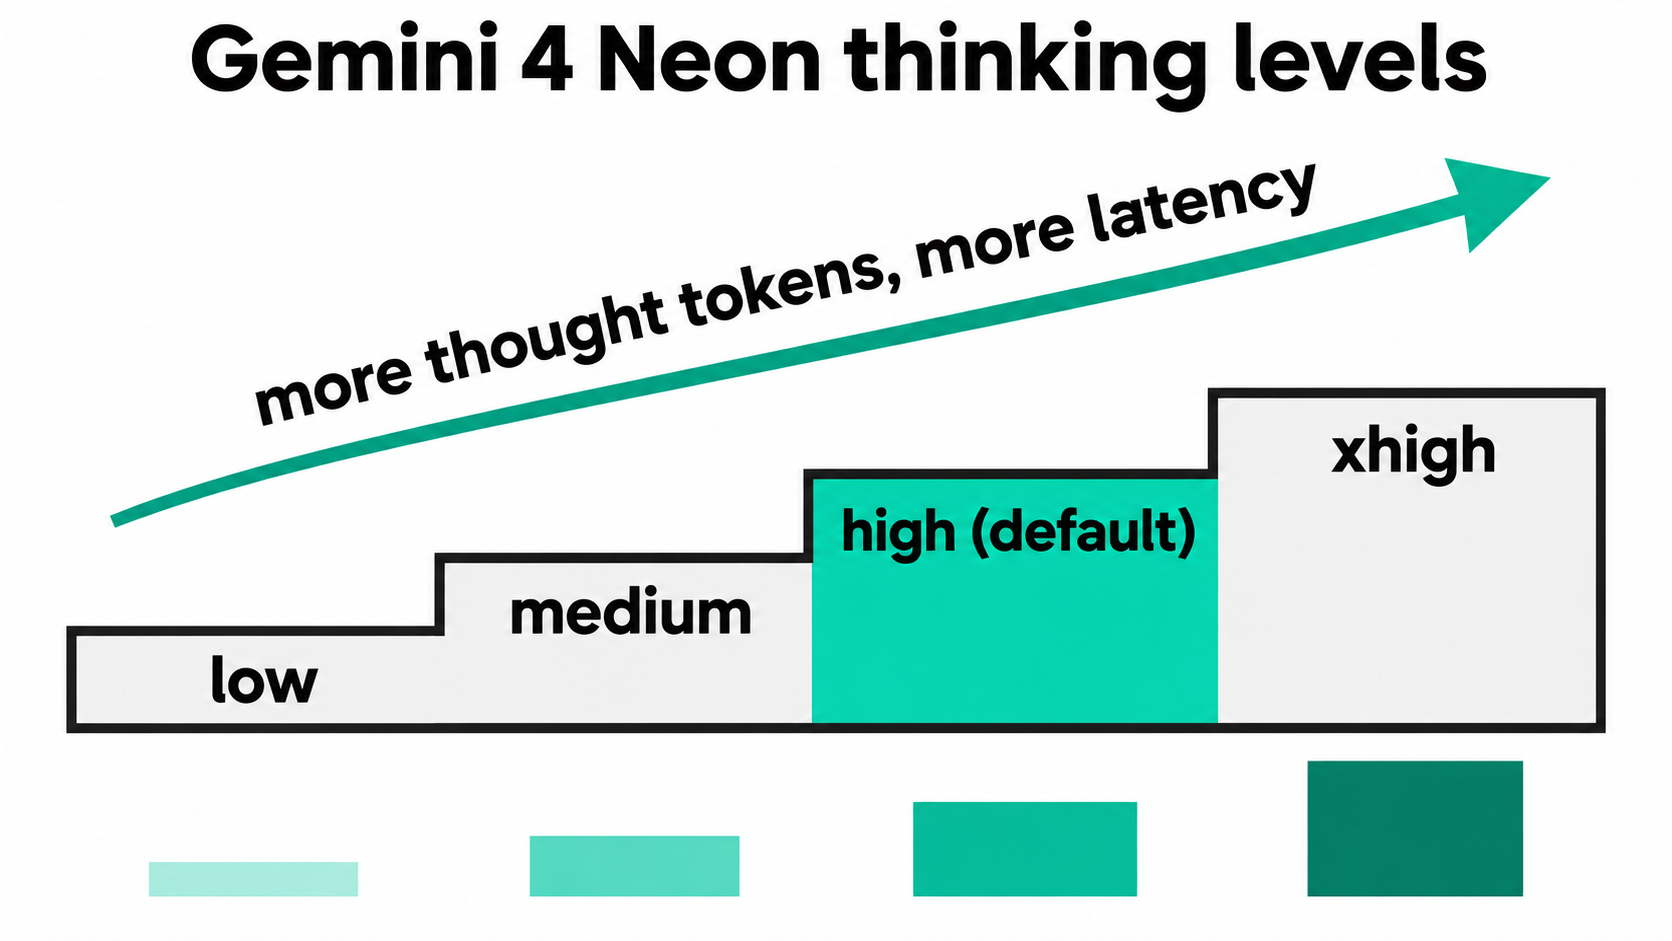
Thinking-Level sind Werte des Parameters thinking_level, die festlegen, wie viel interne Schlussfolgerungsarbeit gemini-4-neon leistet, bevor es eine Antwort verfasst. Neon unterstützt vier Stufen: low, medium, high (Standard) und xhigh. Höhere Stufen verbrauchen mehr Thought-Tokens und erhöhen die Latenz; niedrigere Stufen antworten schneller und kosten weniger.
So beschreibt Googles Thinking-Leitfaden die einzelnen Stufen für Neon:
thinking_level |
Token-Verbrauch | Googles empfohlener Einsatz |
|---|---|---|
low |
Wenigste Tokens, geringste Latenz | Schneller Chat, Verarbeitung mit hohem Durchsatz; weiterhin leistungsfähig bei agentischen Aufgaben |
medium |
Geringerer Token-Verbrauch, schnellere Antworten | Interaktives Coden, Live-UI-Prototyping, latenzempfindliche Tool-Aufrufe |
high (Standard) |
Ausgewogene Intelligenz und Geschwindigkeit | Komplexes Coden, agentische Ausführung, Tool-Aufrufe, multimodale Wissensarbeit |
xhigh |
Meiste Tokens, tiefstes Reasoning | Schwierige mehrstufige Engineering-Aufgaben, analytische und wissenschaftliche Probleme, bei denen high nicht ausreicht |
Zwei Werte, die man erwarten könnte, fehlen. Neon lehnt minimal mit einem Fehler ab, sodass Code, der aus einer Gemini-3-Flash-App kopiert wurde, bricht, wenn er diesen Wert sendet. Und die alte Token-Anzahl thinkingBudget ist bei Gemini 4 veraltet: Allein gesendet wird sie mit einer Warnung auf die nächstgelegene Stufe abgebildet; zusammen mit thinkingLevel gesendet, gibt sie einen 400 zurück.
Wie schlägt sich der Standard von Neon im Vergleich zu anderen Gemini-4-Modellen?
Neon startet eine Stufe höher als seine größeren Geschwister. Laut den Versionshinweisen zu Gemini 4 Neon sind bei Neon und Hydrogen high der Standard und xhigh unterstützt, während bei Carbon und Argon medium der Standard ist und bei high Schluss ist.
| Modell | Standardstufe | Unterstützte Stufen |
|---|---|---|
gemini-4-neon |
high |
low, medium, high, xhigh |
gemini-4-hydrogen |
high |
low, medium, high, xhigh |
gemini-4-carbon |
medium |
low, medium, high |
gemini-4-argon |
medium |
low, medium, high |
Das ist wichtig, wenn man das Modell wechselt. Verschiebt man eine Carbon-Workload zu Neon, ohne thinking_level zu setzen, springt jede Anfrage vom Reasoning-Stand medium auf high, was die Token-Anzahl verändert. Wenn man die größeren Modelle abwägt, behandelt unser Vergleich Gemini 4 Carbon vs. Argon diesen Unterschied.
Wie setzt man thinking_level in der Gemini API?
Neon läuft im kostenpflichtigen Tarif sowohl der Interactions API als auch von generateContent. Der Feldname unterscheidet sich zwischen beiden.
Interactions API: thinking_level gehört in generation_config.
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Audit this payment retry queue for race conditions.",
    "generation_config": {
      "thinking_level": "xhigh",
      "max_output_tokens": 65536
    }
  }'
generateContent: verwenden Sie thinkingLevel in generationConfig.thinkingConfig.
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-4-neon:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "contents": [{"parts": [{"text": "Audit this payment retry queue for race conditions."}]}],
    "generationConfig": {
      "thinkingConfig": {"thinkingLevel": "medium"}
    }
  }'
Im Python SDK nimmt der Interactions-Aufruf generation_config={"thinking_level": "high"}, und der generateContent-Aufruf nimmt thinking_config=types.ThinkingConfig(thinking_level="low"). Lassen Sie temperature, top_p und top_k weg: Laut Google ignoriert Neon Werte im gültigen Bereich und lehnt Werte außerhalb des Bereichs mit einem 400 ab. Für eine vollständige Ersteinführung zur ersten Anfrage beim gleichen API-Design siehe unseren Gemini-4-Hydrogen-API-Leitfaden.
Wann sollte man high und wann xhigh verwenden?
Verwenden Sie standardmäßig high und stufen Sie eine Aufgabe nur dann auf xhigh hoch, wenn high Ihre Qualitätsanforderung dafür nicht erfüllt. Googles Launch-Beitrag beschreibt xhigh als „tieferes, mehrstufiges Reasoning für die schwierigsten Engineering-, Analyse- und Scientific-Workloads“. (deeper, multi-step reasoning for the hardest engineering, analytical, and scientific workloads.)
Wählen Sie xhigh, wenn:
- Die Aufgabe viele voneinander abhängige Schritte hat und ein früher Fehler das Ergebnis ruiniert, etwa bei einem Refactoring über mehrere Dateien oder einem Concurrency-Audit.
higheine selbstsichere, aber falsche Antwort in Ihrem Evaluationsset gegeben hat – nicht nur eine langsamere.- Latenz kaum eine Rolle spielt, etwa bei Hintergrundjobs, nächtlichen Reviews oder Batch-Analysen.
- Eine falsche Antwort mehr kostet als Tokens, etwa bei Sicherheitspatches oder Finanzberechnungen.
Bleiben Sie bei high (oder gehen Sie tiefer), wenn:
- Der Prompt Extraktion oder Formatierung ist. Google warnt, dass
xhigh„zu Überdenken führen odermax_output_tokensbei einfacheren Prompts wie Text- oder JSON-Extraktion erschöpfen kann“. - Ein Nutzer wartet. Chat, Autocomplete und Live-Tool-Aufrufe passen zu
mediumoderlow. - Sie hohes Volumen fahren. Jedes zusätzliche Thought-Token wird berechnet, und der Unterschied multipliziert sich über Anfragen hinweg.
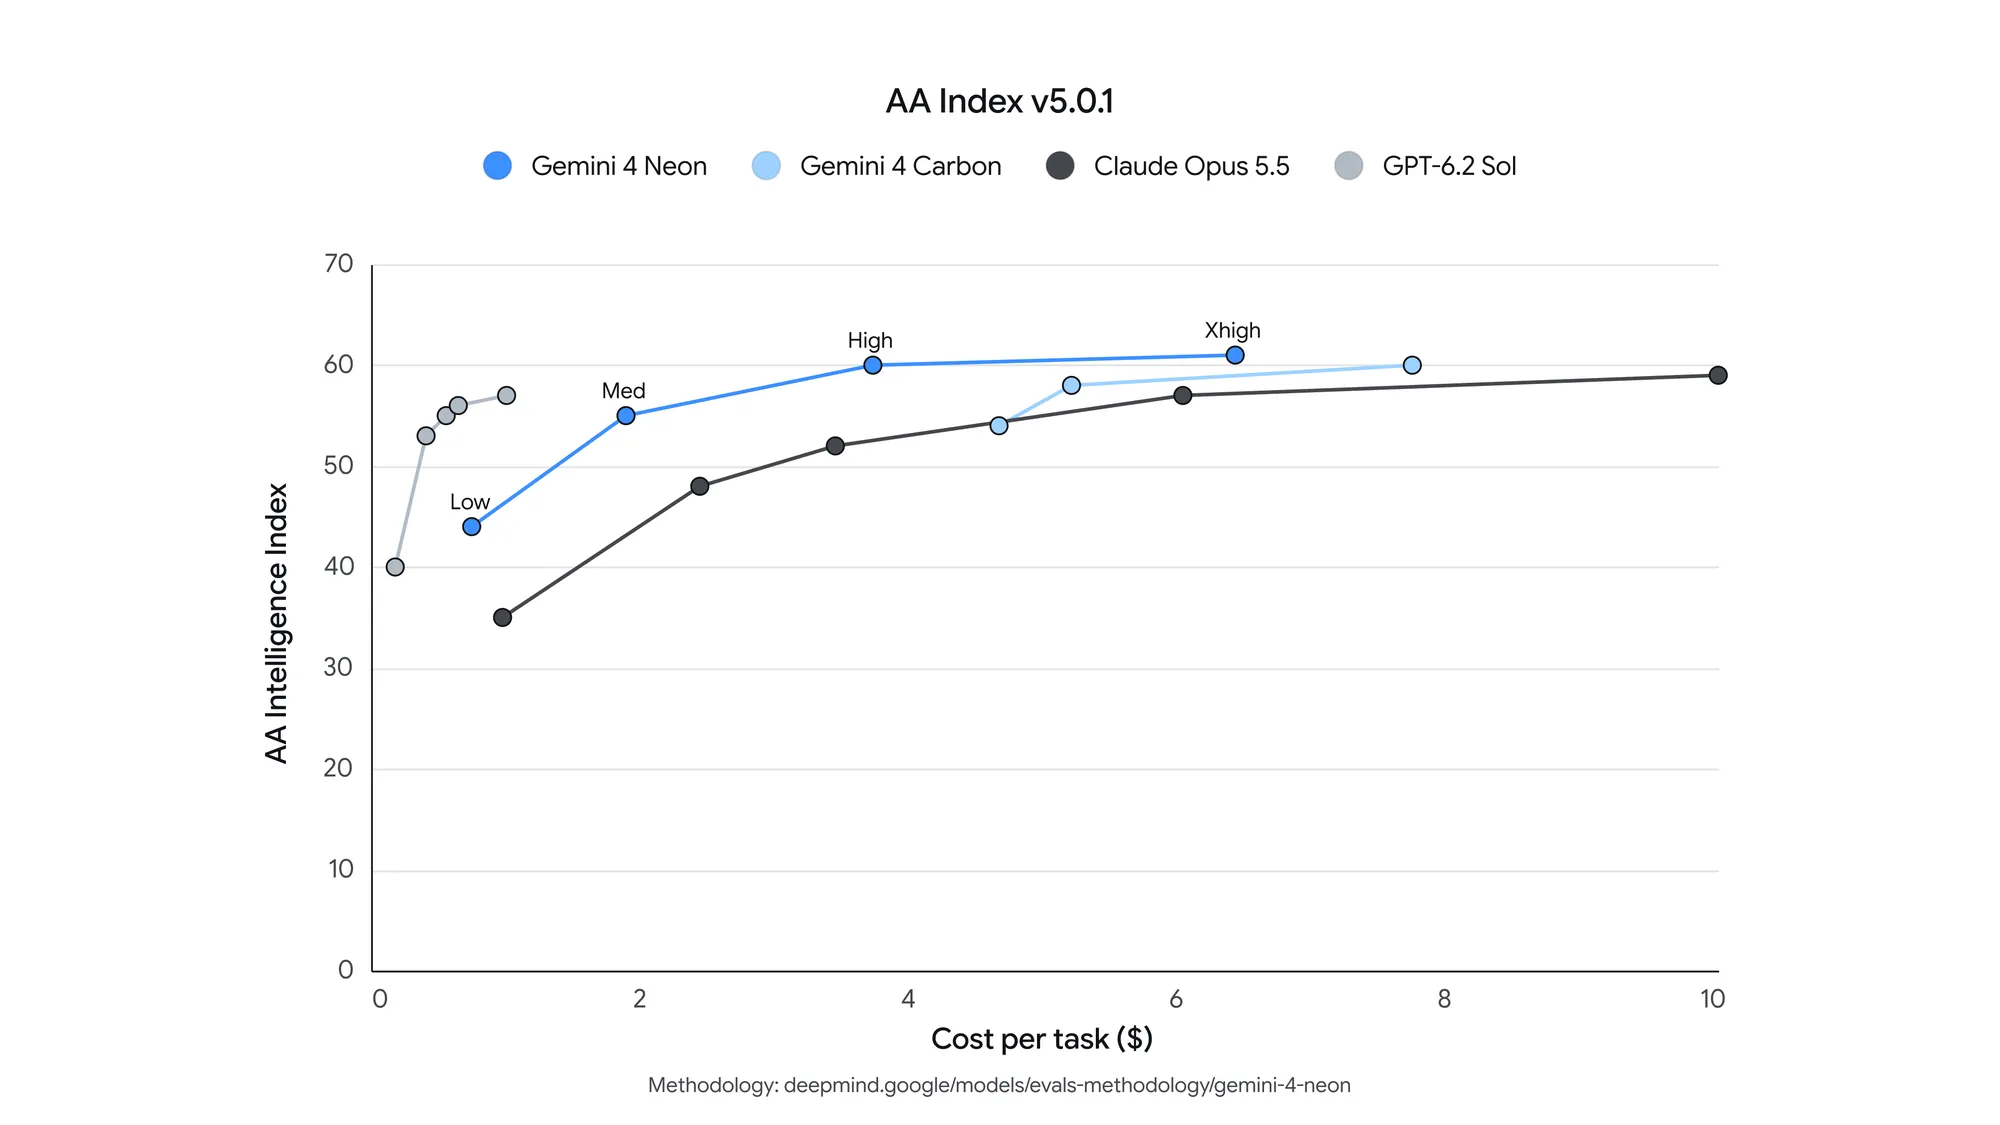
Googles Benchmark-Zahlen stützen diese Aufteilung. In der Launch-Ankündigung erzielt Neon bei xhigh 61 Punkte im Artificial Analysis Intelligence Index und liegt damit auf Platz drei. Beim Standard high meldet Google Kosten pro Aufgabe, die 32 % niedriger sind als bei Carbon. Das sind Googles Zahlen, nicht unsere Tests, aber sie zeigen den Kompromiss: xhigh erkauft Neons höchste Punktzahl, high erkauft Effizienz.
Wie viel kostet jede Thinking-Stufe?
Jede Stufe hat denselben Preis pro Token; was sich ändert, ist die Anzahl der Tokens, für die Sie bezahlen. Neon kostet 3,00 $ pro 1 Mio. Input-Tokens und 15,00 $ pro 1 Mio. Output-Tokens, und Googles Preisseite gibt an, dass der Output-Preis Thinking-Tokens einschließt. Gecachter Input sinkt durch implizites Caching auf 0,15 $ pro 1 Mio. (explizites Caching wird von Neon nicht unterstützt). Für dieses Modell gibt es keinen kostenlosen Tarif.
Die Kosten einer Stufe ergeben sich also aus den Thought-Tokens, die sie hinzufügt, multipliziert mit 15 $ pro Million. Hier ist die Rechnung für eine Anfrage mit 2.000 Input-Tokens und einer sichtbaren Antwort von 800 Tokens. Die Thought-Token-Zahlen sind hypothetisch gewählt, um die Rechnung zu zeigen, nicht gemessen:
| Thought-Tokens (hypothetisch) | Input-Kosten | Output- + Thinking-Kosten | Gesamt pro Anfrage | Pro 10.000 Anfragen |
|---|---|---|---|---|
| 500 | 0,006 $ | 0,0195 $ | 0,0255 $ | 255 $ |
| 2.000 | 0,006 $ | 0,042 $ | 0,048 $ | 480 $ |
| 8.000 | 0,006 $ | 0,132 $ | 0,138 $ | 1.380 $ |
Das Denken dominiert die Rechnung schnell. Bei 8.000 Thought-Tokens ist das Reasoning 87 % der Kosten einer Anfrage. Deshalb empfiehlt Google selbst, Ihre Evaluation auf allen vier Stufen durchzuführen und „die niedrigste thinking_level zu wählen, die Ihre Qualitätsanforderung erfüllt“. Unser Leitfaden zu den Thinking-Level von Gemini 3.8 Flash behandelt denselben Kompromiss bei einem günstigeren Modell, falls Sie vergleichen möchten.
Wie misst man Tokens und Latenz pro Stufe?
Führen Sie denselben Prompt auf jeder Stufe aus und lesen Sie den Usage-Block. In der Interactions API meldet das usage-Objekt der Antwort total_input_tokens, total_output_tokens und total_thought_tokens getrennt. In generateContent erscheinen Thought-Tokens als usageMetadata.thoughtsTokenCount.
Diese Schleife sendet einen Prompt auf allen vier Stufen und gibt Thought-Tokens sowie die reale Uhrzeit aus:
for level in low medium high xhigh; do
  start=$(date +%s)
  usage=$(curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
    -H "x-goog-api-key: $GEMINI_API_KEY" \
    -H 'Content-Type: application/json' \
    -d "{\"model\":\"gemini-4-neon\",
         \"input\":\"Find the race condition in this retry loop: ...\",
         \"generation_config\":{\"thinking_level\":\"$level\",\"max_output_tokens\":65536}}" \
    | jq -c '{status, thought: .usage.total_thought_tokens, out: .usage.total_output_tokens}')
  echo "$level $(( $(date +%s) - start ))s $usage"
done
Führen Sie sie mit 10 bis 20 Prompts aus Ihrem echten Workload aus. Ein einzelner Prompt sagt wenig aus; ein Set zeigt, wo high und xhigh bei der Qualität auseinanderzugehen beginnen.
Setzen Sie beim Testen das Timeout Ihres HTTP-Clients hoch. Googles Migrationshinweise besagen, dass schwierige Prompts mehrere Minuten dauern können, und empfehlen ein Timeout von mindestens 15 Minuten oder eine Hintergrundausführung.
Warum liefert xhigh manchmal eine leere Antwort?
max_output_tokens begrenzt Thinking und sichtbaren Output gemeinsam. Wenn Neon das gesamte Budget fürs Reasoning ausgibt, endet die Interaktion mit Status incomplete und liefert eine abgeschnittene oder leere Antwort zurück – und Sie zahlen trotzdem für die generierten Thought-Tokens.
Drei Regeln aus Googles Dokumentation vermeiden das:
- Alte niedrige Limits entfernen. Wenn Ihre App etwas wie 8.192 fest eincodiert, erhöhen Sie es auf 65.536, das Standardlimit für synchrone Aufrufe.
- Die Stufe senken, nicht das Limit. Um Kosten oder Latenz zu reduzieren, wechseln Sie zu
mediumoderlow, stattmax_output_tokenszu verkleinern. - Für lange Arbeit in den Hintergrund wechseln. Für Antworten über 65.536 Tokens setzen Sie
backgroundauftrueundmax_output_tokensauf bis zu 1.048.576 minus Ihren Input. Input, Thinking und Output teilen sich ein Fenster von 1 Mio. Tokens. Unser Leitfaden zu langen Outputs bei Gemini 4 Argon führt durch das Polling-Muster.
Lassen Sie Ihren Coding-Agenten alle vier Stufen mit Apidog CLI benchmarken
Diese Schleife immer wieder von Hand auszuführen wird mühsam. Lassen Sie stattdessen Ihren Coding-Agenten (Claude Code, Codex, Cursor) einen wiederverwendbaren Test mit Apidog CLI erstellen und ihn auf jeder Stufe erneut ausführen, wenn Sie frische Zahlen brauchen.
Einmal einrichten:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Dann geben Sie Ihrem Agenten einen Prompt:
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and variables GEMINI_API_KEY and
THINKING. Add an endpoint for POST /v1beta/interactions that sends the
x-goog-api-key header from GEMINI_API_KEY. Create a test case that sends model
"gemini-4-neon", my audit prompt, generation_config.thinking_level {{THINKING}}
and max_output_tokens 65536, and asserts: HTTP 200, status is "completed",
and usage.total_thought_tokens exists. Run it once per level (low, medium,
high, xhigh) and give me a table of thought tokens and response time.
Der Agent liest jedes Payload-Schema, validiert dessen JSON, erstellt die Ressourcen und wiederholt den Lauf:
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
for level in low medium high xhigh; do
  apidog run --test-case <caseId> --project <projectId> -e <envId> \
    --env-var "THINKING=$level" -r cli,json --out-file "neon-$level"
done
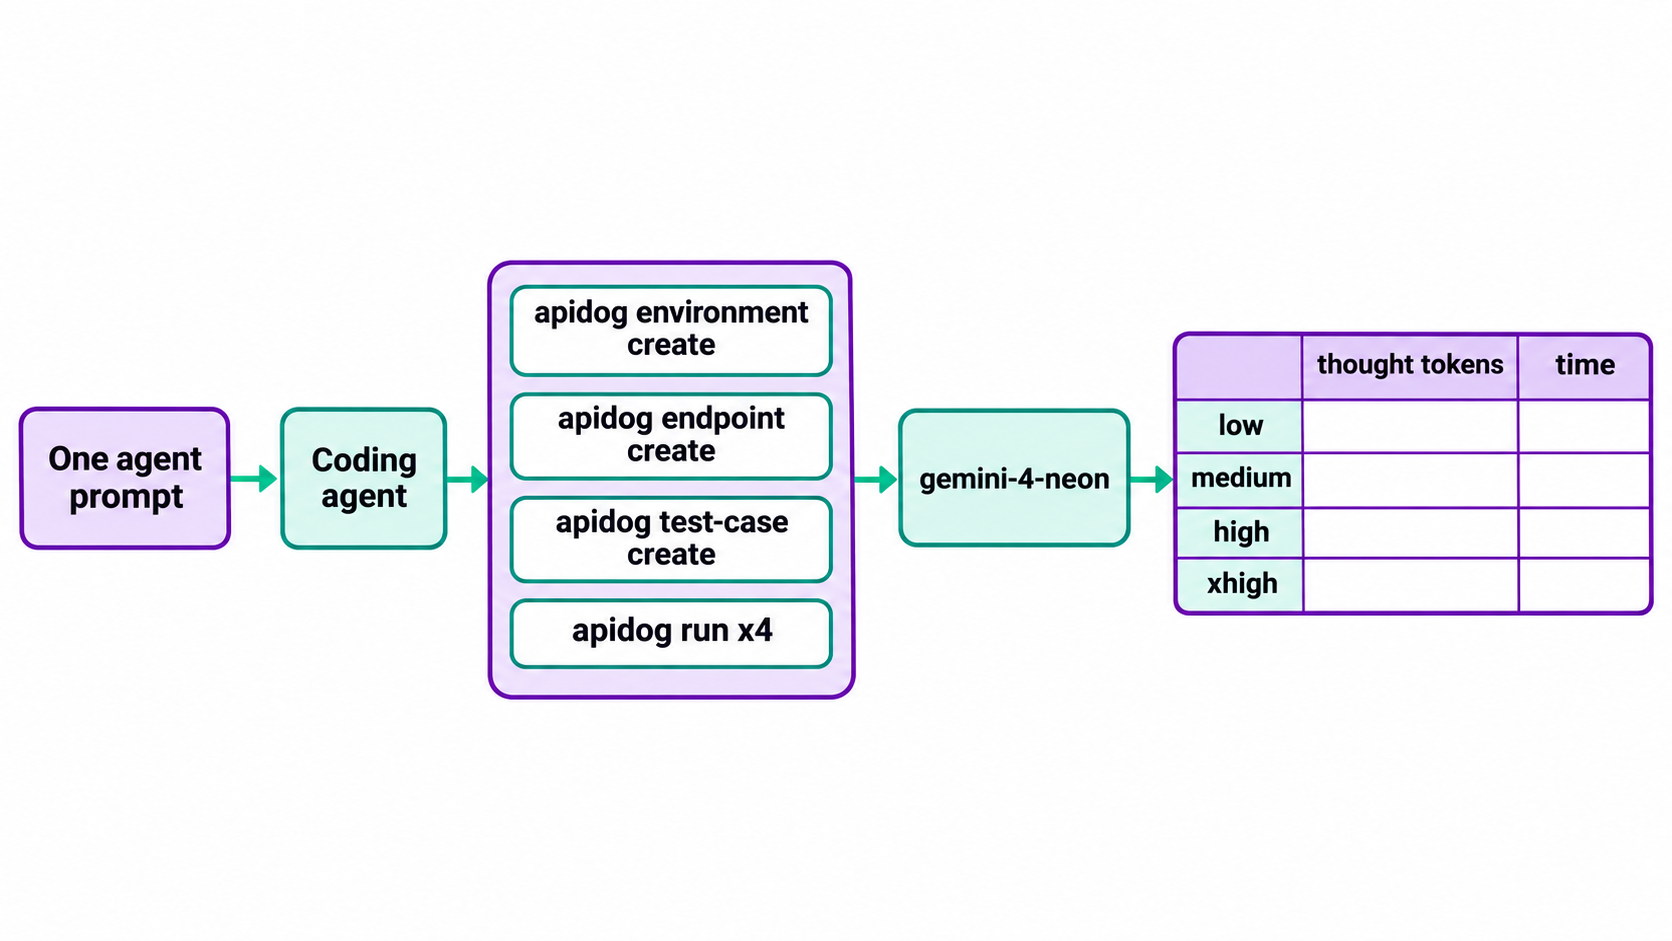
Die Assertion status is "completed" fängt die incomplete-Falle aus dem vorigen Abschnitt ab, sodass eine Stufe, die das Budget ausschöpft, deutlich fehlschlägt, statt einen leeren String zurückzugeben. Ersetzen Sie -r cli,json durch -r junit, und derselbe Lauf geht in die CI; der Apidog-CLI-CI/CD-Leitfaden zeigt die Pipeline, und Apidog CLI in Claude Code behandelt die Einrichtung des Agenten. Der kostenlose Tarif von Apidog deckt bis zu 4 Nutzer ab.
FAQ
Was ist die Standard-Thinking-Stufe für Gemini 4 Neon? high. Sie müssen thinking_level nicht senden, um sie zu erhalten. Carbon und Argon haben medium als Standard, daher sollte man die Stufe beim Migrieren von diesen Modellen explizit setzen.
Unterstützt Gemini 4 Neon minimales Thinking? Nein. Neon unterstützt low, medium, high und xhigh und lehnt minimal mit einem Fehler ab. Verwenden Sie low für die schnellsten und günstigsten Antworten.
Werden Thinking-Tokens bei Gemini 4 Neon berechnet? Ja. Thought-Tokens werden zum Output-Preis von 15,00 $ pro 1 Mio. berechnet. Google zählt jedes Token, das das Modell verarbeitet, einschließlich Thinking-Tokens.
Kann ich thinkingBudget mit Gemini 4 Neon noch verwenden? Bei Gemini-4-Modellen ist es veraltet. Allein gesendet, wird es auf das nächstgelegene thinkingLevel abgebildet und gibt eine Warnung zurück. Zusammen mit thinkingLevel gesendet, schlägt die Anfrage mit einem 400 fehl.
Ist xhigh immer genauer als high? Nicht immer. Laut Google kann xhigh einfache Prompts wie Text- oder JSON-Extraktion überdenken und max_output_tokens erschöpfen. Testen Sie beides mit Ihren eigenen Prompts und behalten Sie die niedrigste Stufe, die besteht.
Kann ich die Thinking-Level von Gemini 4 Neon kostenlos nutzen? Nein. Gemini 4 Neon ist im kostenlosen Tarif der Gemini API nicht verfügbar. In Google AI Studio und Google Antigravity ist es an die kostenpflichtigen Pläne Google AI Pro und Ultra gebunden.