
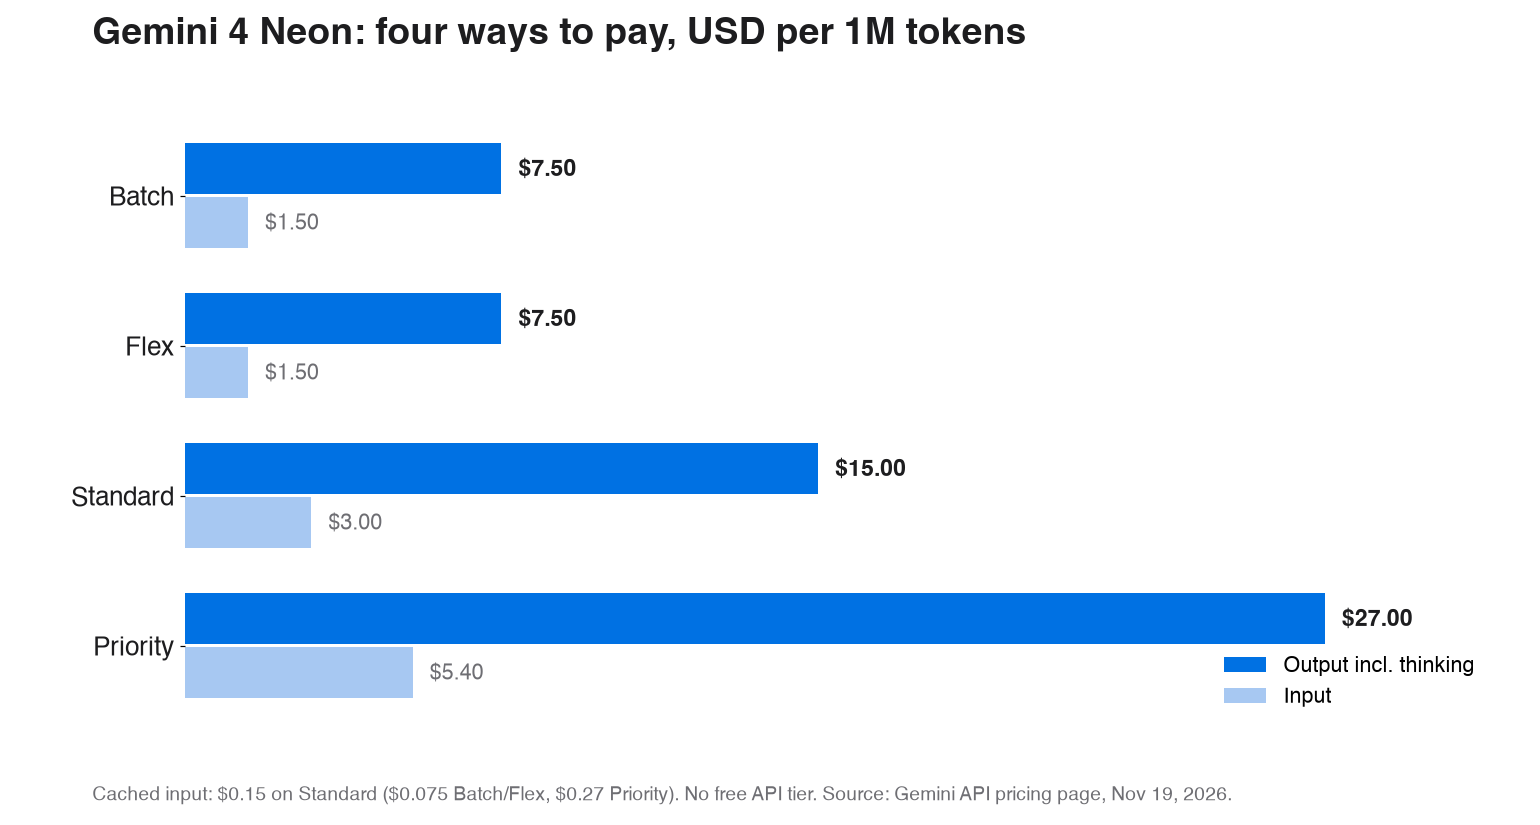
Gemini 4 Neon kostet 3 $ pro 1M Eingabe-Tokens und 15 $ pro 1M Ausgabe-Tokens im Standard-Tarif der Gemini API – einheitlich über das gesamte 1M-Token-Kontextfenster. Thinking-Tokens werden zum Ausgabepreis abgerechnet, gecachte Eingaben kosten 0,15 $ pro 1M, Batch und Flex halbieren alle Preise, und Priority liegt bei 5,40 $ bzw. 27 $. Einen kostenlosen API-Tarif gibt es nicht.
Google hat Neon am 18. November 2026 veröffentlicht – als Mittelmodell der Gemini-4-Familie, zwischen dem schnellen Hydrogen und dem Schwergewicht Carbon. Im Folgenden: der Preistarif, was echte Aufrufe kosten, wie Thinking-Level Ihre Rechnung beeinflussen und wie Neon vor und nach dem 1. Dezember im Vergleich zu seinen Geschwistermodellen abschneidet.
Wie viel kostet Gemini 4 Neon pro 1M Tokens?
Gemini 4 Neon (Modell-ID gemini-4-neon ) hat auf Googles Preisseite vier kostenpflichtige Tarife. Alle Preise in USD pro 1M Tokens:
| Tarif | Eingabe | Ausgabe inkl. Thinking | Gecachte Eingabe |
|---|---|---|---|
| Standard | $3.00 | $15.00 | $0.15 |
| Batch | $1.50 | $7.50 | $0.075 |
| Flex | $1.50 | $7.50 | $0.075 |
| Priority | $5.40 | $27.00 | $0.27 |
| Kostenloser Tarif | Nicht verfügbar | Nicht verfügbar | Nicht verfügbar |
Drei Details sind besonders wichtig:
- Thinking zählt als Ausgabe. In der Ausgabespalte heißt es „inklusive Thinking-Tokens“, d. h. jedes Token, das Neon zum Denken verbraucht, kostet im Standard-Tarif 15 $ pro 1M – obwohl Sie davon in der Antwort nichts sehen.
- Caching gibt es nur implizit. Den Satz von 0,15 $ bekommen Sie, wenn Googles Cache ein wiederholtes Prompt-Präfix erkennt; ein Cache-Objekt können Sie nicht selbst anlegen.
- Kein kostenloser Tarif. Auf Googles Preisseite ist Neon im Free-Tarif nicht verfügbar. Hydrogen ist das Gemini-4-Modell, das Sie für 0 $ aufrufen können (siehe unseren Leitfaden zu Gemini 4 Hydrogen kostenlos).
Was bedeuten die vier Gemini-4-Neon-Tarife?
Die vier Tarife bieten dasselbe Modell mit unterschiedlichen Geschwindigkeitsgarantien an. Batch liefert Ergebnisse asynchron zum halben Preis, Flex ist die halbe Preisstufe für Traffic, der langsamere Verarbeitung verkraftet, und Priority kostet 80 % mehr als Standard, um bei Knappheit der Kapazität schnell zu bleiben. Wählen Sie nach Frist:
| Ihre Workload | Tarif | Warum |
|---|---|---|
| Interaktiver Coding-Assistent, Chat | Standard | Ein Nutzer wartet; $3/$15 ist der Ausgangspunkt |
| Nächtlicher Code-Review, Eval-Läufe, Nachtragen von Dokumenten | Batch | Niemand wartet; Sie zahlen $1.50/$7.50 |
| Hintergrund-Agents, die später erneut versuchen können | Flex | Gleicher halber Preis, ohne eine Batch-Datei zu bauen |
| Kundengerichteter Agent mit Verfügbarkeitsversprechen | Priority | $5.40/$27 kauft Ihnen Kapazität unter Last |
Grounding hat einen eigenen Zähler. Im Standard- und Priority-Tarif umfasst das Google-Suche-Grounding 5.000 kostenlose Suchanfragen pro Monat, geteilt über Gemini 3 und neuere Modelle, danach kostet es 14 $ pro 1.000. Das Google-Maps-Grounding folgt demselben Muster: 5.000 kostenlos, danach 14 $ pro 1.000. Für Batch oder Flex listet die Preisseite keinen Grounding-Preis auf.
Wie verändern Thinking-Level Ihre Gemini-4-Neon-Rechnung?
Neon unterstützt vier Thinking-Level: low, medium, high und xhigh. Das Level ändert nicht den Preis pro Token, sondern wie viele Ausgabe-Tokens Neon verbrennt, bevor es antwortet.
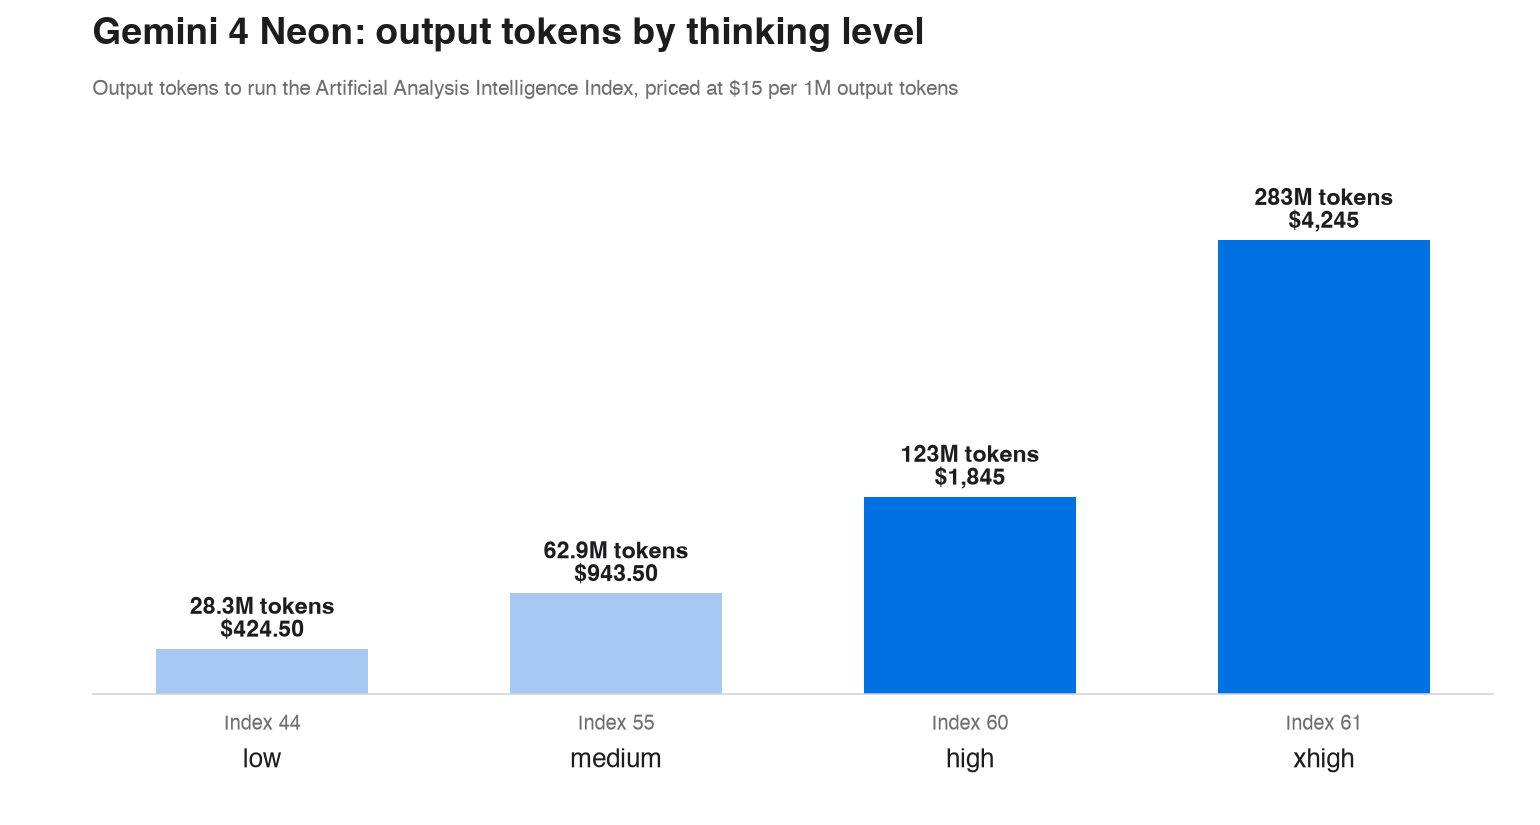
Artificial Analysis hat seinen Intelligence Index auf jedem Level ausgeführt und die jeweils verbrauchten Ausgabe-Tokens veröffentlicht. Multipliziert mit dem Standard-Ausgabepreis von 15 $ ergibt sich die Ausgabekosten des gesamten Laufs:
| Thinking-Level | Intelligence Index | Ausgabe-Tokens | Ausgabekosten bei $15/1M | Zeit pro Aufgabe |
|---|---|---|---|---|
| low | 44 | 28.3M | $424.50 | 3,7 Min. |
| medium | 55 | 62.9M | $943.50 | 8,3 Min. |
| high | 60 | 123M | $1,845 | 14,8 Min. |
| xhigh | 61 | 283M | $4,245 | 21,5 Min. |
Zwei Dinge springen ins Auge: Der Wechsel von high auf xhigh kauft einen Indexpunkt für das 2,3-Fache an Ausgabe-Tokens. Und medium liefert den Großteil des high-Ergebnisses für etwa die Hälfte der Tokens. Laut Artificial Analysis liegt Neons typische Kosten bei 6,44 $ pro Index-Aufgabe auf xhigh.
Die praktische Regel: Beginnen Sie Ihre Tests bei medium, stufen Sie eine Aufgabe nur dann auf high hoch, wenn Sie nachweisen können, dass sie bei medium fehlschlägt, und sparen Sie xhigh für die seltenen Probleme auf, bei denen ein zusätzlicher Qualitätspunkt mehr als die doppelten Kosten wert ist.
Was kostet ein einzelner Gemini-4-Neon-Aufruf?
Hier sind drei typische Anfrageformen, berechnet im Standard-Tarif. Die Ausgabewerte enthalten Thinking-Tokens.
1. Ein Code-Review-Aufruf. 20.000 Eingabe-Tokens (Diff plus Kontext), 3.000 Ausgabe-Tokens:
- Eingabe: 20.000 × 3 $ / 1M = 0,060 $
- Ausgabe: 3.000 × 15 $ / 1M = 0,045 $
- Gesamt: 0,105 $ pro Aufruf, bzw. 0,0525 $ bei Batch
Wenn Sie davon 1.000 täglich über 30 Tage ausführen, zahlen Sie im Standard-Tarif 3.150 $ pro Monat – oder 1.575 $, wenn die Reviews auf Batch warten können.
2. Eine Agent-Schleife mit gecachtem Präfix. Zehn Runden, jede sendet denselben 50.000-Token-Systemprompt und dieselbe Tool-Liste, plus 5.000 neue Eingabe-Tokens und 2.000 Ausgabe-Tokens:
- Mit Cache-Treffer beim Präfix: 50.000 × 0,15 $ / 1M + 5.000 × 3 $ / 1M + 2.000 × 15 $ / 1M = 0,0525 $ pro Runde, 0,53 $ für die Schleife
- Ohne Cache-Treffer: 55.000 × 3 $ / 1M + 2.000 × 15 $ / 1M = 0,195 $ pro Runde, 1,95 $ für die Schleife
Das ist ein Unterschied von 73 % allein durchs Caching. Da Neons Caching implizit ist, können Sie den Treffer nicht erzwingen; Sie erhöhen die Wahrscheinlichkeit, indem Sie den stabilen Teil des Prompts an den Anfang stellen und ihn zwischen den Runden byteidentisch halten.
3. Eine Frage zu einem langen Dokument. 800.000 Eingabe-Tokens (eine große Codebasis oder ein Vertragspaket) und 4.000 Ausgabe-Tokens:
- Eingabe: 800.000 × 3 $ / 1M = 2,40 $
- Ausgabe: 4.000 × 15 $ / 1M = 0,06 $
- Gesamt: 2,46 $, bzw. 1,23 $ bei Batch
Neon hat auf der Preisseite keinen Langkontext-Aufschlag, sodass Token 900.000 genauso viel kostet wie Token 1. Das Kontextfenster umfasst 1.048.576 Tokens, die sich Eingabe und Ausgabe teilen, und eine einzelne synchrone Anfrage liefert standardmäßig bis zu 65.536 Ausgabe-Tokens.
Wie schneidet der Neon-Preis im Vergleich zu Hydrogen und Carbon ab?
Neon kostet pro Token genau doppelt so viel wie Hydrogen. Der Vergleich mit Carbon kippt am 1. Dezember, wenn Carbons Einführungspreis endet:
| Modell | Eingabe / 1M | Ausgabe / 1M | Code-Review-Aufruf (20K rein, 3K raus) | Kostenloser Tarif |
|---|---|---|---|---|
| Gemini 4 Hydrogen | $1.50 | $7.50 | $0.0525 | Ja |
| Gemini 4 Neon | $3.00 | $15.00 | $0.105 | Nein |
| Gemini 4 Carbon, bis 30. Nov. | $2.00 | $10.00 | $0.070 | Nein |
| Gemini 4 Carbon, ab 1. Dez. | $4.00 | $20.00 | $0.140 | Nein |
Für die nächsten elf Tage ist Carbon pro Token günstiger als Neon. Wenn Sie heute auf Carbons 2 $/10 $ aufbauen, planen Sie für Dezember mit 4 $/20 $. Unsere Preis-Analyse zu Gemini 4 Carbon behandelt diese Änderung ausführlich.
Ab dem 1. Dezember liegt Neon in der Mitte: 25 % unter Carbon, das Doppelte von Hydrogen pro Token. Pro Aufgabe hängt die Lücke von den Thinking-Tokens ab, daher messen Sie die Kosten pro Anfrage lieber an Ihren eigenen Prompts, statt Preistabellen zu vergleichen.
Leiten Sie nach Schwierigkeit: Hydrogen für hochvolumige Alltagsaufrufe, Neon für komplexe Coding- und Analyse-Aufgaben, die Sie häufig ausführen, und Carbon für die schwersten Einzelfälle.
Wie können Sie Ihre Gemini-4-Neon-Rechnung senken?
Fünf Hebel, in der Reihenfolge, in der sie sich meist auszahlen:
- Thinking-Level senken.
mediumverbraucht in den Artificial-Analysis-Läufen etwa die Hälfte der Ausgabe-Tokens vonhigh. - Wartende Arbeiten an Batch oder Flex senden. Alles, was niemand in Echtzeit liest, kostet die Hälfte.
- Prompts für implizites Caching gestalten. Halten Sie Systemprompts und Tool-Definitionen oben und unverändert, damit wiederholte Präfixe mit 0,15 $ statt 3 $ abgerechnet werden.
- Ausgabe begrenzen. Legen Sie ein Maximum an Ausgabe-Tokens fest, das zur Aufgabe passt.
- Einfache Aufrufe an Hydrogen leiten. Neon nur für Aufgaben einsetzen, die es wirklich brauchen.
Prüfen Sie die Seite zu den Rate Limits der Gemini API für Ihren Tarif, bevor Sie den Durchsatz planen.
Ihre echten Gemini-4-Neon-Kosten mit Apidog CLI messen
Jede Antwort von Googles Interactions API enthält ein usage-Objekt mit den Token-Zählern für Eingabe, Cache, Thinking und Ausgabe. Dieser Block, multipliziert mit der Preistabelle oben, ist Ihre tatsächlichen Kosten pro Anfrage. Dieselben Prompts auf jedem Thinking-Level auszuführen und zu vergleichen, ist eine repetitive Aufgabe – delegieren Sie sie an Ihren Coding-Agenten.
Apidog CLI gibt Claude Code, Codex, Cursor oder OpenCode einen Kommandozeilenweg, um API-Tests anzulegen und auszuführen. Richten Sie es einmal ein:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Geben Sie Ihrem Agenten dann einen Prompt:
In Apidog project <id>, create an environment for the Gemini API with
GEMINI_API_KEY and THINKING_LEVEL variables. Add a test case for
POST /v1beta/interactions with model gemini-4-neon and
generation_config.thinking_level set from THINKING_LEVEL. Send our code review
prompt, assert HTTP 200 and non-empty output, and save usage.total_input_tokens,
total_cached_tokens, total_thought_tokens and total_output_tokens. Run it at
low, medium and high, then compute the Standard cost of each run at $3 input,
$0.15 cached and $15 per 1M for thought and output tokens.
Der Agent legt die Umgebung an, prüft das Payload seines Testfalls gegen das Schema und führt ihn dann einmal pro Level aus:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "THINKING_LEVEL=low" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "THINKING_LEVEL=medium" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "THINKING_LEVEL=high" -r cli,json
Die JSON-Berichte liefern Ihrem Agenten die Token-Zähler für die Preisberechnung, sodass Sie eine Kosten-Tabelle pro Level für Ihre eigenen Prompts erhalten. Fügen Sie apidog run ... -r junit gemäß dem Apidog-CLI-CI/CD-Leitfaden zu Ihrer CI hinzu, um Prompt-Änderungen zu erkennen, die Ihre Thinking-Tokens verdoppeln – oder starten Sie mit Apidog CLI in Claude Code. Apidogs kostenloser Plan deckt bis zu 4 Nutzer ab.
FAQ
Ist Gemini 4 Neon kostenlos? Nicht über die API. Auf Googles Preisseite ist Neon im Free-Tarif nicht verfügbar, daher benötigen Sie ein kostenpflichtiges Gemini-API-Projekt. Hydrogen ist das Gemini-4-Modell mit einem kostenlosen Tarif.
Werden Thinking-Tokens separat abgerechnet? Nein. Sie werden als Ausgabe-Tokens abgerechnet, im Standard-Tarif zu 15 $ pro 1M. Das usage-Objekt der Interactions API meldet sie als total_thought_tokens, sodass Sie sehen können, wie viel von jeder Rechnung auf Denken entfällt.
Kostet Gemini 4 Neon ab 200K Tokens mehr? Nein. Die Preisseite zeigt für Neon einen einzigen Eingabe- und einen einzigen Ausgabepreis, ohne Langkontext-Stufe, über das gesamte Fenster von 1.048.576 Tokens.
Wie viel günstiger ist Batch? Genau die Hälfte: 1,50 $ pro 1M Eingabe und 7,50 $ pro 1M Ausgabe, mit gecachter Eingabe bei 0,075 $. Flex hat dieselben Preise.
Ist Neon günstiger als Carbon? Erst ab dem 1. Dezember. Carbons Einführungspreis von 2 $/10 $ gilt bis zum 30. November, danach steigt er auf 4 $/20 $ – womit Neons 3 $/15 $ pro Token etwa 25 % unter Carbon liegen.