
Gemini 4 Neon context caching ist nur implizit. Sie erstellen keinen Cache. Google speichert wiederholte Prompt-Präfixe von mindestens 4.096 Token automatisch selbst ab und berechnet diese zwischengespeicherten Eingabe-Token mit 0,15 $ pro 1M statt 3 $ – ein Rabatt von 95 %. Das erreichen Sie, indem Sie den stabilen Teil jeder Anfrage an den Anfang stellen und Byt-für-Byte identisch halten. Bestätigen Sie die Treffer anschließend über usage.total_cached_tokens.
Inhalt: Prompt-Layout für Cache-Treffer, die Agent-Loop-Regel, das Auslesen der zwischengespeicherten Token-Anzahl und ein Test, den Ihr Coding-Agent für Sie ausführt.
Wie funktioniert das Context Caching von Gemini 4 Neon?
Gemini 4 Neon Context Caching ist ein automatisches Präfix-Caching. Wenn eine neue Anfrage mit denselben Token wie eine kürzliche beginnt und dieses gemeinsame Präfix mindestens 4.096 Token lang ist, liefert Google den wiederholten Teil aus dem Cache und berechnet ihn zum Caching-Tarif. Es gibt nichts einzuschalten und kein Cache-Objekt, keine TTL und keine Speichergebühr zu verwalten.
Google hat Neon am 18. November 2026 veröffentlicht (Modell-ID gemini-4-neon, siehe den Launch-Post). Die wichtigsten Caching-Fakten passen in eine Tabelle:
| Punkt | Gemini 4 Neon |
|---|---|
| Caching-Modus | Nur implizit, standardmäßig aktiv |
Explizites Caching (cachedContents, caches.create) |
Nicht unterstützt |
| Minimales Präfix für einen Cache-Treffer | 4.096 Token |
| Standardeingabe | 3,00 $ pro 1M Token |
| Zwischengespeicherte Eingabe (Standard) | 0,15 $ pro 1M Token |
| Zwischengespeicherte Eingabe (Batch und Flex) | 0,075 $ pro 1M Token |
| Zwischengespeicherte Eingabe (Priority) | 0,27 $ pro 1M Token |
| Wo man Treffer sieht | usage.total_cached_tokens |
| Free-Tier | Keiner, nur bezahlter Tier |
Der Rabatt beträgt 95 % auf jedem Tier: 0,15 $ sind 5 % von 3 $, 0,075 $ sind 5 % von 1,50 $ und 0,27 $ sind 5 % von 5,40 $. Ausgabe-Token, einschließlich Thinking-Token, kosten auf dem Standard-Tier weiterhin 15 $ pro 1M. Caching betrifft nur die Eingabe.
Implizites vs. explizites Caching bei Gemini 4 Neon
Wer explizites Caching mit Gemini 2.5 oder 3 genutzt hat, trifft hier auf die Änderung, die Code bricht. Googles Neon-Migrationshinweise sagen es unmissverständlich: Gemini 4 Neon „unterstützt kein explizites Caching (cachedContents und caches.create)“, und Sie sollten „die Felder cached_content aus Anfragen entfernen.“
Die Caching-Dokumentation ergänzt, dass die Interactions API nur implizites Caching unterstützt und explizites Caching für kein Gemini-4-Modell verfügbar ist. Explizite Caches funktionieren weiterhin auf unterstützten Gemini-3- und 2.5-Modellen über generateContent.
Was das für eine Migration bedeutet:
- Entfernen Sie den Code, der
caches.createaufruft und einen Cache-Namen speichert. - Entfernen Sie
cached_contentaus jedem Request-Body. - Zahlen Sie nicht mehr für Cache-Speicher, den Sie nicht mehr nutzen.
- Strukturieren Sie Prompts so um, dass der Inhalt, den Sie früher explizit gecacht haben, ganz am Anfang jeder Anfrage steht.
Sie können kein Dokument festpinnen oder eine TTL wählen, und ein Treffer ist nicht garantiert. Aber Sie können die Wahrscheinlichkeit deutlich erhöhen.
Wie strukturiert man Prompts, um den Gemini-4-Neon-Cache zu treffen?
Ein Cache-Treffer erfordert ein langes, identisches Präfix, das zeitnah erneut gesendet wird. Googles Dokumentation gibt zwei Tipps: Legen Sie große und gemeinsame Inhalte an den Anfang Ihres Prompts und senden Sie Anfragen mit ähnlichem Präfix innerhalb kurzer Zeit.
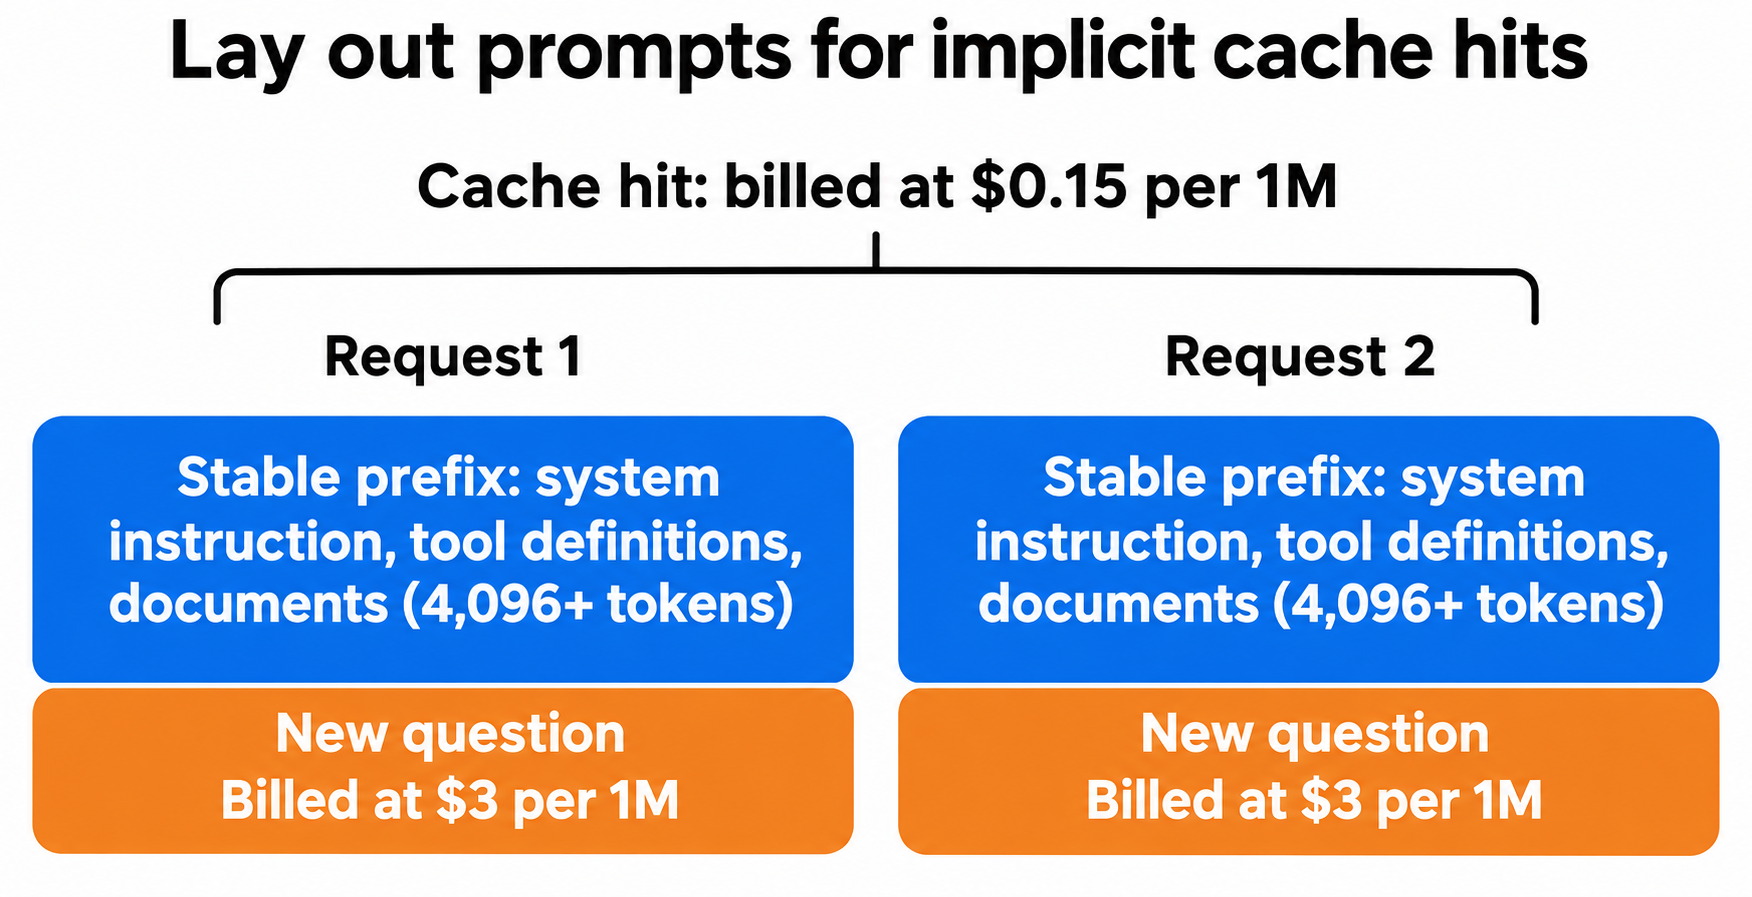
Ordnen Sie jede Anfrage so an:
- Systemanweisung. Fester Text, keine Zeitstempel, keine Benutzernamen, keine Request-IDs.
- Tool- und Funktionsdeklarationen. Immer dieselbe Liste, dieselbe Reihenfolge, dieselben Beschreibungen.
- Gemeinsame Dokumente. Der Codebase, der Vertrag, die API-Spezifikation, die lange Richtliniendatei.
- Der Teil, der sich ändert. Die Frage des Nutzers, das neueste Tool-Ergebnis, das heutige Datum.
Der häufigste Grund für einen Cache-Fehltreffer ist ein kleiner dynamischer Wert nahe dem Anfang. Eine Zeile wie Current time: 2026-11-19T09:14:02Z in der Systemanweisung verändert das Präfix bei jedem Aufruf, sodass nichts danach übereinstimmen kann. Verschieben Sie sie ans Ende, nach den Dokumenten.
Weitere Präfix-Brecher: Tool-Listen in zufälliger Reihenfolge, Dokumente, die mit anderem Whitespace neu serialisiert wurden, und abgerufene Chunks in unterschiedlicher Reihenfolge.
Halten Sie das Präfix über 4.096 Token. Ein 2.000-Token-Systemprompt allein qualifiziert sich nicht. Senden Sie dazu ein langes gemeinsames Dokument, qualifiziert sich das kombinierte Präfix.
Übergeben Sie bei der Interactions API die stabile Anweisung in system_instruction und stellen Sie die Dokumente an den Anfang von input:
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY

SYSTEM = open("review_rules.md").read()      # fixed text
CODEBASE = open("repo_snapshot.txt").read()  # ~200K tokens, unchanged

def ask(question: str):
    interaction = client.interactions.create(
        model="gemini-4-neon",
        system_instruction=SYSTEM,
        input=CODEBASE + "\n\nQuestion: " + question,
    )
    print("cached tokens:", interaction.usage.total_cached_tokens)
    return interaction

ask("Where do we validate JWT expiry?")
ask("Which handlers skip input validation?")
Der erste Aufruf füllt den Cache. Gibt der zweite 0 zwischengespeicherte Token aus, hat sich im Präfix etwas geändert.
Implizites Caching funktioniert in beiden Konversationsmodi. Zustandslose Aufrufe wie der obige qualifizieren sich, ebenso zustandsbehaftete Sitzungen, die mit previous_interaction_id verkettet sind. Die vollständigen Request-Formen finden Sie in unserem Gemini-4-Neon-API-Guide.
So funktioniert Caching in Agent-Loops: die 2.050-Token-Regel
Agent-Loops sind der Ort, an dem Caching am meisten bringt, weil jede Runde den kompletten Verlauf erneut sendet. Gemini-4-Modelle fügen eine Regel hinzu, die Sie kennen sollten. Aus Googles Caching-Doku: „Gemini cached die gesamte vorherige Anfrage nur, wenn die neue Anfrage mindestens 2.050 Token hinzufügt.“ Modellausgaben, Thoughts und Funktionsergebnisse zählen alle zu dieser Summe.
Fügt eine Runde weniger als 2.050 Token hinzu, verarbeitet Gemini die letzten 2.050 Token der vorherigen Anfrage zum Standardeingabetarif neu. Der frühere Teil des Präfixes kann weiterhin treffen, aber dieser Schwanz wird mit 3 $ pro 1M abgerechnet.
Google merkt an, dass die meisten Agent-Runden den Schwellenwert überschreiten. Relevant wird es bei gesprächigen Loops mit winzigen Schritten, etwa wenn ein Status-Check {"ok": true} zurückgibt. Die Kosten sind pro Runde gering (2.050 Token à 3 $ pro 1M sind etwa 0,006 $), summieren sich aber über Tausende kurzer Runden. Wenn Ihr Loop viele winzige Aufrufe macht, bündeln Sie kleine Tool-Ergebnisse in einer Runde, wo Ihre Logik es erlaubt.
Wie viel spart Gemini 4 Neon Context Caching?
Nehmen wir einen Code-Review-Assistenten, der 20 Fragen zu einer 200.000-Token-Codebase beantwortet. Jede Frage fügt 3.000 Token hinzu und erhält eine 1.000-Token-Antwort, auf dem Standard-Tier.
Ohne Cache-Treffer kostet jeder Aufruf:
- Eingabe: 203.000 × 3 $ / 1M = 0,609 $
- Ausgabe: 1.000 × 15 $ / 1M = 0,015 $
- Pro Aufruf: 0,624 $, also 12,48 $ für 20 Aufrufe
Mit Cache-Treffern nach dem ersten Aufruf kosten die Aufrufe 2 bis 20:
- Gecachtes Präfix: 200.000 × 0,15 $ / 1M = 0,030 $
- Neue Eingabe: 3.000 × 3 $ / 1M = 0,009 $
- Ausgabe: 0,015 $
- Pro Aufruf: 0,054 $
Zuzüglich des ersten, nicht gecachten Aufrufs mit 0,624 $ kostet die Sitzung 1,65 $, rund 87 % weniger.
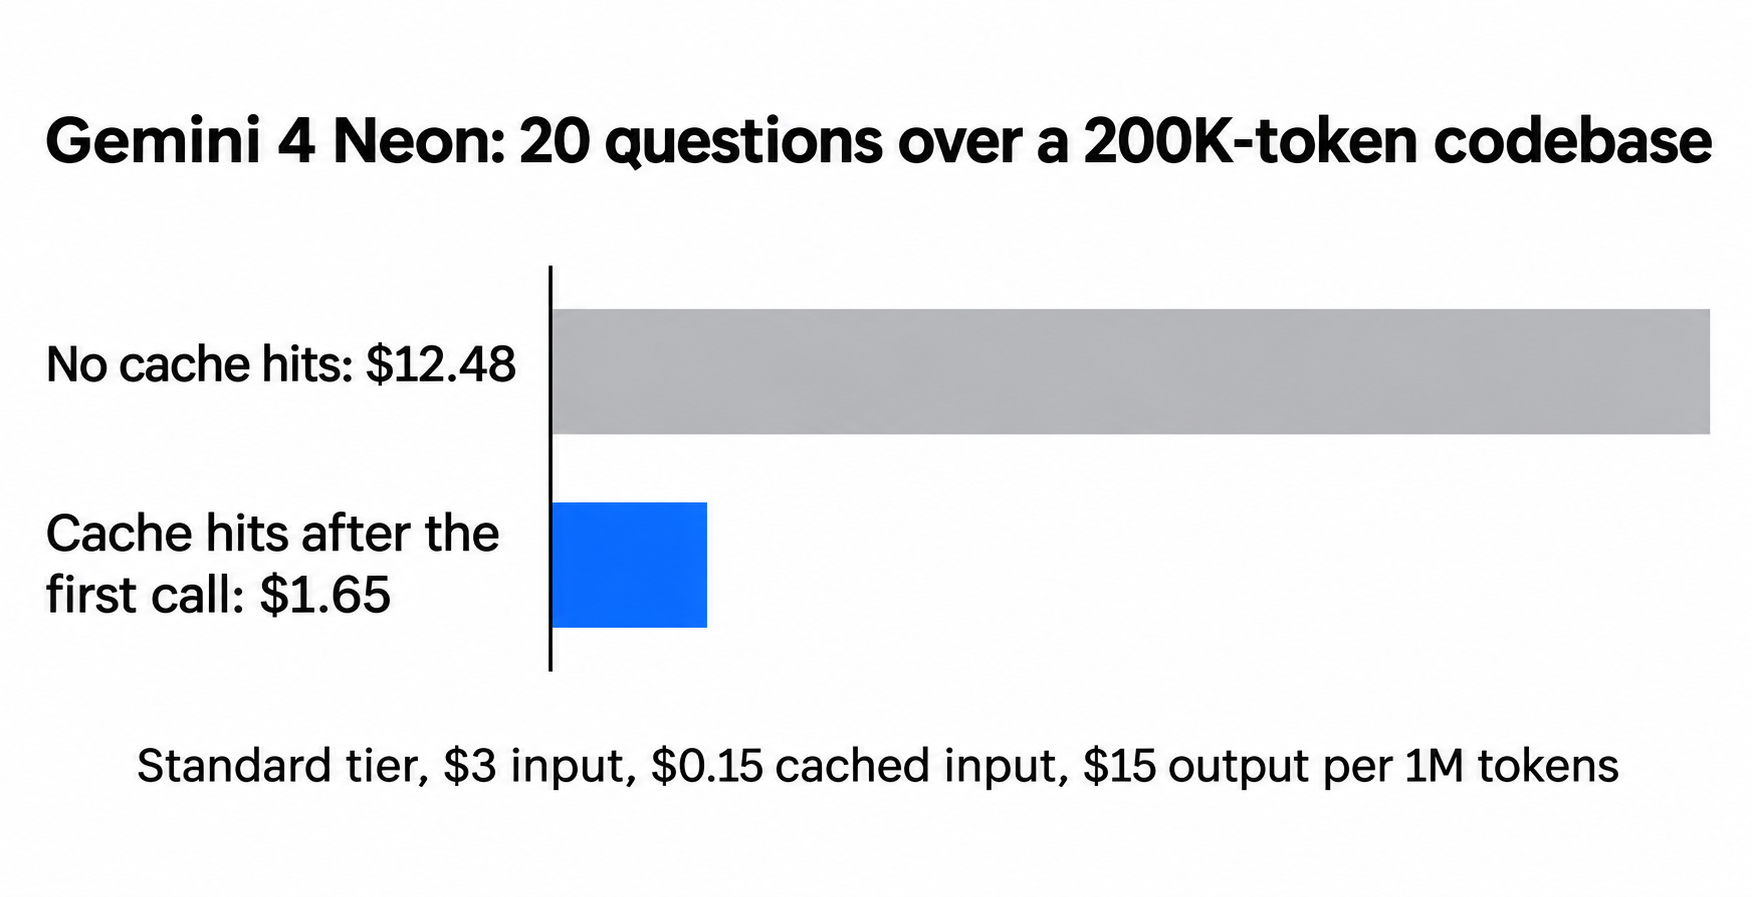
Die Ersparnis liegt unter 95 %, weil Ausgabe und neue Eingabe nie den Rabatt erhalten. Je größer das gemeinsame Präfix im Verhältnis zum Rest, desto näher kommen Sie den 95 % bei der Eingabe. Führen Sie denselben Job über Batch aus, halbiert sich der Cached-Tarif erneut auf 0,075 $. Die vollständige Preisliste und die Thinking-Level-Kosten finden Sie unter Gemini 4 Neon Pricing.
Wie prüft man die zwischengespeicherten Token von Gemini 4 Neon in der Antwort?
Lesen Sie usage.total_cached_tokens bei jeder Antwort. Google dokumentiert es als das Feld, das anzeigt, wie viele Token Cache-Treffer waren, sowohl im Python- als auch im JavaScript-SDK.
Mit curl und jq:
curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d @request.json | jq '.usage'
Um einen Aufruf zu preisen, rechnen Sie die gecachten Token mit 0,15 $ pro 1M, den Rest Ihrer Eingabe mit 3 $ und Ausgabe plus Thinking mit 15 $. Protokollieren Sie die gecachte Anzahl neben Ihrer Request-ID. Ein plötzlicher Abfall auf 0 über den gesamten Traffic bedeutet meist, dass ein Deploy das Präfix geändert hat: ein neues Tool, eine umformulierte Regel oder ein Zeitstempel, der sich in die Systemanweisung geschlichen hat.
Lassen Sie Ihren Coding-Agent Cache-Treffer mit der Apidog CLI testen
Präfixe brechen bei gewöhnlichen Refactorings, und niemand merkt es, bis die Rechnung kommt. Machen Sie aus der Cache-Prüfung einen API-Test, den Ihr Coding-Agent pflegt und CI ausführt.
Apidog CLI ermöglicht Claude Code, Codex, Cursor oder OpenCode, API-Tests aus dem Terminal zu erstellen und auszuführen. Richten Sie es einmal ein:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Geben Sie Ihrem Agenten dann einen Prompt:
In Apidog project <id>, create an environment for the Gemini API with a
GEMINI_API_KEY variable. Build a test scenario called "Neon cache hit" with two
steps that POST to /v1beta/interactions with model gemini-4-neon, using our
production system_instruction and the docs/context.md file as the start of
input, then two different questions. Assert HTTP 200 on both, and assert that
usage.total_cached_tokens on step 2 is greater than 4096. Run it and tell me
the cached token count.
Der Agent erstellt Umgebung und Szenario, prüft sein Payload gegen das CLI-Schema und führt es aus:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog test-scenario create --project <id> --name "Neon cache hit"
apidog cli-schema get test-scenario-update
apidog cli-schema validate test-scenario-update --file scenario.json
apidog test-scenario update <scenarioId> --project <id> --file scenario.json
apidog run -t <scenarioId> --project <id> -e <envId> -r cli,json
Fügt jemand nächsten Monat einen Zeitstempel zum Systemprompt hinzu, schlägt die Assertion von Schritt 2 fehl, bevor die Änderung ausgeliefert wird. Nehmen Sie apidog run -t <scenarioId> --project <id> -e <envId> -r junit in Ihre Pipeline auf, mit dem Apidog-CLI-CI/CD-Guide, oder starten Sie mit Apidog CLI in Claude Code. Jeder Lauf macht zwei echte Neon-Aufrufe und kostet bei den obigen Tarifen also ein paar Cent pro Durchlauf. Apidogs Free-Plan deckt bis zu 4 Nutzer ab.
Wie Präfix-Caching anbieterübergreifend funktioniert, erfahren Sie unter Was ist Prompt-Caching.
FAQ
Unterstützt Gemini 4 Neon explizites Context Caching? Nein. Googles Neon-Guide besagt, dass cachedContents und caches.create nicht unterstützt werden und Sie cached_content aus Anfragen entfernen sollten. Neon nutzt nur implizites Caching, das standardmäßig aktiv ist.
Wie groß muss der Prompt mindestens sein, um den Gemini-4-Neon-Cache zu treffen? 4.096 Token gemeinsames Präfix. Das ist dasselbe Minimum wie bei Gemini 4 Hydrogen, Argon und Carbon. Gemini 2.5 Flash und Pro benötigen 2.048.
Wie hoch ist der Caching-Rabatt bei Gemini 4 Neon? 95 % auf gecachte Eingabe. Standard sinkt von 3 $ auf 0,15 $ pro 1M Token, Batch und Flex von 1,50 $ auf 0,075 $, und Priority von 5,40 $ auf 0,27 $. Ausgabe- und Thinking-Token werden nicht rabattiert.
Kann ich Gemini 4 Neon zwingen, einen Prompt zu cachen? Nein. Implizites Caching hat keine umschaltbare Einstellung, keine wählbare TTL und keinen garantierten Treffer. Sie erhöhen die Wahrscheinlichkeit, indem Sie ein langes, identisches Präfix an den Anfang jeder Anfrage stellen und ähnliche Anfragen zeitnah senden.
Woher weiß ich, ob meine Anfrage den Cache getroffen hat? Prüfen Sie usage.total_cached_tokens in der Antwort. Ein Wert über null bedeutet, dass so viele Eingabe-Token zum gecachten Tarif abgerechnet wurden.
Funktioniert Caching mit previous_interaction_id? Ja. Googles Dokumentation besagt, dass implizites Caching sowohl in zustandsbehafteten Konversationen mit previous_interaction_id als auch in zustandslosen funktioniert, bei denen Sie den kompletten Verlauf selbst senden.