
Die Gemini-4-Neon-Benchmarks setzen es auf Platz 1 im Artificial Analysis Coding Agent Index (58,6), auf 65,2 % bei Terminal-Bench 4.1 und auf Platz 2 im Vals Index (70,9 %). Google gibt außerdem an, dass es pro Aufgabe 32 % weniger kostet als Gemini 4 Carbon bei der standardmäßigen Denkstufe high. Die meisten Werte wurden jedoch mit xhigh erzielt, einige auch auf Googles eigenem Harness.
Genau dieses letzte Detail ist der Kern dieses Beitrags. Unser Gemini-4-Neon-Überblick behandelt Spezifikationen und Preise. Hier bekommst du jeden veröffentlichten Score, wer ihn gemessen hat, auf welcher Denkstufe, und wie du „Kosten pro Aufgabe“ in eine Zahl verwandelst, die du mit deiner eigenen Rechnung abgleichen kannst.
Gemini 4 Neon Benchmarks auf einen Blick
Gemini 4 Neon ist Googles mittleres Gemini-4-Modell, veröffentlicht am 18. November 2026, mit einem Preis von 3 $ pro Million Input-Tokens und 15 $ pro Million Output-Tokens. Seine stärksten veröffentlichten Ergebnisse liegen im agentischen Coding und in der Wissensarbeit, wo es auf vier unabhängigen Ranglisten Platz 1 oder 2 belegt.
Dies sind die zentralen Werte aus Googles Launch-Post:
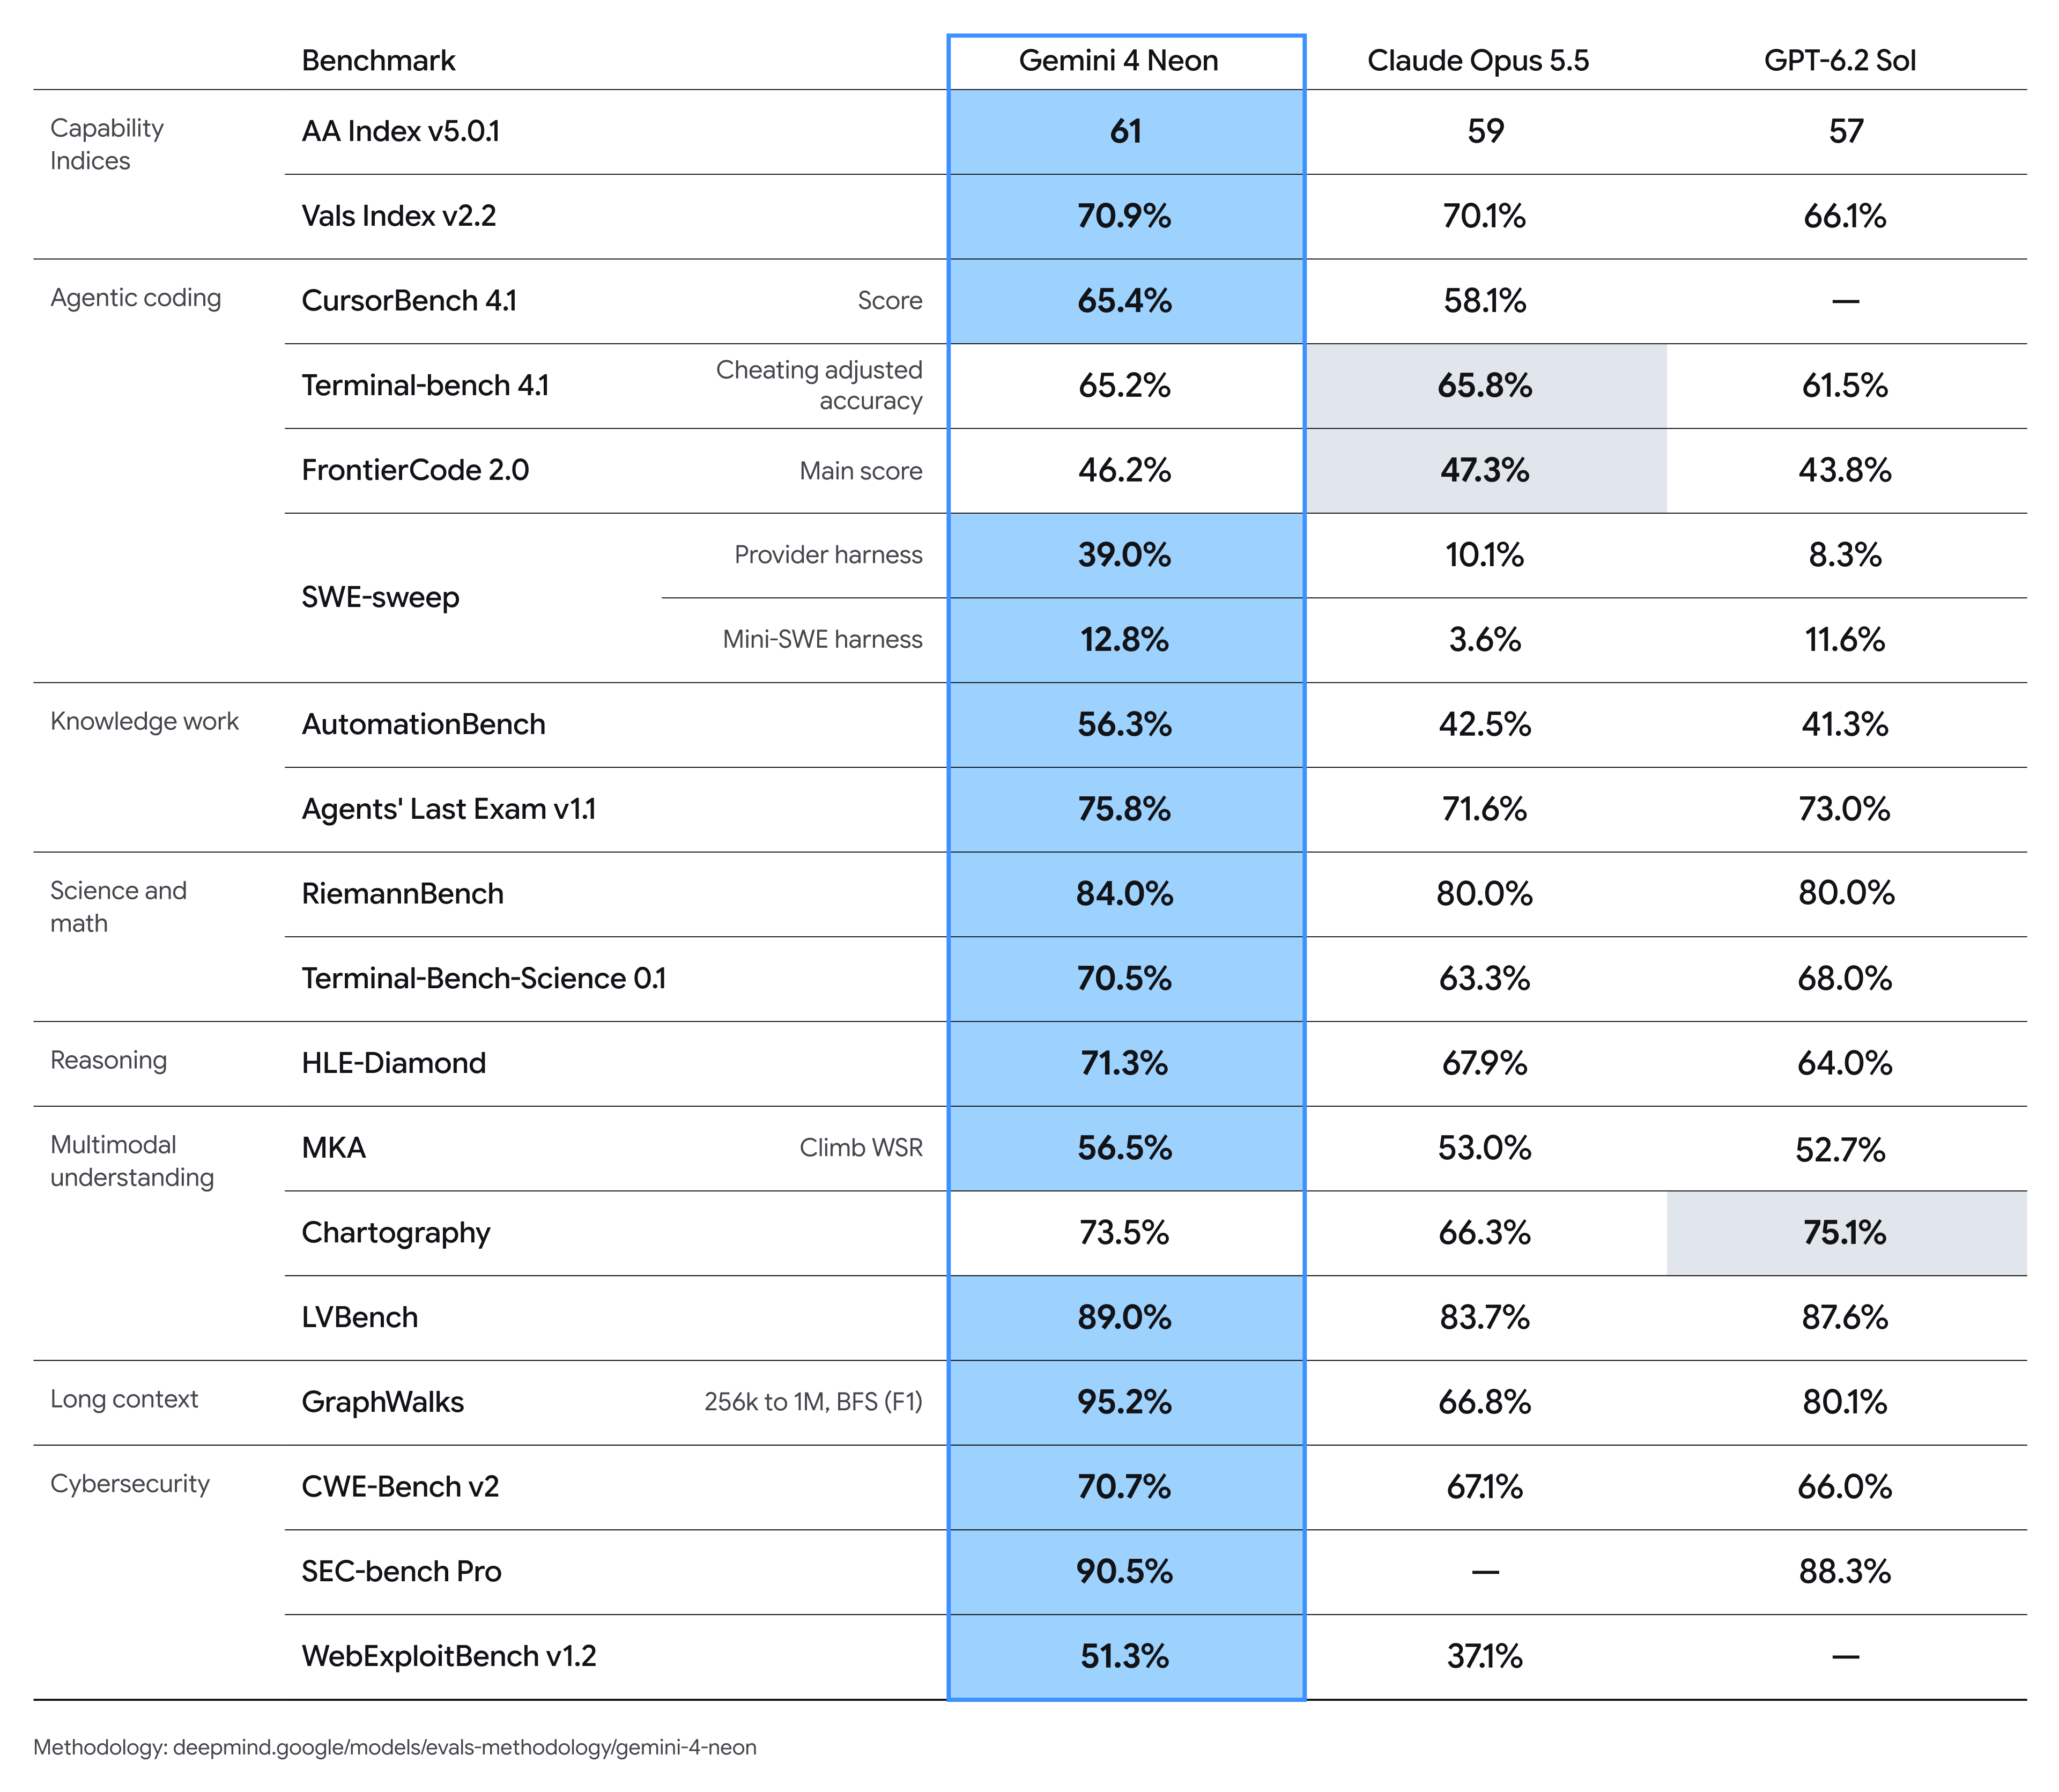
Google meldet außerdem Platz 1 in Vals AIs Legal Research Bench und Tax Agent Bench.
Gemini 4 Neon Coding-Benchmarks
Coding ist der Bereich, in dem Neon am stärksten abschneidet – und gleichzeitig der, in dem der Harness am meisten ausmacht. Googles PDF zur Evaluationsmethodik erläutert, wie jede Coding-Zeile erzeugt wurde.
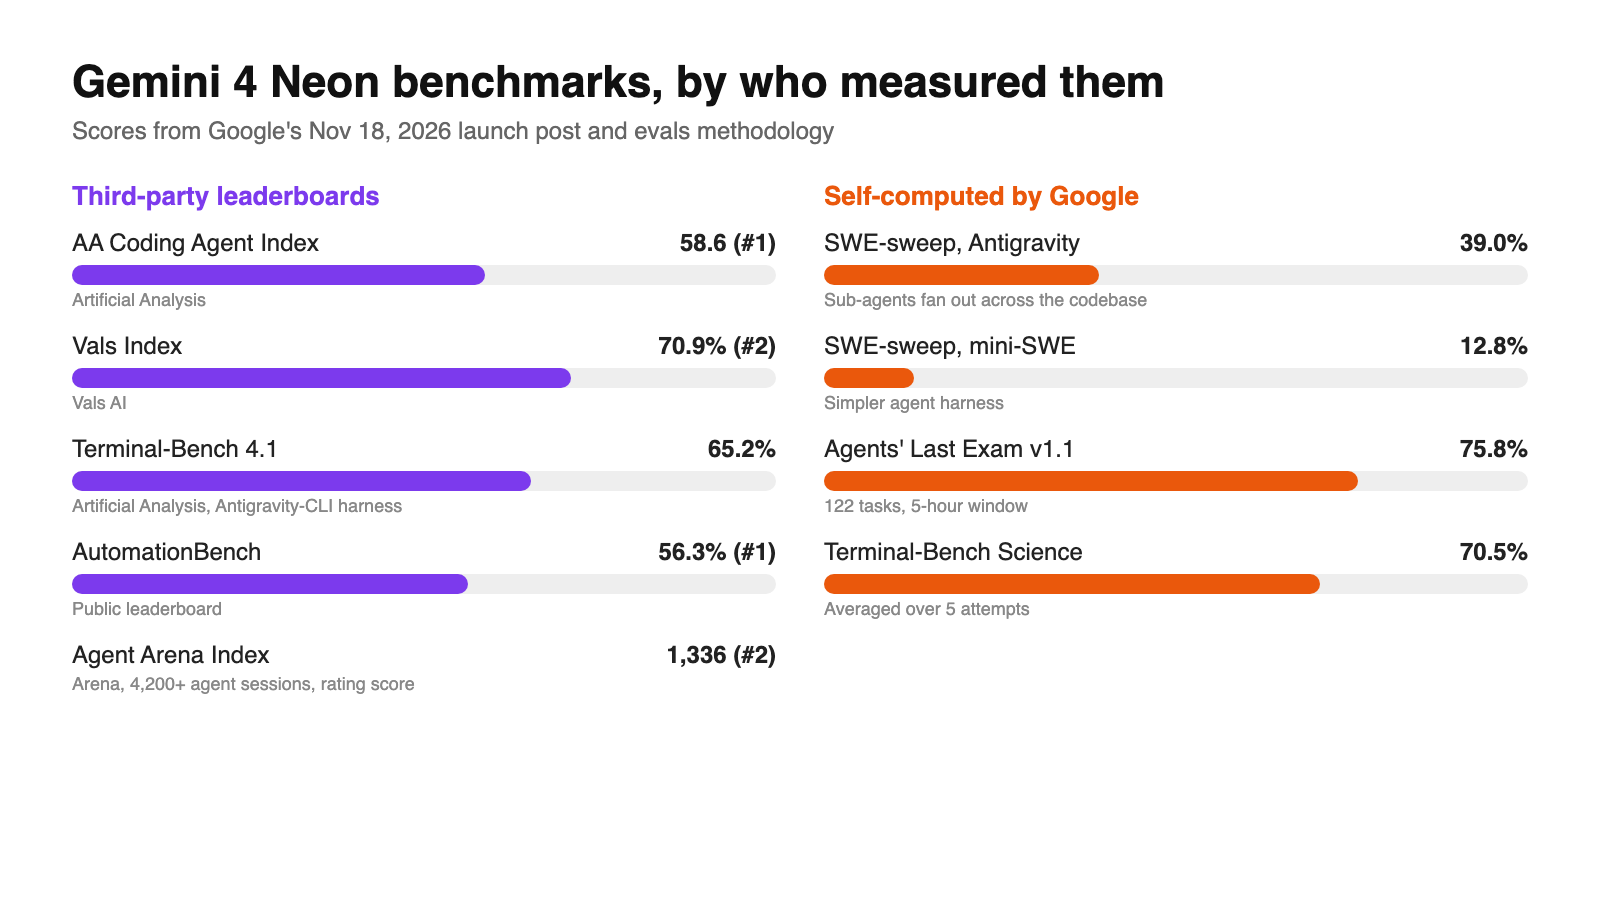
Artificial Analysis Coding Agent Index: 58,6, Platz 1. Dies ist ein unabhängiger zusammengesetzter Index und damit die Zeile, die am wenigsten von Googles Setup beeinflusst ist. Die aktuellen Platzierungen kannst du bei Artificial Analysis einsehen.
Terminal-Bench 4.1: 65,2 %. Artificial Analysis führte Neon mit dem öffentlichen Antigravity-CLI-Harness in Version 1.5.9 aus. Die Scores anderer Modelle stammen von der offiziellen Rangliste, und jedes Ergebnis verwendet eine um Cheating bereinigte Genauigkeit. Fair – aber Neon lief innerhalb von Googles eigener Agent-Tooling.
FrontierCode 2.0: 46,2 %. Dieser Wert stammt von der öffentlichen Rangliste und wurde mit high ausgeführt, der Standardstufe, die man im Produktivbetrieb erhält. Wenn du nur einer Coding-Zahl für den alltäglichen Traffic vertraust, dann dieser.
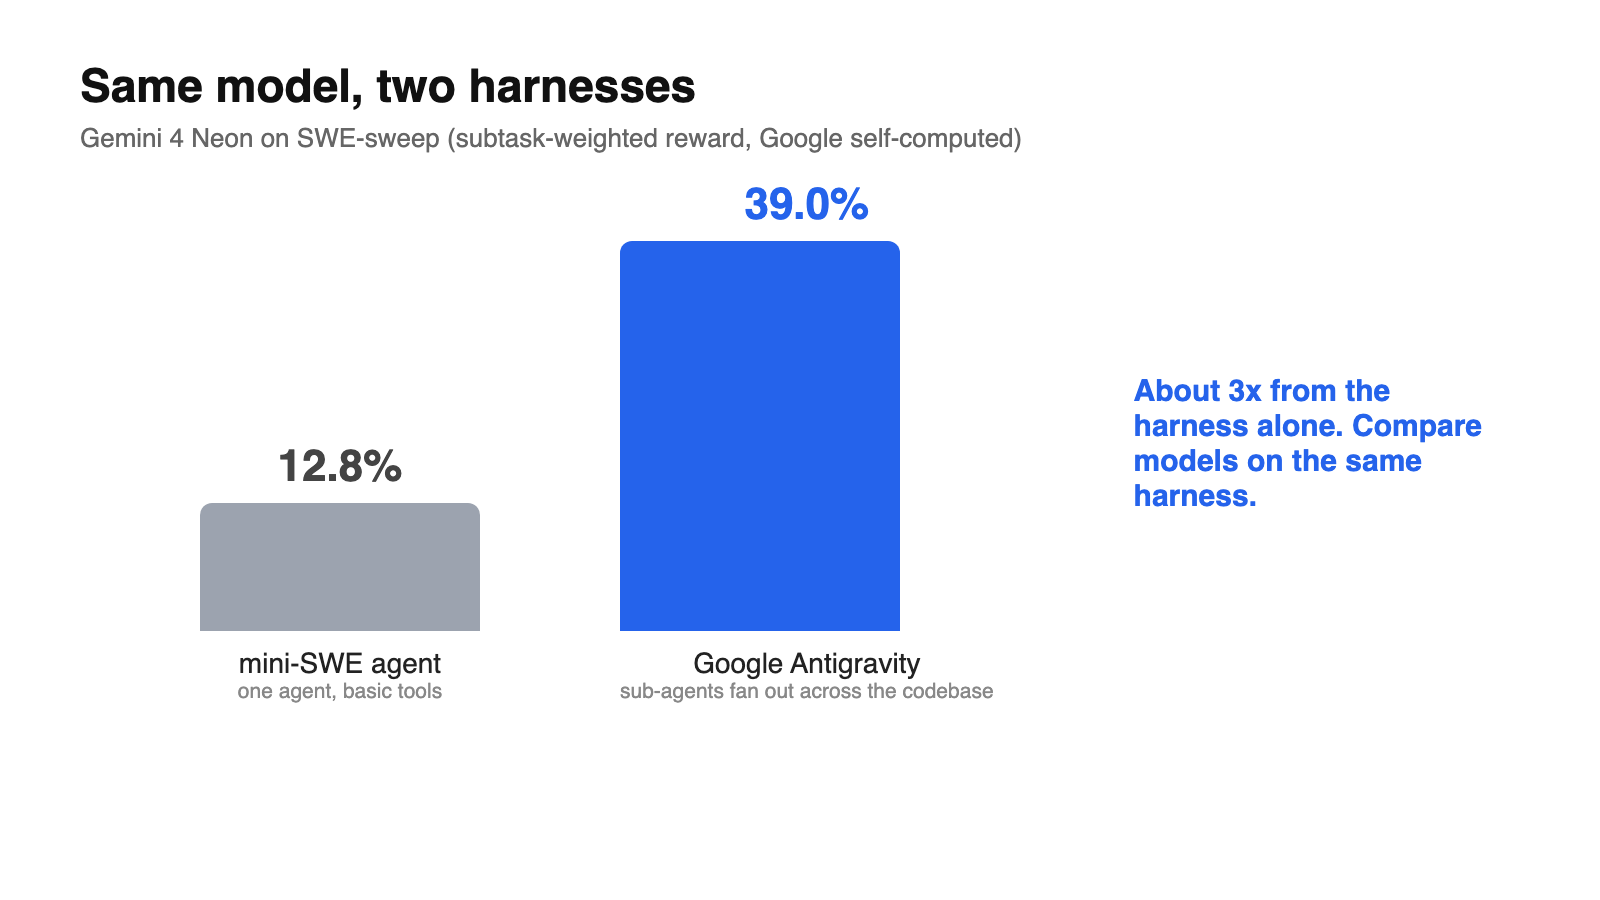
SWE-sweep: 39,0 % in Antigravity, 12,8 % auf mini-SWE. Beide wurden von Google selbst berechnet. Der Sprung um das Dreifache kommt vom Harness: Google merkt an, dass Antigravity-CLI ein Standardwerkzeug enthält, das Sub-Agenten über die Codebasis verteilt – was Aufgaben zur Fehlersuche begünstigt. Opus 5.5 lief für denselben Vergleich in Claude Code und GPT-6.2 Sol in Codex. Lies 12,8 % als das Modell und 39,0 % als das Modell plus seine beste Tooling-Umgebung.
Agent- und Wissensarbeits-Benchmarks
Diese Werte sind relevant, wenn du planst, Neon unbeaufsichtigt über viele Schritte laufen zu lassen.
- Agent Arena Index: 1.336, Platz 2. Basiert auf über 4.200 realen Agent-Sessions. Google gibt außerdem an, dass Neon dort Platz 2 bei der Steuerbarkeit belegt – das heißt, es passt sich sauber an, wenn ein Nutzer mitten in der Aufgabe korrigierend eingreift.
- AutomationBench: 56,3 %, Platz 1. Zapiers Benchmark für Geschäftsautomatisierung, aus der öffentlichen Rangliste.
- Vending-Bench 2: 16.843 $, Platz 1. Andon Labs’ Langhorizont-Simulation eines Geschäftsbetriebs. Der Score ist der erzielte Geldbetrag, kein Prozentwert.
- Agents’ Last Exam v1.1: 75,8 %. Selbst berechnet auf dem 122-Aufgaben-Set innerhalb von Antigravity-CLI 1.4.8 mit einem 5-Stunden-Fenster pro Lauf. Opus 5.5’s Score stammt von der öffentlichen Rangliste und der von GPT-6.2 Sol aus seiner System Card – die Setups unterscheiden sich also.
- Chartography: 73,5 %. Das Lesen dichter professioneller Diagramme, selbst berechnet ohne Tools.
Für Wissenschaft und Mathematik erzielt Neon 70,5 % bei Terminal-Bench Science (selbst berechnet, gemittelt über 5 Versuche), 84,0 % bei RiemannBench und 71,3 % bei HLE-Diamond (aus der Artificial-Analysis-Rangliste).
Wie Google die Zahlen ermittelt hat
Vier Regeln aus der Methodik verändern, wie du die Tabelle lesen solltest:
- Standardmäßig die höchste Denkstufe. „Alle Ergebnisse wurden mit der Gemini API mit den höchsten Denk-Einstellungen ausgeführt, sofern nicht anders angegeben.“ Das ist
xhigh. Nur FrontierCode 2.0 ist ausdrücklich mithighgekennzeichnet. Produktivaufrufe verwenden standardmäßighigh, also rechne mit weniger Denk-Tokens und möglicherweise niedrigeren Scores als in der Tabelle. - Pass@1, ein einziger Versuch. Kein Majority Voting und kein paralleles Test-Time-Compute, außer wo angegeben (Terminal-Bench Science mittelt über 5 Versuche).
- Konkurrenzwerte sind selbst berichtet. Nicht-Gemini-Scores stammen von den jeweiligen Anbietern, sofern nicht anders angegeben. Opus 5.5 und GPT-6.2 Sol verwenden ihre maximale Reasoning-Einstellung, wo verfügbar.
- Sicherheitsfilter an, außer bei Cyber. Die Cybersicherheits-Zeilen liefen mit deaktivierten Filtern.
Unser Leitfaden zu den Denkstufen behandelt, wann xhigh seine zusätzlichen Tokens wert ist.
Kosten pro Aufgabe: Was die 32-%-Aussage bedeutet
Kosten pro Aufgabe sind die Gesamtausgaben, um eine Benchmark-Aufgabe abzuschließen, nicht der Preis pro Token. Ein Modell mit einem höheren Token-Preis kann pro Aufgabe dennoch weniger kosten, wenn es die Antwort in weniger Schritten und mit weniger Denk-Tokens erreicht.
Google macht drei Kostenaussagen:
| Aussage | Denkstufe | Verglichen mit |
|---|---|---|
| 32 % niedrigere Kosten pro Aufgabe bei einem hohen AA Intelligence Index Score | high |
Gemini 4 Carbon |
| Etwa 50 % bis 80 % niedrigere Kosten pro Aufgabe im Vals Index und Agent Arena | high |
Den führenden konkurrierenden Frontier-Modellen |
| 36 %+ niedrigere Kosten pro Aufgabe | xhigh |
Konkurrierenden Modellen auf ihrer höchsten Einstellung |
Beachte die Diskrepanz: Die Genauigkeitswerte verwenden überwiegend xhigh, während die vielzitierte Einsparung von 32 % bei high gilt. Beides ist wahr, aber nicht gleichzeitig. Du bekommst entweder die Kostenersparnis oder den Spitzenwert – und die Lücke dazwischen musst du selbst messen.
So schätzt du deine eigenen Kosten pro Aufgabe. Denk-Tokens werden als Output abgerechnet.
$$\text{cost} = \frac{\text{input} \times 3 + \text{cached input} \times 0.15 + \text{output} \times 15}{1{,}000{,}000}$$
Eine Coding-Aufgabe mit 20.000 Input-Tokens und 4.000 Output-Tokens kostet 0,06 $ + 0,06 $ = 0,12 $. Wenn 15.000 dieser Input-Tokens aus dem Cache kommen, sinkt es auf 0,015 $ + 0,00225 $ + 0,06 $ = etwa 0,077 $. Führst du dieselbe Aufgabe mit xhigh aus, ändert sich vor allem die Output-Menge – logge also Tokens pro Stufe, nicht nur Bestanden oder Fehlgeschlagen. Unsere Preisübersicht zu Gemini 4 Neon behandelt Batch-, Flex- und Priority-Tarife.
Cyber- und Sicherheitswerte
Die Cyber-Scores stammen aus „Gemini 4 Neon for cyber“, das vertrauenswürdigen Verteidigern über das Fairwind-Programm statt über die öffentliche API zugänglich ist.
| Benchmark | Score | Anmerkung |
|---|---|---|
| SEC-bench Pro | 90,5 % | State of the Art, etwa die Hälfte der Kosten pro Challenge |
| WebExploitBench v1.2 | 51,26 % | State of the Art, die Hälfte der Kosten großer Modelle |
| AutoBaxBench (Hard-Tier) | 76 % | State of the Art, sichererer Code als Carbon in jedem Tier |
| CWE-bench v2 | 70,7 % | 3,4 % Verbesserung gegenüber Carbon |
| ExploitGym | Nicht angegeben | Frontier-Niveau mit der Hälfte der Tokens von Carbon |
Sicherheitszahlen aus demselben Post: Neon lehnte 1,98 % der Terminal-Bench-4.0-Aufgaben ab, erzielte 0,0 % Cheating bei Terminal-Bench 4.0, nahm bei 2,45 % von Googles Coding-Cheating-Evaluation Abkürzungen und bestand 99,2 % seiner Agent-Honesty-Evaluation. Mit Echtzeit-Schutzmaßnahmen auf seiner höchsten Denkstufe widerstand es jedem Angriff in Gray Swans Benchmark für indirekte Prompt-Injection.
Wo Neon nicht führt
Neon ist nicht überall Erster, und Google sagt das auch:
- Artificial Analysis Intelligence Index: Platz 3 insgesamt, „knapp hinter größeren, langsameren Modellen“.
- Vals Index: Platz 2, nicht Platz 1.
- Agent Arena Index: Platz 2.
Google verweist für seine schwierigsten Langhorizont-Projekte weiterhin auf Carbon. Wenn du zwischen den drei Gemini-4-Modellen wählst, zeigt unser Vergleich Neon vs. Carbon vs. Hydrogen die Abwägungen, und der Beitrag zu den Gemini-4-Argon-Benchmarks zeigt, wie die Tabelle des früheren Modells zu lesen war.
Benchmarke Gemini 4 Neon selbst mit der Apidog CLI
Ranglisten beschreiben Googles Harness, nicht dein Produkt. Der schnellste Weg herauszufinden, ob Neon seinen Preis wert ist: Lass deinen Coding-Agenten dieselben Prompts mit high und xhigh ausführen und Tokens sowie Latenz für jede Stufe protokollieren.
Für Neon gibt es keinen kostenlosen API-Tarif, du benötigst also einen bezahlten Gemini-API-Schlüssel. Diese Anfrage folgt Googles dokumentiertem Interactions-API-Format; wir haben sie für diesen Beitrag nicht live ausgeführt:
curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "gemini-4-neon", "input": "Find the race condition in this retry queue.", "generation_config": {"thinking_level": "high"}}'
Die Apidog CLI ermöglicht es Claude Code, Codex, Cursor oder OpenCode, API-Tests direkt im Terminal zu erstellen und auszuführen. Einmal einrichten:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Dann gib deinem Agenten einen Prompt:
In Apidog project <id>, create a Gemini API environment with GEMINI_API_KEY
and THINKING variables. Add a test case for POST /v1beta/interactions on
gemini-4-neon that sends my 10 eval prompts from prompts.csv, asserts HTTP 200
and a non-empty output, and records token usage and response time. Run it at
THINKING=high and THINKING=xhigh and compare cost per task at $3/$15 per 1M.
Der Agent erstellt die Umgebung, prüft die Testfall-Payload gegen ihr Schema und führt sie dann einmal pro Denkstufe aus:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "THINKING=high" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "THINKING=xhigh" -r cli,json
Füge --timeout-request 900000 hinzu, wenn deine Prompts lang sind, da schwierige xhigh-Läufe mehrere Minuten dauern können. Um den Vergleich bei jeder Prompt-Änderung erneut auszuführen, pack dasselbe apidog run ... -r junit in die CI mit dem Apidog-CLI-CI/CD-Leitfaden, oder starte mit Apidog CLI in Claude Code. Der Free-Tarif von Apidog deckt bis zu 4 Nutzer ab.
FAQ
Was ist Gemini 4 Neons bestes Benchmark-Ergebnis? Platz 1 im Artificial Analysis Coding Agent Index mit 58,6, dazu Platz 1 bei AutomationBench (56,3 %) und Vending-Bench 2 (16.843 $).
Mit welcher Denkstufe wurden die Benchmarks ausgeführt? Überwiegend mit xhigh, der höchsten Einstellung. Googles Methodik besagt, dass die Ergebnisse die höchsten Denk-Einstellungen verwenden, sofern nicht anders angegeben; FrontierCode 2.0 (46,2 %) ist als Standardstufe high gekennzeichnet.
Ist Gemini 4 Neon pro Aufgabe günstiger als Carbon? Google gibt 32 % niedrigere Kosten pro Aufgabe bei high an. Das ist ein Pro-Aufgabe-Wert aus Benchmark-Läufen – bestätige ihn also mit deinen eigenen Prompts, bevor du Traffic umstellst.
Warum erzielt Neon 39,0 % und 12,8 % bei SWE-sweep? Unterschiedliche Harnesses. 39,0 % sind innerhalb von Google Antigravity, das Sub-Agenten über die Codebasis verteilt; 12,8 % sind der einfachere mini-SWE-Agent.
Sind die Benchmarks von Gemini 4 Neon unabhängig? Teilweise. Die Zeilen von Artificial Analysis, Vals, Arena, AutomationBench und FrontierCode stammen von Dritten. SWE-sweep, Agents’ Last Exam und Terminal-Bench Science wurden von Google selbst berechnet.