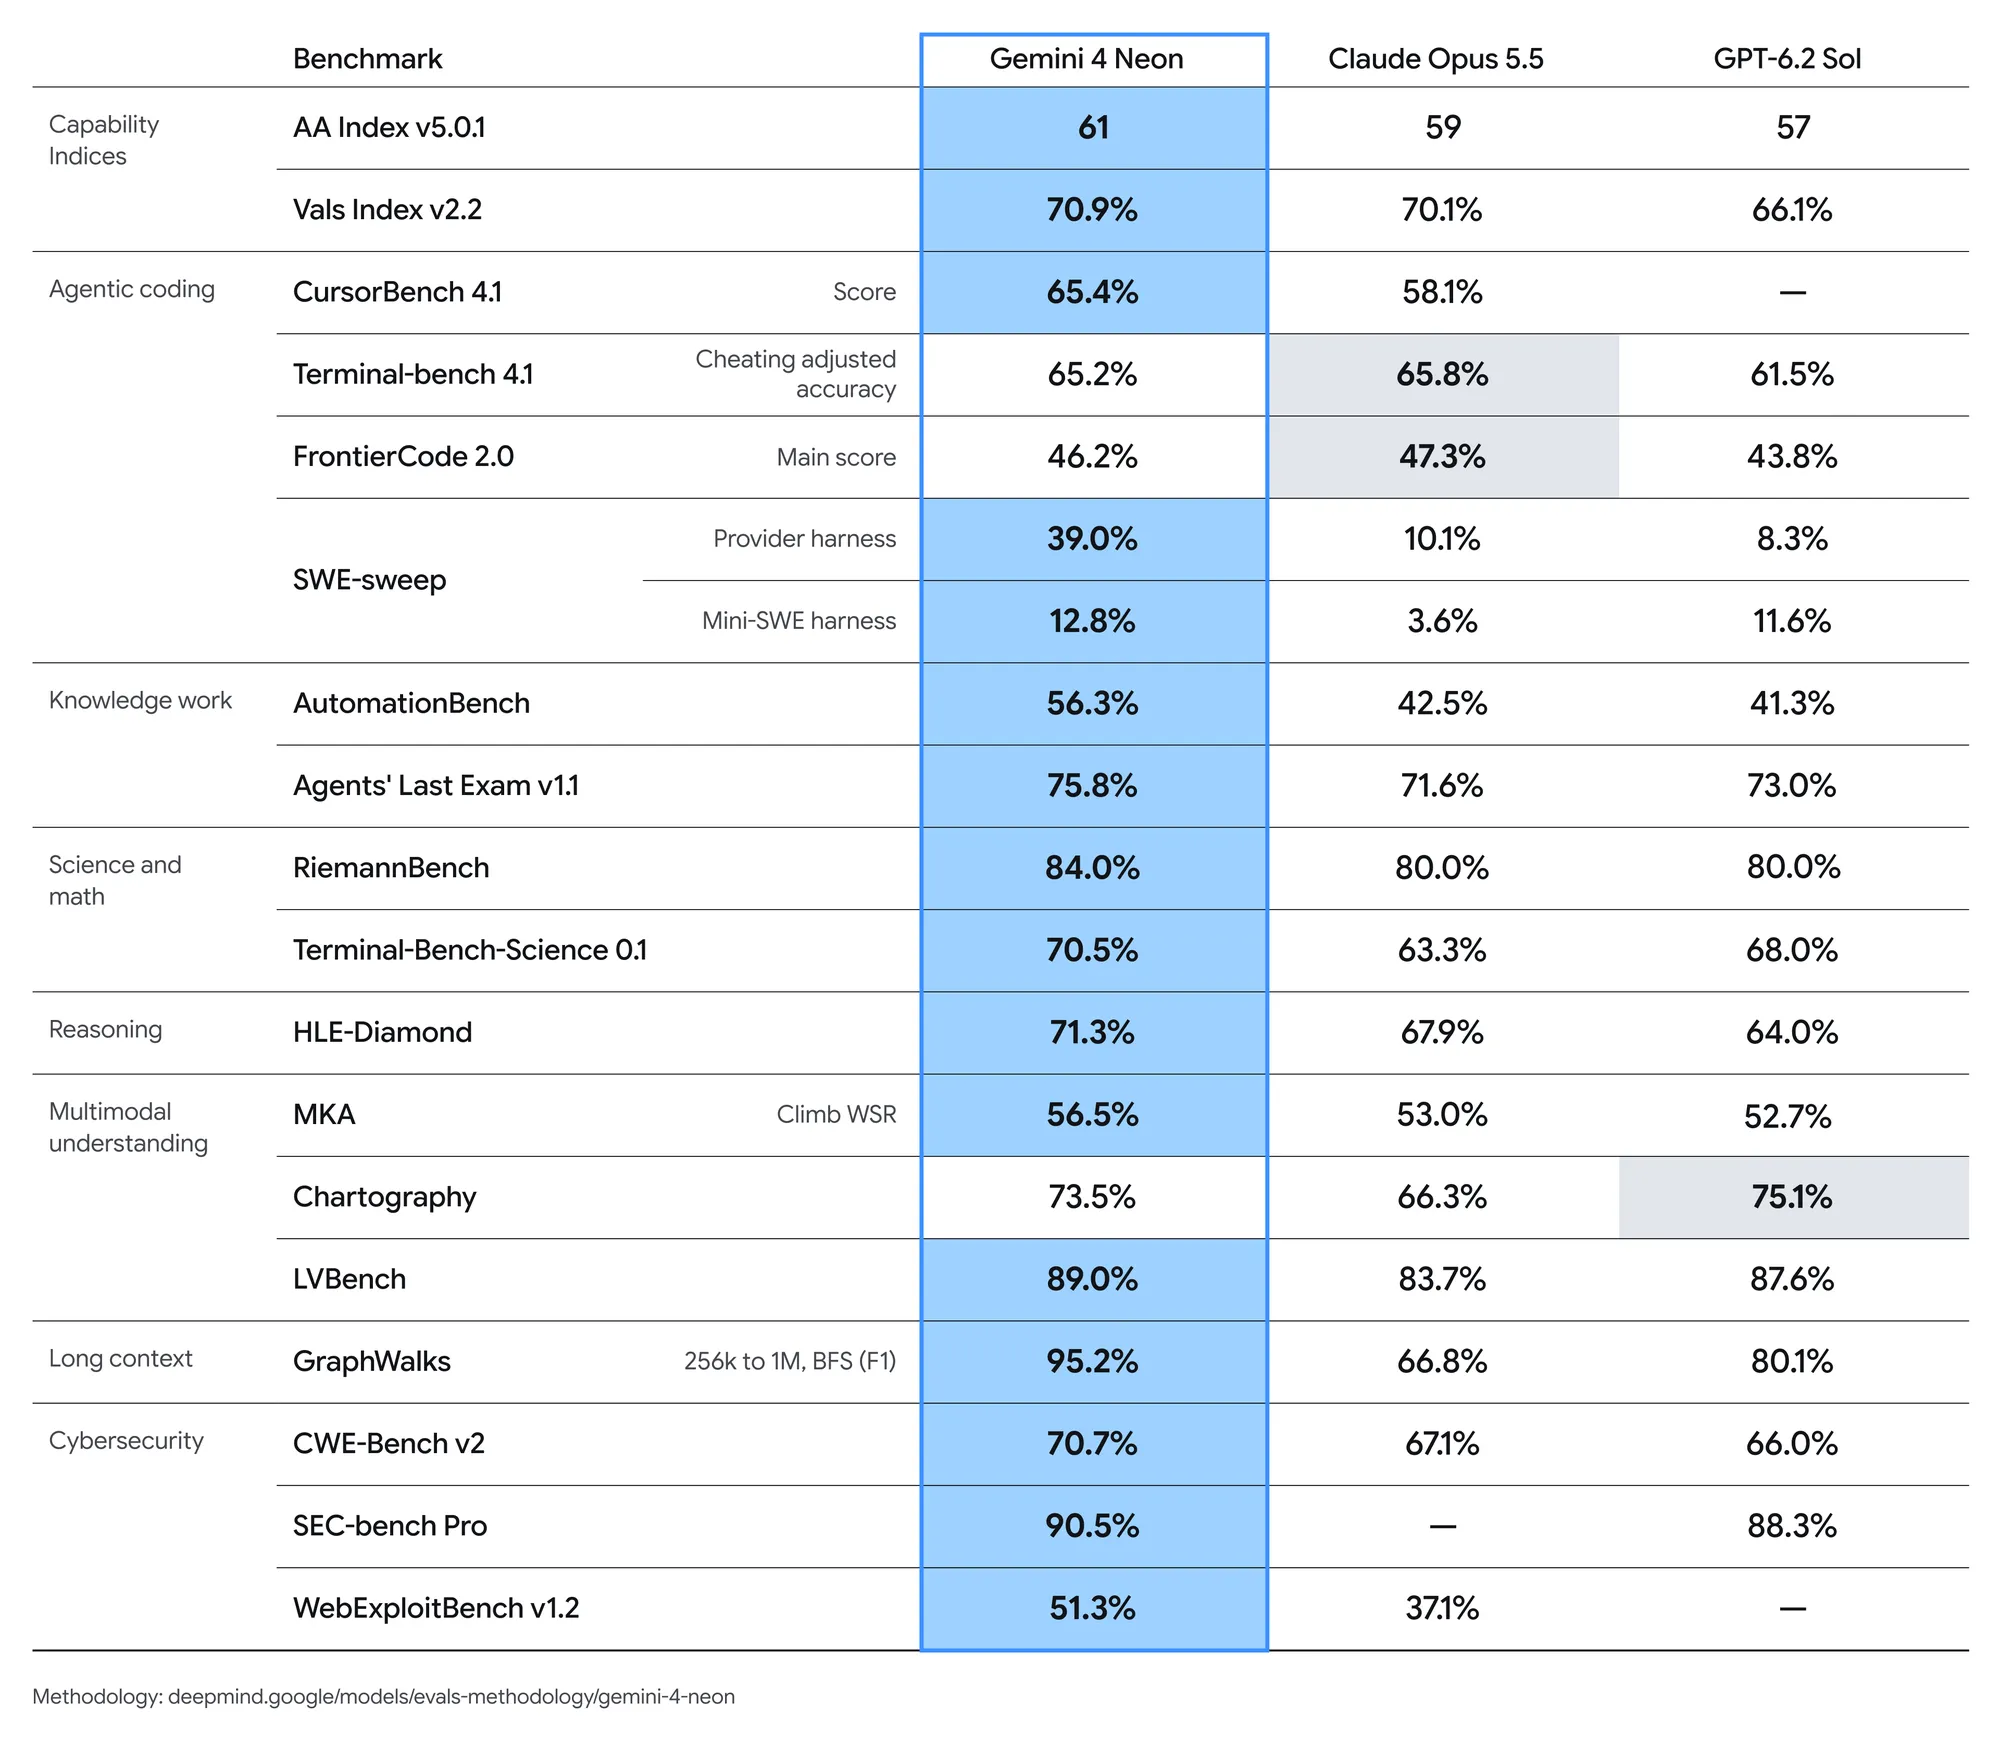
Die Gemini 4 Neon API verwendet die Modell-ID gemini-4-neon. Sie rufen sie mit einem POST an https://generativelanguage.googleapis.com/v1beta/interactions auf, mit Ihrem Schlüssel im Header x-goog-api-key sowie model und input im JSON-Body. Das Modell läuft ausschließlich in der kostenpflichtigen Stufe, zu 3 $ pro Million Eingabe-Tokens und 15 $ pro Million Ausgabe-Tokens, und nutzt standardmäßig die Denkebene high.
Dieser Leitfaden behandelt, was bei Neon anders ist: die Einrichtung in der kostenpflichtigen Stufe, den Wechsel von einem anderen Gemini-4-Modell, Ausgaben von mehr als 64K Tokens, die Kombination von Neon mit Hydrogen und die Kostenkontrolle. Alle Feldnamen stammen aus Googles Dokumentation.
Was brauchen Sie, bevor Sie Ihren ersten Gemini 4 Neon API-Aufruf starten?
Sie brauchen einen Gemini API-Schlüssel in einem Projekt mit aktivierter Abrechnung, die Modell-ID gemini-4-neon und den Interactions-Endpunkt. Google hat Neon am 18. November 2026 veröffentlicht, als mittleres Modell der Gemini-4-Familie, zwischen Hydrogen und Carbon.
| Element | Wert |
|---|---|
| Modell-ID | gemini-4-neon |
| Endpunkt | POST /v1beta/interactions auf generativelanguage.googleapis.com |
| Auth-Header | x-goog-api-key: $GEMINI_API_KEY |
| APIs | Interactions API und generateContent |
| Denkebenen | low, medium, high (Standard), xhigh |
| Kontextfenster | 1.048.576 Tokens, gemeinsame Nutzung durch Eingabe, Denken und Ausgabe |
| Ausgabe pro synchronem Durchlauf | 65.536 Tokens |
| Long Decode | Bis zu 1.048.576 Tokens minus Ihrer Eingabe |
| Free Tier | Nein |
| Paid-Preis | 3,00 $ / 1M Eingabe, 15,00 $ / 1M Ausgabe (Denken inbegriffen) |
| Cached Input | 0,15 $ / 1M über implizites Caching |
Für PDFs, Function Calling und Streaming entsprechen die Request-Formate unserem Gemini 4 Hydrogen API-Leitfaden; tauschen Sie einfach die Modell-ID aus.
Wie bekommen Sie einen Gemini API-Schlüssel, der mit Neon funktioniert?
Neon ist nicht im Free Tier enthalten, ein Schlüssel allein reicht also nicht aus. Das Projekt dahinter braucht eine aktivierte Abrechnung.
- Öffnen Sie die API-Keys-Seite in Google AI Studio und erstellen Sie einen Schlüssel, oder verwenden Sie einen bereits vorhandenen.
- Stellen Sie sicher, dass das Projekt des Schlüssels in der kostenpflichtigen Stufe ist. Googles Leitfaden sagt es klar und deutlich: „Neon is available on the paid tier only (not on the free tier).“
- Exportieren Sie den Schlüssel:
export GEMINI_API_KEY="YOUR_API_KEY". Die Google GenAI SDKs lesen ihn automatisch aus. - Prüfen Sie Ihre Rate-Limits in der kostenpflichtigen Stufe auf der Rate-Limits-Seite, bevor Sie einen großen Batch planen. [VERIFY: Neons RPM- und TPM-Zahlen pro Stufe]
Wie senden Sie Ihre erste Gemini 4 Neon API-Anfrage?
Senden Sie model und input an den Interactions-Endpunkt. Das ist das Format aus Googles Quickstart:
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Review this Go handler for missing error checks and suggest fixes."
  }'
Derselbe Aufruf mit dem Python SDK (pip install -U google-genai):
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Review this Go handler for missing error checks and suggest fixes.",
)

print(interaction.output_text)
print(interaction.usage)
Lesen Sie usage bei jeder Antwort, solange Sie testen: Denking-Tokens werden zum Ausgabepreis von 15 $ abgerechnet, daher liegt hier der Kostenpunkt.
Diese Snippets folgen Googles Leitfaden. Wir haben sie für diesen Beitrag nicht ausgeführt – prüfen Sie daher das Antwortformat anhand Ihres ersten eigenen Aufrufs.
Was ändert sich, wenn Sie von Hydrogen oder Carbon wechseln?
Wenn Sie bereits ein anderes Gemini-4-Modell einsetzen, erfordert der Wechsel keine Änderungen am Request-Schema. Ändern Sie den model-String und prüfen Sie drei Dinge:
| Prüfpunkt | Neon | Hydrogen | Carbon und Argon |
|---|---|---|---|
| Standard-Denkebene | high |
high |
medium |
| Höchste Ebene | xhigh |
xhigh |
high |
| Eingabe / Ausgabe pro 1M | 3 $ / 15 $ | 1,50 $ / 7,50 $ | Siehe Carbon-Preise |
Wenn Sie von Carbon oder Argon kommen, bedeutet der Standard-Wechsel von medium auf high mehr Denking-Tokens bei derselben Eingabe. Setzen Sie thinking_level explizit, wenn Sie das alte Verhalten beibehalten möchten:
interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Audit this payment retry queue for race conditions.",
    generation_config={"thinking_level": "medium"},
)
Wenn Sie von Gemini 3.8 Flash oder älter kommen, ist die Liste länger. Laut Googles Migrations-Checkliste:
- Heben Sie niedrige Ausgabe-Limits an.
max_output_tokensumfasst Denken und Antwort zusammen. Entfernen Sie fest kodierte Limits wie 8.192 oder erhöhen Sie sie auf 65.536, und senken Sie die Denkebene, wenn Sie weniger verbrauchen müssen. - Verwerfen Sie
minimal. Neon lehnt es mit einem Fehler ab. - Entfernen Sie Sampling-Parameter. Der Server ignoriert in-range-Werte für
temperature,top_pundtop_k; außerhalb des gültigen Bereichs liefert er einen400. - Verlassen Sie sich nicht mehr auf explizites Caching. Neon unterstützt weder
cachedContentsnochcaches.create– entfernen Sie dahercached_content-Felder. - Deklarieren Sie Tools nativ. Das Auffordern zu rohen JSON-Tool-Aufrufen ohne deklarierte Tools kann einen
MALFORMED_FUNCTION_CALLzurückgeben. Verwenden Sie Function Calling oder strukturierte Ausgaben.
Wie bekommen Sie mehr als 64K Tokens aus Neon heraus?
Eine synchrone Anfrage stoppt bei 65.536 Tokens, mit oder ohne Streaming. Für längere Ausgaben – etwa eine vollständige Migrationsspezifikation samt Testsuite – setzen Sie background auf true und erhöhen max_output_tokens über 65.536. Googles Server generieren dann in 64K-Token-Schritten weiter, bis Ihr Limit erreicht ist.
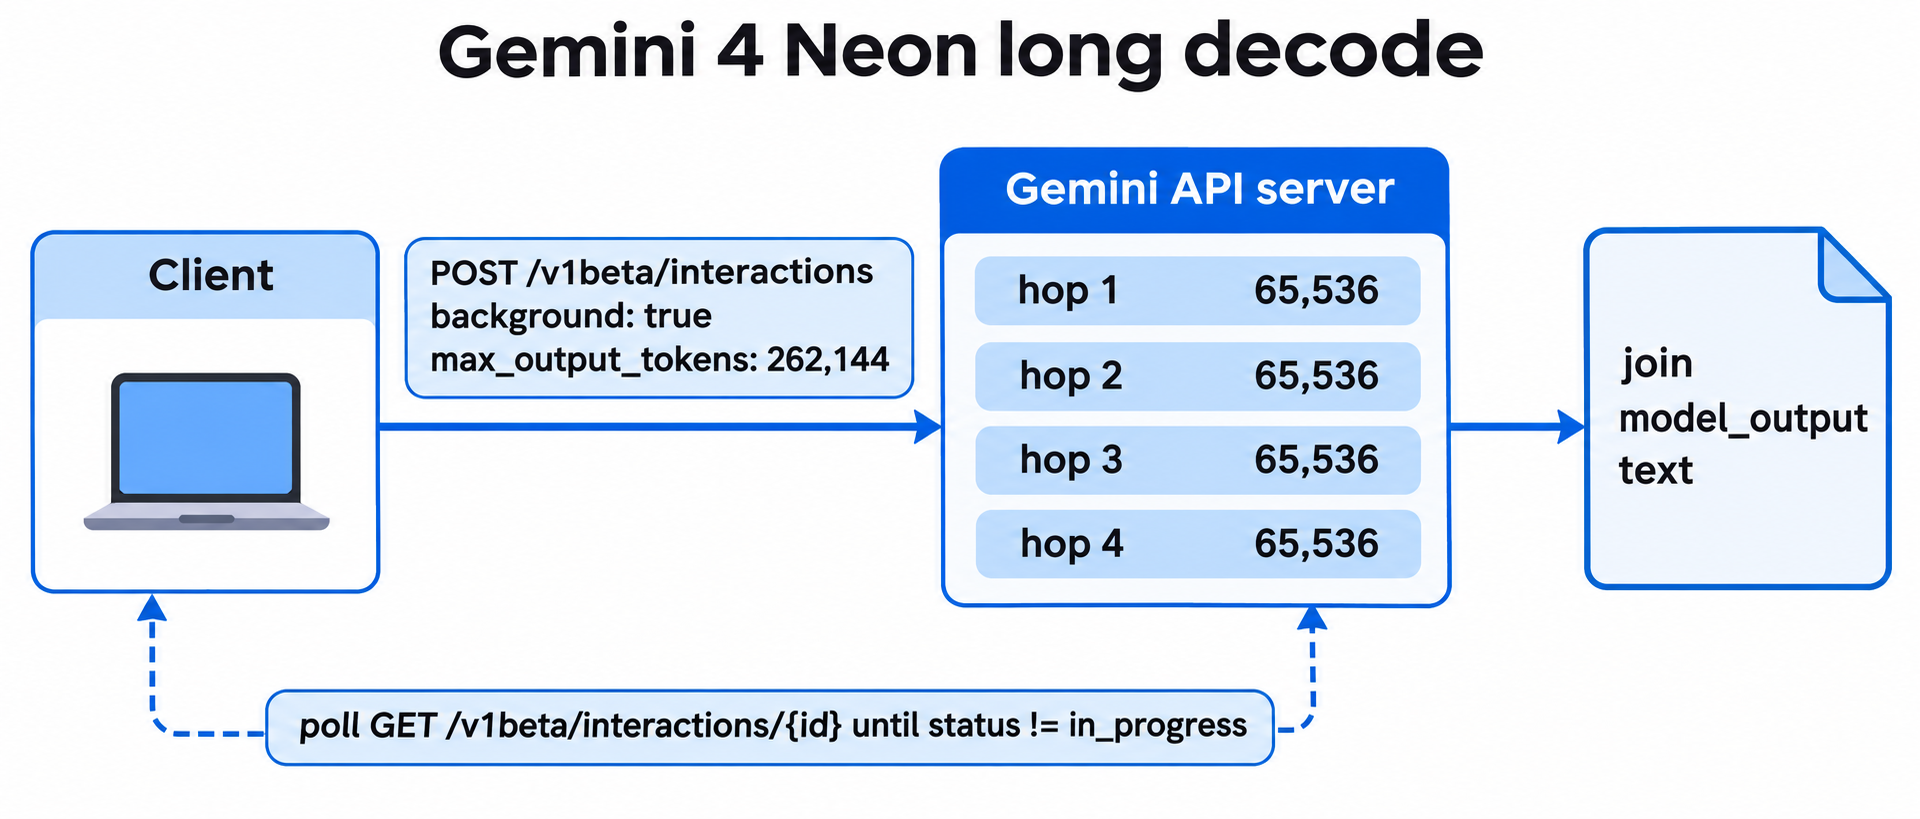
Starten Sie den Job und merken Sie sich seine id:
export ID=$(curl -s -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-4-neon",
    "input": "Generate a complete multi-module migration specification and test suite for this service.",
    "background": true,
    "generation_config": {
      "max_output_tokens": 262144,
      "thinking_level": "high"
    }
  }' | jq -r '.id')
Dann pollen Sie, bis der Job abgeschlossen ist, und fügen den Text aller Durchläufe zusammen (Python, mit der exportierten ID):
import os, time

interaction = client.interactions.get(id=os.environ["ID"])
while interaction.status in ("in_progress", "queued"):
    time.sleep(5)
    interaction = client.interactions.get(id=interaction.id)

text = "".join(
    c.text
    for step in interaction.steps if step.type == "model_output"
    for c in step.content if c.type == "text"
)
Drei Regeln aus Googles Leitfaden verhindern, dass hier etwas schiefgeht:
- Wenn Sie
backgroundohnemax_output_tokenssetzen, stoppt der Server bei 65.536 Tokens. - Das Limit kann bis zu 1.048.576 minus Ihrer Eingabe-Tokens betragen. Google empfiehlt 131.072 oder 262.144 für lange, mehrstufige Aufgaben.
- Anspruchsvolle Prompts können mehrere Minuten laufen. Verwenden Sie den Hintergrundmodus oder setzen Sie die Timeouts Ihres HTTP-Clients auf mindestens 15 Minuten.
Wenn Sie Interaktionen nicht auf Googles Seite speichern möchten, dokumentiert der Long-Decode-Leitfaden auch die clientseitige Fortsetzung in den neuesten SDKs.
Wie kombinieren Sie Neon mit Hydrogen?
Nutzen Sie Neon für das Urteilsvermögen und Hydrogen für das Volumen. Neon plant oder prüft einen Workflow, danach übergeben Sie seine Interaktions-id als previous_interaction_id an einen gemini-4-hydrogen-Aufruf, der einen einzelnen Schritt ausführt. Googles Cloud-Entwicklerleitfaden zeigt das Muster:
plan = client.interactions.create(
    model="gemini-4-neon",
    input="Design a 3-step plan to migrate our REST order service to gRPC in Go.",
    store=True,
)

step = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Implement step 1 (.proto service definition) from the plan.",
    previous_interaction_id=plan.id,
)
print(step.output_text)
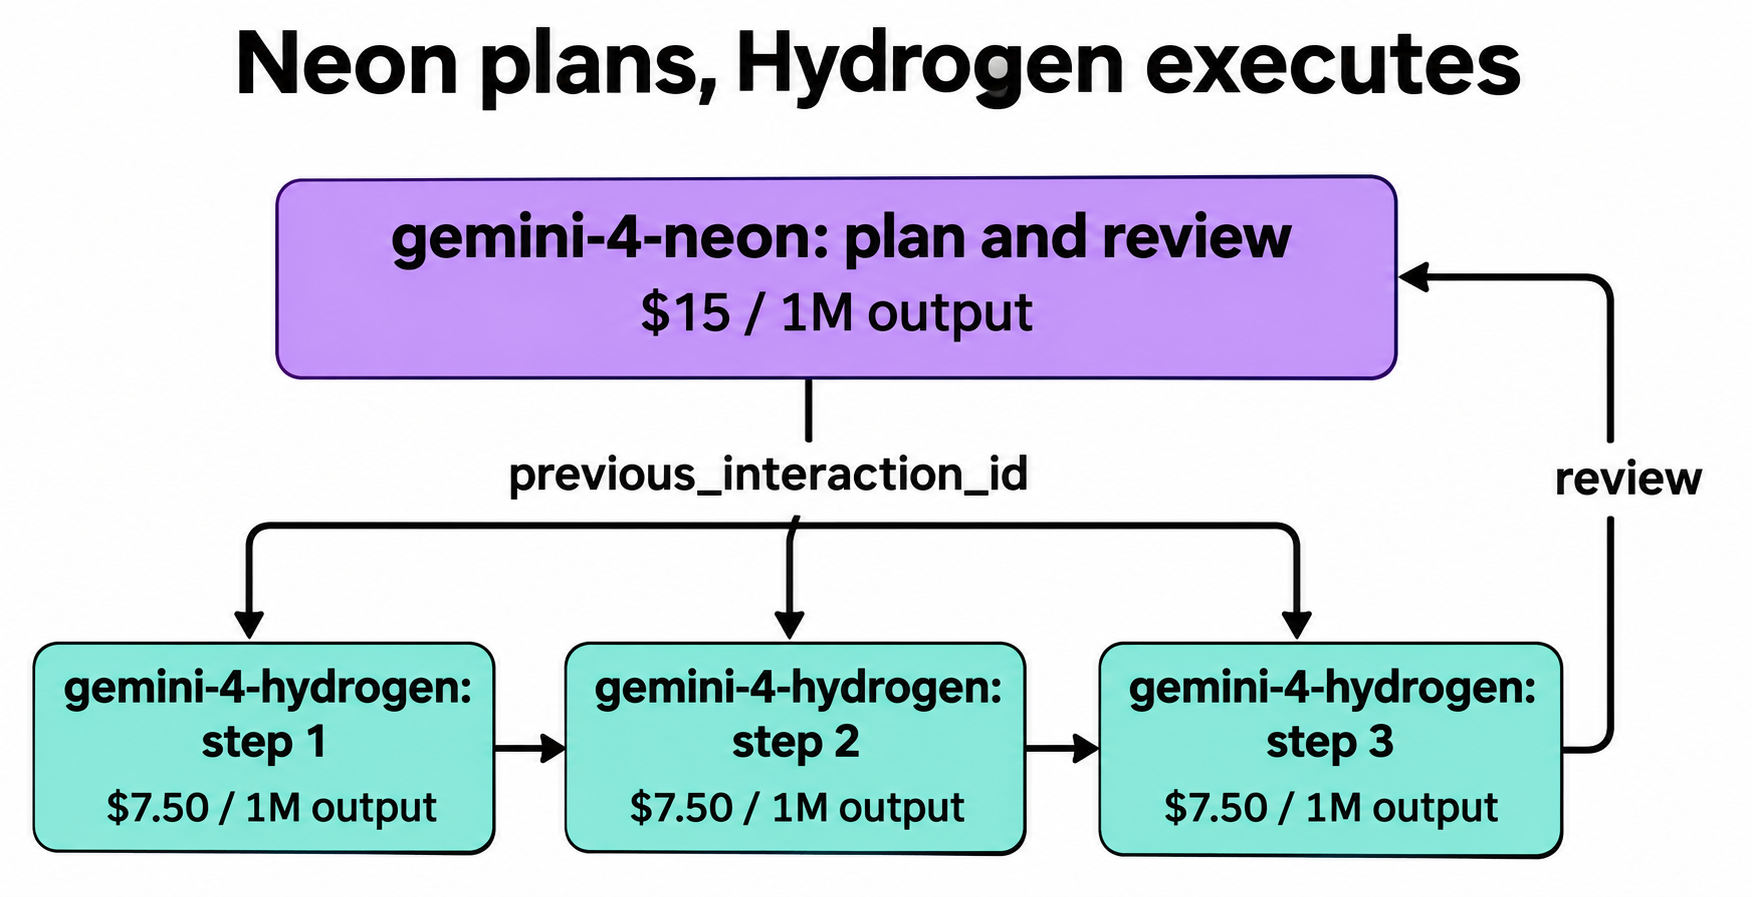
Jedes Ausgabe-Token, das Hydrogen statt Neon schreibt, kostet nur die Hälfte. Unser Gemini 4 Hydrogen Orchestrator-Leitfaden zeigt dieselbe Schleife mit Carbon als Planer.
Wie senken Sie die Kosten der Gemini 4 Neon API?
Vier Hebel, in der Reihenfolge, in der sie sich meistens auszahlen:
- Wählen Sie die niedrigste Denkebene, die funktioniert. Google rät, Ihre Evaluierungen auf allen vier Ebenen mit einem hohen
max_output_tokenslaufen zu lassen und dann die niedrigstethinking_levelzu wählen, die Ihre Qualitätsanforderung erfüllt. - Verwenden Sie lange Prompts wieder. Implizites Caching greift standardmäßig bei Prompts ab 4.096 Tokens und senkt die Kosten für gecachte Eingaben um 95 %, von 3,00 $ auf 0,15 $ pro Million. Platzieren Sie den langen, stabilen Teil Ihres Prompts (Systemtext, Dokumentation, Schemas) am Anfang.
- Überlassen Sie die Ausführung Hydrogen. Siehe das Kombinationsmuster oben.
- Zählen Sie alles mit. Google berechnet jedes Token, das das Modell verarbeitet, einschließlich Denking-Tokens und der internen Anweisungen, die bei Grounding hinzukommen. Grounding mit Google Search wird zusätzlich pro Abfrage abgerechnet.
Eine kurze Plausibilitätsprüfung: Ein Aufruf mit 20.000 Eingabe-Tokens und 8.000 Ausgabe-Tokens (Denken inbegriffen) kostet 0,06 $ für die Eingabe und 0,12 $ für die Ausgabe – also 0,18 $ zum Listenpreis.
Lassen Sie Ihren Coding-Agent Neon und Hydrogen mit Apidog CLI vergleichen
Ist Neon den doppelten Preis von Hydrogen bei Ihren Prompts wert? Lassen Sie Ihren Coding-Agent (Claude Code, Codex, Cursor) einen Testfall bauen und ihn mit Apidog CLI gegen beide Modelle laufen.
Richten Sie es einmal ein:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Dann geben Sie Ihrem Agent einen Prompt:
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and variables GEMINI_API_KEY,
MODEL (default "gemini-4-hydrogen") and THINKING (default "high"). Add an
endpoint for POST /v1beta/interactions with the x-goog-api-key header from
GEMINI_API_KEY. Create a test case that sends model {{MODEL}}, our code-review
prompt and generation_config.thinking_level {{THINKING}}, and asserts: HTTP 200,
status is "completed", a non-empty model_output step, and usage.total_tokens
exists. Run it for gemini-4-hydrogen and gemini-4-neon, then compare
usage.total_thought_tokens and usage.total_output_tokens.
Der Agent liest jedes Payload-Schema und validiert sein JSON, bevor er etwas schreibt:
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "MODEL=gemini-4-hydrogen" -r cli,json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "MODEL=gemini-4-neon" -r cli,json
Multiplizieren Sie die Tokens jedes Laufs mit dem jeweiligen Modellpreis, und Sie erhalten echte Kosten pro Aufgabe für Ihren Prompt – statt eines Durchschnittswerts aus einer Launch-Ankündigung. Ergänzen Sie --upload-report, um den Lauf in der Apidog-App anzusehen, oder ersetzen Sie -r cli,json durch -r junit, um dieselbe Prüfung in CI einzubinden. Der Apidog CLI CI/CD-Leitfaden zeigt die Pipeline, und Apidog CLI in Claude Code erklärt die Agent-Einrichtung. Apidogs kostenloser Plan deckt bis zu 4 Nutzer ab.
FAQ
Was ist die Modell-ID von Gemini 4 Neon? gemini-4-neon. Sie funktioniert sowohl mit der Interactions API als auch mit generateContent.
Ist die Gemini 4 Neon API kostenlos? Nein. Neon ist ausschließlich in der kostenpflichtigen Stufe der Gemini API verfügbar, zu 3 $ pro Million Eingabe-Tokens und 15 $ pro Million Ausgabe-Tokens. Abonnenten von Google AI Pro und Ultra können es im AI Studio Chat ausprobieren.
Funktioniert mein Hydrogen-Code mit Neon? Ja. Google bestätigt, dass der Wechsel zwischen Gemini-4-Modellen keine Änderungen am Request-Schema erfordert. Aktualisieren Sie den model-String und entscheiden Sie dann, ob Sie die standardmäßige Denkebene high möchten.
Was ist die maximale Ausgabe der Gemini 4 Neon API? 65.536 Tokens pro synchroner Anfrage. Mit background auf true und einem höheren max_output_tokens kann Neon bis zum 1.048.576-Token-Fenster minus Ihrer Eingabe generieren.
Unterstützt Gemini 4 Neon temperature? Nein. Der Server ignoriert in-range-Werte für temperature, top_p und top_k und liefert für außerhalb des gültigen Bereichs liegende Werte einen 400. Verwenden Sie thinking_level, um Qualität gegen Geschwindigkeit und Kosten abzuwägen.
Unterstützt Neon explizites Kontext-Caching? Nein. Entfernen Sie cached_content aus Ihren Anfragen. Implizites Caching greift weiterhin automatisch bei Prompts ab 4.096 Tokens, mit 95 % Rabatt auf gecachte Eingaben.