
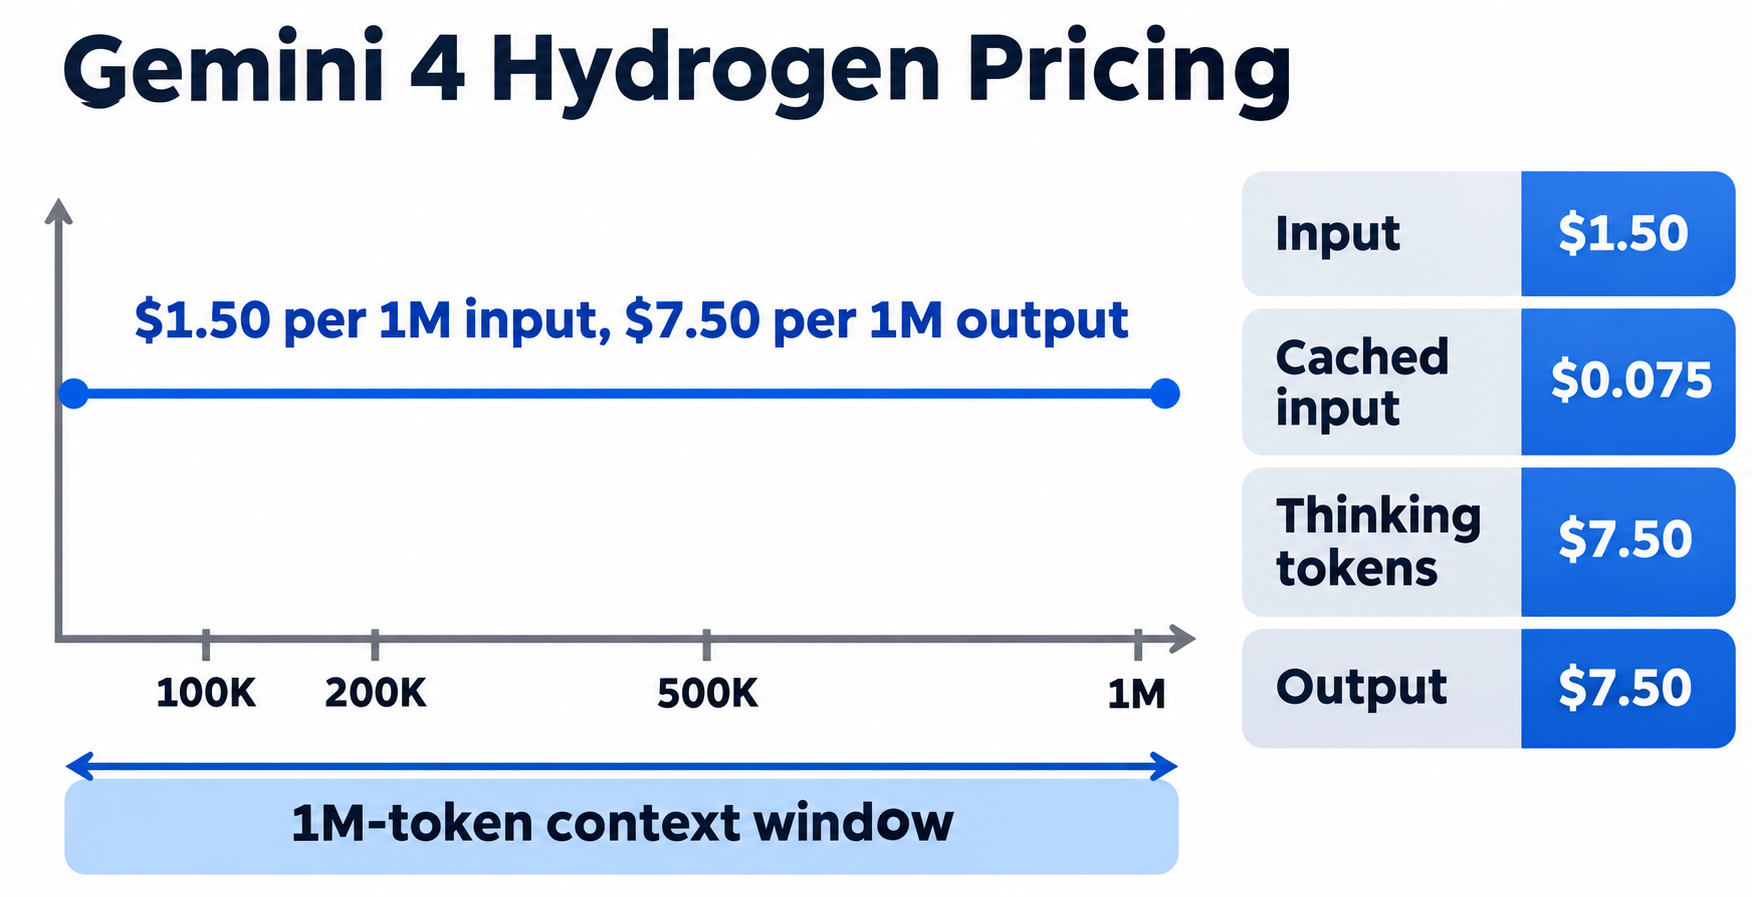
Die Preise für Gemini 4 Hydrogen liegen bei 1,50 $ pro 1M Input-Tokens und 7,50 $ pro 1M Output-Tokens im Standard-Tarif der Gemini API – einheitlich über das gesamte Kontextfenster von 1M Tokens. Thinking-Tokens werden zum Output-Preis abgerechnet, gecachte Inputs kosten 0,075 $ pro 1M, und Batch oder Flex halbiert jeden Preis.
Hydrogen, veröffentlicht am 12. November 2026, ist das schnelle Modell der Gemini-4-Familie. Im Gegensatz zu Carbon und Argon gibt es keinen Einführungspreis, der sich später verdoppelt, und es ist im Free Tier verfügbar. Im Folgenden: die Preistabelle, durchgerechnete Kostenbeispiele, wie Thinking-Level Ihre Rechnung beeinflussen und wie Sie Ihre eigenen Kosten messen. Neu bei diesem Modell? Beginnen Sie mit Was ist Gemini 4 Hydrogen.
Was kostet Gemini 4 Hydrogen pro 1M Tokens?
Gemini 4 Hydrogen (Modell-ID gemini-4-hydrogen hat auf der Preisseite von Google vier bezahlte Tarife. Alle Preise gelten pro 1M Tokens:
| Tarif | Input | Output inkl. Thinking | Gecachter Input | Free Tier |
|---|---|---|---|---|
| Standard | 1,50 $ | 7,50 $ | 0,075 $ | Kostenlos |
| Batch | 0,75 $ | 3,75 $ | 0,0375 $ | Nicht verfügbar |
| Flex | 0,75 $ | 3,75 $ | 0,0375 $ | Nicht verfügbar |
| Priority | 2,70 $ | 13,50 $ | 0,135 $ | Siehe Preisseite |
Drei Details auf derselben Seite beeinflussen Ihr Budget:
- Thinking wird abgerechnet. „Jedes Token, das das Modell verarbeitet, wird gezählt und abgerechnet, einschließlich Thinking-Tokens.“
- Nur implizites Caching. Explizites Caching wird nicht unterstützt; den reduzierten Preis erhalten Sie, wenn Googles impliziter Cache einen wiederholten Prompt-Präfix erkennt.
- Grounding kostet extra. Google Search Grounding umfasst 5.000 kostenlose Anfragen pro Monat, danach 14 $ pro 1.000.
Die Nutzung im Free Tier ist auf der Seite mit „Used to improve our products: Yes“ gekennzeichnet. Unser Leitfaden zu Gemini 4 Hydrogen kostenlos zeigt alle Gratis-Möglichkeiten.
Was bedeutet „einheitlicher Preis bis 1M Tokens“?
Es bedeutet: ein Preis für jede Prompt-Größe. In Googles Launch-Ankündigung heißt es, Hydrogen sei „zu einem einheitlichen Preis über das gesamte Kontextfenster von 1 Million Tokens hinweg abgerechnet: 1,50 $ pro Million Input-Tokens und 7,50 $ pro Million Output-Tokens.“ Ein 5K-Token-Prompt und ein 900K-Token-Prompt werden also zum selben Preis pro Token abgerechnet.
Nicht jedes Gemini-Modell funktioniert so: Gemini 3.1 Pro Preview kostet 2,00 $/12,00 $ pro 1M bis 200K Tokens und darüber 4,00 $/18,00 $.
Zwei Zahlen machen es konkret:
- Ein 900K-Token-Prompt (eine große Codebasis oder ein Stapel PDFs) kostet im Standard-Tarif 1,35 $ an Input, oder 0,0675 $, wenn der implizite Cache greift.
- Das Kontextfenster ist vereint: Input, Thinking und Output teilen sich 1.048.576 Tokens. Ein 900K-Prompt lässt etwa 148K Tokens für Thinking und Antwort zusammen.
Synchrone Antworten sind auf 65.536 Tokens begrenzt. Längere Ausgaben laufen über Long Decode, weiterhin zum Preis von 7,50 $ pro 1M.
Wie verändern Thinking-Level Ihre Gemini-4-Hydrogen-Rechnung?
Hydrogen unterstützt vier Thinking-Level: low, medium, high (Standard) und das neue xhigh. Sie setzen es mit generation_config.thinking_level. Der Preis pro Token ändert sich nie; die Anzahl der Thinking-Tokens schon, und diese werden zum Output-Preis abgerechnet.
Artificial Analysis hat seinen Intelligence Index auf jedem Level ausgeführt. Das sind die Ergebnisse:
| Thinking-Level | Index-Score | Erzeugte Tokens im Index | Kosten pro Index-Aufgabe |
|---|---|---|---|
| low | 27 | 20,3M | 0,29 $ |
| medium | 41 | 54,4M | 0,80 $ |
| high (Standard) | 51 | 110M | 1,87 $ |
| xhigh | 54 | 304M | 3,16 $ |
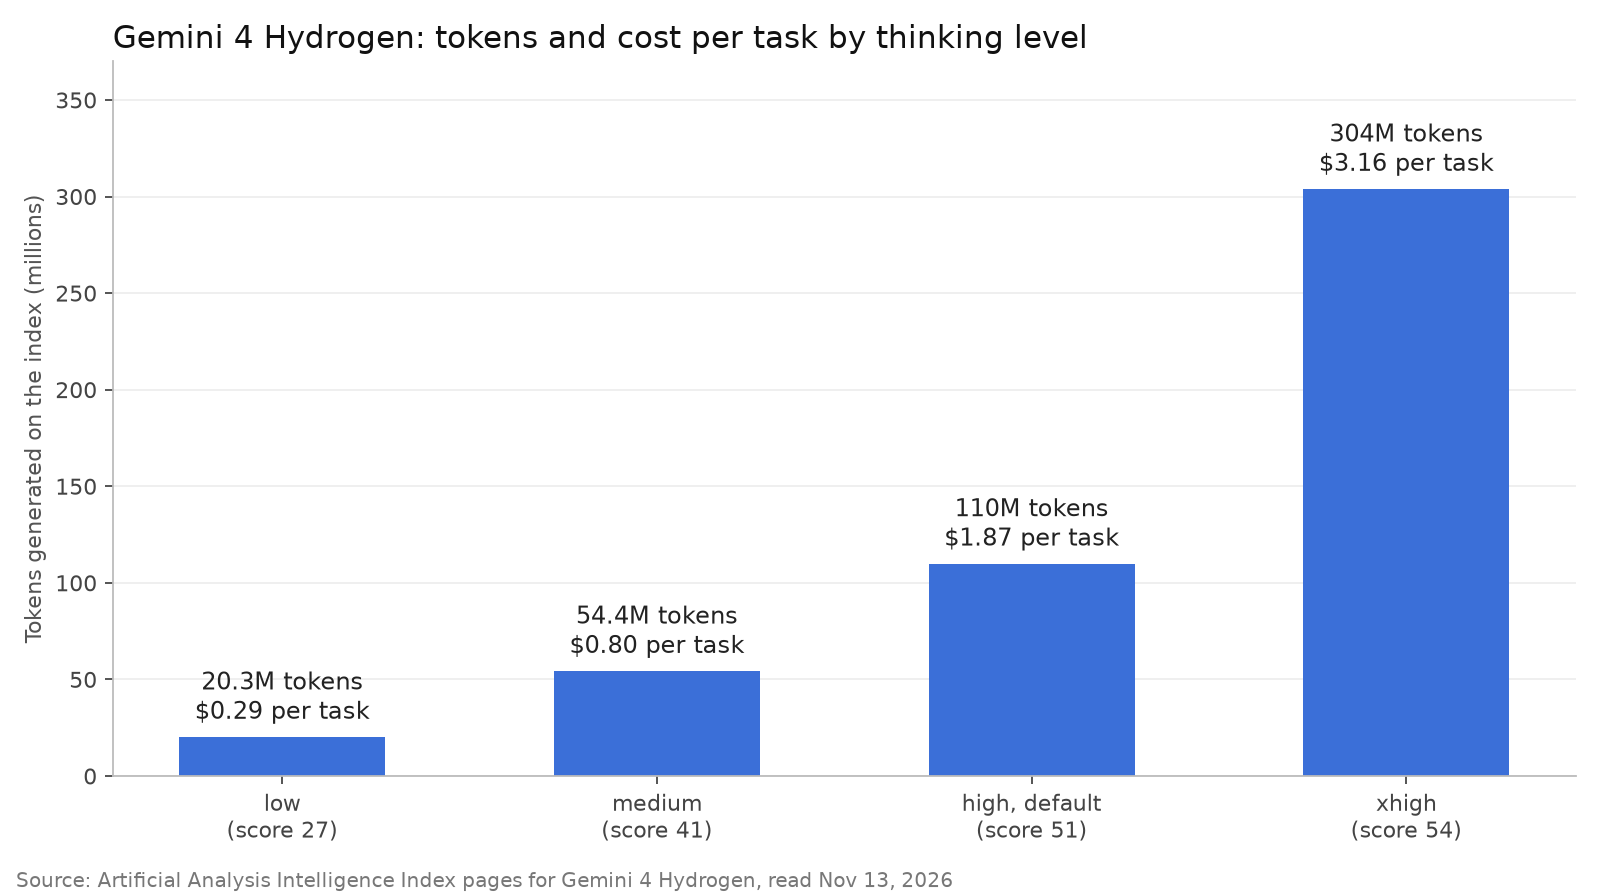
Lesen Sie die Tabelle als Verhältnisse. Der Wechsel von high auf xhigh erzeugte etwa das 2,8-fache an Tokens und erhöhte die Kosten pro Aufgabe um rund das 1,7-fache – für 3 Indexpunkte mehr. Ein Wechsel von high auf low reduzierte die Tokens auf weniger als ein Fünftel.
Googles Seite Neu in Gemini 4 Hydrogen warnt, dass xhigh „bei einfacheren Prompts zu Overthinking führen kann“, und empfiehlt, „den niedrigsten thinking_level zu wählen, der Ihre Qualitätsanforderungen erfüllt.“ Beachten Sie, dass max_output_tokens Thinking und Output zusammen begrenzt.
Was kostet ein einzelner Gemini-4-Hydrogen-Aufruf?
Jede Anfrage folgt einer Formel. Entnehmen Sie die Token-Zahlen dem usage-Objekt in der Antwort (total_input_tokens, total_cached_tokens, total_thought_tokens, total_output_tokens):
cost = (uncached_input x $1.50 / 1M)
     + (cached_input   x $0.075 / 1M)
     + ((thought + output) x $7.50 / 1M)
Die beiden folgenden Beispiele verwenden beispielhafte Token-Zahlen, keine Messwerte. Setzen Sie Ihre eigenen ein.
Beispiel 1: ein Chat-Aufruf auf high. 2.000 Input-Tokens, 1.500 Thinking-Tokens, 600 Output-Tokens.
| Position | Standard | Batch oder Flex |
|---|---|---|
| Input (2.000) | 0,0030 $ | 0,0015 $ |
| Thinking + Output (2.100) | 0,0158 $ | 0,0079 $ |
| Gesamt pro Aufruf | 0,0188 $ | 0,0094 $ |
| 10.000 Aufrufe pro Monat | 187,50 $ | 93,75 $ |
Beispiel 2: eine Agent-Schleife. Ein Coding-Agent läuft über 40 Runden. Er sendet die Konversation in jeder Runde erneut, liest also insgesamt 1,2M Input-Tokens, wobei 900K davon den impliziten Cache treffen. Er denkt über 200K Tokens nach und schreibt 60K Tokens an Code und Tool-Aufrufen.
| Position | Standard | Batch oder Flex | Priority |
|---|---|---|---|
| Nicht gecachter Input (300K) | 0,45 $ | 0,23 $ | 0,81 $ |
| Gecachter Input (900K) | 0,07 $ | 0,03 $ | 0,12 $ |
| Thinking + Output (260K) | 1,95 $ | 0,98 $ | 3,51 $ |
| Gesamt pro Durchlauf | 2,47 $ | 1,23 $ | 4,44 $ |
Rund 79 % der Standard-Rechnung entfallen auf Thinking und Output – das Thinking-Level zählt also mehr als das Kürzen Ihres Prompts. Der Anfrage-Code für beide Beispiele steht in unserem Gemini 4 Hydrogen API-Leitfaden.
Wie schneiden die Hydrogen-Preise im Vergleich zu Carbon, Argon und Gemini 3.8 Flash ab?
Die Standard-Tarife pro 1M Tokens laut Googles Preisseite, abgerufen am 13. November 2026:
| Modell | Input | Output | Gecachter Input | Free Tier |
|---|---|---|---|---|
| Gemini 4 Hydrogen | 1,50 $ | 7,50 $ | 0,075 $ | Ja |
| Gemini 4 Carbon (bis 30. Nov.) | 2,00 $ | 10,00 $ | 0,10 $ | Nein |
| Gemini 4 Carbon (ab 1. Dez.) | 4,00 $ | 20,00 $ | 0,20 $ | Nein |
| Gemini 4 Argon (bis 30. Nov.) | 2,00 $ | 10,00 $ | 0,10 $ | Nein |
| Gemini 4 Argon (ab 1. Dez.) | 4,00 $ | 20,00 $ | 0,20 $ | Nein |
| Gemini 3.8 Flash (bis 31. Dez.) | 0,75 $ | 3,75 $ | 0,075 $ | Ja |
| Gemini 3.8 Flash (ab 1. Jan. 2027) | 1,50 $ | 7,50 $ | 0,15 $ | Ja |
Rechnen Sie die Token-Zahlen der Agent-Schleife aus Beispiel 2 durch jeden Preis, erhalten Sie 2,47 $ bei Hydrogen, 3,29 $ bei Carbon oder Argon in diesem Monat und 6,58 $ ab dem 1. Dezember sowie 1,27 $ bei Gemini 3.8 Flash bis zum 31. Dezember. Sobald Flashs Preis am 1. Januar 2027 steigt, kosten dieselben Tokens bei Flash 2,54 $ – etwas mehr als bei Hydrogen, da Flashs gecachter Preis auf 0,15 $ verdoppelt. Details zur Preisänderung der Frontier-Modelle finden Sie in unseren Leitfäden zu Gemini 4 Carbon Preise und Gemini 4 Argon Preise.
Die echten Vergleichszahlen sind allerdings nicht „dieselben Tokens“, denn jedes Modell verbraucht pro Aufgabe eine unterschiedliche Anzahl an Tokens. Die Intelligence-Index-Seiten von Artificial Analysis bieten eine Perspektive:
| Modell (Thinking-Level) | Index-Score | Erzeugte Tokens | Kosten pro Index-Aufgabe |
|---|---|---|---|
| Gemini 4 Hydrogen (high) | 51 | 110M | 1,87 $ |
| Gemini 4 Hydrogen (xhigh) | 54 | 304M | 3,16 $ |
| Gemini 4 Argon (high) | 50 | 113M | 4,97 $ |
| Gemini 4 Carbon (high) | 60 | 205M | 5,48 $ |
| Gemini 3.8 Flash (high) | 31 | 126M | hier nicht verglichen |
In diesem Benchmark erreichte Hydrogen im Standard-Modus Argons Score bei rund 38 % von Argons Kosten pro Aufgabe, während Carbon am höchsten punktete. Betrachten Sie es als Sicht eines einzelnen Benchmarks. Google gibt zudem an, dass Hydrogen Aufgaben auf der Stufe „high“ 2,5-mal schneller abschließt als Gemini 3.8 Flash.
Die praktische Aufteilung: Hydrogen für alltägliches Coding und Agents, Carbon für anspruchsvolle Architektur, Debugging und Security-Reviews. In Antigravity wechselt die Orchestrator-Option innerhalb eines Durchlaufs zwischen Carbon und Hydrogen. Unser Vergleich Gemini 4 Carbon vs. Argon behandelt die Frontier-Seite.
Wie können Sie Ihre Gemini-4-Hydrogen-Rechnung senken?
- Nutzen Sie Batch oder Flex für Arbeit, die warten kann. Beide kosten die Hälfte.
- Wählen Sie den niedrigsten Thinking-Level, der Ihre Evals besteht.
mediumverbrauchte etwa halb so viele Tokens wiehigh. - Heben Sie sich
xhighfür die schweren Runden auf. - Halten Sie einen stabilen Prompt-Präfix, damit implizites Caching wiederholten Input mit 0,075 $ pro 1M berechnet – ein Nachlass von 95 %.
- Prototypen Sie im Free Tier.
Messen Sie Ihre echten Gemini-4-Hydrogen-Kosten mit Apidog CLI
Ihre Rechnung ergibt sich aus Ihren eigenen Prompts. Am schnellsten bekommen Sie echte Zahlen, indem Sie Ihren Coding-Agent (Claude Code, Codex, Cursor) Ihre Prompts auf jedem Thinking-Level über die Apidog CLI ausführen lassen und das usage-Objekt jedes Durchlaufs protokollieren.
Einmalige Einrichtung:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Legen Sie 5 bis 10 Ihrer echten Prompts in levels.csv ab, eine Zeile pro Prompt und Thinking-Level, mit den Spalten prompt und thinking_level (low, medium, high, xhigh). Geben Sie Ihrem Agent dann einen Prompt:
In Apidog project <projectId>, create a test case for
POST https://generativelanguage.googleapis.com/v1beta/interactions
with the x-goog-api-key header read from GEMINI_API_KEY in environment
<envId>. Send model "gemini-4-hydrogen", input {{prompt}} and
generation_config.thinking_level {{thinking_level}}. Assert status 200,
status "completed", non-empty output, and a usage object that includes
total_input_tokens and total_output_tokens. In a post-processor, read
total_input_tokens, total_cached_tokens, total_thought_tokens and
total_output_tokens, compute cost at $1.50 input, $0.075 cached and
$7.50 output per 1M, and log it. Run every row of levels.csv and give me
a table of tokens and cost per prompt and thinking level.
Der Agent prüft das Payload-Format, bevor er etwas schreibt, und führt dann jede Zeile aus:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> \
  -d levels.csv -r cli,json --out-file hydrogen-cost-{GENERATE_TIME}
Der JSON-Bericht zeigt, was jedes Thinking-Level auf Ihrer Workload kostet. Ergänzen Sie -r junit, läuft derselbe Befehl in der CI, wo eine Assertion zum Token-Budget den Build fehlschlagen lassen kann. Der Apidog-CLI-CI/CD-Leitfaden zeigt die Pipeline, und Apidog CLI in Claude Code behandelt die Agent-Einrichtung. Apidogs Free Plan deckt bis zu 4 Nutzer ab.
Ein Abkürzungstipp: Sagen Sie Ihrem Agent: „Lies https://apidog.com/apidog-cli-installation-guide.md und richte die Apidog CLI ein.“
FAQ
Ist Gemini 4 Hydrogen kostenlos? Über die API ja, innerhalb der Rate-Limits des Free Tiers: Google listet Standard-Input und -Output im Free Tier als „Kostenlos“. Batch, Flex und Search Grounding benötigen einen bezahlten Key. Siehe unseren Leitfaden zu Gemini 4 Hydrogen kostenlos.
Steigt der Preis von Gemini 4 Hydrogen wie bei Carbon? Googles Preisseite listet einen einzigen Satz von 1,50 $/7,50 $ für Hydrogen, ohne Einführungszeitraum oder Enddatum. Carbon und Argon haben datierte Einführungspreise; Hydrogen nicht.
Werden Thinking-Tokens bei Gemini 4 Hydrogen abgerechnet? Ja, zum Output-Preis von 7,50 $ pro 1M im Standard-Tarif. Das usage-Objekt der Antwort weist sie separat als total_thought_tokens aus.
Ist Gemini 4 Hydrogen günstiger als Gemini 3.8 Flash? In diesem Jahr nicht: Flash kostet bis zum 31. Dezember 2026 0,75 $/3,75 $. Ab dem 1. Januar 2027 steigt Flash auf 1,50 $/7,50 $ – derselbe Preis pro Token wie Hydrogen – und Hydrogen erreichte auf Artificial Analysis’ Index 51 gegenüber Flashs 31.