
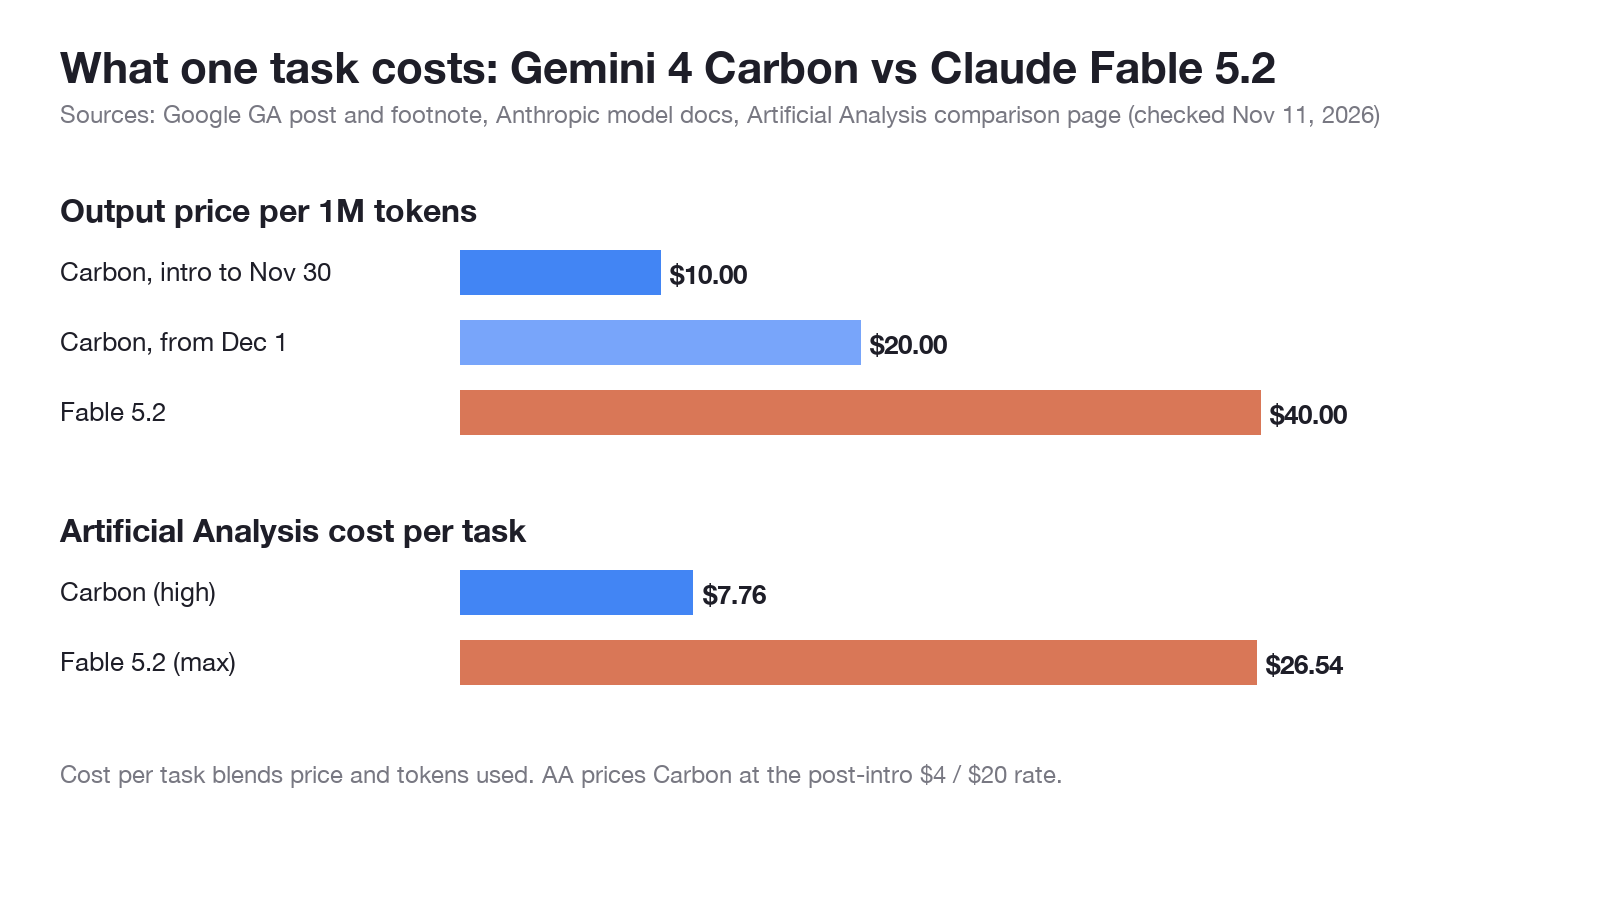
Stand vom 11. November 2026 ist Googles Gemini 4 Carbon das günstigere Modell und Claude Fable 5.2 das stärkere, gemessen an den meisten veröffentlichten Coding- und Agent-Benchmarks. Carbon kostet bis zum 30. November 2 $ / 10 $ pro 1M Input-/Output-Tokens (danach 4 $ / 20 $), Fable 5.2 kostet 8 $ / 40 $, und laut Artificial Analysis liegt die Kosten pro Aufgabe bei 7,76 $ gegenüber 26,54 $.
Die beiden Modelle erschienen nur einen Tag auseinander (Fable 5.2 am 9. November, Carbon GA am 10. November), und die Tabelle jedes Anbieters bevorzugt das eigene Modell. Dieser Leitfaden trennt jede Zahl danach, wer sie gemessen hat, und zeigt dann, wie Sie beide Modelle mit Ihren eigenen Anfragen im A/B-Test vergleichen.
Gemini 4 Carbon vs. Claude Fable 5.2: das schnelle Urteil
Wählen Sie Gemini 4 Carbon, wenn die Kosten pro Aufgabe am wichtigsten sind, für Business-Automatisierungsabläufe oder für Security-Arbeiten. Wählen Sie Claude Fable 5.2, wenn Sie die höchsten Ergebnisse bei anspruchsvollen Coding-, Terminal- und Computer-Use-Aufgaben benötigen und etwa das 3,4-fache pro Aufgabe bezahlen können. Für die alltägliche Entwicklungsarbeit verweisen beide Anbieter zuerst auf ein günstigeres Standardmodell.
Googles GA-Beitrag sagt: „Argon bleibt die ideale Wahl für den Großteil der Softwareentwicklungs- und Wissensarbeit“ und positioniert Carbon für schwierigere Aufgaben, bei denen es mehr Tokens zum Erkunden und Verifizieren verbraucht. Anthropics Modelldokumentation sagt dasselbe in eigenen Worten: Beginnen Sie mit Claude Opus 5.5 für die meisten Workloads und wechseln Sie zu Fable 5.2 für anspruchsvolles Reasoning und langlebige agentische Arbeiten.
Sie greifen also zu einem der beiden, wenn Ihr Standardmodell nicht ausreicht. Sie wählen noch ein Standardmodell? Lesen Sie zuerst Gemini 4 Carbon vs. Argon.
Wie schneiden Gemini 4 Carbon und Claude Fable 5.2 bei Preis und Spezifikationen ab?
Hier sind die Fakten, die jeder Anbieter veröffentlicht, mit der Quelle für jede Zeile.
| Spezifikation | Gemini 4 Carbon | Claude Fable 5.2 | Quelle |
|---|---|---|---|
| Model-ID | gemini-4-carbon |
claude-fable-5-2 |
Google, Anthropic |
| Veröffentlichung | GA 10. Nov. 2026 | 9. Nov. 2026 | Google, Anthropic |
| Input-Preis pro 1M Tokens | 2 $ bis 30. Nov., danach 4 $ | 8 $ (16 $ im Fast-Modus) | Google-Fußnote, Anthropic |
| Output-Preis pro 1M Tokens | 10 $ bis 30. Nov., danach 20 $ | 40 $ (80 $ im Fast-Modus) | Google-Fußnote, Anthropic |
| Kontextfenster | 1M Tokens | 1M Tokens | AI-Studio-Model Card, Anthropic-Dokumentation |
| Max. Output | 65K / 1M laut Angabe [VERIFY] | 128K Tokens | AI-Studio-Model Card, Anthropic-Dokumentation |
| Thinking | Konfigurierbares Thinking-Level | Adaptiv, immer aktiv, Standard-Aufwand high |
Google-Quickstart, Anthropic-Dokumentation |
| Verfügbarkeit | Gemini API Paid Tier, AI Studio, Android Studio, Gemini for business, Antigravity, CodeMender, Google AI Ultra | Claude Platform, Amazon Web Services, Google Cloud, Microsoft Azure | Google, Anthropic |
| Kostenloses API-Tier | Keine Angabe | Keine Angabe | Google, Anthropic |
Googles GA-Beitrag nennt Vertex AI, Gemini CLI und GitHub Copilot nicht, planen Sie also noch nicht mit diesen. Carbons Einführungspreis entspricht dem von Argon, was den November zum günstigsten Monat für Ihre Evaluierung macht.
Für vollständige Preislisten siehe Claude Fable 5.2 Pricing und Googles Gemini-4-Carbon-Ankündigung.
Welches Modell gewinnt bei den Benchmarks?
Das hängt davon ab, welche Tabelle man liest – hier sind daher drei Tabellen, getrennt aufbewahrt.
Anthropics Tabelle (veröffentlicht mit Fable 5.2)
Anthropics Fable-5.2-Launchbeitrag enthält eine Spalte für Gemini 4 Carbon. Die Seite sagt nicht, wer die Carbon-Zahlen ermittelt hat, behandeln Sie sie daher als anbietergemeldet.
| Benchmark (Anthropics Tabelle) | Fable 5.2 | Gemini 4 Carbon |
|---|---|---|
| FrontierSWE v2 | 69,9 % | 61,2 % |
| FrontierCode 2.0 | 49,1 % (Aufwand xhigh) | 41,1 % (Aufwand medium) |
| Terminal-Bench-Science 0.1 | 74,6 % | 64,8 % |
| OSWorld 2.1 (Offline-Set, teilweise) | 89,3 % | 81,5 % |
| AA-Briefcase v1.1 (Rubric) | 66,1 % | 61,8 % |
| Chartography (ohne Tools) | 73,4 % | 72,5 % |
| AutomationBench | 51,4 % | 53,9 % |
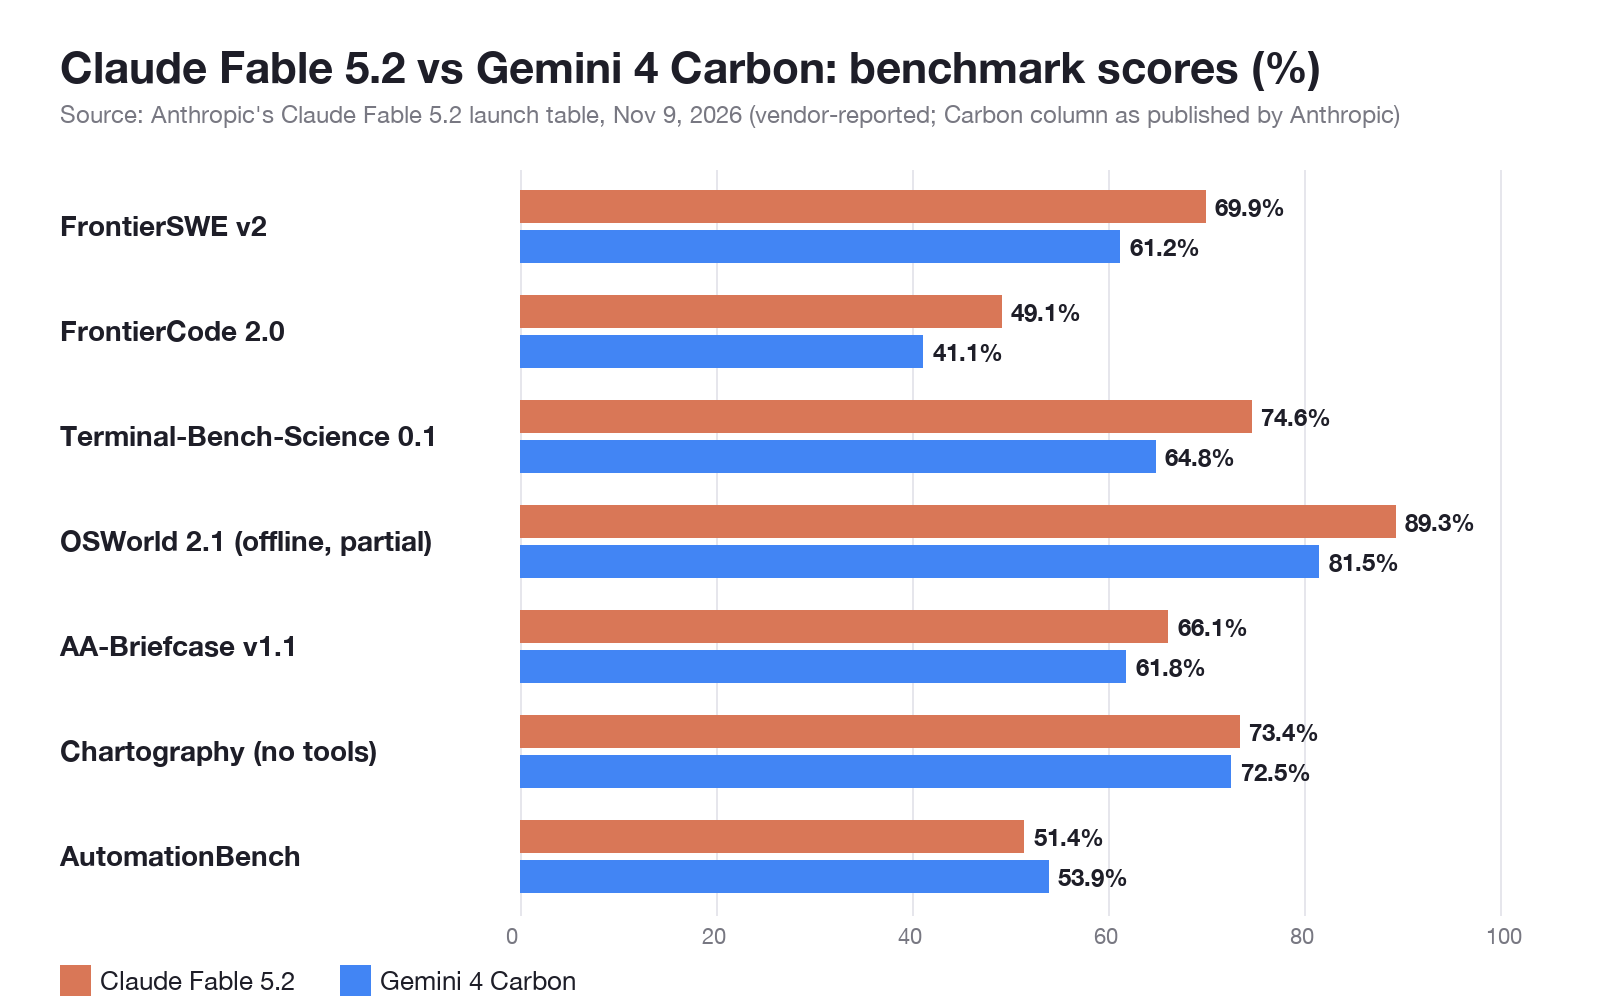
Beachten Sie die FrontierCode-Zeile: Fable lief mit xhigh-Aufwand, Carbon mit medium. Dieser Unterschied in den Einstellungen ist genauso wichtig wie der Unterschied in den Ergebnissen.
Googles Tabelle (veröffentlicht mit Carbon GA)
Google veröffentlicht keinen direkten Vergleich mit Fable 5.2. Stattdessen berichtet es über Partner-Leaderboards: Carbon belegt Platz 1 bei CursorBench 4.0, Perplexitys WANDR und Zapiers AutomationBench „bei mehr als 2X niedrigeren Kosten pro Aufgabe im Vergleich zum besten externen Modell“. Beim Multimodal Knowledge Agent Benchmark belegt es Platz 2 bei mehr als 6x niedrigeren durchschnittlichen Kosten pro Aufgabe als das Top-Modell. Google nennt die Konkurrenzmodelle in diesen Angaben nicht.
Artificial Analysis (unabhängig)
Die Vergleichsseite von Artificial Analysis führt beide Modelle durch denselben Intelligence Index v5.0.1:
| Metrik (Artificial Analysis) | Fable 5.2 (max) | Gemini 4 Carbon (high) |
|---|---|---|
| Intelligence Index | 65 | 60 |
| Kosten pro Aufgabe | 26,54 $ | 7,76 $ |
| Kosten für den gesamten Index | 22.191 $ | 8.240 $ |
| Output-Geschwindigkeit | 103 Tokens/s | 82 Tokens/s |
Fable 5.2 (max) belegt derzeit den Spitzenplatz in diesem Index. Carbon liegt 5 Punkte darunter bei etwa 29 % der Kosten pro Aufgabe. Artificial Analysis berechnet Carbon mit 4 $ / 20 $, dem Preis nach November, daher spiegeln seine Kostenangaben bereits den Dezemberpreis wider.
Wo gewinnt Claude Fable 5.2?
Fable 5.2 gewinnt bei den schwierigsten Coding- und Computer-Use-Aufgaben, laut Anthropics Zahlen:
- Repository-weites Coding: 69,9 % vs. 61,2 % bei FrontierSWE v2.
- Terminal- und Recherchearbeiten: 74,6 % vs. 64,8 % bei Terminal-Bench-Science 0.1.
- Computer Use: 89,3 % vs. 81,5 % bei OSWorld 2.1.
- Unabhängiger Index: 65 vs. 60 bei Artificial Analysis – der eine Score, den kein Anbieter selbst ermittelt hat.
- Output-Länge: dokumentierte maximal 128K Output-Tokens pro Anfrage.
Wenn eine fehlgeschlagene Aufgabe den Nachmittag eines Entwicklers kostet, kann ein FrontierSWE-Gewinn von 8 Punkten die Token-Rechnung aufwiegen. Zum Einrichten siehe den Claude-Fable-5.2-API-Leitfaden.
Wo gewinnt Gemini 4 Carbon?
Carbon gewinnt bei den Kosten pro Aufgabe und bei den Workloads, für die Google es gebaut hat:
- Kosten pro Aufgabe: 7,76 $ vs. 26,54 $ bei Artificial Analysis, etwa 3,4x günstiger.
- Business-Automatisierung: 53,9 % vs. 51,4 % bei AutomationBench, in Anthropics eigener Tabelle.
- Security: führt laut Google bei SEC-bench Pro, ExploitGym und CWE-bench v1, plus ein zugangsbeschränktes Carbon-for-Cyber-Modell für Verteidiger über das Fairwind Program.
- Preis im November: 2 $ / 10 $ bis zum 30. November, ein Viertel von Fables Satz sowohl bei Input als auch bei Output.
- Agent-Teams: die /swarm-Vorschau in Google Antigravity macht aus einem Prompt ein koordiniertes Team, bei dem Carbon plant und auditiert, während leichtere Modelle parallel arbeiten.
Neu bei diesem Modell? Beginnen Sie mit Was ist Gemini 4 Carbon.
Was kostet eine Aufgabe tatsächlich?
Der Listenpreis nennt den Satz, nicht die Rechnung. Die Kosten einer Aufgabe ergeben sich aus dem Preis multipliziert mit den Tokens, die das Modell zu verbrauchen entscheidet – und Google sagt, dass Carbon mehr Tokens zum Erkunden und Verifizieren verbraucht.
Nehmen wir eine Anfrage mit 50.000 Input-Tokens und 10.000 Output-Tokens:
- Carbon, Einführungspreis: (0,05 x 2 $) + (0,01 x 10 $) = 0,20 $
- Carbon, ab 1. Dezember: (0,05 x 4 $) + (0,01 x 20 $) = 0,40 $
- Fable 5.2: (0,05 x 8 $) + (0,01 x 40 $) = 0,80 $
Das setzt voraus, dass beide 10.000 Tokens ausgeben. Werden sie nicht. Wenn Carbon 30.000 Tokens an Reasoning schreibt, wo Fable 10.000 schreibt, steigen Carbons Dezemberkosten auf 0,80 $, und der Abstand schließt sich. Artificial Analysis hat das Realverhalten über seine gesamte Suite gemessen und Carbon weiterhin etwa 3,4x günstiger pro Aufgabe gefunden – das stärkste Signal, das Sie haben, bis Sie selbst messen.
Wie führt man A/B-Tests mit Gemini 4 Carbon und Claude Fable 5.2 an eigenen Anfragen durch?
Benchmarks sind die Aufgaben anderer. Der faire Test sendet denselben Prompt an beide APIs und zeichnet Tokens und Latenz nebeneinander auf.
Beide Aufrufe sind einfaches HTTP. Hier ist Carbons Anfrage, aufgebaut aus Googles Quickstart für die Interactions API, mit dem Modellnamen in einer Variablen:
MODEL="gemini-4-carbon"
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Api-Revision: 2026-05-20" \
  -d "{\"model\": \"$MODEL\", \"input\": \"Review this diff and list the bugs.\"}"
Fable 5.2 läuft über Anthropics Messages API mit claude-fable-5-2 als Modell.
Lassen Sie Ihren Coding-Agenten den A/B-Test mit Apidog CLI ausführen
Anfragepaare von Hand auszuführen, wird schnell mühsam. Lassen Sie stattdessen Claude Code, Codex oder Cursor die Apidog CLI steuern. Das Setup braucht drei Befehle:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Dann geben Sie Ihrem Agenten einen Prompt:
In Apidog project <PROJECT_ID>, create two test cases: one that sends
our code-review prompt to gemini-4-carbon through the Gemini API, and
one that sends the same prompt to claude-fable-5-2 through the Claude
Messages API. Keep both API keys in private environment variables.
Assert a 200 status and a non-empty answer, record token usage and
response time, run each case 5 times and summarize cost per run.
Validate every payload before you write it.
Der Agent prüft das Schema, schreibt die Testfälle und führt sie aus. Die folgenden Flags stammen aus apidog run --help der CLI 2.2.12:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file carbon-case.json
apidog test-case create --project <PROJECT_ID> --file carbon-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <CARBON_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
apidog run --test-case <FABLE_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
-n 5 wiederholt jeden Testfall fünfmal, damit eine langsame Antwort nicht über das Ergebnis entscheidet. Fügen Sie --upload-report hinzu, um die Läufe in der Apidog-App anzusehen. Dies ist eine Workflow-Vorlage; wir haben sie auf dieser Maschine nicht gegen Carbon ausgeführt. Der Leitfaden Apidog CLI in Claude Code behandelt das Agent-Setup, und der Gemini-4-Argon-API-Leitfaden behandelt die Gemini-Anfrageseite.
Apidogs kostenloser Plan umfasst bis zu 4 Nutzer – genug, um diesen Vergleich durchzuführen.
FAQ
Ist Gemini 4 Carbon besser als Claude Fable 5.2?
Nicht pauschal. Fable 5.2 erzielt bei den meisten von Anthropics Benchmarks und im Artificial-Analysis-Index höhere Ergebnisse (65 vs. 60). Carbon gewinnt bei den Kosten pro Aufgabe (7,76 $ vs. 26,54 $) und bei AutomationBench.
Wie viel günstiger ist Gemini 4 Carbon als Claude Fable 5.2?
Zum Listenpreis ist Carbon bis zum 30. November 2026 4x günstiger (2 $ / 10 $ vs. 8 $ / 40 $ pro 1M Tokens) und ab dem 1. Dezember 2x günstiger (4 $ / 20 $). Pro Aufgabe gemessen von Artificial Analysis ist es etwa 3,4x günstiger.
Haben beide Modelle ein 1M-Token-Kontextfenster?
Ja. Googles AI-Studio-Model Card listet 1M Tokens für Carbon, und Anthropics Dokumentation listet 1M Tokens für Fable 5.2. Fables maximaler Output beträgt 128K Tokens; den genauen Output-Limit von Carbon finden Sie in Googles Entwicklerleitfaden.
Gibt es ein kostenloses Tier für Gemini 4 Carbon oder Claude Fable 5.2 über die API?
Keiner der Anbieter gibt eines an. Carbon läuft im Paid Tier der Gemini API und in Google-AI-Ultra-Apps; Fable 5.2 wird pro Token abgerechnet.
Sollte ich mein Standardmodell auf eines der beiden umstellen?
Wahrscheinlich nicht. Google sagt, dass Argon die richtige Wahl für den Großteil der Softwareentwicklungs- und Wissensarbeit bleibt, und Anthropic empfiehlt Opus 5.5 für die meisten Workloads. Leiten Sie nur die Aufgaben, an denen Ihr Standardmodell scheitert, an Carbon oder Fable weiter – und vergleichen Sie die Ergebnisse dann an Ihren eigenen Anfragen.