
Ab dem 11. November 2026 kostet Googles Gemini 4 Carbon 2 $ pro 1M Input-Tokens und 10 $ pro 1M Output-Tokens über die Gemini API – ein Einführungspreis, der am 30. November 2026 endet. Ab dem 1. Dezember verdoppelt sich der Preis für Gemini 4 Carbon auf 4 $ für Input und 20 $ für Output pro 1M Tokens, und Thinking-Tokens werden zum Output-Preis abgerechnet.
Ihre tatsächliche Rechnung hängt davon ab, wie viele Tokens Carbon für das Nachdenken verbraucht – und Carbon verbraucht eine Menge. Nachfolgend: die vollständige Preistabelle, durchgerechnete Beispiele zu beiden Preisen, der Kostenabstand zu Argon und Mitbewerbern sowie eine Möglichkeit, Ihre echten Kosten pro Anfrage zu protokollieren. Neu beim Modell? Beginnen Sie mit Was ist Gemini 4 Carbon.
Was kostet Gemini 4 Carbon pro 1M Tokens?
Gemini 4 Carbon (Modell-ID gemini-4-carbon) ist ein Modell der Paid-Tier-Stufe. Googles Preisseite listet vier Stufen auf, jeweils mit einem Einführungspreis bis zum 30. November 2026 und einem neuen Preis ab dem 1. Dezember 2026:
| Stufe | Input (bis 30. Nov.) | Input (ab 1. Dez.) | Output inkl. Thinking (bis 30. Nov.) | Output inkl. Thinking (ab 1. Dez.) | Cached Input (bis 30. Nov. / ab 1. Dez.) | Quelle |
|---|---|---|---|---|---|---|
| Standard | 2,00 $ | 4,00 $ | 10,00 $ | 20,00 $ | 0,10 $ / 0,20 $ | |
| Batch | 1,00 $ | 2,00 $ | 5,00 $ | 10,00 $ | 0,05 $ / 0,10 $ | |
| Flex | 1,00 $ | 2,00 $ | 5,00 $ | 10,00 $ | 0,05 $ / 0,10 $ | |
| Priority | 3,60 $ | 7,20 $ | 18,00 $ | 36,00 $ | 0,18 $ / 0,36 $ |
Alle Preise gelten pro 1M Tokens. Einige Details auf derselben Seite sind für Ihr Budget relevant:
- Kein Free-Tier. Googles Seite besagt: „Gemini 4 Carbon is not available on the Free tier." (Gemini 4 Carbon ist im Free-Tier nicht verfügbar.)
- Thinking wird abgerechnet. „Jedes Token, das das Modell verarbeitet, wird gezählt und abgerechnet, einschließlich Thinking-Tokens."
- Nur implizites Caching. Explizites Caching wird nicht unterstützt, daher erhalten Sie den Cache-Preis, wenn Googles impliziter Cache ein wiederholtes Prompt-Präfix erkennt.
Googles Launch-Beitrag nennt den Wechsel in einer Fußnote: „Nach Ablauf der Einführungsphase am 30. November 2026 gelten 4 $ pro 1M Input-Tokens und 20 $ pro 1M Output-Tokens. Gilt nur für das Modell Carbon, das für den öffentlichen Zugang vorgesehen ist."
Was ändert sich am 1. Dezember 2026?
Jeder Preis verdoppelt sich. Der Standard-Input steigt von 2 $ auf 4 $, der Output von 10 $ auf 20 $ und der Cache-Preis von 0,10 $ auf 0,20 $. Batch und Flex verdoppeln sich ebenfalls, sodass der Batch-Rabatt von 50 % bestehen bleibt.
Die Fußnote enthält keine Ausnahme für Early Adopters, und nichts auf der Preisseite deutet darauf hin, dass bestehende Projekte den Einführungspreis behalten. Kalkulieren Sie jedes Token, das am oder nach dem 1. Dezember gesendet wird, mit 4 $/20 $.
Gemini 4 Argon folgt demselben Zeitplan; siehe unseren Preis-Leitfaden zu Gemini 4 Argon.
Wie werden Gemini 4 Carbon Thinking-Tokens abgerechnet?
Thinking-Tokens werden zum Output-Preis abgerechnet: 10 $ pro 1M bis zum 30. November, danach 20 $. Die Interactions API meldet sie in einem separaten Feld, sodass das usage-Objekt einer Antwort wie in diesem Beispiel aus Googles Dokumentation aussieht:
"usage": {
  "total_tokens": 530,
  "total_input_tokens": 62,
  "total_output_tokens": 171,
  "total_thought_tokens": 297
}
Das Modell hat 297 Tokens lang nachgedacht, um 171 zu schreiben, und Sie zahlen den Output-Preis für Text, den Sie nie sehen. Carbon nutzt standardmäßig thinking_level „medium" und akzeptiert außerdem „low" und „high", laut Googles Thinking-Leitfaden.
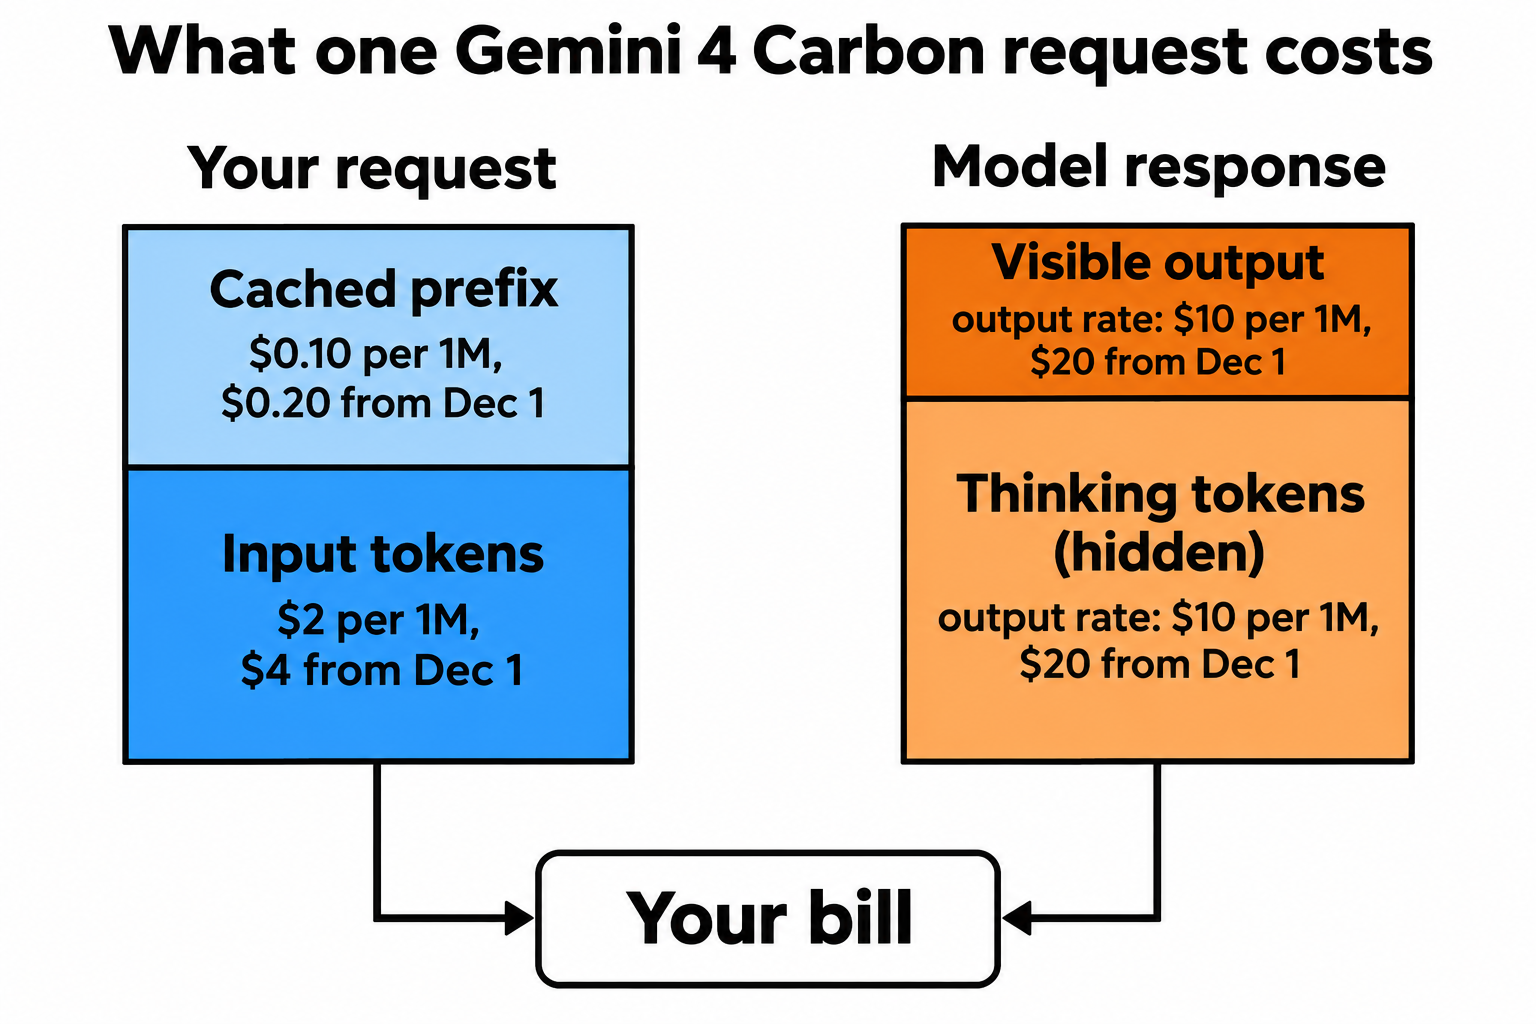
Die Formel für eine Anfrage lautet:
cost = (uncached_input x input_rate)
     + (cached_input x cached_rate)
     + ((thought + output) x output_rate)
Was kostet ein einzelner Gemini 4 Carbon Aufruf?
Die beiden folgenden Beispiele sind illustrative Token-Zahlen, keine Messungen. Setzen Sie die Zahlen aus Ihrem eigenen usage-Objekt ein.
Beispiel 1: ein einzelner Chat-Aufruf. 1.500 Input-Tokens, 2.500 Thinking-Tokens, 800 Output-Tokens.
| Position | Bis 30. Nov. | Ab 1. Dez. |
|---|---|---|
| Input (1.500) | 0,0030 $ | 0,0060 $ |
| Thinking + Output (3.300) | 0,0330 $ | 0,0660 $ |
| Gesamt pro Aufruf | 0,036 $ | 0,072 $ |
| 10.000 Aufrufe pro Monat | 360 $ | 720 $ |
Beispiel 2: ein langer Agent-Lauf mit intensivem Nachdenken. Eine Agent-Schleife benötigt 40 Durchläufe. Da sie in jedem Durchlauf die Konversation erneut sendet, liest sie insgesamt 1,2M Input-Tokens, und 900K davon treffen den impliziten Cache. Sie denkt 300K Tokens lang und schreibt 60K Tokens an Code und Tool-Aufrufen.
| Position | Bis 30. Nov. | Ab 1. Dez. |
|---|---|---|
| Uncached Input (300K) | 0,60 $ | 1,20 $ |
| Cached Input (900K) | 0,09 $ | 0,18 $ |
| Thinking + Output (360K) | 3,60 $ | 7,20 $ |
| Gesamt pro Lauf | 4,29 $ | 8,58 $ |
| Gleiche Tokens zu Batch- oder Flex-Preisen | 2,15 $ | 4,29 $ |
Im Agent-Lauf machen Thinking und Output 84 % der Rechnung aus, daher spart das Senken des Thinking-Levels mehr als das Kürzen des Prompts. Der Anfrage-Code finden Sie in unserem API-Leitfaden zu Gemini 4 Carbon.
Ist Gemini 4 Carbon teurer als Gemini 4 Argon?
Pro Token: nein – beide kosten derzeit 2 $/10 $ und ab dem 1. Dezember 4 $/20 $. Pro Aufgabe: ja, in der Regel. Google sagt, Carbon bewältige anspruchsvollere Aufgaben, indem es „mehr Tokens als Argon verwendet, um gründlich zu explorieren, tief zu reasoning und erweiterte Verifikationsschleifen auszuführen", und dass „Argon die ideale Wahl für die Mehrheit der Software-Engineering- und Wissensarbeit bleibt."
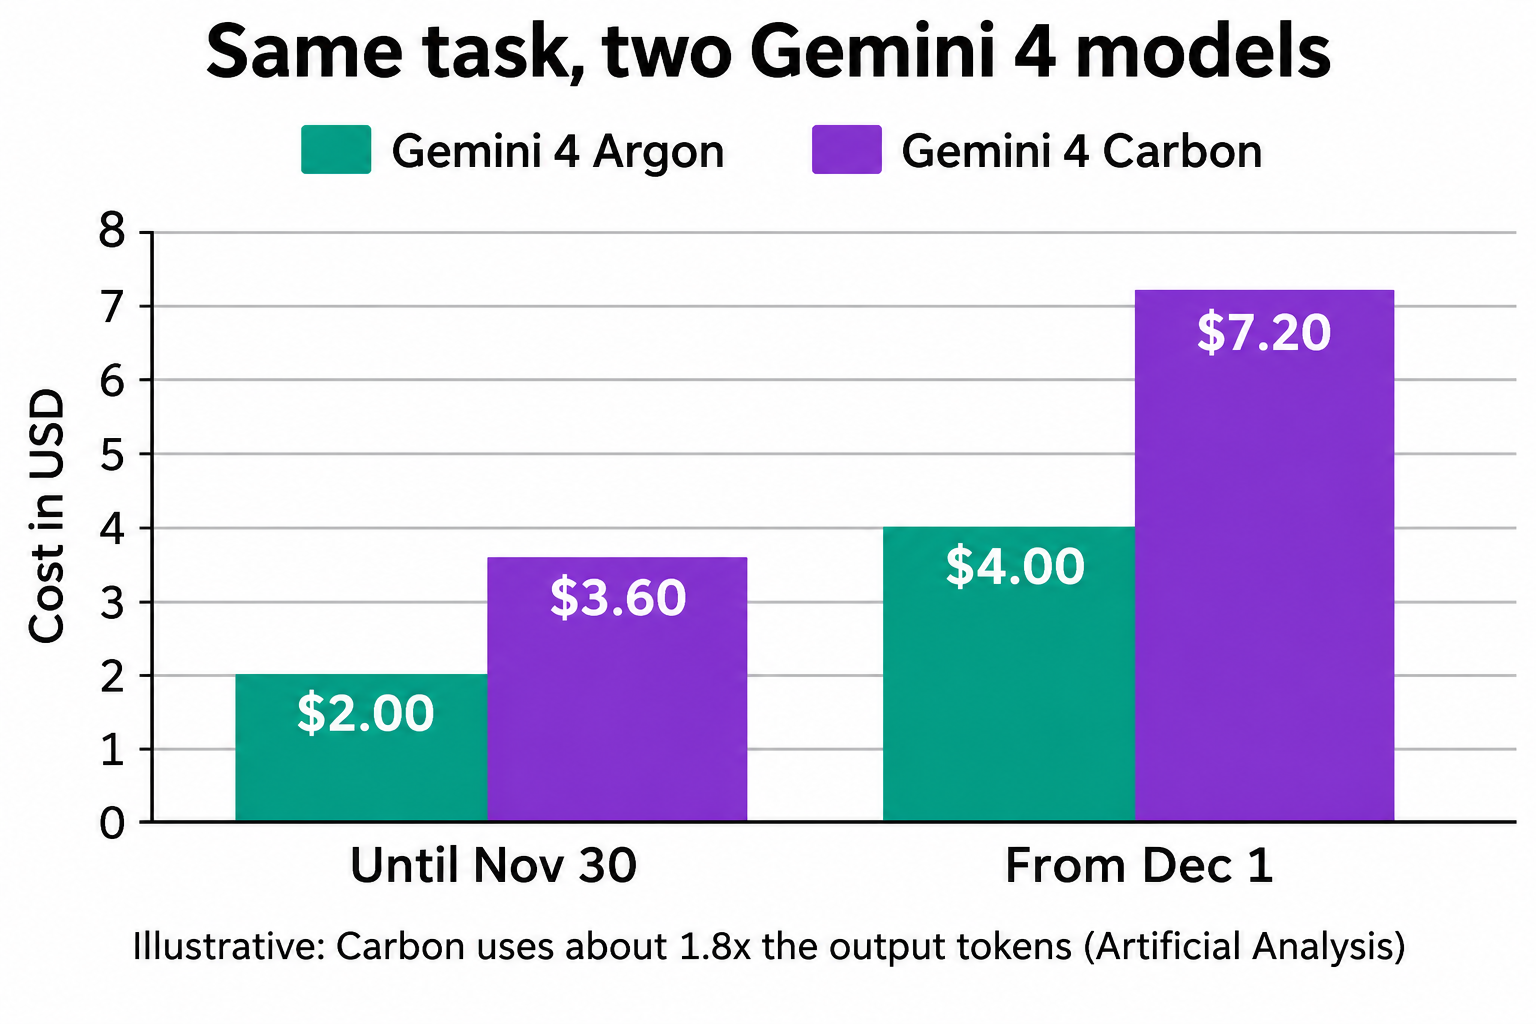
Artificial Analysis beziffert das: Beim Durchlauf seines Intelligence Index erzeugte Gemini 4 Carbon (high) 205M Output-Tokens, gegenüber 113M bei Gemini 4 Argon. Das sind etwa 1,8-fache Output-Tokens für dieselbe Aufgabenmenge – und dafür gab es einen höheren Score: 60 für Carbon gegenüber 50 für Argon.
Wendet man dieses Verhältnis auf eine Aufgabe an, bei der Argon 200K Output-Tokens verbraucht:
| Modell | Output-Tokens | Kosten bis 30. Nov. | Kosten ab 1. Dez. |
|---|---|---|---|
| Gemini 4 Argon | 200.000 | 2,00 $ | 4,00 $ |
| Gemini 4 Carbon (ca. 1,8x) | 360.000 | 3,60 $ | 7,20 $ |
Route also nach Schwierigkeit: schwieriges Debugging, Architektur- und Sicherheitsaudits an Carbon, alltägliche Codierarbeit an Argon. Unser Vergleich Gemini 4 Carbon vs. Argon behandelt, welche Aufgaben die zusätzlichen Tokens rechtfertigen.
Wie schneidet der Preis von Gemini 4 Carbon im Vergleich zu Claude Fable 5.2, Opus 5.5 und GPT-6.1 Sol ab?
Hier sind die Standard-API-Preise pro 1M Tokens, jeweils von der Preisseite des Anbieters am 11. November 2026 übernommen:
| Modell | Input | Output | Cached Input | Quelle |
|---|---|---|---|---|
| Gemini 4 Carbon (bis 30. Nov.) | 2,00 $ | 10,00 $ | 0,10 $ | |
| Gemini 4 Carbon (ab 1. Dez.) | 4,00 $ | 20,00 $ | 0,20 $ | |
| Gemini 4 Argon (bis 30. Nov.) | 2,00 $ | 10,00 $ | 0,10 $ | |
| Claude Fable 5.2 | 8,00 $ | 40,00 $ | 0,20 $ (Cache-Treffer) | Anthropic |
| Claude Opus 5.5 | 4,00 $ | 20,00 $ | 0,20 $ (Cache-Treffer) | Anthropic |
| GPT-6.1 Sol | 2,00 $ | 10,00 $ | 0,10 $ | OpenAI |
| GPT-6 Astra | 10,00 $ | 50,00 $ | 1,00 $ | OpenAI |
Ab dem 1. Dezember entspricht Carbons Preis pro Token dem von Claude Opus 5.5 und bleibt halb so hoch wie der von Claude Fable 5.2. Anthropic berechnet Cache-Schreibvorgänge separat; Google listet für das implizite Caching keine Schreibgebühr auf. OpenAIs Sol-Preis gilt für Prompts bis 272K Input-Tokens.
Listenpreise entscheiden das nicht, denn jedes Modell denkt unterschiedlich viel. Artificial Analysis veröffentlicht eine Kostenfigur für jedes Modell auf seinem Intelligence Index: 7,76 $ für Gemini 4 Carbon (high) mit einem Score von 60 und 26,54 $ für Claude Fable 5.2 (max) mit einem Score von 65. Fable 5.2 erzeugte auf dem Index auch mehr Output-Tokens (275M gegenüber Carbons 205M). Betrachten Sie diese Zahlen als Sicht eines einzelnen Benchmarks; Ihre Workload wird anders aussehen. Für den direkten Vergleich siehe Gemini 4 Carbon vs. Claude Fable 5.2 sowie den API-Leitfaden zu Claude Fable 5.2 für die Anthropic-Seite.
Wie können Sie Ihre Gemini 4 Carbon Rechnung senken?
- Nutzen Sie Batch oder Flex für Arbeiten, die warten können. Beide kosten die Hälfte des Standardpreises.
- Senken Sie das Thinking-Level. „low" für Routinedurchläufe, „high" nur dort, wo sich Genauigkeit auszahlt.
- Leiten Sie einfache Durchläufe an Argon weiter. Gleicher Preis pro Token, deutlich weniger Output-Tokens.
- Halten Sie ein stabiles Prompt-Präfix ein, damit implizites Caching wiederholten Input mit 0,10 $ pro 1M (danach 0,20 $) abrechnet.
- Schließen Sie große Jobs vor dem 1. Dezember ab, wenn derselbe Lauf doppelt so viel kostet.
Protokollieren Sie Ihre echten Gemini 4 Carbon Kosten pro Anfrage mit Apidog CLI
Ihre Rechnung ergibt sich aus Token-Zahlen, und die ändern sich jedes Mal, wenn Sie einen Prompt oder ein Thinking-Level anpassen. Der schnellste Weg zu echten Zahlen: Lassen Sie Ihren Coding-Agenten (Claude Code, Codex, Cursor) Ihre tatsächlichen Prompts über die Apidog CLI ausführen und das usage-Objekt jedes Aufrufs protokollieren.
Einmalige Einrichtung:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Legen Sie 10 bis 20 Ihrer echten Prompts in prompts.csv mit den Spalten prompt und thinking_level ab. Geben Sie Ihrem Agenten dann einen einzigen Prompt:
In Apidog project <projectId>, create a test case for
POST https://generativelanguage.googleapis.com/v1beta/interactions
with the x-goog-api-key header read from GEMINI_API_KEY in environment
<envId>. Send model {{model}} (default "gemini-4-carbon"), input {{prompt}}
and generation_config.thinking_level {{thinking_level}}. In a post-processor,
read usage.total_input_tokens, total_thought_tokens and total_output_tokens,
compute cost at $2/$10 and at $4/$20 per 1M, and log both. Assert status is
"completed". Run it once per row of prompts.csv and give me a table of
tokens and cost per prompt, plus the totals.
Der Agent prüft die Struktur der Payload, bevor er etwas schreibt, und führt dann jede Zeile aus:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case category --project <projectId>
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> \
  -d prompts.csv -r cli,json --out-file carbon-cost-{GENERATE_TIME}
Der JSON-Bericht führt ein datiertes Protokoll der Tokens pro Prompt. Führen Sie den Lauf mit --env-var "model=gemini-4-argon" erneut aus, und Sie erhalten die Argon-Zahlen für dieselben Prompts – der sauberste Weg zu entscheiden, welches Modell welche Aufgabe verdient. Fügen Sie -r junit hinzu, und derselbe Befehl läuft in CI, wo eine Kosten-Assertion den Build fehlschlagen lassen kann; der Apidog CLI CI/CD-Leitfaden zeigt die Pipeline, und Apidog CLI in Claude Code behandelt die Agent-Einrichtung. Apidogs Free-Plan deckt bis zu 4 Nutzer ab.
Ein Abkürzungstipp: Sagen Sie Ihrem Agenten „Lies https://apidog.com/apidog-cli-installation-guide.md und richte Apidog CLI ein."
FAQ
Ist Gemini 4 Carbon kostenlos? Nicht über die API: Carbon ist nicht im Free-Tier enthalten, Sie brauchen also einen kostenpflichtigen Schlüssel. Wissenschaftler können bei Google sechs Monate kostenlosen Zugang über Antigravity beantragen. Unser Leitfaden zu Gemini 4 Carbon kostenlos deckt jeden Weg ab.
Ist Gemini 4 Carbon in Google AI Ultra enthalten? Google sagt, dass Carbon für AI Ultra-Abonnenten in der Gemini App, im AI Mode in der Suche und in Antigravity ausgerollt wird. API-Aufrufe werden separat, pro Token, auf der Paid-Tier-Stufe abgerechnet.
Steigt der Preis für bestehende Nutzer am 1. Dezember? Googles Fußnote nennt keine Ausnahme für bestehende Nutzer. Kalkulieren Sie ab dem 1. Dezember 2026 mit 4 $ Input und 20 $ Output pro 1M Tokens für die gesamte Carbon-Nutzung.
Ist Gemini 4 Carbon günstiger als Claude Fable 5.2? Pro Token: ja – 4 $/20 $ ab dem 1. Dezember gegenüber Fable 5.2s 8 $/40 $. Auf Artificial Analysis Intelligence Index lag Carbons Kostenfigur bei 7,76 $ gegenüber 26,54 $ für Fable 5.2 (max), wobei Fable höher bewertet wurde: 65 zu 60.