
Gemini 4 Argon kostet während einer Einführungsphase 2 $ pro 1 Mio. Eingabe-Tokens und 10 $ pro 1 Mio. Ausgabe-Tokens, danach 4 $ und 20 $. Zwischengespeicherte Eingaben erhalten 95 % Rabatt auf den Eingabepreis, was sich während der Einführungsphase auf 0,10 $ pro 1 Mio. Tokens und danach auf 0,20 $ beläuft. Google hat nicht mitgeteilt, wie lange die Einführungsphase dauert, und Sie können Argon noch nicht kaufen: Es wurde zwar angekündigt, ist aber nicht allgemein verfügbar, und wird heute nur für Cyberverteidiger des Fairwind-Programms eingeführt.
Dieser Beitrag wandelt dieses Preisblatt in Budgetzahlen um: einen Vergleich mit sieben aktuellen Modellen, vier durchgerechneten Szenarien, Drittanbieter-Kosten pro Aufgabe und die jetzt einzurichtenden Kostenkontrollen. Für das Modell selbst beginnen Sie mit was Gemini 4 Argon ist; für den Zugriff siehe ist Gemini 4 Argon kostenlos. Sie können in Apidog Kostenannahmen für ein Modell erstellen, das Sie heute aufrufen können, und den Modellnamen später austauschen.
Das Preisblatt
Google veröffentlichte die Preise im Launch-Post für Gemini 4 Argon, wobei der Preis nach der Einführungsphase in Fußnote 1 angegeben ist: „Nach Ablauf der Einführungsphase gelten die Preise von 4 $ pro 1 Mio. Eingabe-Tokens und 20 $ pro 1 Mio. Ausgabe-Tokens.“
| Gemini 4 Argon, pro 1 Mio. Tokens | Einführung | Standard (nach Einführung) |
|---|---|---|
| Eingabe | $2.00 | $4.00 |
| Zwischengespeicherte Eingabe (95 % Rabatt auf Eingabe) | $0.10 | $0.20 |
| Ausgabe | $10.00 | $20.00 |
| Maximale Ausgabe pro Antwort (Google) | 1 Mio. Tokens | 1 Mio. Tokens |
| Kosten für eine vollständige 1 Mio.-Token-Ausgabe | $10.00 | $20.00 |
Die Preise für zwischengespeicherte Daten ergeben sich rechnerisch aus Googles 95%-Regel (2 $ x 0,05 und 4 $ x 0,05). Google hat weder ein Eingabekontextfenster noch eine Modell-ID veröffentlicht. Es gibt an, dass das Ausgabelimit 1 Mio. Tokens beträgt, „ein Anstieg gegenüber den vorherigen 64K Tokens“; mindestens ein Drittanbieter-Evaluator, Vals AI, listet eine maximale Ausgabe von 262K für die von ihm getestete Konfiguration auf.
Argon vs. aktuelle Frontier- und Gemini-Modelle
Alle Preise gelten pro 1 Mio. Tokens.
| Modell | Eingabe | Zwischengespeicherte Eingabe | Ausgabe | Max. Ausgabe |
|---|---|---|---|---|
| Gemini 4 Argon (Einführung) | $2 | $0.10 | $10 | 1M |
| Gemini 4 Argon (Standard) | $4 | $0.20 | $20 | 1M |
| GPT-6 Astra | $10 | $1 | $50 | 128,000 |
| Claude Opus 5.5 | $4 | $0.20 | $20 | 128K (300K im Batch, Beta) |
| Claude Sonnet 5.5 | $2 | $0.20 | $10 | 128K (300K im Batch, Beta) |
| GPT-6.1 Sol | $2 | $0.10 | $10 | 128,000 |
| Claude Fable 5.1 | $10 | $0.25 | $50 | 128K |
| gemini-3.1-pro-preview (Prompt <=200K / >200K) | $2 / $4 | $0.20 / $0.40 | $12 / $18 | 65,536 |
| gemini-3.8-flash (Einführung / ab 01.01.2027) | $0.75 / $1.50 | $0.075 / $0.15 | $3.75 / $7.50 | 65,536 |
Die Preise der Wettbewerber stammen von den eigenen Seiten der Anbieter: OpenAIs GPT-6 Astra Seite, Anthropic's Preisseite und Googles Gemini API Preisseite.
- Standard Argon = Claude Opus 5.5. Gleiche 4 $/20 $, gleiche 0,20 $ für zwischengespeicherte Eingabe.
- Einführungs-Argon = Claude Sonnet 5.5 und GPT-6.1 Sol. Gleiche 2 $/10 $; der zwischengespeicherte Einführungs-Tarif von 0,10 $ entspricht GPT-6.1 Sol.
- GPT-6 Astra und Claude Fable 5.1 kosten das 5-fache des Einführungs-Argon und das 2,5-fache des Standard-Argon. Siehe Claude Fable 5.1 Preise.
- Argons Einführungs-Ausgabe (10 $) liegt unter gemini-3.1-pro-preview (12 $), Googles vorigem Top-Pro-Modell.
- Lange Prompts ändern die Rechnung. OpenAI berechnet Prompts über 272K Eingabe-Tokens mit dem 2-fachen Eingabe- und Cache-Preis und dem 1,5-fachen Ausgabe-Preis für die gesamte Anfrage. Gemini 3.1 Pro berechnet mehr über 200K; Anthropic nicht. Google hat nicht gesagt, ob Argon eine Stufe für lange Prompts hat.
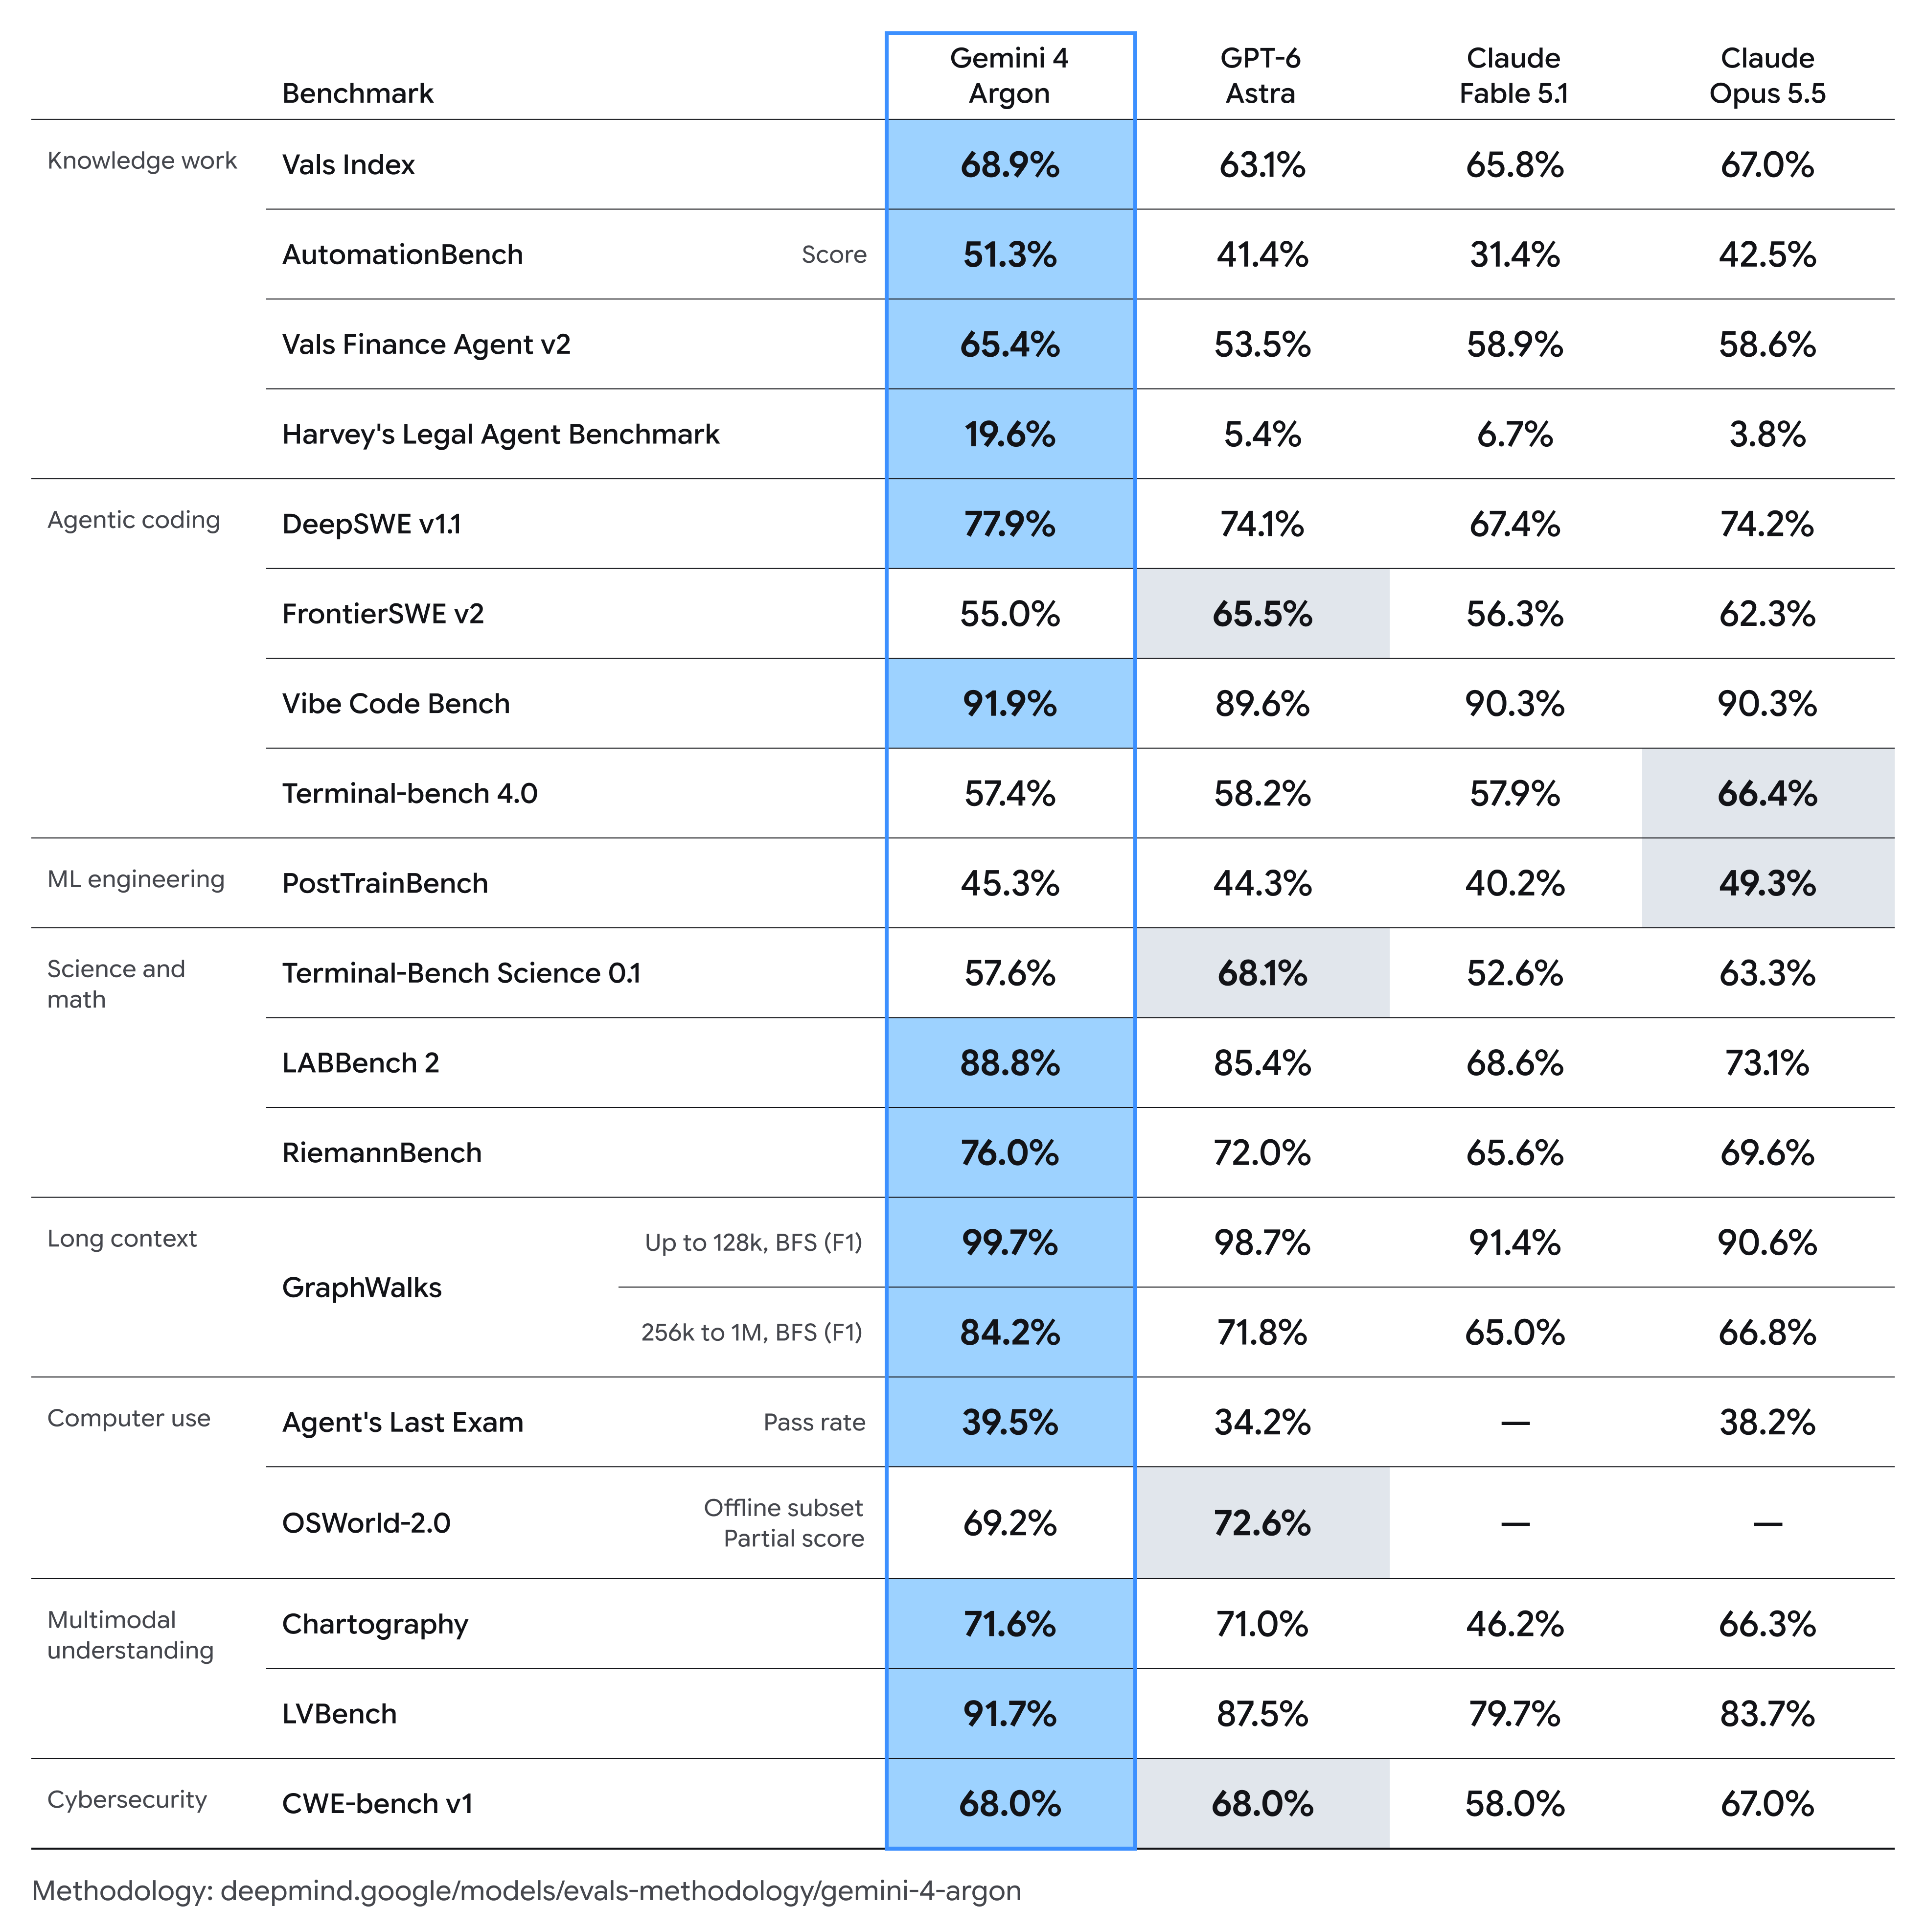
Für die Fähigkeiten neben dem Preis siehe Gemini 4 Argon vs. GPT-6 Astra vs. Claude Opus 5.5.
Denk-Tokens werden als Ausgabe berechnet
Bei aktuellen Gemini-Modellen werden Denk-Tokens als Ausgabe berechnet: Googles Thinking-Dokumentation besagt, dass „die Antwortpreisgestaltung die Summe aus Ausgabe-Tokens und Denk-Tokens ist.“ Google hat Argon nicht spezifisch dokumentiert, aber gehen Sie von der gleichen Regel aus. Google führte Argons Evaluierungen „mit den höchsten Denkeinstellungen“ durch, daher lesen Sie „10 $ pro 1 Mio. Ausgabe-Tokens“ als Antwort plus Überlegung.
Vier durchgerechnete Szenarien
Jede untenstehende Zahl ist Tokens geteilt durch 1 Mio., mal dem Pro-1M-Satz. Szenarien 1 bis 3 gehen davon aus, dass kein Caching verwendet wird.
1. Ein typischer API-Aufruf: 20K Eingabe, 5K Ausgabe
- Einführung: 20.000 / 1 Mio. x 2 $ = 0,04 $ Eingabe, plus 5.000 / 1 Mio. x 10 $ = 0,05 $ Ausgabe. Gesamt 0,09 $.
- Standard: 0,08 $ + 0,10 $ = 0,18 $.
Bei 1.000 Aufrufen pro Tag sind das 90 $ (Einführung) oder 180 $ (Standard). Der gleiche Aufruf kostet 0,18 $ bei Claude Opus 5.5, 0,45 $ bei GPT-6 Astra (0,20 $ + 0,25 $), 0,10 $ bei gemini-3.1-pro-preview (0,04 $ + 0,06 $) und etwa 0,034 $ bei gemini-3.8-flash zum Einführungspreis (0,015 $ + 0,019 $).
2. Eine lange Agentenrunde: 200K Eingabe, 50K Ausgabe
- Einführung: 200.000 / 1 Mio. x 2 $ = 0,40 $, plus 50.000 / 1 Mio. x 10 $ = 0,50 $. Gesamt 0,90 $.
- Standard: 0,80 $ + 1,00 $ = 1,80 $.
GPT-6 Astra würde 4,50 $ (2,00 $ + 2,50 $) berechnen. gemini-3.1-pro-preview berechnet 1,00 $ (0,40 $ + 0,60 $), aber 200K ist seine Schwellenwertlinie: längere Prompts werden mit 4 $/18 $ berechnet. Wenn Argon eine ähnliche Stufe erhält, kosten längere Runden mehr.
3. Eine maximale Antwort: 1 Mio. Ausgabe-Tokens
Die Ausgabe allein beträgt 1.000.000 / 1 Mio. x 10 $ = 10,00 $ (Einführung) und 20,00 $ (Standard). Fügt man einen 100K-Token-Prompt hinzu (0,20 $ Einführung, 0,40 $ Standard), kostet der Aufruf 10,20 $ oder 20,40 $.
Kein anderes Modell in der Tabelle erzeugt dies in einer synchronen Antwort: Wettbewerber begrenzen auf 128K, das vorherige Gemini Pro auf 65.536. Bei Vals' gelisteter maximaler Ausgabe von 262K kostet eine vollständige Antwort etwa 2,62 $ (Einführung) oder 5,24 $ (Standard). Die technische Seite (Timeouts, Streaming, Gateways) wird in Gemini 4 Argons 1 Mio. Ausgabe-Tokens behandelt.
4. Ein zwischengespeicherter 500K-Token-Prompt, 10-mal wiederverwendet
Angenommen, Sie senden denselben 500K-Token-Codebasis oder Vertragssatz zehnmal, mit jeweils 5K Tokens Ausgabe. Gehen Sie davon aus, dass der erste Aufruf den vollen Eingabepreis zahlt, um den Cache zu erstellen, und die nächsten neun daraus lesen.
| 10 Aufrufe, 500K Prompt, je 5K Ausgabe | Einführung | Standard |
|---|---|---|
| Eingabe, ohne Caching (10 x 500K) | $10.00 | $20.00 |
| Eingabe, zwischengespeichert (1 voll + 9 zwischengespeichert) | $1.00 + 9 x $0.05 = $1.45 | $2.00 + 9 x $0.10 = $2.90 |
| Ausgabe (10 x 5K) | $0.50 | $1.00 |
| Gesamt mit Caching | $1.95 | $3.90 |
| Gesamt ohne Caching | $10.50 | $21.00 |
Caching reduziert die Eingaberechnung um 85,5 %. Zwei Vorbehalte: Google hat nicht gesagt, ob Argon Gebühren für die Cache-Speicherung verlangt (gemini-3.1-pro-preview berechnet 4,50 $ pro 1 Mio. Tokens pro Stunde, was 2,25 $ zusätzlich kosten würde, um 500K Tokens eine Stunde lang zu halten), und ein 500K-Prompt liegt über der 200K-Grenze von 3.1 Pro. Argons Standard-Cache-Rate entspricht der von Opus 5.5 von 0,20 $, sodass die Break-Even-Logik in Claude Opus 5.5 Prompt-Caching-Kostenberechnung übernommen wird.
Preis pro Token ist nicht Kosten pro Aufgabe
Artificial Analysis listet 1,99 $ pro Aufgabe auf, um ihren Intelligence Index auf Gemini 4 Argon (Hoch) zu Einführungspreisen auszuführen; The Decoder setzt den gleichen Lauf auf 3,98 $ zu Standardpreisen. AA bewertet Argon mit 53, genauso wie GPT-6 Astra (max), das es mit 3,26 $ pro Aufgabe listet.
Der Haken ist das Token-Volumen. AA zählt ungefähr 62K Ausgabe-Tokens pro Aufgabe für Argon (hoch) gegenüber ungefähr 27K für Astra bei maximaler Einstellung, etwa 2,3-mal so viel. Ausgabe pro Aufgabe zur Einführung: 62.000 / 1 Mio. x 10 $ = 0,62 $, vs. 27.000 / 1 Mio. x 50 $ = 1,35 $ für Astra. Im Standardpreis liegt der vollständige Aufgabenwert von Argon ($3,98) laut The Decoder über den 3,26 $ von AA für Astra (max), obwohl Argons Standardtarife 60 % unter denen von Astra liegen.
Vals AI zeigt das gleiche Muster. Es listet 15,68 $ pro Test für Argon im Vals Index auf, gegenüber 32,14 $ für Claude Opus 5.5, 21,34 $ für Claude Sonnet 5.5 und 3,24 $ für GPT-6.1 Sol, und es listet Argon zum Standardpreis von 4 $/20 $ auf. Sonnet 5.5 und GPT-6.1 Sol teilen Argons Einführungspreis auf dem Papier, doch ihre Kosten pro Test liegen mehr als 6-mal auseinander.
Budgetieren Sie anhand Ihrer eigenen Token-Zählungen, nicht anhand der Preisliste.
Kostenkontrollen vor dem Start von Argon einrichten
- Ausgabe begrenzen. Bei generateContent setzt
generationConfig.maxOutputTokenseine Obergrenze. Google sagt, dass neue Modelle über die Interactions API gestartet werden. Legen Sie dort eine entsprechende Obergrenze fest, sobald die Dokumentation diese für Argon auflistet. Eine Obergrenze von 1 Mio. bedeutet eine Ausgabebegrenzung von 20 $ pro Aufruf zu Standardtarifen. - Stabile Inhalte cachen. Systemanweisungen, Schemas und Referenzdokumente, die sich über Aufrufe hinweg wiederholen, sind die Bereiche, in denen der 95%-Rabatt zum Tragen kommt.
- Den Denk-Level bewusst wählen. Google hat Argons Level noch nicht veröffentlicht. Heute ist bei gemini-3.1-pro-preview standardmäßig
highund bei gemini-3.8-flashmediumeingestellt. Wenn Argons dokumentiert sind, testen Sie, ob ein niedrigeres Level die Qualität Ihrer Aufgabe beibehält. - Nutzung überprüfen. Jede generateContent-Antwort endet mit
usageMetadata. Speichern Sie in Apidog die Anfrage mit dem Modell in einer UmgebungsvariablenGEMINI_MODEL, fügen Sie eine Nach-Antwort-Assertion hinzu, die die Kosten aus den Token-Zählungen inusageMetadataberechnet, und lassen Sie den Test fehlschlagen, wenn ein Aufruf Ihre Obergrenze überschreitet. Führen Sie ihn heute gegen gemini-3.8-flash aus; wenn Argons ID verfügbar ist, ändern Sie eine Variable und führen Sie die Suite erneut aus.
Die Berechnung für diese Assertion:
cost = uncached_input / 1,000,000 x input_rate
     + cached_input   / 1,000,000 x cached_rate
     + (output + thinking) / 1,000,000 x output_rate
Was Google noch nicht bepreist hat
Die Länge der Einführungsphase und das Startdatum für 4 $/20 $; ob Prompts über 200K mehr kosten; Batch- oder Flex-Preise (3.1 Pro hat beides, zu 1 $/2 $ Eingabe und 6 $/9 $ Ausgabe); Gebühren für Cache-Speicherung; Ratenbegrenzungen; und ob es überhaupt einen kostenlosen Tarif gibt.
FAQ
Wie viel kostet Gemini 4 Argon pro Million Tokens? 2 $ Eingabe und 10 $ Ausgabe während der Einführungsphase, danach 4 $ und 20 $. Zwischengespeicherte Eingabe ist um 95 % reduziert: 0,10 $, danach 0,20 $.
Wie lange dauert der Einführungspreis? Google hat es nicht gesagt. Der Launch-Post gibt kein Enddatum oder keine Dauer an.
Werden Denk-Tokens als Ausgabe berechnet? Bei aktuellen Gemini-Modellen ja. Google hat Argons Regeln noch nicht spezifisch dokumentiert.
Wie viel kostet eine Antwort mit 1 Mio. Ausgabe-Tokens? 10 $ zum Einführungspreis und 20 $ zum Standardpreis, vor der Eingabe.
Ist Argon günstiger als Claude Opus 5.5 oder GPT-6 Astra? Pro Token ist Standard-Argon gleich Opus 5.5 und liegt 60 % unter Astra. Pro Aufgabe hängt es vom Token-Volumen ab: Artificial Analysis hat gemessen, dass Argon etwa das 2,3-fache der Ausgabe-Tokens von Astra verwendet. Für ein günstigeres Gemini heute siehe Gemini 3.8 Flash-Preise.
Kann ich Argon heute bezahlen? Nein. Es wird nur an Partner des Fairwind-Programms ausgeliefert. Bezahlte API-Kunden und Google AI Ultra-Abonnenten folgen als Nächstes, ohne Datum.
Jetzt budgetieren, später messen
Multiplizieren Sie die Token-Zählungen Ihres aktuellen Traffics mit 2 $/10 $ und 4 $/20 $, und Sie erhalten Argons Einführungs- und Standardbereich. Erstellen Sie dann die Messung: laden Sie Apidog herunter, speichern Sie Ihre Anfrage gegen gemini-3.8-flash mit GEMINI_MODEL als Variable und fügen Sie eine Kostenprüfung für usageMetadata hinzu. Wenn Google die Modell-ID veröffentlicht, ändern Sie einen Wert und sehen Ihre tatsächlichen Kosten pro Aufruf am ersten Tag.