
Es gibt noch keine öffentliche Gemini 4 Argon API, und Google hat noch keine Modell-ID veröffentlicht. Google kündigte Argon am 30. September 2026 an, und es ist heute nur für Verteidiger des Fairwind Programms verfügbar: Eine Gruppe von Fairwind-Partnern nutzt es als verwaltetes Modell auf Gemini Enterprise. Artificial Analysis listet Google AI Studio als einzigen API-Anbieter für Argon auf, jedoch ohne Geschwindigkeits- oder Latenzdaten, was eher auf einen vorab genehmigten Pre-Release-Zugang als auf einen Endpunkt zutrifft, für den man sich anmelden kann. Wenn der breitere Rollout beginnt, sagt Google, dass dieser „mit zahlenden API-Kunden und Google AI Ultra-Abonnenten“ startet, sodass ein kostenpflichtiger Gemini API-Schlüssel Sie an erster Stelle positioniert.
Diese Lücke zwischen Ankündigung und Zugang ist Zeit, die Sie nutzen können. Dieser Leitfaden trennt, was Google über die Argon API bestätigt hat, von dem, was nicht bestätigt wurde, und führt Sie dann durch Code, den Sie heute auf Gemini 3.8 Flash ausführen können, sodass der Wechsel zu Argon zu einer Änderung einer einzigen Variable wird. Sie erstellen die Anfrage, richten eine Go-Live-Benachrichtigung ein, mocken die Antwort in Apidog und fügen eine Kostenobergrenze zu den Argon-Preisen hinzu. Für das Modell selbst beginnen Sie mit was Gemini 4 Argon ist; für die Rollout-Phasen siehe den Leitfaden zum Gemini 4 Argon Veröffentlichungsdatum.
Was über die Gemini 4 Argon API bestätigt ist und was nicht
Googles Einführungsbeitrag nennt Preise und ein Ausgabelimit. Fast alles andere, was eine Integration benötigt, ist noch unveröffentlicht.
| Posten | Status | Details |
|---|---|---|
| Eingabepreis | Bestätigt | 2 $ pro 1 Million Tokens (Einführung), 4 $ nach der Einführungsphase |
| Ausgabepreis | Bestätigt | 10 $ pro 1 Million Tokens (Einführung), 20 $ danach |
| Gecachter Input | Bestätigt | 95 % Rabatt auf Input: 0,10 $ Einführung, 0,20 $ Standard |
| Ausgabelimit | Bestätigt | 1 Million Tokens, erhöht von 64K |
| API-Oberfläche | Signalisiert | Googles Dokumente besagen, dass alle neuen Modelle auf der Interactions API starten |
| Modell-ID | Nicht veröffentlicht | Fehlt auf der Modellseite, der Preisseite und im Änderungsverzeichnis |
| Eingabe-Kontextfenster | Nicht veröffentlicht | Googles Langkontext-Evaluierung verwendete Prompts bis zu 1 Million Tokens, aber das ist keine Spezifikation |
| Denk-Level | Nicht veröffentlicht | Evaluierungen liefen mit den „höchsten Denkeinstellungen“; Namen und Standardeinstellung unbekannt |
| Ratenbegrenzungen | Nicht veröffentlicht | Keine Stufen angekündigt |
| Batch-Unterstützung | Nicht veröffentlicht | Keine Batch- oder Flex-Preise |
| Lang-Prompt-Stufe | Nicht veröffentlicht | 3.1 Pro berechnet mehr über 200K; Argons Regel ist ungenannt |
| Dauer der Einführungsphase | Nicht veröffentlicht | Kein Enddatum für 2 $/10 $ |
Zwei Zeilen verdienen einen genaueren Blick. Die Zeile „API-Oberfläche“ stammt aus den Interactions API-Dokumenten, die besagen, dass neue Modelle „auf der Interactions API eingeführt werden.“ Argon ist ein neues Modell, erwarten Sie es also zuerst dort; Google hat nicht gesagt, ob generateContent es bedienen wird. Die Ausgabezahl ist Googles angegebenes Limit für das Modell, aber Vals AI listet eine maximale Ausgabe von 262K für die von ihnen getestete Konfiguration auf, also gehen Sie nicht davon aus, dass jeder Endpunkt am ersten Tag die volle Million liefert. Unser Leitfaden für 1 Million Ausgabe-Tokens behandelt, welche Auswirkungen dieses Limit auf Streaming, Timeouts und Speicherung hat.
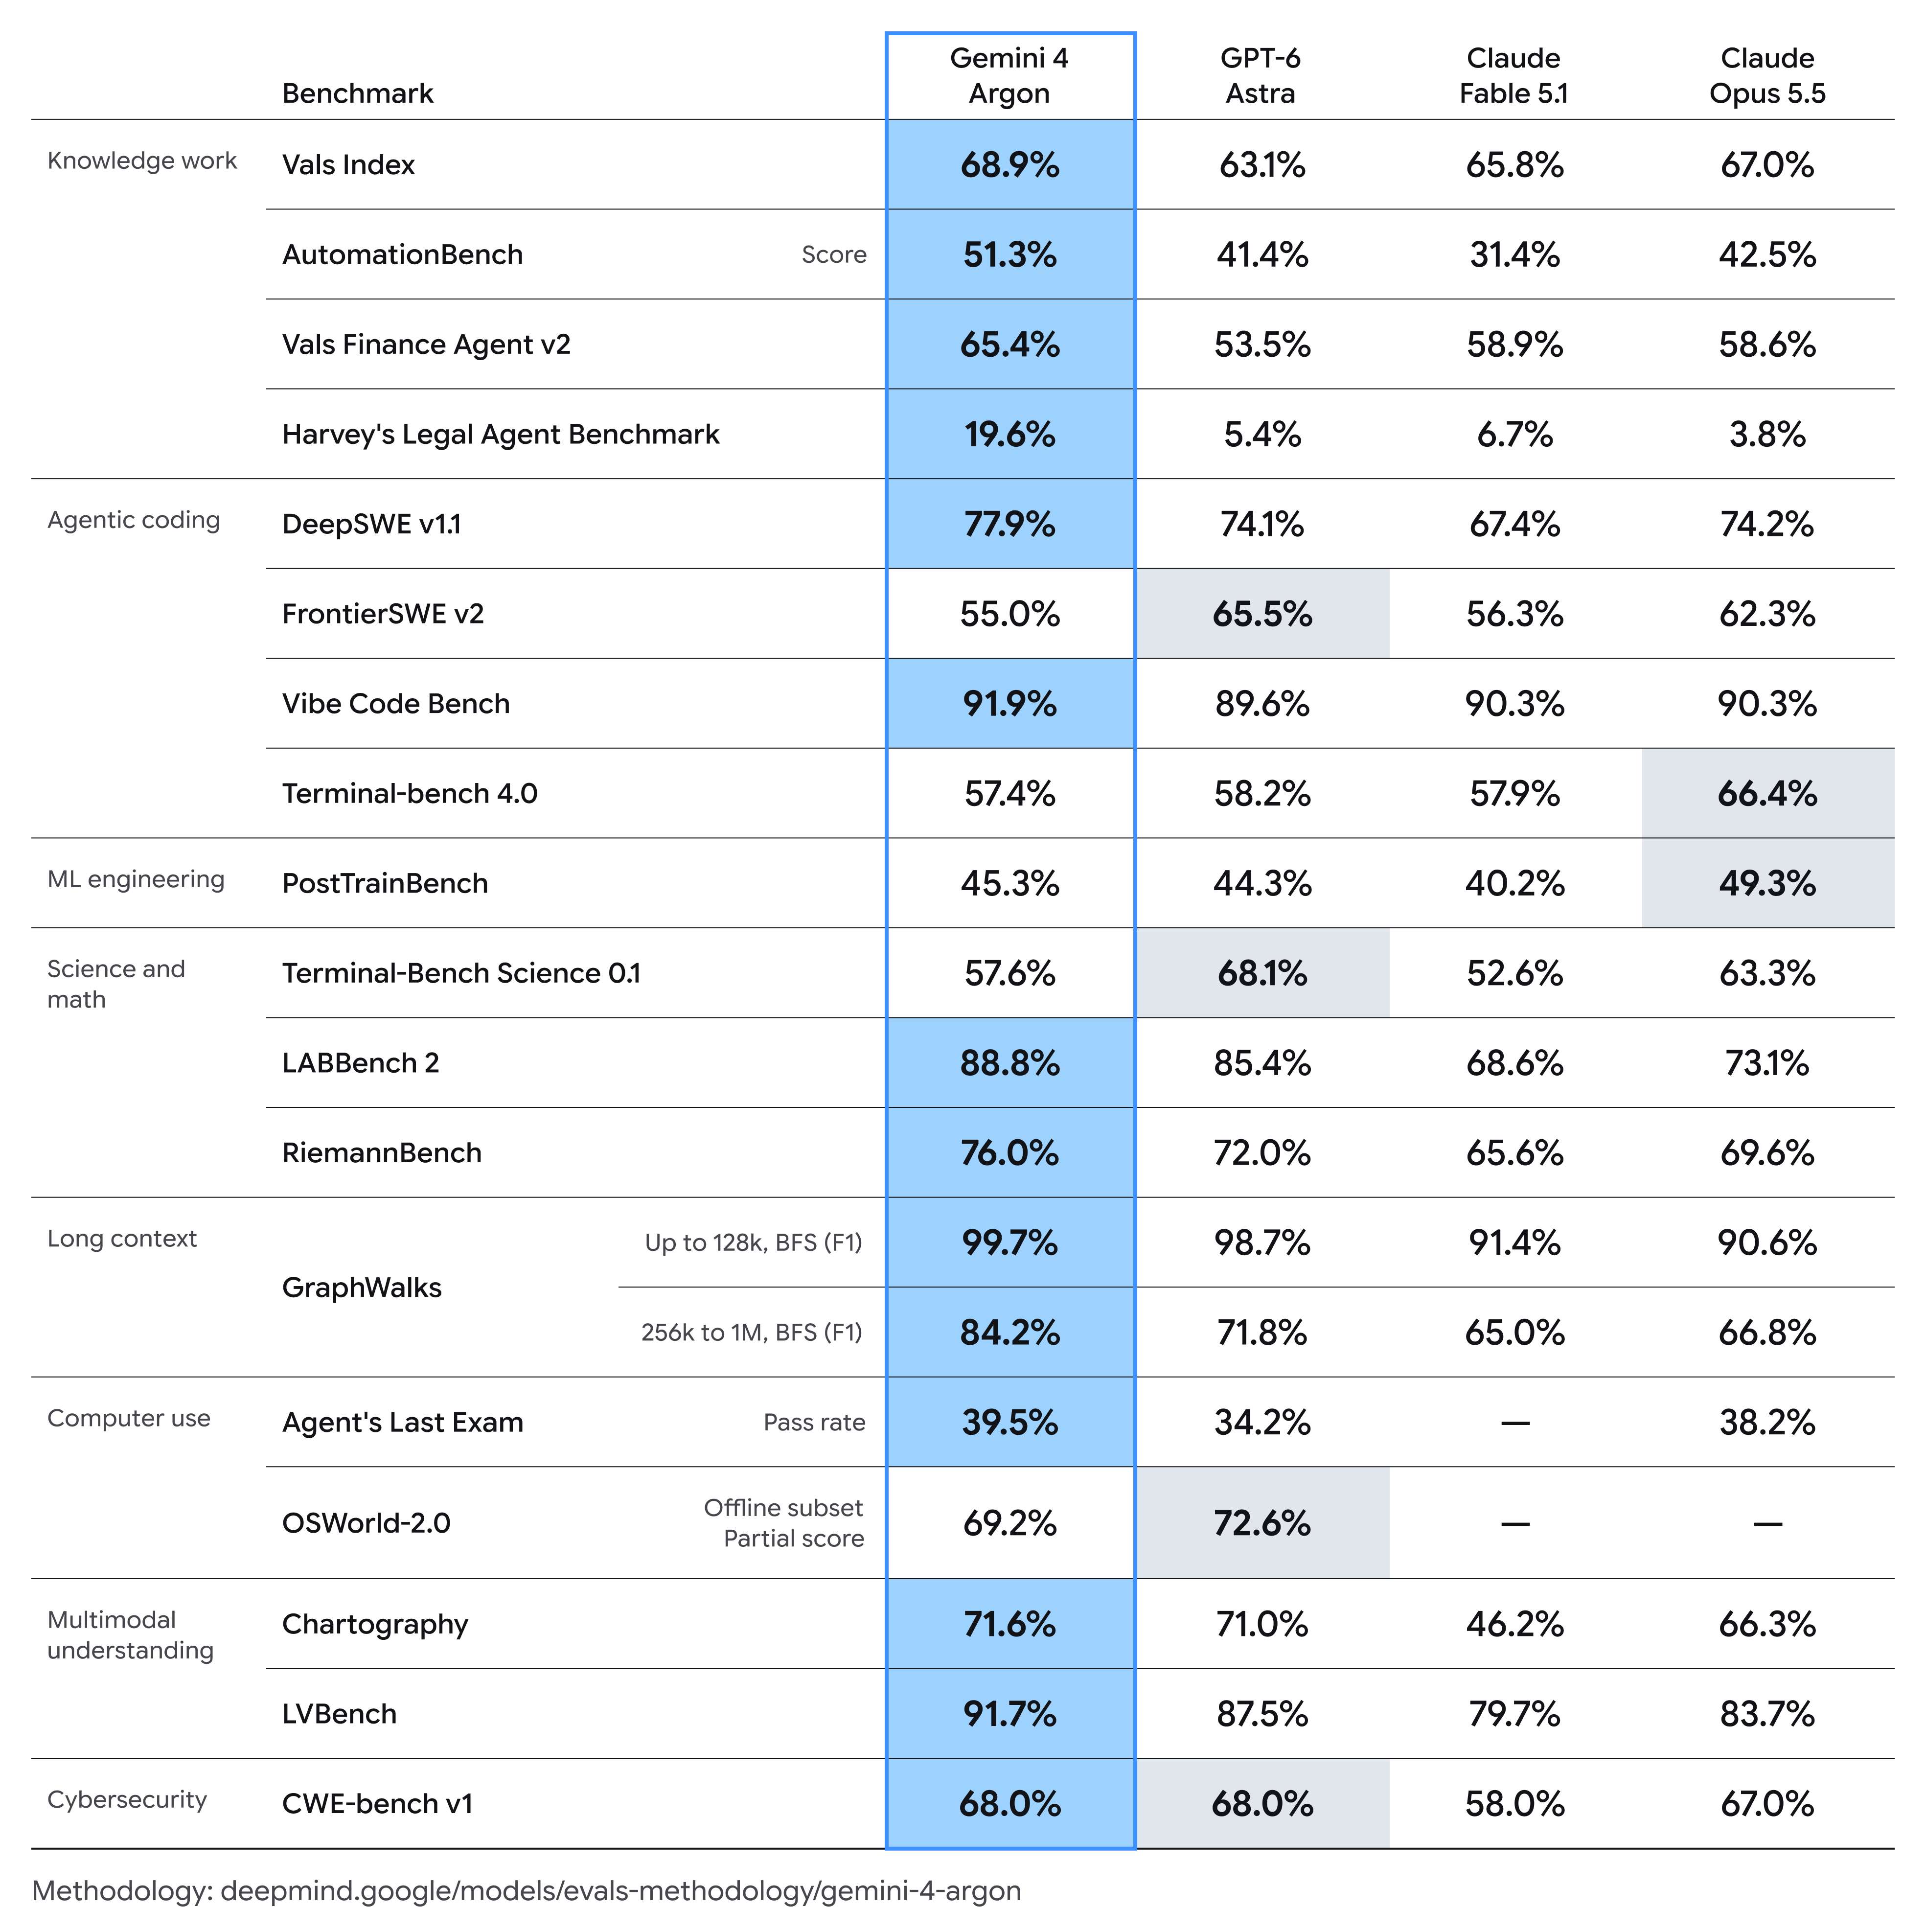
Zum Preis reicht hier ein Absatz. Eine Anfrage mit einem 20.000-Token-Prompt und 5.000 Ausgabe-Tokens kostet 20.000 x 2 $/1M + 5.000 x 10 $/1M = 0,04 $ + 0,05 $ = 0,09 $ zu Einführungspreisen und 0,18 $ zu den Standardpreisen von 4 $/20 $. Argons Einführungspreis für die Ausgabe (10 $) liegt unter dem von Gemini 3.1 Pro Preview (12 $), und sein Standardpreis entspricht genau dem von Claude Opus 5.5. Die Preisübersicht für Gemini 4 Argon behandelt alle Szenarien, einschließlich gecachter Eingaben und einer maximalen 1-Million-Token-Antwort.
Verwenden Sie keine fest codierte Modell-ID, die Sie online gefunden haben
Suchen Sie nach der Argon Modell-ID und Sie werden Zeichenfolgen auf Benchmark-Seiten, Aggregatoren und Open-Source-Pull-Requests finden. Dies sind Platzhalter. Vals AI verwendet einen eigenen Slug für seine Modellseite, ein GitHub-Pull-Request fügt eine ID „vorläufig“ hinzu, und der OpenRouter-ähnliche Pfad führt zu einer „Seite nicht gefunden“-Meldung. Google hat keine davon bestätigt, und mehrere Quellen warnen ausdrücklich davor, eine Vermutung fest zu codieren.
Eine geratene ID führt auf die am wenigsten hilfreiche Weise zum Fehlschlag: ein 404-Fehler in der Produktion am Bereitstellungstag oder ein stiller Fallback, wenn Ihr Wrapper Fehler zu breit fängt. Bewahren Sie stattdessen den Modellnamen in der Konfiguration auf. In jedem der folgenden Beispiele stammt das Modell aus einer Umgebungsvariablen GEMINI_MODEL, die standardmäßig gemini-3.8-flash verwendet, ein stabiles Modell, das Sie heute aufrufen können. Wenn Google Argons ID veröffentlicht, ändern Sie einen Wert.
Bereiten Sie Ihren Code auf Gemini 3.8 Flash vor
Gemini 3.8 Flash (gemini-3.8-flash) läuft auf denselben Endpunkten, Headern und Antwortstrukturen, die Argon voraussichtlich verwenden wird, zu Preisen von 0,75 $/3,75 $ pro 1 Million Tokens bis zum 31. Dezember 2026. Ihr Schlüssel befindet sich in GEMINI_API_KEY; fügen Sie ihn niemals in den Code ein. Die vollständige Einrichtung finden Sie in unserem Gemini 3.8 Flash API-Leitfaden.
Schritt 1: Senden Sie eine Interactions API-Anfrage
Die Interactions API ist Googles primäre API, die seit Juni 2026 allgemein verfügbar ist. Halten Sie sowohl das Modell als auch das Denk-Level in Variablen, da die Level-Namen von Argon nicht veröffentlicht sind.
MODEL="${GEMINI_MODEL:-gemini-3.8-flash}"
THINKING="${GEMINI_THINKING:-medium}"

curl -s -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"model\": \"${MODEL}\",
    \"input\": \"List the retry rules a REST client should follow for HTTP 429.\",
    \"generation_config\": {\"thinking_level\": \"${THINKING}\"}
  }"
Das Python SDK benötigt google-genai 2.3.0 oder neuer für die Interactions API:
# pip install "google-genai>=2.3.0"
import os
from google import genai

MODEL = os.environ.get("GEMINI_MODEL", "gemini-3.8-flash")
THINKING = os.environ.get("GEMINI_THINKING", "medium")

client = genai.Client()  # reads GEMINI_API_KEY from the environment
interaction = client.interactions.create(
    model=MODEL,
    input="List the retry rules a REST client should follow for HTTP 429.",
    generation_config={"thinking_level": THINKING},
)
print(interaction.output_text)
```
Auf 3.8 Flash sind die gültigen Level low, medium (der Standard) und high; minimal gibt HTTP 400 zurück. Unser Leitfaden zu Denk-Level erklärt die Kompromisse. Für mehrstufige Arbeit übergeben Sie die ID der vorherigen Antwort als previous_interaction_id und senden Sie store: false, um die serverseitige Speicherung abzuwählen.
Schritt 2: Halten Sie den generateContent-Pfad funktionsfähig
Die meisten bestehenden Codes rufen den älteren generateContent-Endpunkt auf, der laut Google weiterhin vollständig unterstützt wird. Hier ist die gleiche Anfrage:
curl -s "https://generativelanguage.googleapis.com/v1beta/models/${MODEL}:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"contents\": [{\"parts\": [{\"text\": \"List the retry rules a REST client should follow for HTTP 429.\"}]}],
    \"generationConfig\": {\"thinkingConfig\": {\"thinkingLevel\": \"${THINKING}\"}}
  }"
Beachten Sie, wo das Denk-Level liegt: generation_config.thinking_level bei Interactions, generationConfig.thinkingConfig.thinkingLevel hier. Wenn Ihr Client beides umschließt, leiten Sie neue Modelle standardmäßig über Interactions. Tool-Definitionen benötigen die gleiche Sorgfalt; siehe Gemini 3.8 Flash Funktionsaufrufe.
Schritt 3: Planen Sie einen Go-Live-Check mit models.list
Aktualisieren Sie nicht das Änderungsverzeichnis. Fragen Sie die API. Der Modelle-Endpunkt gibt die verfügbaren Modelle mit ihren Token-Limits und unterstützten Methoden zurück:
import os, sys, requests

resp = requests.get(
    "https://generativelanguage.googleapis.com/v1beta/models",
    params={"pageSize": 1000},
    headers={"x-goog-api-key": os.environ["GEMINI_API_KEY"]},
    timeout=30,
)
resp.raise_for_status()
hits = [m for m in resp.json().get("models", []) if "argon" in m["name"].lower()]
for m in hits:
    print(m["name"], "in:", m.get("inputTokenLimit"),
          "out:", m.get("outputTokenLimit"), m.get("supportedGenerationMethods"))
sys.exit(1 if hits else 0)  # a failed run is the alert
```
Führen Sie es stündlich von Cron oder einem CI-Zeitplan aus, unter Verwendung des Schlüssels, den Ihre Produktions-App verwendet. Als wir diesen Aufruf am 1. Oktober 2026 mit einem kostenpflichtigen Projektschlüssel ausführten, wurden 61 Modelle zurückgegeben, kein nextPageToken und kein Name, der „argon“ enthielt. An dem Tag, an dem es übereinstimmt, sagt Ihnen der Eintrag drei Dinge auf einmal: den echten Modellnamen, ob outputTokenLimit die vollen 1 Million beträgt und welche Methoden aufgeführt sind.
Schritt 4: Mocken Sie die Antwort, damit der Client vor dem Zugriff erstellt wird
Sie benötigen Argon nicht, um den Code zu erstellen, der Argon konsumiert. Speichern Sie die Anfrage aus Schritt 2 in Apidog mit GEMINI_API_KEY und GEMINI_MODEL als Umgebungsvariablen, senden Sie sie einmal an 3.8 Flash und extrahieren Sie die echte Antwort als Antwortbeispiel in den Endpunkt. Apidogs standardmäßiger Smart Mock generiert Daten aus dem Schema, stellen Sie daher die Standard-Mock-Methode des Projekts auf „Response example first“ (Projekt-Einstellungen, Feature-Einstellungen, Mock-Einstellungen) ein. Die Mock-URL gibt dann Ihre gespeicherte Antwort zurück, sodass Ihr Frontend, Ihre Queue-Worker und Parser ohne Token-Ausgaben damit arbeiten können.
Machen Sie sich klar, was dieser Mock ist: das aktuelle Gemini-Antwortschema, nicht ein Argon-spezifisches, da Google keines veröffentlicht hat. Es ist immer noch die richtige Annahme, da Argon auf derselben API erwartet wird. Um eine umfangreiche Argon-Antwort zu proben, bearbeiten Sie die usageMetadata des Beispiels auf hohe Zählwerte und bestätigen Sie, dass Ihr Abrechnungs- und Warncode reagiert.
Schritt 5: Bestätigen Sie usageMetadata und eine Kostenobergrenze
Jede generateContent-Antwort enthält usageMetadata. Fügen Sie ein Post-Processor-Skript in Apidog hinzu, das jede Antwort zu Argons Standardtarifen bepreist, damit ein Test fehlschlägt, bevor eine Rechnung anfällt:
// Apidog Post-Prozessor: Bepreist diese Antwort zu den Standardtarifen von Gemini 4 Argon
const u = pm.response.json().usageMetadata;
const IN = 4 / 1e6;   // USD pro Input-Token nach der Einführungsphase
const OUT = 20 / 1e6; // USD pro Output-Token; "Denken" wird bei aktuellen Gemini-Modellen als Output abgerechnet
const out = (u.candidatesTokenCount || 0) + (u.thoughtsTokenCount || 0);
const cost = u.promptTokenCount * IN + out * OUT;
pm.test("usageMetadata ist vorhanden", () => pm.expect(u).to.be.an("object"));
pm.test("Kosten unter 0,10 $ zu Argon-Tarifen", () => pm.expect(cost).to.be.below(0.10));
```
Wählen Sie die Obergrenze pro Anfrage; 0,10 $ passt zu einem kurzen Prompt wie diesem. Google hat nicht angegeben, wie Argon Denk-Tokens abrechnet, daher geht das Skript von der aktuellen Gemini-Regel aus. Behalten Sie dieselbe gespeicherte Anfrage bei und führen Sie sie jetzt gegen 3.8 Flash und später gegen Argon aus: Der Unterschied in Token-Anzahl und Kosten ist Ihr Regressionsvergleich.
Häufig gestellte Fragen (FAQ)
Ist die Gemini 4 Argon API verfügbar? Nicht öffentlich. Argon wird nur an eine Gruppe von Fairwind-Programmpartnern ausgerollt, die es über Gemini Enterprise nutzen. Zahlende API-Kunden und Google AI Ultra-Abonnenten folgen als Nächstes, ein Datum steht noch nicht fest.
Was ist die Gemini 4 Argon Modell-ID? Google hat keine veröffentlicht. Zeichenfolgen auf Drittanbieter-Websites sind Platzhalter, bewahren Sie das Modell daher in einer Umgebungsvariablen auf und beobachten Sie models.list.
Wie viel wird die Gemini 4 Argon API kosten? 2 $ für den Input und 10 $ für den Output pro 1 Million Tokens während einer nicht näher bestimmten Einführungsphase, danach 4 $ und 20 $. Gecachter Input ist 95 % günstiger. Siehe Gemini 4 Argon Preise.
Wird Argon mit generateContent funktionieren? Google hat sich dazu nicht geäußert. Die Dokumente besagen, dass alle neuen Modelle auf der Interactions API starten, daher sollte man auf Interactions aufbauen und generateContent als Fallback behandeln.
Gibt mir Google AI Ultra API-Zugang? Nein. AI Ultra ist ein Verbraucherabonnement, kein API-Schlüssel. Google sagt, dass der API-Zugang mit zahlenden API-Kunden beginnt.
Ihr nächster Schritt
Setzen Sie GEMINI_MODEL in jeder Umgebung, planen Sie den models.list-Check und speichern Sie die Interactions- und generateContent-Anfragen mit der angehängten Kostenbestätigung. Laden Sie Apidog herunter, um diese Anfragen, Mocks und Tests in einem Arbeitsbereich zu behalten, und ändern Sie dann eine Variable, wenn Google die ID veröffentlicht.