
Gemini 4 Argons Schlagzeilenzahl, 1 Mio. Tokens, ist seine Ausgabebegrenzung, nicht sein Kontextfenster. Google gibt an, dass eine einzelne Argon-Antwort bis zu 1 Million Tokens umfassen kann, was etwa dem 16-fachen der bisherigen Grenze von 64K entspricht, und hat das Eingabefenster von Argon überhaupt nicht veröffentlicht. Es gibt auch noch nichts aufzurufen: Argon ist heute nur für Teilnehmer des Fairwind-Programms verfügbar, zahlende API-Kunden folgen, sobald Google den Zugang öffnet (siehe den Leitfaden zu Veröffentlichungsdatum und Zugang).
Eine so lange Antwort bricht drei Annahmen, auf denen die meisten API-Stacks basieren: Ein Aufruf ist in Sekunden abgeschlossen, der Hauptteil passt in den Speicher, und eine Anfrage hat geringe, vorhersehbare Kosten. Dieser Leitfaden behandelt die Kosten einer maximalen Antwort, Streaming, Timeouts, Ausgabebegrenzungen, Speicherung und wie man all dies in Apidog testet, bevor der Zugang verfügbar ist. Für eine Modellübersicht siehe was Gemini 4 Argon ist; für Anfrageformen siehe den Gemini 4 Argon API-Leitfaden.
1 Mio. Ausgabe-Tokens ist kein 1 Mio. Kontextfenster
Mehrere Seiten, die für Argon ranken, beschreiben die 1-Mio.-Zahl als Kontextfenster, und eine Schlagzeile bezeichnet es als „16-fach größeres Kontextfenster“. Das ist falsch herum. Googles Startpost sagt, dass es „die Ausgabetoken-Grenze des Modells auf branchenführende 1 Mio. Tokens“ erweitert hat. Diese 64K entsprechen der 65.536-Token-Ausgabebegrenzung von Gemini 3.1 Pro Preview, Googles vorherigem Top-Pro-Modell.
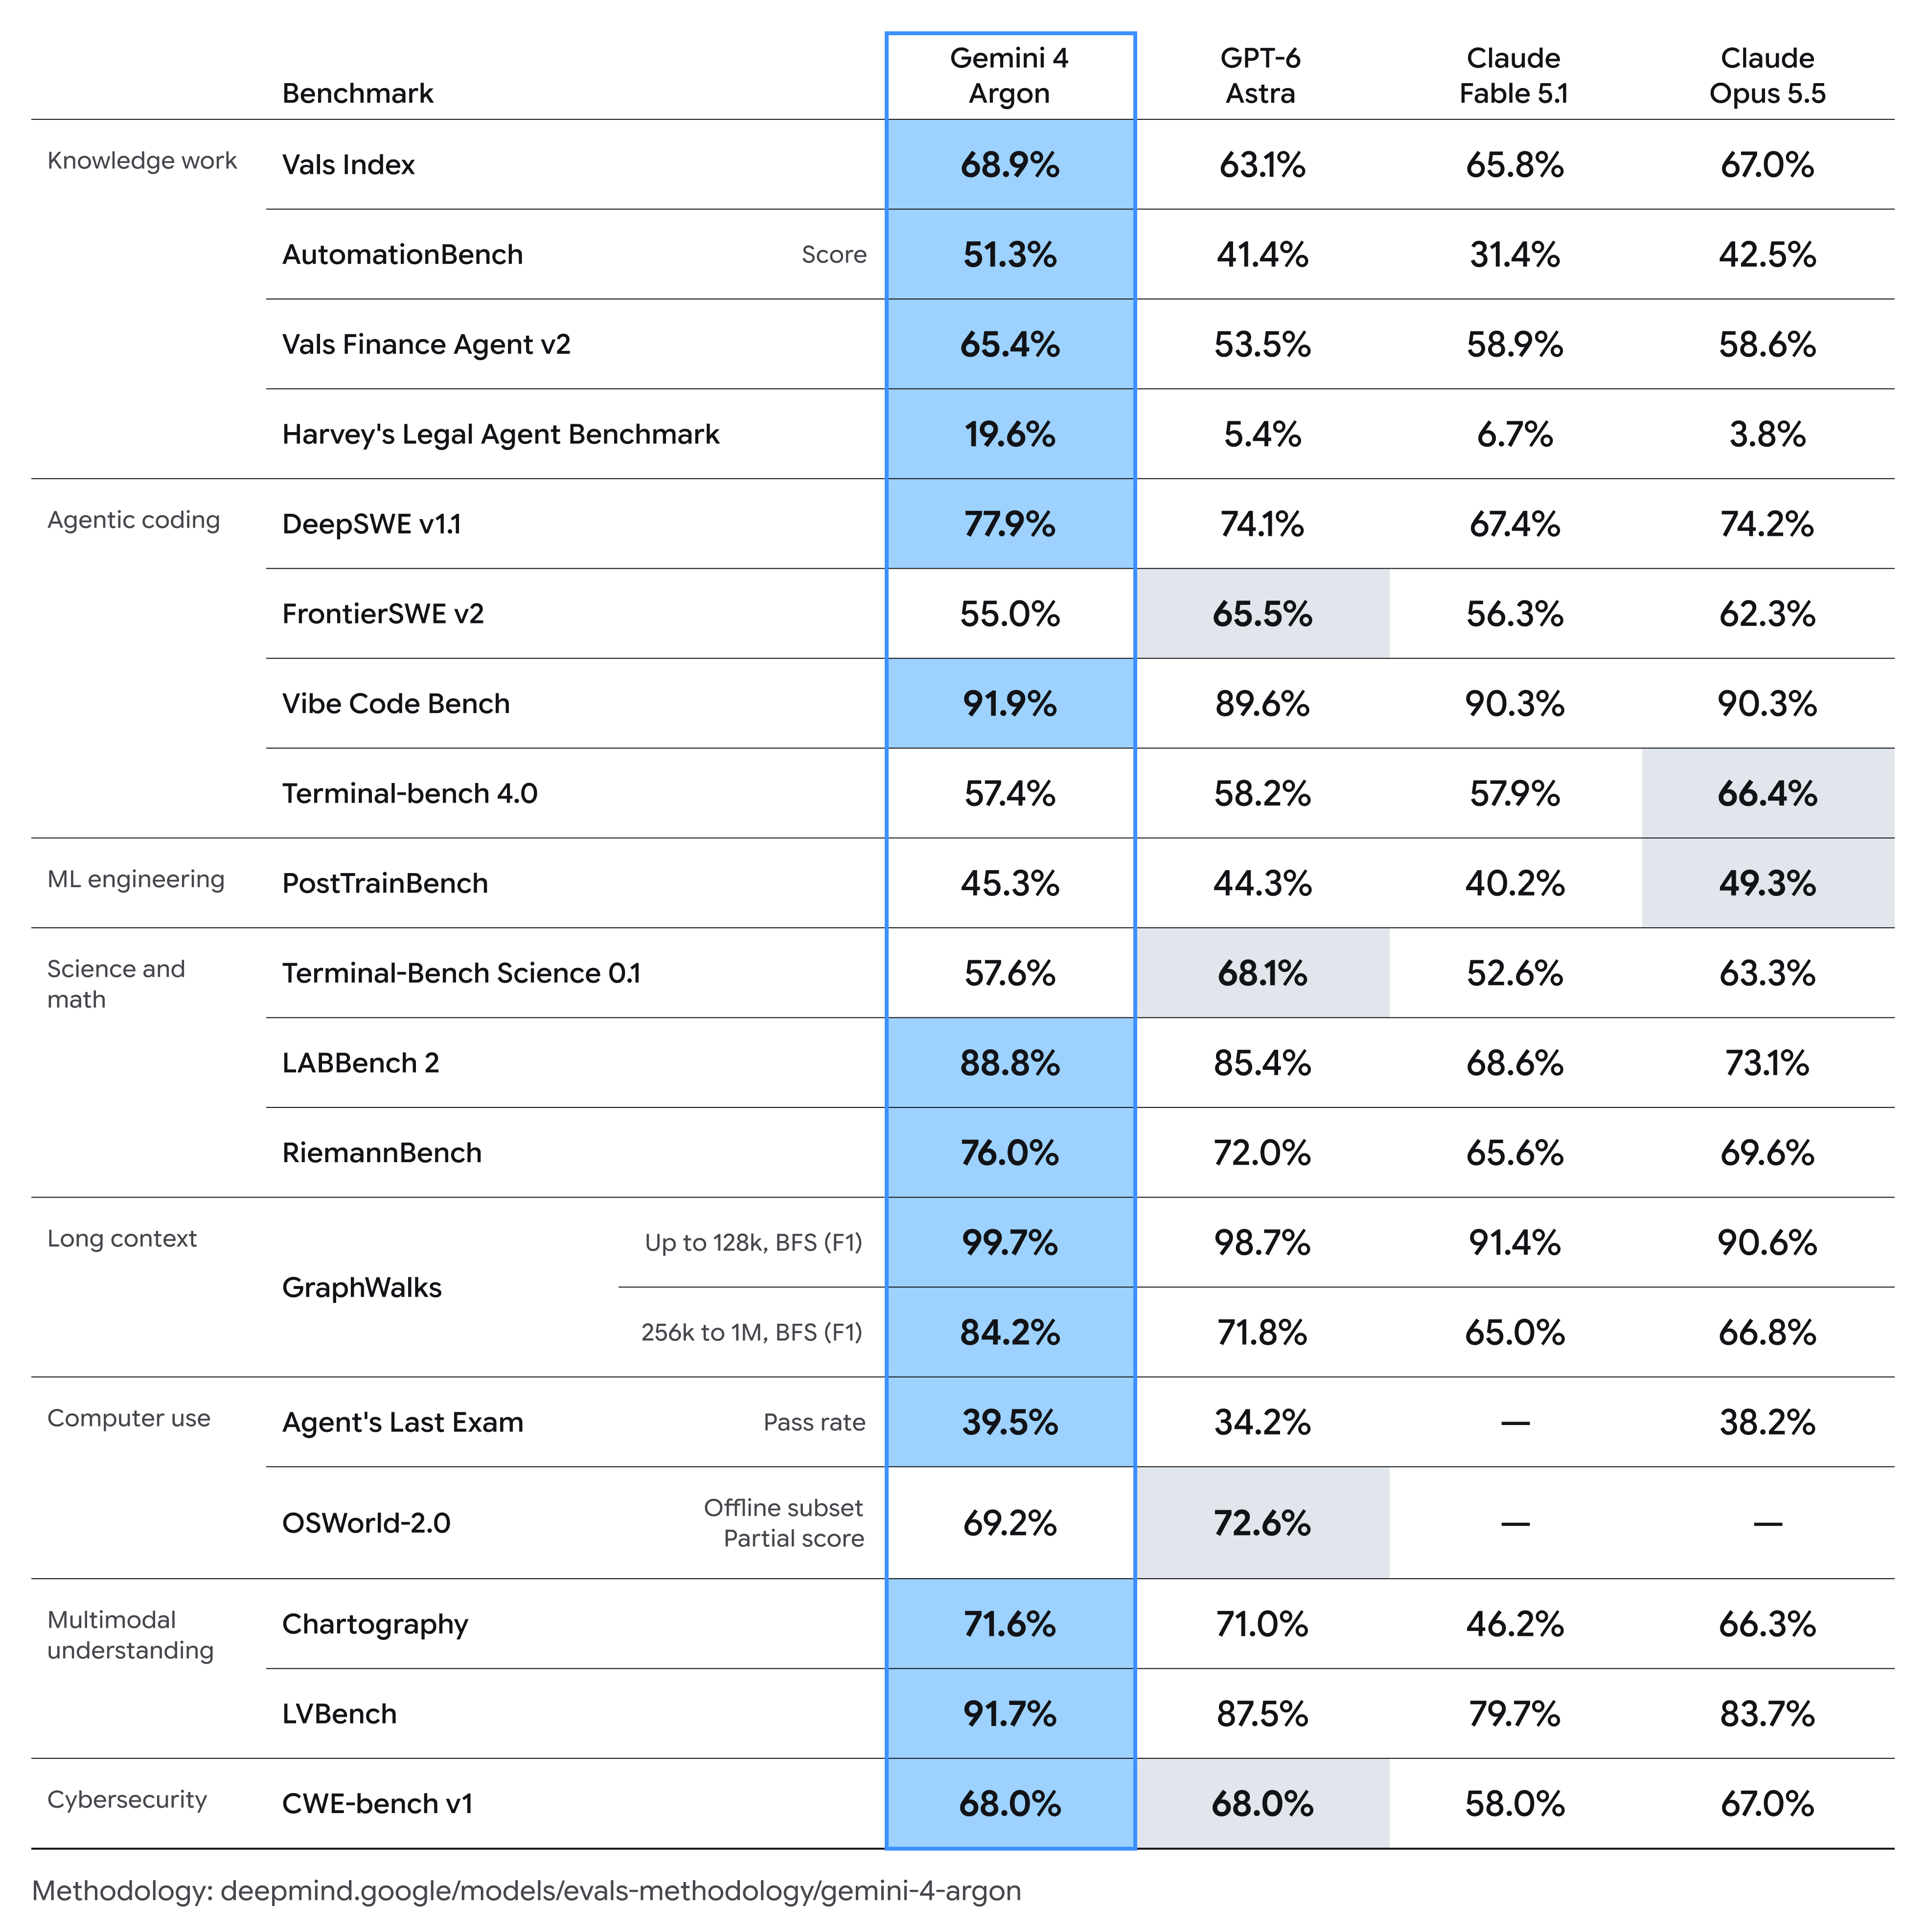
Input ist eine separate Zahl, die Google nicht angegeben hat. Seine Langkontext-Evaluierung, beschrieben in der Evaluierungsmethodik, verwendete Prompts zwischen 256K und 1M Tokens. Das ist eine Benchmark-Untermenge, keine Spezifikation. Auch auf der Ausgabeseite gibt es einen Vorbehalt: Vals AI listet eine maximale Ausgabe von 262K für die getestete Argon-Konfiguration auf. Google gibt an, dass die Grenze des Modells 1M beträgt; mindestens ein externer Evaluator sah eine niedrigere Grenze am verwendeten Endpunkt.
| Modell | Maximale Ausgabe pro Antwort | Eingabe- oder Kontextfenster |
|---|---|---|
| Gemini 4 Argon | 1 Mio. (Googles angegebene Grenze) | Nicht veröffentlicht |
| Gemini 3.1 Pro Preview | 65,536 | 1.048.576 |
| Gemini 3.8 Flash | 65,536 | 1.048.576 |
| GPT-6 Astra | 128.000 | 1.050.000 (922K maximale Eingabe) |
| Claude Opus 5.5 | 128K (300K im Batch mit einem Beta-Header) | 1 Mio. |
Jeder Wettbewerber begrenzt die synchrone Ausgabe auf 128K, Argons angegebene Grenze ist also etwa 8-mal höher. Googles Begründung ist die Tiefe der Argumentation: Mit Spielraum kann das Modell „Hunderttausende von Tokens in einem einzigen Durchlauf generieren“ und schwierige Probleme in einem einzigen Schritt lösen. Wie andere Anbieter lange Läufe handhaben, siehe Claude Opus 5.5s 18-Stunden-Aufgaben und den GPT-6 Astra API-Leitfaden.
Was eine maximal ausgelastete Antwort kostet
Preisen Sie zuerst die Obergrenze ein. Die Ausgabe wird während der Einführungsphase von Argon mit 10 $ pro 1 Mio. Tokens und danach mit 20 $ berechnet, sodass eine vollständige Antwort kostet:
- Einführung: 1.000.000 x 10 $/1 Mio. = 10,00 $ Ausgabe
- Standard: 1.000.000 x 20 $/1 Mio. = 20,00 $ Ausgabe
Der Input kommt noch dazu. Ein Prompt mit 200.000 Tokens kostet zusätzlich 200.000 x 2 $/1 Mio. = 0,40 $ zu Einführungspreisen oder 0,80 $ zu Standardpreisen, sodass ein einzelner maximaler Aufruf 10,40 $ oder 20,80 $ kostet. Ein nächtlicher Job, der 100 davon ausführt, kostet zu Einführungspreisen 1.040 $.
Denkprozesse machen dies schwerer nachzuvollziehen. Bei aktuellen Gemini-Modellen werden Denk-Tokens als Ausgabe abgerechnet; Google hat nicht mitgeteilt, ob Argon dieser Regel folgt oder ob Denkprozesse zur 1-Mio.-Grenze zählen. So oder so kann eine kurze, sichtbare Antwort immer noch eine hohe Ausgaberechnung verursachen. Der Preisleitfaden für Gemini 4 Argon enthält weitere Szenarien, einschließlich zwischengespeicherter Eingaben mit 95 % Rabatt.
Warum Streaming zwingend erforderlich ist
Ein nicht-streaming-fähiger Aufruf gibt nichts zurück, bis die gesamte Antwort abgeschlossen ist. Bei Hunderttausenden von Tokens ist das eine lange, stille Verbindung, und Idle-Timeouts in Ihrem Stack können diese schließen, bevor das erste Byte eintrifft.
Streamen Sie stattdessen. Ersetzen Sie bei generateContent die Methode durch :streamGenerateContent?alt=sse, und Google sendet Server-Sent Events, einen Teilstück der Kandidaten pro Event. Lesen Sie jedes Event, sobald es ankommt, und schreiben Sie es aus; sammeln Sie nicht zuerst den gesamten Inhalt. Dies läuft heute auf Gemini 3.8 Flash, wobei das Modell in einer Variable enthalten ist, da Google die Modell-ID von Argon nicht veröffentlicht hat (die Einrichtung finden Sie in unserem Gemini 3.8 Flash API-Leitfaden):
import json, os, requests

MODEL = os.environ.get("GEMINI_MODEL", "gemini-3.8-flash")
URL = ("https://generativelanguage.googleapis.com/v1beta/models/"
       f"{MODEL}:streamGenerateContent?alt=sse")
body = {
    "contents": [{"parts": [{"text": "Write a test plan for every endpoint in a payments API."}]}],
    "generationConfig": {"maxOutputTokens": 60000},
}
usage = None
with requests.post(URL, json=body, stream=True, timeout=(10, 120),
                   headers={"x-goog-api-key": os.environ["GEMINI_API_KEY"]}) as r, \
        open("response.txt", "a", encoding="utf-8") as out:
    r.raise_for_status()
    for line in r.iter_lines(decode_unicode=True):
        if not line or not line.startswith("data:"):
            continue
        event = json.loads(line[5:])
        for cand in event.get("candidates", []):
            for part in cand.get("content", {}).get("parts", []):
                out.write(part.get("text", ""))
        out.flush()
        usage = event.get("usageMetadata", usage)
print(usage)
timeout=(10, 120) setzt ein 10-Sekunden-Verbindungs-Timeout und ein 120-Sekunden-Lese-Timeout. Bei requests ist das Lese-Timeout die längste Lücke zwischen Bytes, nicht die Gesamtdauer, sodass ein Stream, der ständig sendet, so lange laufen kann, wie er benötigt. Jeder Chunk wird bei Ankunft auf die Festplatte geschrieben. Bei 3.8 Flash enthält jedes Event laufende usageMetadata, sodass das letzte Event Ihnen die endgültigen Token-Zahlen zur Protokollierung und Abrechnung liefert.
Timeouts bei jedem Hop
Ihr Client ist ein Hop. Ein langer Stream durchläuft auch einen Reverse Proxy, ein API-Gateway, einen Load Balancer und möglicherweise eine serverlose Laufzeitumgebung, und jeder von ihnen kann die Antwort vorzeitig beenden:
| Hop | Was zu prüfen ist | Symptom bei Fehlfunktion |
|---|---|---|
| HTTP-Client | Lese- oder Idle-Timeout, plus eventuelles Gesamt-Anfrage-Timeout | Ausnahmen mitten im Stream nur bei langen Antworten |
| Reverse Proxy | Lese-Timeout und Antwort-Buffering für text/event-stream |
Events kommen in Schüben an, oder der Stream bricht ab |
| API-Gateway | Maximale Anfragedauer | Anfragen schlagen bei jeder Ausführung zur gleichen abgelaufenen Zeit fehl |
| Load Balancer | Idle-Timeout | Abbrüche während langer Pausen vor dem ersten Event |
| Serverlose Funktion | Maximale Ausführungszeit | Die Funktion endet, während das Modell noch schreibt |
Achten Sie auf einen festen Abbruchpunkt. Wenn lange Antworten immer zur gleichen abgelaufenen Zeit fehlschlagen, hat ein Hop eine harte Dauerbegrenzung, die Streaming nicht beheben kann, und diese Arbeit muss vom Anfragepfad verlagert werden.
Lange Jobs im Hintergrund ausführen
Für die längsten Jobs verlagern Sie die Arbeit von einer Live-Verbindung. Die Interactions API unterstützt die Hintergrundausführung für langlaufende Aufgaben mittels background=true. Hintergrundausführungen hängen von gespeicherten Interaktionen ab: Die Dokumentation besagt, dass store=false mit der Hintergrundausführung inkompatibel ist, lassen Sie also die Speicherung für diese Anfragen aktiviert. Zum Abrufen einer abgeschlossenen Hintergrundinteraktion folgen Sie den Google-Dokumenten; raten Sie nicht bei Polling-Endpunkten. Da Google angibt, dass neue Modelle auf der Interactions API starten, planen Sie, dass Argons lange Jobs dort ausgeführt werden.
Ausgabe bewusst begrenzen
Die 1-Mio.-Grenze ist eine Obergrenze, kein Ziel. Bei generateContent begrenzt generationConfig.maxOutputTokens jede Antwort; das Streaming-Beispiel setzt 60.000. Bei 3.8 Flash zählen Denkprozesse zu dieser Begrenzung: Unser Testlauf, der auf 2.000 begrenzt war, lieferte 1.340 Denk-Tokens und 656 sichtbare Tokens zurück. Bestätigen Sie für die Interactions API das Feld für die Ausgabebegrenzung in Googles Dokumentation, bevor Sie sich darauf verlassen. Wählen Sie dann die Begrenzung basierend auf den Kosten, die Sie pro Aufruf akzeptieren:
| Ausgabebegrenzung | Worst-Case-Ausgabekosten, Standard (20 $/1 Mio.) | Einführung (10 $/1 Mio.) |
|---|---|---|
| 64.000 | 64.000 x 20 $/1 Mio. = 1,28 $ | 0,64 $ |
| 128.000 | 2,56 $ | 1,28 $ |
| 500.000 | 10,00 $ | 5,00 $ |
| 1.000.000 | 20,00 $ | 10,00 $ |
Eine Antwort, die die Begrenzung erreicht, wird frühzeitig gestoppt und sollte als unvollständig betrachtet werden. Überprüfen Sie den finishReason des letzten Events: MAX_TOKENS bedeutet, dass die Begrenzung sie abgeschnitten hat. Fahren Sie dann entweder in einem weiteren Durchgang fort oder erhöhen Sie die Begrenzung für diesen einen Job.
Große Ausgaben ohne Buffering speichern und parsen
Eine Million Tokens sind Megabytes an Text pro Antwort. Ein paar Regeln verhindern, dass dies einen Worker lahmlegt:
- Schreiben Sie Chunks, sobald sie ankommen, in eine Datei oder einen Multipart-Objekt-Upload, anstatt einen einzelnen String im Speicher zu erstellen.
- Behalten Sie die teilweise Datei, wenn die Verbindung abbricht. Ein blinder Wiederholungsversuch von Grund auf erzeugt die Ausgabe erneut und berechnet sie auch.
- Fordern Sie JSON Lines an, wenn Sie Struktur benötigen, sodass jede Zeile für sich geparst wird, anstatt auf den Abschluss eines riesigen Dokuments zu warten.
- Protokollieren Sie
usageMetadataund die Byte-Anzahl, nicht die gesamten Inhalte. - Überprüfen Sie Spalten- und Nachrichten-Größenbeschränkungen in Ihrer Datenbank und Warteschlange, bevor eine 800K-Token-Antwort diese erreicht.
Testen Sie es in Apidog, bevor der Zugang freigegeben wird
Sie können all dies an einem Stellvertreter üben. Laden Sie Apidog herunter und gehen Sie drei Prüfungen durch.
Den Stream beobachten. Senden Sie die Streaming-Anfrage an 3.8 Flash mit GEMINI_API_KEY und GEMINI_MODEL als Umgebungsvariablen. Apidog parst text/event-stream-Antworten und zeigt jedes Event in seiner Zeitachsenansicht an, sobald es ankommt, sodass Sie Chunk-Größen, Lücken und die endgültigen usageMetadata sehen können.
Einen wesentlich längeren Fake-Stream senden. Die reale 3.8 Flash-Ausgabe erreicht maximal 65.536 Tokens. Führen Sie daher einen lokalen Mock aus, der viel mehr im gleichen Event-Format streamt:
# long_stream_mock.py: Gemini-shaped SSE for parser and timeout tests (fake data)
import json, time
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer

EVENTS, DELAY, CHUNK = 20000, 0.005, "lorem ipsum " * 40

class Handler(BaseHTTPRequestHandler):
    def do_POST(self):
        self.rfile.read(int(self.headers.get("Content-Length", 0)))
        self.send_response(200)
        self.send_header("Content-Type", "text/event-stream")
        self.end_headers()
        for i in range(EVENTS):
            event = {"candidates": [{"content": {"parts": [{"text": CHUNK}]}}]}
            if i == EVENTS - 1:  # fake counts sized like a near-max reply
                event["usageMetadata"] = {"promptTokenCount": 1200,
                    "candidatesTokenCount": 950000, "thoughtsTokenCount": 40000,
                    "totalTokenCount": 991200}
            self.wfile.write(f"data: {json.dumps(event)}\n\n".encode())
            self.wfile.flush()
            time.sleep(DELAY)

ThreadingHTTPServer(("127.0.0.1", 8787), Handler).serve_forever()
Richten Sie die Basis-URL einer „Mock“-Umgebung auf http://127.0.0.1:8787 und senden Sie dieselbe Streaming-Anfrage darüber. Der Stream läuft etwa zwei Minuten (128 Sekunden in unserem Test) und enthält 9,6 Millionen Zeichen Text, genug, um einen Puffer-Parser, einen Proxy, der Events zurückhält, oder ein zu kurz gesetztes Timeout aufzudecken.
Token-Anzahlen überprüfen. Bei einer nicht-streaming-fähigen generateContent-Anfrage stellen Sie sicher, dass candidatesTokenCount plus thoughtsTokenCount in usageMetadata innerhalb oder unter Ihrer Begrenzung bleibt und dass die berechneten Kosten unter Ihrer Obergrenze zu Argon-Preisen bleiben. Der Argon API-Leitfaden enthält ein fertiges Kosten-Skript.
FAQ
Ist 1 Mio. das Kontextfenster von Gemini 4 Argon? Nein. 1 Mio. ist die Ausgabebegrenzung pro Antwort, gegenüber 64K zuvor. Google hat das Eingabefenster von Argon nicht veröffentlicht.
Wie viel kostet eine Argon-Antwort mit 1 Mio. Tokens? 10 $ für die Ausgabe zu Einführungspreisen und 20 $ zu Standardpreisen, zuzüglich Eingabe. Weitere Szenarien finden Sie unter Gemini 4 Argon-Preise.
Kann ich heute eine Antwort mit 1 Mio. Tokens generieren? Nur wenn Ihre Organisation zur Fairwind-Kohorte mit Argon-Zugang gehört. Gemini 3.8 Flash und 3.1 Pro Preview begrenzen die Ausgabe auf 65.536 Tokens, und Vals AI listet eine maximale Ausgabe von 262K für die von ihr getestete Argon-Konfiguration auf.
Muss ich lange Argon-Antworten streamen? Google hat keine Streaming-Anleitung für Argon veröffentlicht, aber ein nicht-streaming-fähiger Aufruf, der minutenlang läuft, ist jedem Idle-Timeout in Ihrem Stack ausgesetzt. Streamen Sie es, oder verwenden Sie die Hintergrundausführung über die Interactions API.
Wie verhält sich Argons Ausgabegrenze im Vergleich zu GPT-6 Astra und Claude Opus 5.5? Beide begrenzen die synchrone Ausgabe auf 128K; Anthropic erlaubt 300K im Batch mit einem Beta-Header. Argons angegebene 1 Mio. ist etwa das 8-fache davon.
Ihr nächster Schritt
Fügen Sie Ihrem Gemini-Client jetzt Streaming und eine Ausgabebegrenzung hinzu, für 3.8 Flash, und führen Sie es gegen den langen Mock-Stream aus, bis nichts in Ihrem Stack es abschneidet. Wenn Argons ID veröffentlicht wird, ändern Sie GEMINI_MODEL und führen Sie dieselben Tests in Apidog erneut aus.