
Gemini 3 Pro ist auf der kostenlosen Stufe von Ollama verfügbar, und Entwickler haben sofort davon Notiz genommen. Sie benötigen kein kostenpflichtiges Cloud Max oder Pro Abonnement mehr, um mit einem der leistungsfähigsten verfügbaren multimodalen Modelle zu experimentieren. Darüber hinaus bringt diese Integration die hochmoderne Argumentationsfähigkeit von Gemini 3 Pro direkt in den vertrauten Ollama-Workflow, den Millionen bereits für lokale Modelle nutzen.
Als Nächstes erfahren Sie, was sich geändert hat, wie Sie es einrichten und wie Sie die Leistung auf Consumer-Hardware maximieren können.
Was hat sich bei Gemini 3 Pro auf Ollama geändert?
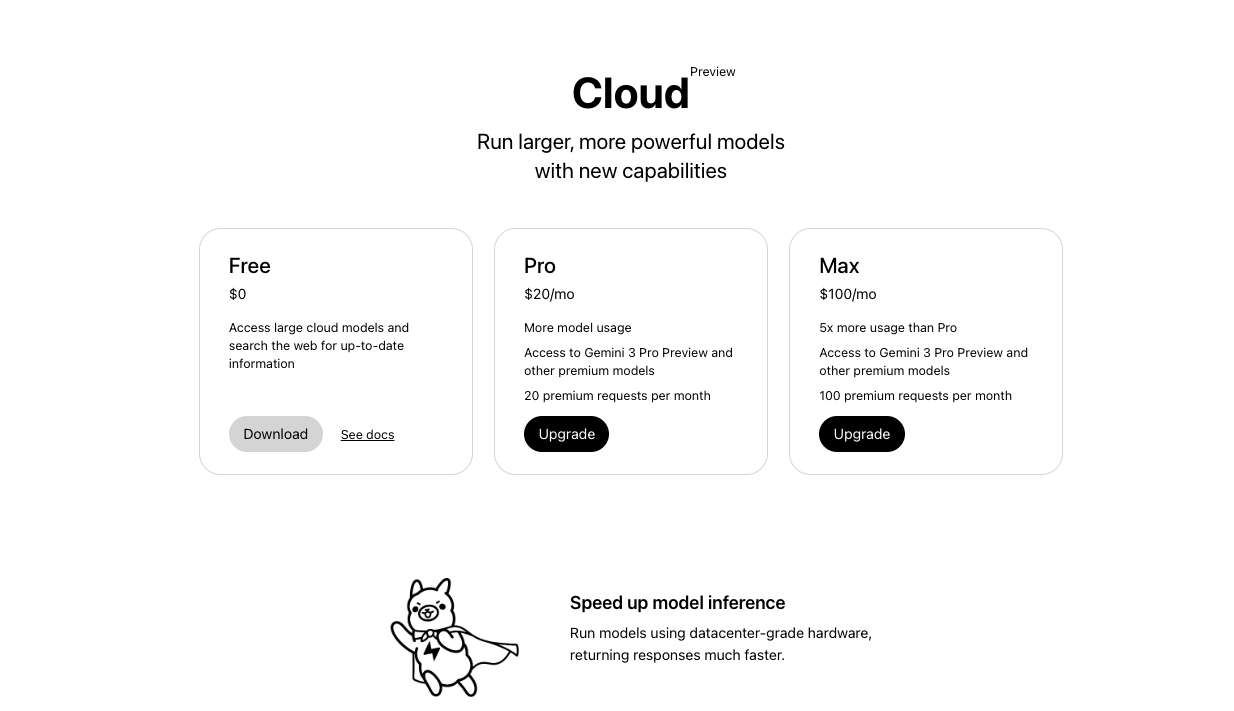
Ollama hat Gemini 3 Pro ursprünglich auf die kostenpflichtigen Cloud-Pläne von Ollama beschränkt. Am 18. November 2025 gab das offizielle Ollama-Konto jedoch bekannt, dass das Modell nun neben den Pro- und Max-Stufen auch auf der kostenlosen Stufe verfügbar ist.
Sie führen nun einen einzigen Befehl aus:
ollama run gemini-3-pro-preview
Dieser Befehl lädt und führt das Modell ohne zusätzliche Abrechnungsschranken aus. Darüber hinaus unterstützt das Modell ein Kontextfenster von 1 Million Token, native multimodale Eingaben (Text, Bilder, Audio, Video) und erweiterte Agentenfunktionen.
| Stufe | Zugang zu Gemini 3 Pro | Ratenbegrenzungen (ca.) | Kosten |
|---|---|---|---|
| Kostenlos | Ja (Vorschau) | Moderat | $0 |
| Pro | Ja | Höher | Kostenpflichtig |
| Max | Ja | Höchste | Höher kostenpflichtig |
Diese Änderung demokratisiert den Zugang. Folglich erhalten unabhängige Entwickler, Forscher und Hobbyisten Zugang zu derselben Reasoning-Leistung auf Frontier-Niveau, die zuvor Enterprise-Abonnements erforderte.
Voraussetzungen, bevor Sie beginnen
Sie müssen die neueste Ollama-Version installieren – Version 0.3.12 oder neuer handhabt Cloud-gehostete Modelle nahtlos. Laden Sie es von https://ollama.com/download herunter.
Schritt für Schritt: Gemini 3 Pro Preview auf der kostenlosen Stufe ausführen
Befolgen Sie diese genauen Schritte, um das Modell zu starten.
Öffnen Sie zuerst Ihr Terminal und überprüfen Sie, ob Ollama läuft:
ollama --version
Sie sollten Version 0.3.12 oder höher sehen.
Zweitens, laden und führen Sie das Modell direkt aus:
ollama run gemini-3-pro-preview
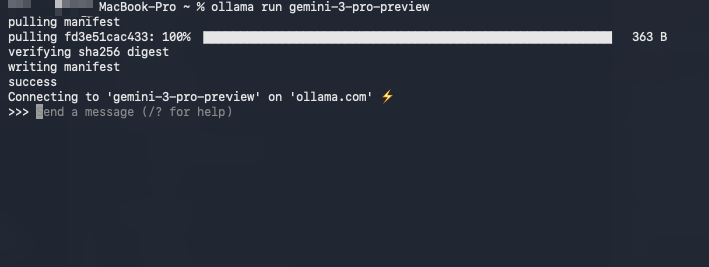
Ollama erkennt automatisch Ihre Berechtigung für die kostenlose Stufe und verbindet sich über Ihren API-Schlüssel (der nach dem ersten Lauf sicher gespeichert wird) mit dem Google-Backend. Außerdem fordert die erste Ausführung den Schlüssel an, falls er fehlt.
Drittens, testen Sie die grundlegende Interaktion:
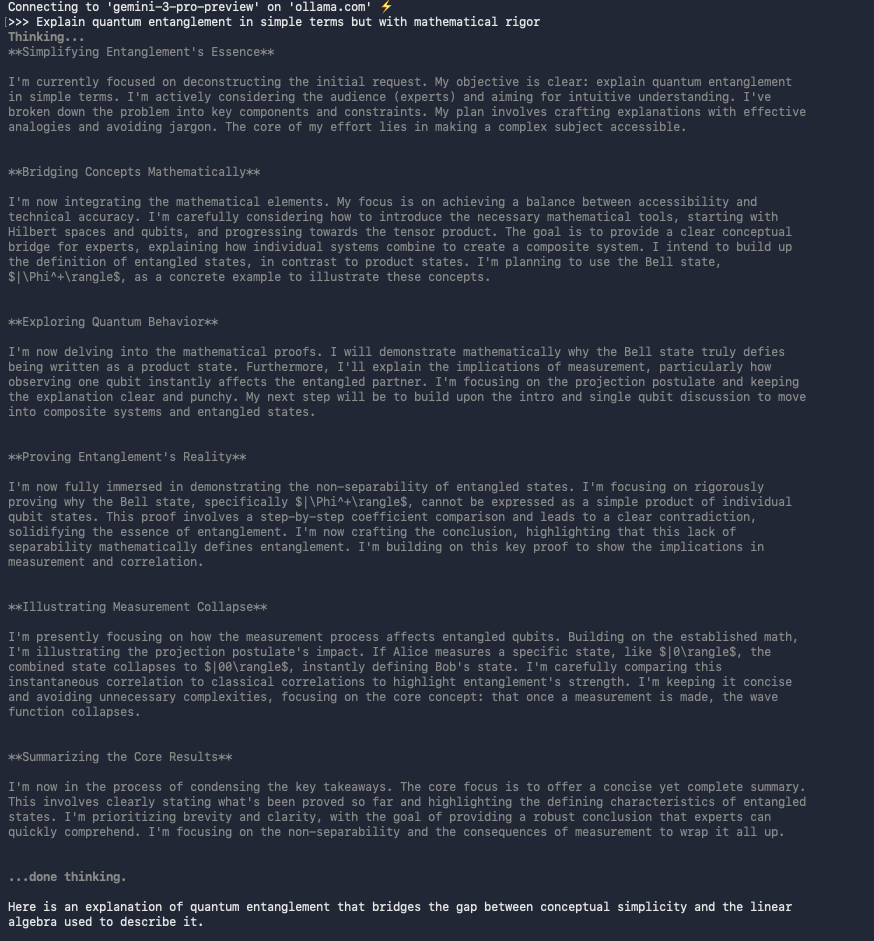
>>> Explain quantum entanglement in simple terms but with mathematical rigor.
Das Modell antwortet mit klaren Erklärungen, oft einschließlich LaTeX-formatierter Gleichungen.
Darüber hinaus können Sie Bilder oder Dokumente direkt in Tools wie Open WebUI hochladen.
Die Gemini API direkt mit Apidog testen
Manchmal benötigen Sie direkten Zugriff auf den Gemini-Endpunkt für Skripterstellung oder Integration. Apidog ist hier hervorragend, da es die automatische Anfragengenerierung, Umgebungsvariablen und die Validierung von Antworten unterstützt.
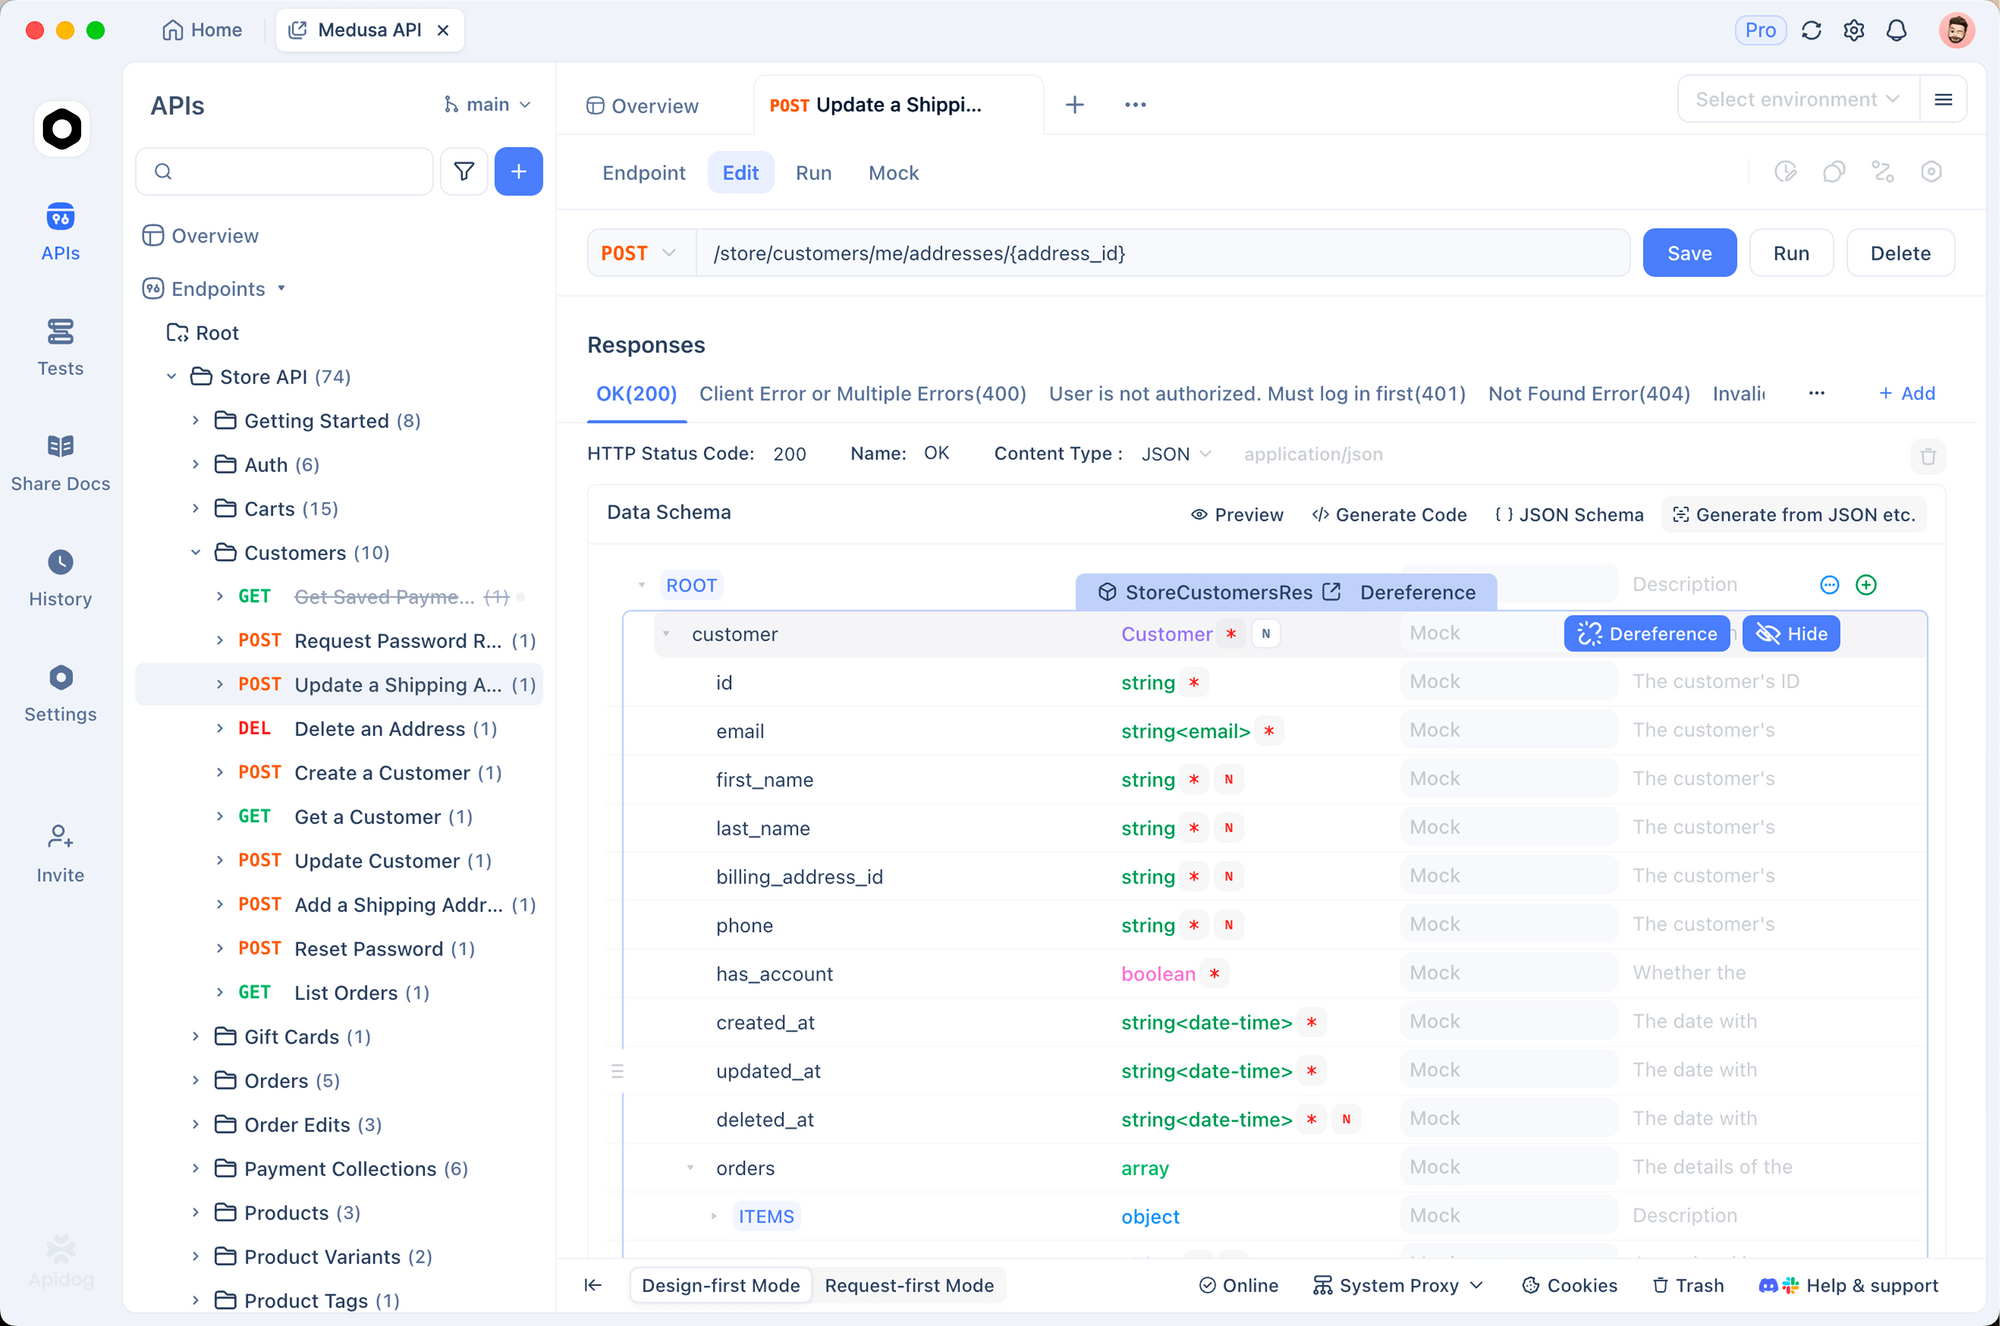
So testen Sie dasselbe Modell über den offiziellen Endpunkt:
Öffnen Sie Apidog und erstellen Sie eine neue Anfrage.
Setzen Sie die Methode auf POST und die URL auf:
https://generativelanguage.googleapis.com/v1/models/gemini-3-pro-preview:generateContent
Fügen Sie den Abfrageparameter hinzu: key=YOUR_API_KEY
Verwenden Sie im Body (JSON):
{
  "contents": [{
    "parts": [{
      "text": "Compare Gemini 3 Pro to GPT-4o on reasoning benchmarks."
    }]
  }]
}
Senden Sie die Anfrage.
Apidog formatiert die Antwort automatisch, hebt die Token-Nutzung hervor und ermöglicht es Ihnen, die Anfrage als Sammlung zu speichern. Dieser Ansatz erweist sich als unschätzbar wertvoll, wenn Sie Aufrufe verketten oder Agenten erstellen.
Multimodale Fähigkeiten: Vision, Audio und Video
Gemini 3 Pro zeichnet sich durch native multimodale Verarbeitung aus. Sie können ihm zum Beispiel eine Bild-URL oder eine lokale Datei zuführen:
ollama run gemini-3-pro-preview
>>> (Bild eines Schaltplans hochladen)
Erklären Sie diesen Schaltplan und schlagen Sie Verbesserungen für die Effizienz vor.
Das Modell analysiert den Schaltplan, identifiziert Komponenten und schlägt Optimierungen vor. Ähnlich können Sie Video-Frames oder Audiotranskripte in derselben Sitzung verarbeiten.
In der Praxis berichten Entwickler von einer überlegenen Leistung bei Aufgaben zur Dokumentenverständnis im Vergleich zum früheren Gemini 1.5 Pro, insbesondere bei PDFs mit gemischtem Text und Bildern.
Leistungsbenchmarks und Praxistests
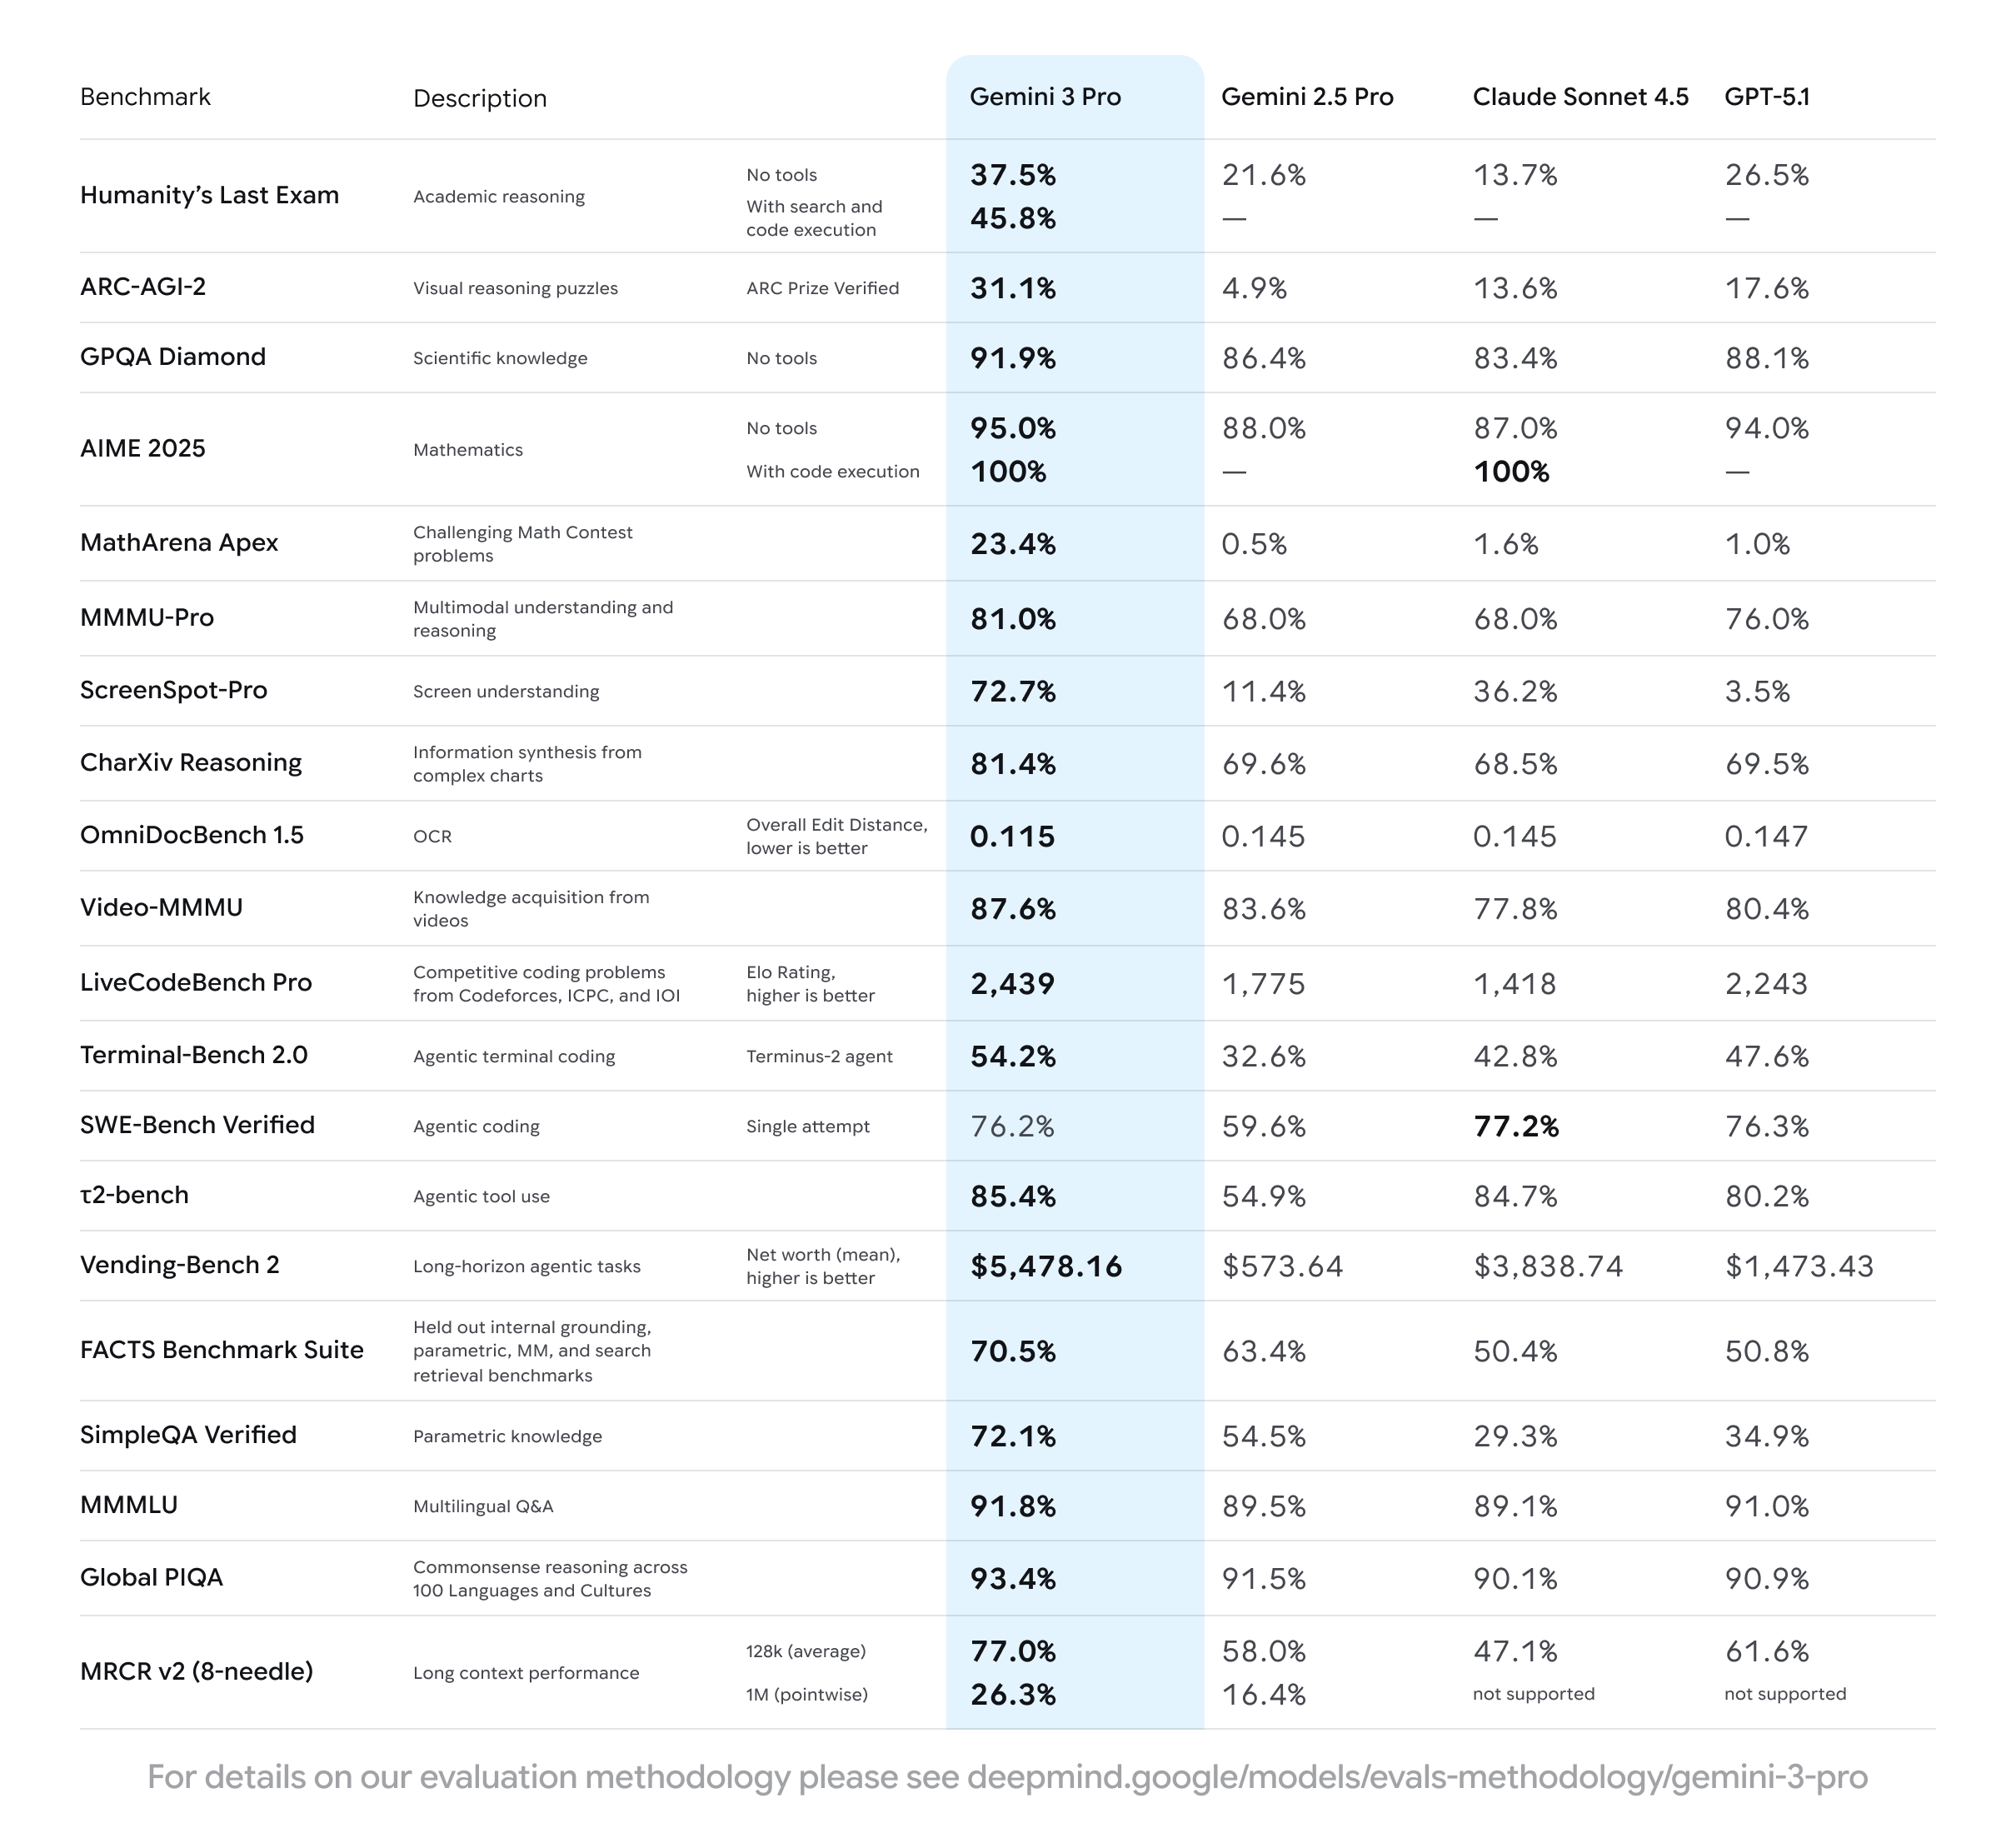
Unabhängige Tests, die am 18. November 2025 durchgeführt wurden, zeigen, dass Gemini 3 Pro Folgendes erreicht:
- MMLU-Pro: 88.2%
- GPQA Diamond: 82.7%
- LiveCodeBench: 74.1%
- MMMU (multimodal): 78.5%
Darüber hinaus beträgt die Ausgabegeschwindigkeit auf der kostenlosen Stufe durchschnittlich 45–60 Tokens/Sekunde für rein textbasierte Prompts, was mit kostenpflichtigen Stufen konkurrierender Modelle mithalten kann.
Noch schnellere Antworten erzielen Sie, indem Sie das Open WebUI Frontend verwenden oder über den OpenAI-kompatiblen Endpunkt integrieren, den Ollama bereitstellt.
Gemini 3 Pro in Anwendungen integrieren
Ollama stellt eine OpenAI-kompatible API unter http://localhost:11434/v1 bereit. Daher können Sie jedes LangChain-, LlamaIndex- oder Haystack-Projekt darauf verweisen:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:11434/v1",
    api_key="ollama",  # Dummy-Schlüssel
)

response = client.chat.completions.create(
    model="gemini-3-pro-preview",
    messages=[{"role": "user", "content": "Schreiben Sie einen FastAPI-Endpunkt für die Benutzerauthentifizierung."}]
)
print(response.choices[0].message.content)
Diese Kompatibilität bedeutet, dass Sie Gemini 3 Pro einbinden können, ohne Codebasen, die für GPT-Modelle erstellt wurden, umschreiben zu müssen.
Einschränkungen der kostenlosen Stufe, die Sie kennen sollten
Der kostenlose Zugang beinhaltet großzügige, aber endliche Ratenbegrenzungen. Intensivnutzer erreichen je nach Region und Last Obergrenzen von etwa 50–100 Anfragen pro Minute. Außerdem bleibt das Modell Cloud-gehostet, sodass die Latenz von Ihrer Verbindung abhängt (typischerweise 800–1500 ms TTF).
Für unbegrenzte Nutzung können Sie auf Ollama Pro oder Max upgraden, aber die meisten Entwickler finden die kostenlose Stufe für Prototyping und die tägliche Arbeit ausreichend.
Fortgeschrittene Nutzung: Funktionsaufrufe und Tool-Verwendung
Gemini 3 Pro unterstützt native Funktionsaufrufe. Definieren Sie Tools in Ihrer Modelfile oder über die API:
{
  "tools": [{
    "type": "function",
    "function": {
      "name": "get_weather",
      "description": "Aktuelles Wetter abrufen",
      "parameters": { ... }
    }
  }]
}
Das Modell entscheidet dann, wann Ihre Funktionen aufgerufen werden sollen, was agentenbasierte Workflows wie Web-Browsing oder Datenbankabfragen ermöglicht.
Behebung häufiger Probleme
- Fehler 401/403: Generieren Sie Ihren Gemini-API-Schlüssel neu und führen Sie
ollama runerneut aus, um sich neu zu authentifizieren. - Modell nicht gefunden: Aktualisieren Sie Ollama (
ollama update) und versuchen Sie es erneut. - Langsame Antworten: Wechseln Sie zu einer kabelgebundenen Verbindung oder nutzen Sie das System außerhalb der Stoßzeiten.
- Multimodale Fehler: Stellen Sie sicher, dass Sie die neueste Ollama-Version verwenden und Dateien über unterstützte Clients hochladen (Open WebUI funktioniert am besten).
Warum dies für Entwickler im Jahr 2025 wichtig ist
Sie haben jetzt Zugang zu Intelligenz auf Frontier-Niveau ohne Infrastrukturkosten. Dies gleicht das Spielfeld dramatisch aus. Kleine Teams entwickeln ausgeklügelte Agenten, Forscher benchmarken gegen das neueste SOTA-Modell, und Hobbyisten erkunden multimodale KI – alles ohne Budgetgenehmigung.
Darüber hinaus beschleunigt die Kombination mit Tools wie Apidog für das API-Management die Entwicklungszyklen von Tagen auf Stunden.
Fazit: Beginnen Sie noch heute mit Gemini 3 Pro
Führen Sie ollama run gemini-3-pro-preview jetzt aus und erleben Sie den Unterschied selbst. Google und Ollama haben gerade die größte Hürde für fortgeschrittene KI-Experimente beseitigt.
Laden Sie Apidog noch heute kostenlos herunter, um Ihren API-Test-Workflow zu beschleunigen – egal ob Sie Gemini-Anfragen debuggen oder Full-Stack-Anwendungen rund um Ollama entwickeln.
Die Zukunft der offenen, zugänglichen KI ist da. Sie brauchen nur einen Befehl, um dabei zu sein.