
Google hat am 15. September 2026 zwei neue Sprach-zu-Sprach-Modelle veröffentlicht, und der Hacker News-Thread erreichte innerhalb eines Tages 337 Punkte. Das ist eine große Resonanz für einen Sprach-API-Launch, und die meisten Diskussionen drehten sich nicht um das Demo-Video. Es waren Entwickler, die dieselbe Frage stellten: Was kostet es, damit etwas zu entwickeln, und wie stellt man tatsächlich eine Verbindung dazu her?
Dies ist dieser Leitfaden. gemini-3.8-live und gemini-3.8-live-extended-thinking werden jetzt in der Gemini API und im Google AI Studio eingeführt, mit Gemini Enterprise und Search Live-Zugang in der privaten Vorschau. Beide Modelle bieten kostenlose Eingabe- und Ausgabe-Tokens zusätzlich zu einem kostenpflichtigen Tarif mit Preisen pro Token und pro Minute, was für ein Live-Audio-Modell ungewöhnlich genug ist, dass es sich lohnt, die WebSocket-Sitzung selbst durchzugehen und nicht nur die Preisübersicht. Wir haben die Sprachassistenten für Endverbraucher bereits in GPT-Live vs Gemini Live verglichen; dieser Artikel ist der Entwicklerpfad zur API hinter einer Seite dieses Vergleichs.
Was tatsächlich am 15. September veröffentlicht wurde
Googles Ankündigung umfasst zwei Modelle. gemini-3.8-live ist das Standard-Sprach-zu-Sprach-Modell. gemini-3.8-live-extended-thinking fügt eine Reasoning-Schicht hinzu, die läuft, während das Modell spricht, wie unten beschrieben. Beide unterstützen 97 Sprachen mit automatischem Wechsel mitten im Gespräch, was bedeutet, dass ein Anrufer einen Satz auf Englisch beginnen und auf Spanisch beenden kann, ohne eine manuelle Sprachauswahl.
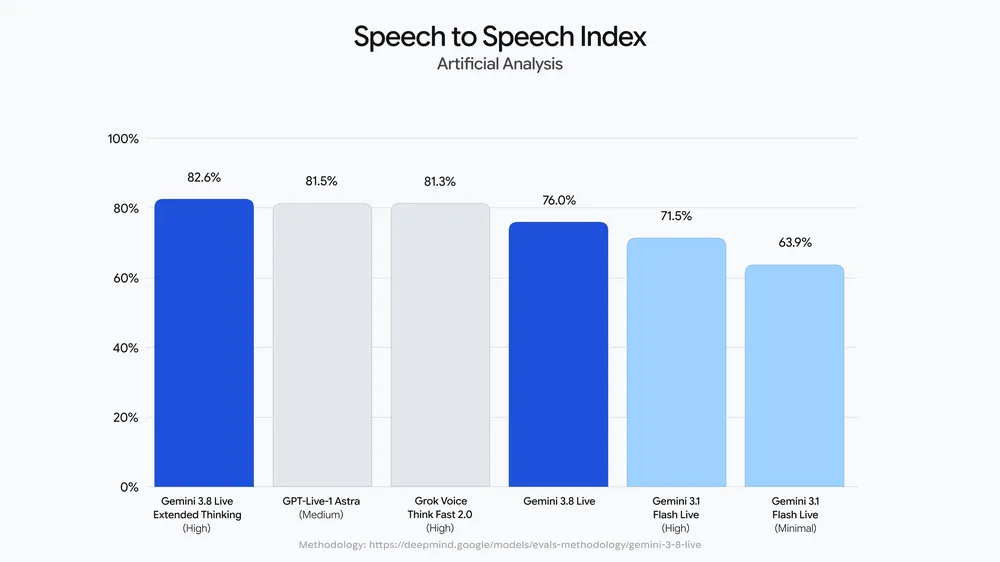
Verfügbarkeit bei der Veröffentlichung: die Gemini API und das Google AI Studio (allgemeiner Zugang), plus Gemini Enterprise und Search Live (private Vorschau, daher werden die meisten Entwickler, die dies lesen, in der API oder im AI Studio beginnen). Kostenlose Tokens gelten für beide Modelle sowohl für die Eingabe als auch für die Ausgabe, was einen echten Prototyp in Reichweite bringt, bevor Sie eine Kreditkarte verwenden müssen.
Ein Detail, das Google nicht veröffentlicht hat: die Ratenbegrenzungen der kostenlosen Stufe für die beiden Live-Modelle. Die Seite mit den Ratenbegrenzungen ist die Quelle der Wahrheit, sobald sie diese auflistet; behandeln Sie jede Zahl, die Sie anderswo sehen, als unbestätigt, bis Sie sie dort selbst überprüft haben.
Der Zugang zu Search Live und Gemini Enterprise, der nur in der privaten Vorschau verfügbar ist und nicht offen wie die API, ist ein bemerkenswertes Signal: Google ist damit einverstanden, Entwickler auf produktionsnahe Weise darauf aufbauen zu lassen, bevor es dasselbe Modell für die Verbrauchersuche oder kostenpflichtige Enterprise-Lizenzen freigibt. Das ist normal für die Einführung eines Sprachmodells und bedeutet, dass die API-Oberfläche im Moment der stabile Ausgangspunkt ist, und nicht eine abgespeckte Vorschau einer besseren Consumer-Erfahrung, die später kommt.
Kostenlosen API-Schlüssel erhalten und eine Sitzung öffnen
Ein Gemini API-Schlüssel stammt aus dem Google AI Studio, ist an ein Google-Konto gebunden und funktioniert am selben Tag, an dem die Live-Modelle veröffentlicht werden, da es keinen separaten Genehmigungsschritt für die kostenlose Stufe gibt. Sobald Sie den Schlüssel haben, ist der Verbindungspunkt ein WebSocket, kein REST-Endpunkt, was die erste Anpassung ist, wenn Sie an generateContent-Aufrufe gewöhnt sind:
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent
Diese URL stammt aus Simon Willisons praxisorientiertem Bericht vom Starttag, veröffentlicht zusammen mit seiner üblichen genauen Lektüre einer neuen API. Er wies auch auf etwas Wissenswertes hin, bevor Sie eine Benutzeroberfläche darum herum bauen: Sie können das Modell mitten in der Antwort unterbrechen, so wie Sie eine sprechende Person unterbrechen würden, und das zurückkommende Transkript kann Sprache enthalten, die das Modell zu generieren begann, aber nie vollständig abgespielt hat, weil die Wiedergabe durch Ihre Unterbrechung abgebrochen wurde. Behandeln Sie dies als einen separaten Zustand in Ihrem Client, anstatt anzunehmen, dass jede Transkriptionszeile vollständig gehört wurde.
Eine bidirektionale Sitzung über diesen Socket folgt dem Muster, das jede WebSocket-basierte Streaming-API verwendet: zuerst eine Setup-Nachricht, die das Modell und seine Generierungskonfiguration identifiziert, dann ein Strom von Inhaltsnachrichten, die Audio-Chunks oder Text in beide Richtungen übertragen, wobei der Server partielle und finale Antwortsegmente zurücksendet, sobald sie bereit sind. Das genaue Nachrichtenschema muss Google präzise dokumentieren, und es kann sich zwischen der Vorschau und der allgemeinen Verfügbarkeit ändern, daher überprüfen Sie die Feldnamen anhand der aktuellen Gemini API-Dokumentation und der Referenz für Ihr SDK, bevor Sie sich für einen Produktions-Client entscheiden. Was stabil ist, ist das Muster: verbinden, Setup senden, Inhalt streamen, gestreamte Antworten lesen und Unterbrechungen als normales Ereignis und nicht als Fehlerfall erwarten.
Praktisch bedeutet das, dass Ihre erste Arbeitssitzung auf die kleinstmögliche Schleife abzielen sollte: Öffnen Sie den Socket, senden Sie eine Setup-Nachricht mit dem gewünschten Modellnamen (gemini-3.8-live oder gemini-3.8-live-extended-thinking), senden Sie eine einzelne kurze Audio- oder Text-Eingabe und bestätigen Sie, dass Sie eine gestreamte Antwort erhalten, bevor Sie Wiederholungslogik, Verbindungsbehandlung oder eine Benutzeroberfläche hinzufügen. Bauen Sie den Unterbrechungspfad erst danach, wenn der "Happy Path" funktioniert, da gutes Testen bedeutet, bewusst während einer Modellantwort zu sprechen und zu überprüfen, ob Ihr Client das abgebrochene Transkript korrekt markiert, anstatt es als vollständigen Turn zu behandeln.
Erweitertes Denken: Wenn die Argumentation laut stattfindet
Das einfache gemini-3.8-live Modell antwortet direkt. gemini-3.8-live-extended-thinking tut etwas anderes: Google sagt, es „argumentiert und spricht gleichzeitig“ und bewahrt so einen „ununterbrochenen Gesprächsfluss“, indem es die Denkzeit mit verbalen Hinweisen füllt, Phrasen wie „Lassen Sie mich das überprüfen“ anstelle von Stille, während das Modell arbeitet.
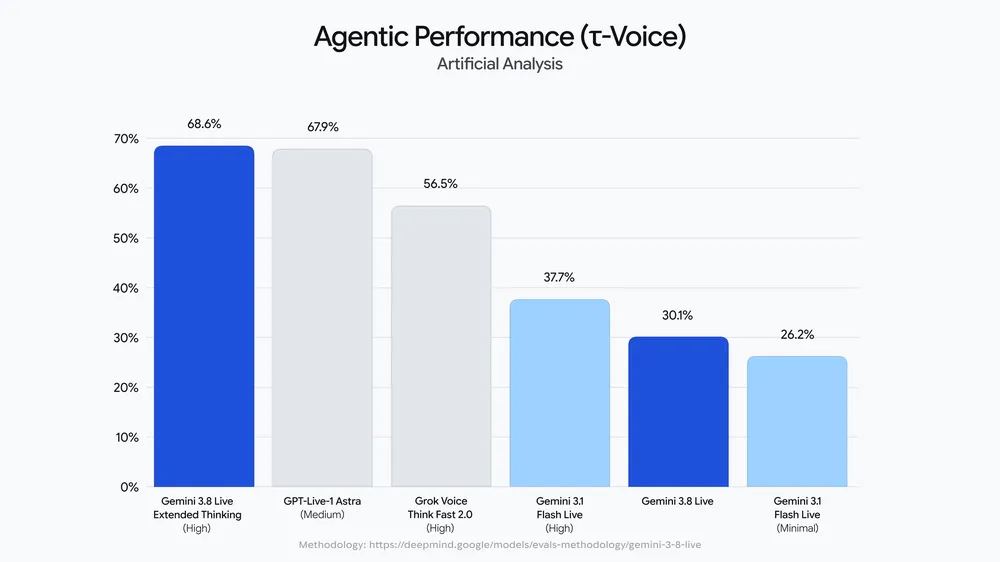
Das ist wichtig für eine bestimmte Art von Anwendung: Sprachagenten, die Tools aufrufen oder externe APIs mitten im Gespräch ansprechen. Das Modell mit erweitertem Denken „führt Tools und API-Aufrufe im Hintergrund aus, während das Gespräch fortgesetzt wird“, und Funktionsaufrufe werden von beiden Modellen unterstützt. Stellen Sie sich einen Buchungsagenten vor, der die Verfügbarkeit anhand einer Kalender-API überprüfen muss: Anstatt zwei Sekunden lang still zu sein, während die Suche läuft, kann das Modell die Anfrage laut bestätigen und den Austausch aufrechterhalten, während der Aufruf im Hintergrund abgeschlossen wird.
Wählen Sie "erweitertes Denken", wenn Ihre Sitzung Tool-Aufrufe, mehrstufige Suchvorgänge oder argumentationsintensive Antworten beinhaltet, bei denen eine Schweigepause störend wirken würde. Wählen Sie das einfache Modell für kürzere, latenzarme Austausche, bei denen der Denk-Overhead nicht benötigt wird. Beide kosten pro Token dasselbe, daher geht es bei der Wahl um das Verhalten, nicht um das Budget. Wenn Ihr Agent speziell auf Funktionsaufrufe angewiesen ist, deckt unser Leitfaden für Funktionsaufrufe für Gemini 3.8 Flash die Anforderungsform ab, die Google in der gesamten aktuellen Gemini 3.8-Familie verwendet. Bestätigen Sie jedoch die Live-spezifische Payload für Funktionsaufrufe mit den Live-API-Dokumenten, bevor Sie diese verwenden, da die Text- und Sprach-APIs nicht garantiert ein Schema teilen.
Was es kostet, aufgeschlüsselt
Beide Live-Modelle teilen sich die gleichen Standardpreise:
| Typ | Rate |
|---|---|
| Texteingabe | 0,75 $ pro 1 Mio. Tokens |
| Audioeingabe | 3,00 $ pro 1 Mio. Tokens oder 0,005 $ pro Minute |
| Bild-/Videoeingabe | 1,00 $ pro 1 Mio. Tokens oder 0,002 $ pro Minute |
| Textausgabe | 4,50 $ pro 1 Mio. Tokens |
| Audioausgabe | 12,00 $ pro 1 Mio. Tokens oder 0,018 $ pro Minute |
Denk-Tokens werden als Ausgabe abgerechnet, wie bei jedem anderen Gemini 3.x-Modell, sodass die Hintergrundargumentation des erweiterten Denkens auf der Ausgabelinie erscheint und nicht als separate Gebühr.
Rechenbeispiel: ein 10-minütiger Sprachanruf, durchgehend mit Audio-Eingabe und -Ausgabe, im kostenpflichtigen Standard-Tarif. Audioeingabe: 10 Minuten x 0,005 $ = 0,05 $. Audioausgabe: 10 Minuten x 0,018 $ = 0,18 $. Gesamt: 0,23 $ für ein vollständiges 10-minütiges Hin- und Her-Gespräch, bevor Text- oder Tool-Call-Tokens hinzukommen. Führen Sie denselben Anruf in der kostenlosen Stufe während des Prototypings durch, und die Token-Kosten sind null, vorbehaltlich der Ratenbegrenzung, die Google schließlich dafür veröffentlicht.
Das gemini-3.1-flash-live-preview Modell auf derselben Preisübersichtsseite hat identische Raten wie die beiden neuen Live-Modelle, was sich zu überprüfen lohnt, wenn Sie bereits eine Live-Integration mit diesem älteren Modell haben; die Preisentscheidung ist kein Grund, die Migration aufzuschieben.
Was Entwickler bisher sagen
Die Hacker News Diskussion ist nicht durchweg positiv. Eine wiederkehrende Beschwerde: zahlende Google Workspace- und Google AI Plus-Abonnenten haben noch keinen Consumer-Zugang zur neuen Live-Erfahrung, obwohl sie zahlende Kunden sind, während der API- und AI Studio-Zugang offen ist. Ein Bericht aus dem Thread beschrieb eine Agenten-Schleife, bei der das Modell zusätzliche Anforderungen erfand, die nicht Teil der ursprünglichen Aufgabe waren, ein Fehlermodus, der speziell getestet werden sollte, wenn Sie Live in einen autonomen Agenten statt in einen Sprachassistenten mit menschlicher Beteiligung integrieren. Wenn Sie etwas bauen, das näher an einer autonomen Schleife als an einem beaufsichtigten Assistenten ist, fügen Sie eine explizite Überprüfung hinzu, die das, was das Modell als notwendig beansprucht, mit der von Ihnen angegebenen Aufgabenbeschreibung vergleicht, anstatt den angegebenen Anforderungen des Modells blind zu vertrauen. Betrachten Sie beide Punkte als ein Signal vom ersten Tag aus einem einzigen Thread, nicht als einen verifizierten Fehlerbericht, und testen Sie sie erneut anhand Ihres eigenen Anwendungsfalls, bevor Sie von ihnen verallgemeinern.
Das Rohprotokoll sehen, bevor Sie Client-Code schreiben
Bevor Sie sich für eine Client-Bibliothek entscheiden, hilft es, die tatsächlichen Frames zu beobachten, die über die Leitung gehen. Apidog kann eine WebSocket-Verbindung zum BidiGenerateContent-Endpunkt öffnen, die JSON-Setup-Nachricht und nachfolgende Inhaltsnachrichten manuell senden und Ihnen die gestreamten Frames in Echtzeit anzeigen. Das ist der schnellste Weg, das Setup-dann-Stream-Muster zu verstehen, bevor Sie eine einzige Zeile SDK-Code dafür schreiben. Apidog erfasst kein Mikrofon-Audio für Sie; Sie stellen die Audio- oder Text-Payloads selbst bereit und nutzen die Verbindung, um zu überprüfen, was der Server zurücksendet, Ihre Setup-Nachricht zu bestätigen und zu beobachten, wie Unterbrechungen sich verhalten, bevor Sie eine Fehlerbehandlung für die Produktion erstellen. Die vollständige Protokollreferenz zum Erstellen und Testen von WebSocket-APIs auf diese Weise finden Sie unter docs.apidog.com. Laden Sie Apidog herunter, um die Verbindung vor Ihrer ersten Client-Erstellung selbst auszuprobieren.
Zum Vergleich deckt unser WebSocket vs. WebRTC-Vergleich ab, warum Google für diesen bidirektionalen Stream einen WebSocket anstelle des WebRTC-Pfades gewählt hat, den einige konkurrierende Sprach-APIs verwenden, und was dieser Kompromiss speziell für Browser-Clients bedeutet.
Häufig gestellte Fragen (FAQ)
Ist die Gemini 3.8 Live API kostenlos? Ja, für beide Modelle sind Eingabe- und Ausgabe-Tokens in der kostenlosen Stufe kostenlos. Kostenpflichtige Standardtarife gelten, sobald Sie die von Google festgelegte Ratenbegrenzung überschreiten, und diese Ratenbegrenzung für die kostenlose Stufe ist noch nicht veröffentlicht, daher überprüfen Sie die Seite mit den Ratenbegrenzungen direkt.
Was ist der Unterschied zwischen den beiden neuen Modellen? gemini-3.8-live antwortet direkt. gemini-3.8-live-extended-thinking argumentiert während des Sprechens und verwendet verbale Füllwörter, um Hintergrund-Tool-Aufrufe und mehrstufige Suchvorgänge abzudecken, zum gleichen Token-Preis.
Brauche ich WebRTC, um dies zu nutzen? Nein. Die API ist WebSocket-basiert und stellt eine Verbindung zu einem BidiGenerateContent-Endpunkt her, anstatt eine WebRTC-Peer-Verbindung zu nutzen.
Kann ich dies ohne das Schreiben eines Clients testen? Ja. Öffnen Sie den WebSocket in Apidog, senden Sie die Setup- und Inhaltsnachrichten manuell und lesen Sie die gestreamte Antwort, bevor Sie einen echten Client darum herum bauen.