Google veröffentlichte Gemini 3.7 Flash am 13. August 2026, drei Wochen nach 3.6 Flash, und nannte es „unser intelligentestes Arbeitspferdemodell“. Die Benchmark-Deltas untermauern das Vertrauen. DeepSWE steigt von 49,0 % auf 65,3 %, AutomationBench klettert von 17,0 % auf 30,4 %, und der Einführungspreis von 0,75 $ pro 1 Mio. Eingabe-Tokens beträgt die Hälfte dessen, was 3.6 Flash bei der Einführung gekostet hat.
Diese Kombination wirft eine Frage auf, die jedes API-Team in diesem Quartal beschäftigt: Deckt ein schnelles, günstiges Gemini-Modell nun Workloads ab, die Sie zuvor an Claude oder GPT weitergeleitet haben? Dieser Vergleich beschränkt sich auf das, was Sie überprüfen können: Kontextfenster, Modalitäten, Tool-Unterstützung, Preisstruktur und die Anforderungsschemata, mit denen Sie integrieren werden; wo Wettbewerberzahlen nicht vergleichbar sind, wird dies vermerkt. Und weil die ehrliche Antwort auf die Frage „Welche API sollten Sie verwenden?“ lautet: „Diejenige, die bei Ihrer Workload gewinnt“, zeigt der letzte Abschnitt, wie Sie alle drei Seite an Seite in Apidog ausführen, bevor Sie sich festlegen.
Wenn Sie sich für Gemini entscheiden und die Einrichtungsschritte benötigen, behandelt der Gemini 3.7 Flash API Quickstart Schlüssel, Endpunkte und erste Anfragen.
TL;DR
- Gemini 3.7 Flash: 1 Mio. Token Kontext, 64k Ausgabe-Limit, native Eingabe über Text, Bild, Video, Audio und PDF, plus Funktionsaufrufe, Suche als Tool und Computernutzung.
- Einführungspreise: 0,75 $ pro 1 Mio. Eingabe-Tokens und 3,75 $ pro 1 Mio. Ausgabe-Tokens bis zum 31. Dezember 2026, Verdopplung auf 1,50 $ bzw. 7,50 $ am 1. Januar 2027.
- Code-Verbesserungen gegenüber 3.6 Flash: DeepSWE v1.1 von 49,0 % auf 65,3 %, FrontierCode 1.1 Main von 34,4 % auf 43,6 %, AutomationBench von 17,0 % auf 30,4 %.
- Claude Fable 5 und GPT-5.6 Sol führen weiterhin bei der Frontier-Code-Tiefe und Agenten-Konsistenz, zu einem mehrfachen des Pro-Token-Preises.
- Die drei Anbieter verwenden inkompatible Anforderungsschemata: Google
contents, Anthropic Messages, OpenAImessages. - Benchmarks prognostizieren Durchschnitte, nicht Ihre Workload; führen Sie einen 20-Prompt-Vergleich über alle drei APIs durch, bevor Sie sich entscheiden.
Wie dieser Vergleich zu lesen ist
Dies ist kein „Frontier gegen Frontier“-Vergleich. Claude Fable 5 und GPT-5.6 Sol sind Flaggschiffe, die auf maximale Leistungsfähigkeit ausgelegt sind; Gemini 3.7 Flash ist ein Arbeitspferd, das auf Volumen ausgelegt ist. Google liefert es aus, während sein Flaggschiff noch wartet: Axios berichtete, dass Gemini 3.5 Pro weiterhin verzögert ist, wobei Flash-Updates vorab veröffentlicht werden.
Der Vergleich ist dennoch wertvoll: Die Startwerte von 3.7 Flash überlappen nun den Bereich, in dem sich Frontier-Modelle noch vor Wochen befanden, und das ändert die Routing-Berechnung, selbst wenn die Flaggschiffe die Nase vorn behalten.
Durchweg gelten zwei Vorbehalte. Erstens ist jede hier angegebene Zahl eine vom Anbieter in der Startwoche gemeldete Zahl; behandeln Sie diese als richtungsweisend, bis unabhängige Bewertungen vorliegen. Zweitens sind Benchmark-Varianten wichtig. Google meldet FrontierCode 1.1 Main, während die Zahlen, die für Claude und GPT bei deren Starts veröffentlicht wurden, aus dem „Extended Split“ stammten, sodass diese Spalten hier nie eine Tabelle teilen.
Spezifikationen im Vergleich
Das Datenblatt zeigt, wie Gemini 3.7 Flash sich gegen Modelle behauptet, die weit mehr kosten. Die vollständigen technischen Details finden Sie auf der Gemini Flash Modellseite.
| Gemini 3.7 Flash | Claude Fable 5 | GPT-5.6 Sol | |
|---|---|---|---|
| Entwickler | Anthropic | OpenAI | |
| Kontextfenster | 1 Mio. Tokens | 1 Mio. Tokens | 1,05 Mio. Tokens |
| Ausgabelimit | 64k Tokens | Siehe Anbieterdokumentation | Siehe Anbieterdokumentation |
| Eingabemodalitäten | Text, Bild, Video, Audio, PDF | Text, Bild | Text, Bild |
| Ausgabe | Text | Text | Text |
| Tool-Unterstützung | Funktionsaufrufe, Suche als Tool, Computernutzung | Funktionsaufrufe, Tool-Nutzung | Funktionsaufrufe, integrierte Tools |
| Anforderungsschema | Google contents + generationConfig |
Anthropic Messages | OpenAI messages |
| Authentifizierung | x-goog-api-key-Header |
x-api-key + Versions-Header |
Bearer-Token |
| Preise (pro 1 Mio. Tokens) | 0,75 $ Eingang / 3,75 $ Ausgang (Einführung); 1,50 $ / 7,50 $ ab Jan 2027 | Premium-Frontier-Tier | Premium-Frontier-Tier |
| Positionierung | Arbeitspferd für hohes Volumen | Langfristige Agentenarbeit | Code-Tiefe im Repository-Maßstab |
Die Kontextfenster sind nun effektiv gleich, sodass diese Zeile nichts mehr entscheidet. Die Modalitäts- und Preiszeilen sind die Punkte, an denen die drei divergieren, und die nächsten Abschnitte erläutern beides.
Kodierung und Agentenaufgaben
Googles Schlagzeilen-Ansprüche für 3.7 Flash sind entwicklerorientiert: besser beim Debugging, fähiger, auf Anhieb einsetzbaren Code zu produzieren, und gewissenhafter bei der mehrstufigen Planung und Tool-Aufrufen. Die Generations-über-Generations-Zahlen, bestätigt in 9to5Googles Startbericht, untermauern diese Behauptungen.
| Benchmark | Gemini 3.6 Flash | Gemini 3.7 Flash |
|---|---|---|
| DeepSWE v1.1 (Fehlerbehebungen im Repository-Maßstab) | 49,0 % | 65,3 % |
| FrontierCode 1.1 Main | 34,4 % | 43,6 % |
| WebDev Arena (Elo) | 1538 | 1588 |
| GDP.pdf (Dokumentenlogik) | 22,0 % | 34,0 % |
| AutomationBench (Agentenaufgaben) | 17,0 % | 30,4 % |
Der AutomationBench-Sprung ist derjenige, den Agenten-Entwickler genau beobachten sollten. Eine nahezu Verdoppelung eines Agenten-Benchmarks in drei Wochen deutet darauf hin, dass die Behauptung „denkt gewissenhafter bei Tool-Aufrufen“ mehr als nur Marketing ist.
Wie schneidet das im Vergleich zu Claude und GPT ab? Bei DeepSWE v1.1 erreichte der Frontier-Tier 73,0 % für GPT-5.6 Sol Max bei seinem Start, mit Grok 4.6 bei 65,9 %; unser Vergleich von Grok 4.6 vs GPT-5.6 Sol vs Claude Fable 5 behandelt diese Ergebnisse ausführlich. Sol Max behält einen echten Vorsprung bei der Fehlerbehebung im Repository-Maßstab, und Claude Fable 5s Stärke ist die Konsistenz über Kodierungs- und Agenten-Bewertungen hinweg, wo es selten schlechter als Zweiter ist. Gemini 3.7 Flash hat diesen Abstand nicht geschlossen. Es ist in Schlagweite gekommen, zu einem Bruchteil der Kosten, was ein anderes Wertversprechen ist als „beste Punktzahl gewinnt“.
Zwei spezielle Zahlen runden das Bild ab: 90,7 % bei Harvey LAB-AA für juristisches Denken und 97,0 % bei der 128k-Needle-Retrieval, die Punktzahl, die das 1M-Fenster in der Praxis vertrauenswürdig macht.
Multimodale Eingabe
Dies ist der klarste strukturelle Unterschied zwischen den drei APIs. Gemini 3.7 Flash akzeptiert Text, Bilder, Video, Audio und PDF im selben contents-Array an einem einzigen Endpunkt. Claude und GPT verarbeiten Text und Bilder gut, aber Video- und Audio-Workloads werden typischerweise durch separate Transkriptions- oder Vorverarbeitungsschritte geleitet, bevor der Text das Modell erreicht.
Wenn Ihr Produkt Dokumente berührt, ist der GDP.pdf-Sprung von 22,0 % auf 34,0 % das relevante Signal: Dieser Benchmark misst die Denkfähigkeit über reale PDFs mit Tabellen, Scans und fehlerhaften Layouts. Einen Vertrag oder eine Rechnung direkt ohne OCR-Pipeline in das Modell einzuspeisen, eliminiert eine ganze fehleranfällige Stufe aus Ihrer Architektur.
Die praktische Regel: Für Text- und Bild-Chats ist die Modalität gleichwertig. Für Video-Frames, Anrufaufzeichnungen oder Dokumentenstapel ist Gemini das einzige der drei Modelle, bei dem die Eingabepipeline in einen einzigen API-Aufruf zusammenfällt.
Preisphilosophie
Die drei Anbieter verfolgen unterschiedliche Preisstrategien, und der Unterschied verrät Ihnen, für wen jedes Modell gedacht ist.
Google preist 3.7 Flash für die Markteroberung. Der Einführungspreis von 0,75 $ pro 1 Mio. Eingabe-Tokens und 3,75 $ pro 1 Mio. Ausgabe-Tokens gilt bis zum 31. Dezember 2026 und beträgt die Hälfte dessen, was 3.6 Flash bei der Einführung gekostet hat. Am 1. Januar 2027 übernimmt der Standardpreis von 1,50 $ und 7,50 $, eine glatte Verdoppelung. Diese Frist ist ein starker Anreiz: Google möchte, dass Ihr Traffic gebunden ist, bevor der Preis zurückgesetzt wird. Die vollständige Token-Berechnung, mit durchgerechneten Beispielen für Chatbots und Agentenschleifen, finden Sie in unserer Gemini 3.7 Flash Preisübersicht.
Anthropic und OpenAI bepreisen ihre Flaggschiffe als Premium-Fähigkeit. Die Raten variieren je nach Stufe und ändern sich oft, aber die Form ist konsistent: Frontier-Ausgabe-Tokens kosten um ein Vielfaches mehr als Flash, und beide Anbieter verkaufen den Premium-Preis für weniger fehlgeschlagene Läufe, nicht für billigere Tokens. Anthropic fügt einen Aufwandsparameter hinzu, der Kosten gegen Fähigkeiten innerhalb eines Modells abwägt; OpenAI staffelt stattdessen nach Modellgrößen.
Welche Philosophie gewinnt, hängt von Ihrer Fehlerökonomie ab. Ein günstiges Modell, das eine Aufgabe fehlschlägt, erzeugt Reparaturarbeiten, die mehr kosten als die eingesparten Tokens; ein Premium-Modell verdient seinen Preis nur, wenn es diese Fehler verhindert. Vergleichen Sie die Kosten pro abgeschlossener Aufgabe, nicht die Kosten pro Token, und passen Sie die Preise nach dem 1. Januar 2027 neu an, wenn Geminis Raten sich verdoppeln.
API-Ergonomie
Schemaunterschiede sind die Steuer, die Sie zahlen, wenn Sie Anbieter wechseln oder zwischen ihnen routen. Hier ist dieselbe One-Turn-Anfrage in allen drei Formen.
Googles Gemini API verpackt Turns in contents mit parts, und Generationseinstellungen befinden sich in generationConfig:
{
  "contents": [
    { "role": "user", "parts": [{ "text": "Summarize this changelog." }] }
  ],
  "generationConfig": { "temperature": 0.3, "maxOutputTokens": 1024 }
}
Anthropics Messages API platziert das Modell und ein erforderliches max_tokens auf oberster Ebene, wobei der System-Prompt als eigenes Feld fungiert:
{
  "model": "claude-fable-5",
  "max_tokens": 1024,
  "system": "You summarize changelogs in three bullets.",
  "messages": [{ "role": "user", "content": "Summarize this changelog." }]
}
OpenAI faltet den System-Prompt in das messages-Array selbst ein:
{
  "model": "gpt-5.6-sol",
  "messages": [
    { "role": "system", "content": "You summarize changelogs in three bullets." },
    { "role": "user", "content": "Summarize this changelog." }
  ]
}
Der Textfall sieht nah genug aus, um ihn mit einem Adapter zu überbrücken. Die Tool-Nutzung ist der Punkt, an dem die Abstraktion undicht wird: Google deklariert Funktionen in einem tools-Array mit functionDeclarations und steuert den Aufruf über toolConfig, Anthropic verwendet sein eigenes Tool-Schema mit verschiedenen Antwortblöcken, und OpenAI hat wieder sein eigenes Funktionsformat. Auch die Streaming-Chunk-Formen unterscheiden sich, obwohl alle drei auf Server-Sent Events basieren. Gateways und Kompatibilitäts-Endpunkte normalisieren die grundlegende Chat-Form, aber multimodale Teile und Tool-Aufrufe überleben die Übersetzung selten sauber; wir haben dasselbe Problem bei verschiedenen Anbietern in unserem API-Formatvergleich für DeepSeek V4 Pro dokumentiert.
Der Integrationsrat ist unglamourös: Halten Sie eine dünne Anbieterschicht zwischen Ihrem Produkt und dem Modell. Teams, die das tun, wechseln Anbieter in Tagen statt in Quartalen.
Wann man welches wählen sollte
Benchmarks und Schemata zusammengefasst in einer Entscheidungsliste:
- Wählen Sie Gemini 3.7 Flash für Agenten-Traffic mit hohem Volumen, multimodale Pipelines, die Video, Audio oder PDFs aufnehmen, und jede Workload, bei der die Kosten pro Aufruf die Produktmarge begrenzen. Es ist auch die offensichtliche Sandbox für Experimente zur Computernutzung; unsere Aufschlüsselung von Computernutzung versus strukturierten APIs behandelt, wann diese Fähigkeit sich auszahlt.
- Wählen Sie Claude Fable 5 für langfristige autonome Arbeiten: mehrstündige Agenten-Sitzungen, Aufgaben, bei denen ein entgleister Schritt eine Stunde Fortschritt zunichtemacht, und Workloads, die die Kosten-Fähigkeits-Einstellung des Aufwandsparameters belohnen.
- Wählen Sie GPT-5.6 Sol für Codierungs-Agenten im Repository-Maßstab, die mit minimaler Überwachung über große bestehende Codebasen arbeiten, und für Teams, die das tiefste Drittanbieter-Ökosystem rund um die API wünschen.
- Wählen Sie einen Router, wenn Sie können. Das Muster, auf das sich die meisten Produktionsteams einigen: Ein günstiges Standardmodell bewältigt den Großteil des Traffics, und die schwierigsten 10 % eskalieren zu einem Frontier-Modell. Die Startzahlen von Gemini 3.7 Flash machen es zu einem glaubwürdigen Standard in dieser Architektur, was bei 3.6 Flash nicht der Fall war.
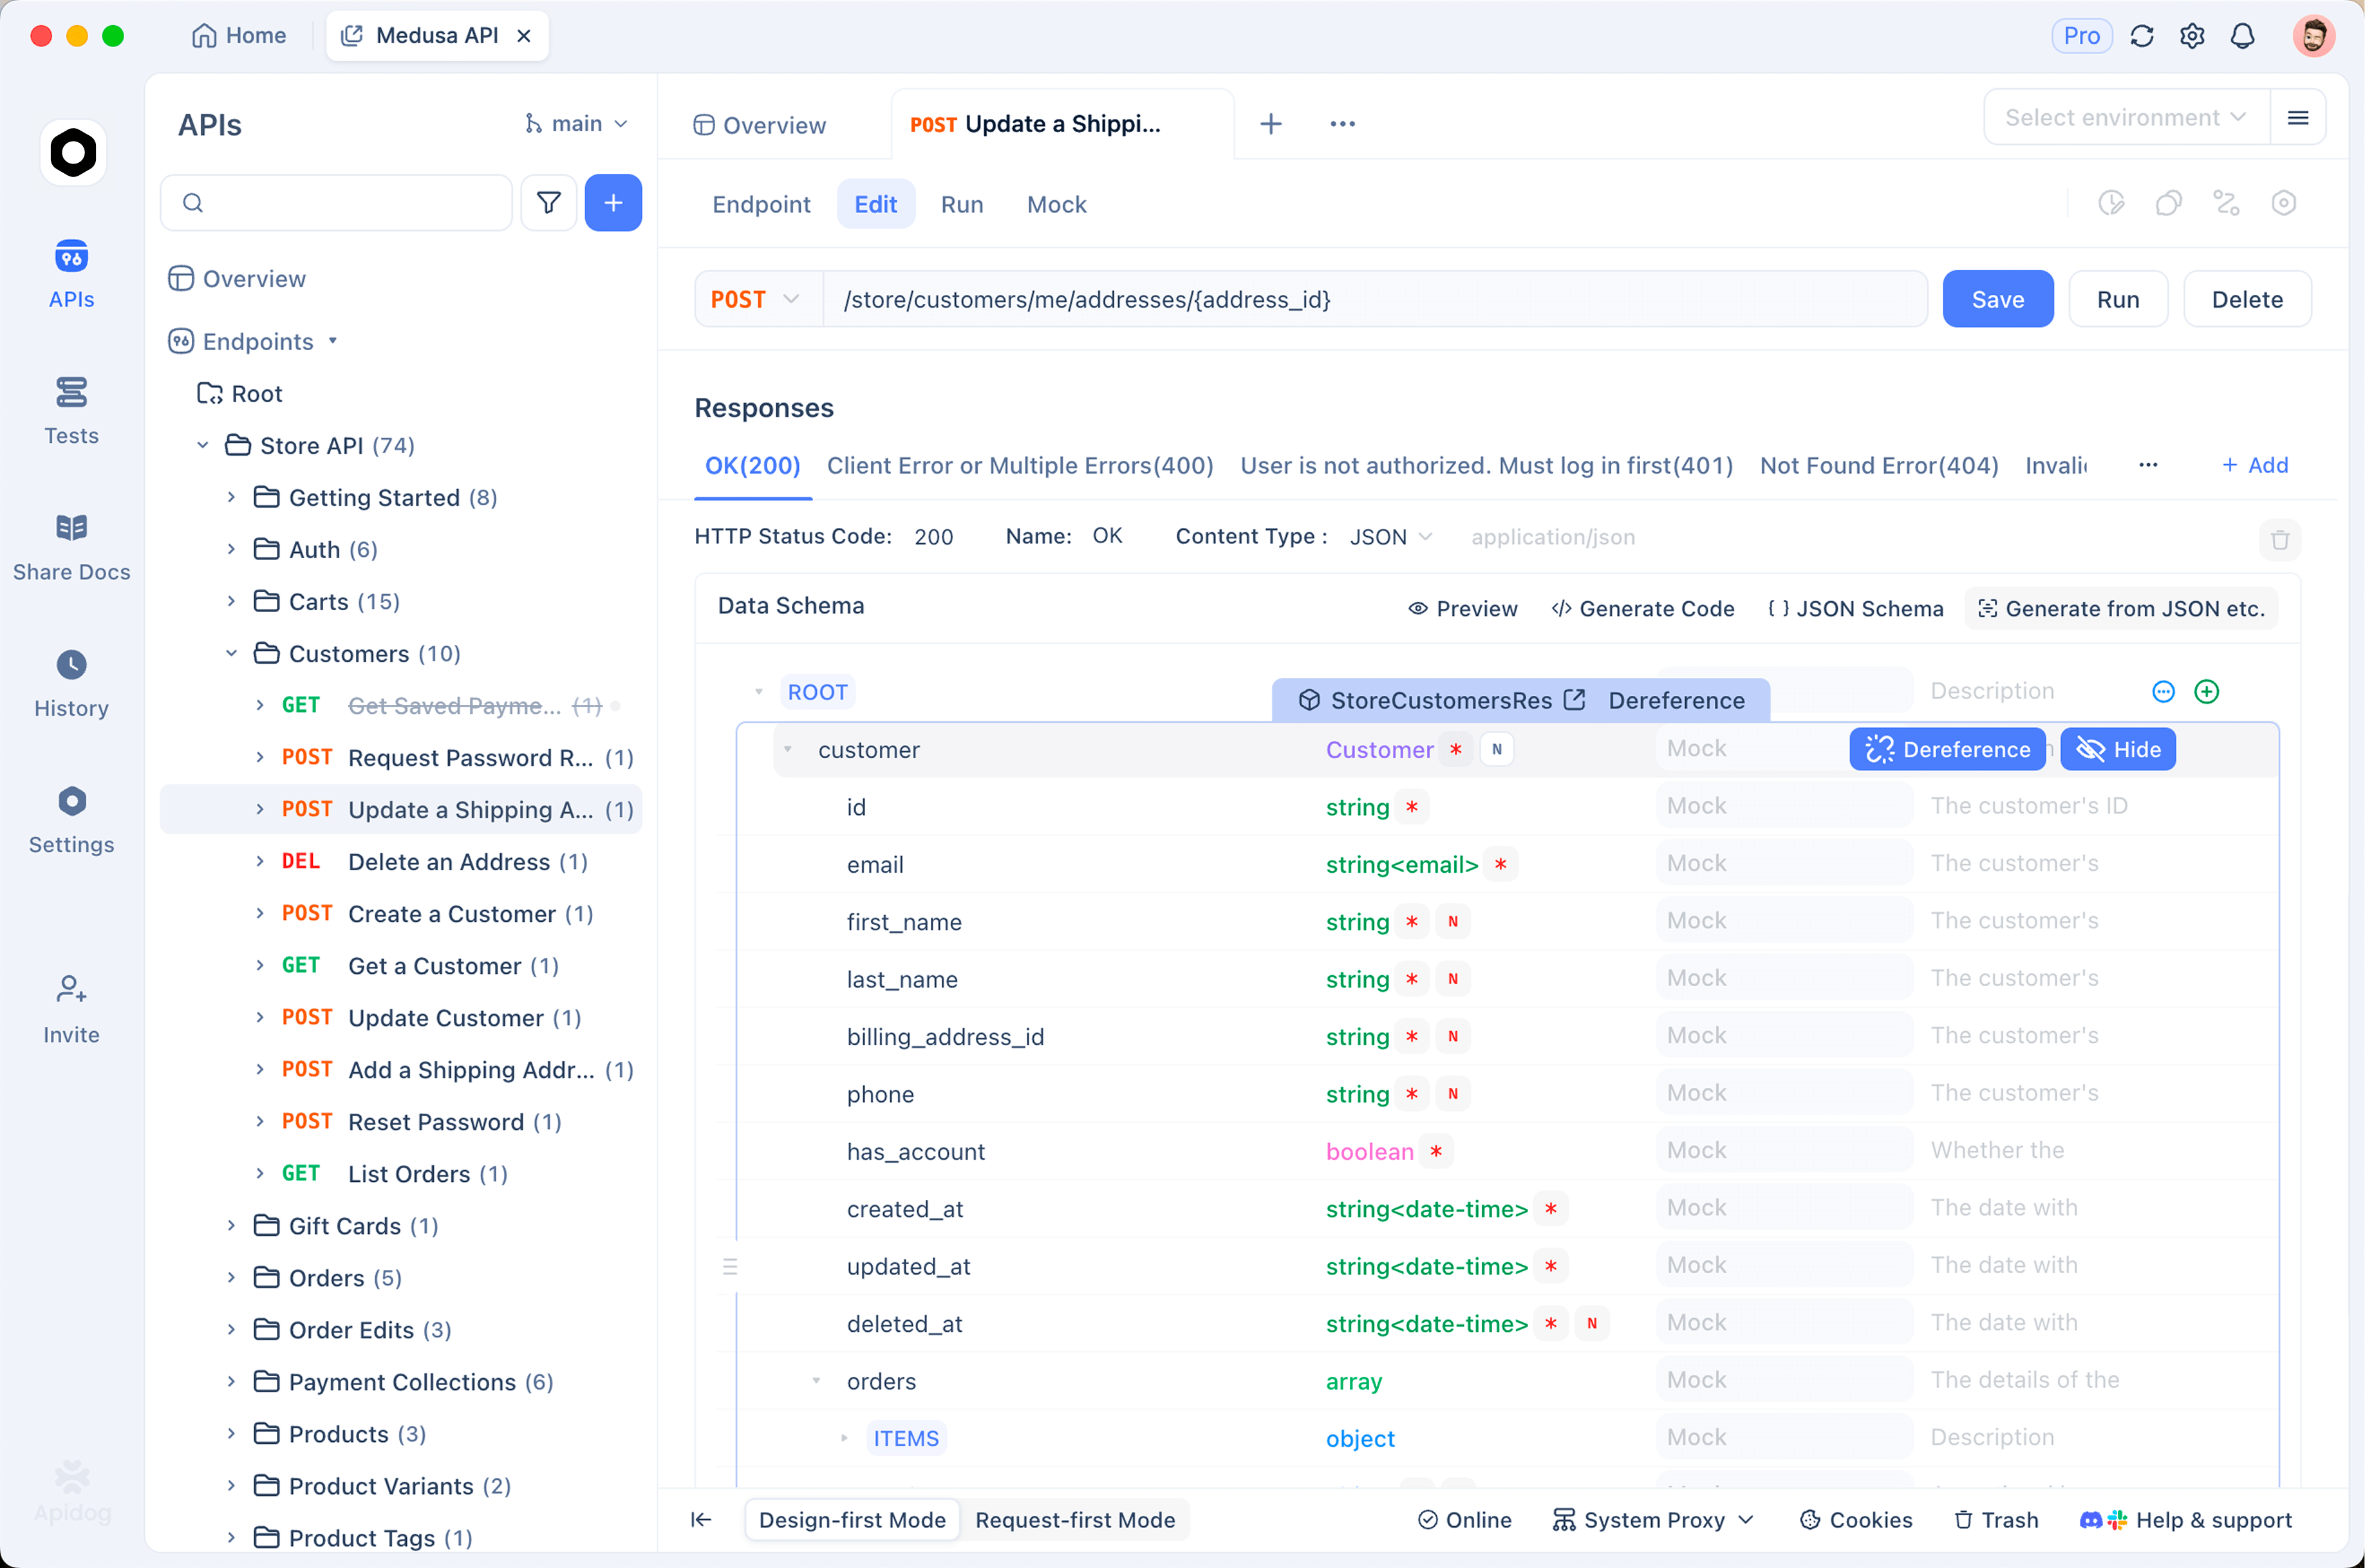
Testen Sie alle drei Anbieter in einem Apidog-Arbeitsbereich
Der Vergleich, der zählt, ist der, den Sie mit Ihren eigenen Prompts durchführen. Apidog hält Sammlungen für Google, Anthropic und OpenAI in einem einzigen Projekt, sodass der Vergleich einen Nachmittag statt eines Sprints dauert:
- Erstellen Sie drei Umgebungen, eine pro Anbieter, jede mit eigener Basis-URL und Authentifizierungs-Header:
x-goog-api-keyfür Gemini,x-api-keyfür Anthropic, ein Bearer-Token für OpenAI. Der Wechsel des Anbieters wird zu einem Dropdown-Menü, nicht zu einer Code-Äänderung. - Sammeln Sie 20 reale Prompts aus Ihrem Produkt. Fügen Sie Ihren System-Prompt, Ihre Tool-Definitionen, falls Sie Funktionsaufrufe verwenden, und mindestens fünf bekanntermaßen schwierige Fälle hinzu.
- Fügen Sie Assertions hinzu für das, was Ihnen wichtig ist: Antwortgültigkeit, Token-Zählungen aus dem Nutzungsblock jedes Anbieters, Latenzschwellenwerte. Bei Tool-Calling-Workloads stellen Sie sicher, dass das Tool-Call-JSON geparst wird und Ihrem Schema entspricht; Modelle versagen dort weitaus häufiger als in Prosa.
- Führen Sie jede Suite dreimal pro Modell aus. Die Ausgabe von LLMs variiert; drei Läufe zeigen die Varianz auf, die eine einzelne Demo verbirgt. Vergleichen Sie die Erfolgsrate und die Kosten pro erfolgreicher Aufgabe.
- Behalten Sie die Suite bei. Modellveröffentlichungen erfolgen nun wochenweise; 3.7 Flash folgte 3.6 um drei Wochen. Teams mit einem bestehenden Test-Framework entscheiden sich an einem Nachmittag neu, anstatt sich auf Anekdoten zu verlassen.
- Nicht an der Spitze. GPT-5.6 Sol Max erreichte 73,0 % bei DeepSWE v1.1 gegenüber 65,3 % von 3.7 Flash, und Claude Fable 5 führt bei der Konsistenz über Kodierungs- und Agenten-Benchmarks hinweg. Was sich geändert hat, ist das Preis-Leistungs-Verhältnis: 3.7 Flash erreicht Werte, die vor Wochen im Frontier-Bereich lagen, während es Arbeitspferdepreise verlangt.
- Bis zum 31. Dezember 2026 kostet Gemini 3.7 Flash 0,75 $ pro 1 Mio. Eingabe-Tokens und 3,75 $ pro 1 Mio. Ausgabe-Tokens. Frontier Claude- und GPT-Modelle verlangen ein Vielfaches mehr pro Token; prüfen Sie die aktuellen Preisinformationen, bevor Sie Kosten modellieren. Denken Sie daran, dass sich der Einführungspreis am 1. Januar 2027 verdoppelt.
- Google stellt einen OpenAI-kompatiblen Endpunkt bereit, der die grundlegende Chat-Struktur verarbeitet, sodass ein
base_url-Tausch für Text-Ein- und Text-Ausgabe funktioniert. Multimodale Teile und Tool-Aufrufe lassen sich nicht sauber abbilden, verwenden Sie daher das nativecontents-Schema für alles, was über einfachen Chat hinausgeht. Das Tutorial zu Funktionsaufrufen für Gemini 3.7 Flash zeigt das native Tool-Format von Anfang bis Ende. - Ja. Es wird mit Funktionsaufrufen, Suche als Tool und Computernutzung geliefert, sowie aktualisierten CBRN- und Cybersicherheits-Leitplanken. Die Verbesserung von AutomationBench von 17,0 % auf 30,4 % ist der nächstgelegene veröffentlichte Indikator dafür, wie viel besser der Agenten-Loop geworden ist.
- Die Gemini API mit einem AI Studio Schlüssel, Google AI Studio, die Gemini App, Gemini Spark für AI Pro und Ultra Abonnenten, Google Antigravity, Android Studio und Gemini Enterprise, in über 160 Ländern. Produktions-GCP-Teams können es über Vertex AI mit OAuth anstelle eines API-Schlüssels aufrufen.
- Die falsche Schlussfolgerung aus diesem Vergleich ist: „Gemini hat die Frontier eingeholt.“ Das ist nicht der Fall; Sol besitzt immer noch die Code-Tiefe im Repository-Maßstab und Fable 5 immer noch die langfristige Zuverlässigkeit. Die richtige Schlussfolgerung ist, dass sich die Untergrenze verschoben hat: Arbeitspferdepreise kaufen jetzt Bewertungen, die vor einem Quartal Premium-Tarife rechtfertigten, was den Standard in jeder Router-Architektur zurücksetzt. Modelle der Flash-Klasse bewältigen den Großteil, Flaggschiffe die Eskalationen.
- Die Entscheidung ist messbar, also messen Sie sie. Verbinden Sie alle drei Anbieter in einem Arbeitsbereich, führen Sie Ihre realen Prompts mit Assertions aus und lassen Sie die Kosten pro abgeschlossener Aufgabe den Gewinner bestimmen. Laden Sie Apidog kostenlos herunter, richten Sie die drei Umgebungen ein, und Sie werden anbieterbezogene Beweise haben, bevor das Einführungs-Preiszeitfenster schließt.