Bei ERNIE 5.5 Flash vs. DeepSeek V4.1 Flash vs. GPT-6 Luna geht es um drei unterschiedliche Kompromisse. ERNIE 5.5 Flash Preview lässt sich heute kostenlos über OpenRouter aufrufen. DeepSeek V4.1 Flash bietet offene MIT-Gewichte und kostet $0,30/$1,20 pro 1M Tokens zur Spitzenzeit, davon die Hälfte außerhalb der Spitzenzeiten. GPT-6 Luna hat den niedrigsten offiziellen Bezahlpreis: $0,10 rein, $0,50 raus.
Alle drei verarbeiten etwa 1M Tokens Kontext und können Tools aufrufen. Sie unterscheiden sich in Preisstruktur, Gewichten und Reife. Alle Preise unten wurden am 12. November 2026 von den offiziellen Seiten abgelesen, und der letzte Abschnitt zeigt, wie Ihr Coding-Agent alle drei mit einem Prompt testet.
ERNIE 5.5 Flash vs. DeepSeek V4.1 Flash vs. GPT-6 Luna im Überblick
| ERNIE 5.5 Flash Preview | DeepSeek V4.1 Flash | GPT-6 Luna | |
|---|---|---|---|
| API-Modell-ID | baidu/ernie-5.5-flash-preview:free (OpenRouter) |
deepseek-flash |
gpt-6-luna |
| Eingabe pro 1M | Kostenlos auf OpenRouter; Bezahlpreis [VERIFY] | $0,30 Spitzenzeit, $0,15 Nebenzeiten | $0,10 |
| Zwischengespeicherte Eingabe pro 1M | n/v beim kostenlosen Endpunkt | $0,006 Spitzenzeit, $0,003 Nebenzeiten | $0,01 |
| Ausgabe pro 1M | Kostenlos auf OpenRouter; Bezahlpreis [VERIFY] | $1,20 Spitzenzeit, $0,60 Nebenzeiten | $0,50 |
| Kontextfenster | 1.024.000 Tokens | 1M Tokens | 1.050.000 Tokens |
| Maximale Ausgabe | 1.024.000 (OpenRouter-Eintrag) | 384K | 128.000 |
| Parameter | 280B gesamt, 14B aktiv (MoE) | 552B Backbone, 8B aktiv beim Prefill / 16B beim Decode | Nicht veröffentlicht |
| Eingabetypen | Text | Text, Bild | Text, Bild |
| Offene Gewichte | Basismodell ja; Preview „in Kürze“ unter Apache 2.0 | Ja, MIT | Nein |
| Status | Preview-Checkpoint | Produktion (Version 1017) | Produktion |
Quellen: Baidus Release-Beitrag, OpenRouter, DeepSeek-Preise und OpenAIs Luna-Seite.
Was die einzelnen günstigen Modelle sind
ERNIE 5.5 Flash Preview ist Baidus erstes post-trainiertes Modell auf Basis von ERNIE 5.5 Flash Base, das Anfang November auf Hugging Face veröffentlicht wurde. Es ist ein sparsames Mixture-of-Experts-Modell mit 280B Parametern, davon 14B aktiv, und einem Kontext von 1M Tokens. Baidu bezeichnet es als intermediären Checkpoint: Das Post-Training ist noch nicht abgeschlossen. Hintergrund: was ERNIE 5.5 Flash ist und das frühere ERNIE 5.1.
DeepSeek V4.1 Flash ist ein multimodales MoE mit einem 552B-Parameter-Backbone. Es aktiviert 8B Parameter pro Token während des Prefill und 16B während des Decode, was inputlastige Agent-Arbeit günstig hält. Die Gewichte stehen unter der MIT-Lizenz auf Hugging Face. Siehe die DeepSeek-V4.1-Flash-Erklärung.
GPT-6 Luna ist OpenAIs „effizientestes Modell für fokussierte, volumenstarken Aufgaben“. Es nimmt Text und Bilder entgegen, unterstützt Reasoning-Aufwand von none bis max und funktioniert mit den Tools der Responses API. Siehe was GPT-6 Luna ist.
Preis pro 1M Tokens und was ein echter Agent-Aufruf kostet
Agent-Schleifen senden bei jedem Schritt denselben langen Kontext erneut, daher sind Caching und Tageszeit-Regeln mindestens so wichtig wie der Listenpreis.
- GPT-6 Luna: $0,10 Eingabe, $0,01 zwischengespeicherte Eingabe, $0,125 Cache-Schreibvorgänge, $0,50 Ausgabe. Prompts mit über 272K Eingabe-Tokens kosten für die gesamte Anfrage das 2-Fache der Eingabe- und das 1,5-Fache der Ausgabepreise. Batch und Flex laufen mit 50 % des Standardpreises.
- DeepSeek V4.1 Flash: $0,30 Eingabe (Cache-Miss), $0,006 Cache-Treffer, $1,20 Ausgabe während der Spitzenzeiten. Die Preise außerhalb der Spitzenzeiten liegen bei der Hälfte. Spitzenzeit ist 01:00 bis 04:00 und 06:00 bis 10:00 UTC, Montag bis Freitag; alles andere, einschließlich Wochenenden, gilt als Nebenzeit.
- ERNIE 5.5 Flash Preview: $0 für Ein- und Ausgabe am
:free-Endpunkt von OpenRouter, der laut OpenRouter ratenbegrenzt ist. Baidu hat auf einer heute zugänglichen Seite keinen Bezahlpreis pro Token veröffentlicht, behandeln Sie also jede Zahl, die Sie anderswo sehen, als [VERIFY].
Nehmen wir einen Agent-Schritt mit 50.000 Eingabe-Tokens und 2.000 Ausgabe-Tokens, ohne Cache:
| Modell | Kosten pro Aufruf | Kosten pro 1.000 Aufrufe |
|---|---|---|
| GPT-6 Luna | $0,0060 | $6,00 |
| DeepSeek V4.1 Flash, Spitzenzeit | $0,0174 | $17,40 |
| DeepSeek V4.1 Flash, Nebenzeit | $0,0087 | $8,70 |
ERNIE 5.5 Flash Preview, :free |
$0 | $0 (innerhalb der Rate-Limits) |
Nehmen wir nun an, dass 90 % dieser Eingabe ein Cache-Treffer sind, was für einen Agenten, der dasselbe Repository erneut liest, normal ist. Luna sinkt auf etwa $0,0020 pro Aufruf (plus ein einmaliger Cache-Schreibvorgang). DeepSeek sinkt auf etwa $0,0042 zur Spitzenzeit und $0,0021 in der Nebenzeit. Der Abstand zwischen den beiden Bezahlmodellen schließt sich in der Nebenzeit fast.
Zwei Vorbehalte: Jeder Anbieter hat seinen eigenen Tokenizer, daher unterscheiden sich die Token-Zahlen für denselben Prompt, und Reasoning-Tokens werden als Ausgabe abgerechnet, sodass hoher Reasoning-Aufwand die Ausgabeposition aufbläht. Unsere DeepSeek-V4.1-Flash-Preisübersicht und der Vergleich der Sub-$1-API-Tarife gehen tiefer auf die Cache-Rechnung ein.
Kontextfenster, Ausgabelänge und Geschwindigkeit
Das Kontextfenster wird die Entscheidung nicht herbeiführen. Die Ausgabelimits unterscheiden sich stärker: 384K für DeepSeek, 128.000 für Luna und 1.024.000 laut Angabe für den ERNIE-Kostenlosen Endpunkt. Bei Geschwindigkeitsangaben ist Vorsicht geboten:
- ERNIE 5.5 Flash Preview: Die Modellbeschreibung von OpenRouter nennt mehr als 200 Tokens pro Sekunde. OpenRouters selbst gemessener P50-Durchsatz der letzten 3 Tage lag bei 79 Tokens pro Sekunde mit einer P50-Latenz von 2,53 Sekunden, bei einem einzigen Anbieter (Baidu Qianfan).
- DeepSeek V4.1 Flash: keine Tokens-pro-Sekunde-Angabe auf der Preisseite; dafür ein Konkurrenzlimit von 2.500.
- GPT-6 Luna: OpenAI stuft es als „Fast“ ein, mit Build-Tier-Limits von 5.000 Anfragen und 2.000.000 Tokens pro Minute.
Messen Sie aus Ihrer eigenen Region mit Ihren eigenen Prompts; der Apidog-Abschnitt unten richtet das ein.
Offene Gewichte, kostenloser Zugang und Lizenzierung
- DeepSeek V4.1 Flash ist das einzige Modell mit Produktions-Gewichten, die Sie heute unter der MIT-Lizenz herunterladen können. Hosten Sie es selbst oder wählen Sie einen gehosteten Anbieter über seine Hugging-Face-Karte.
- ERNIE 5.5 Flash umfasst zwei Artefakte. Das Basismodell (nur Pretraining, 33,5T Tokens) ist bereits auf Hugging Face verfügbar. Die Preview, das Chat- und Agent-Modell, hat noch keine öffentlichen Gewichte; Baidu sagt, sie werden „in Kürze“ unter Apache 2.0 als Open Source veröffentlicht. Ein online zu findendes Datum ist unbestätigt [VERIFY].
- GPT-6 Luna ist geschlossen. Sie erreichen es über OpenAIs API oder Amazon Bedrock, und der API-Free-Tier ist als „Nicht unterstützt“ gelistet.
Für Tests zum Preis von $0 ist ERNIEs :free-Endpunkt die einfachste Tür. DeepSeek und Luna haben ihre eigenen kostenlosen Routen, behandelt in wie man DeepSeek V4.1 Flash kostenlos nutzt und wie man GPT-6 Luna kostenlos nutzt.
Am besten geeignet für Agents und Coding
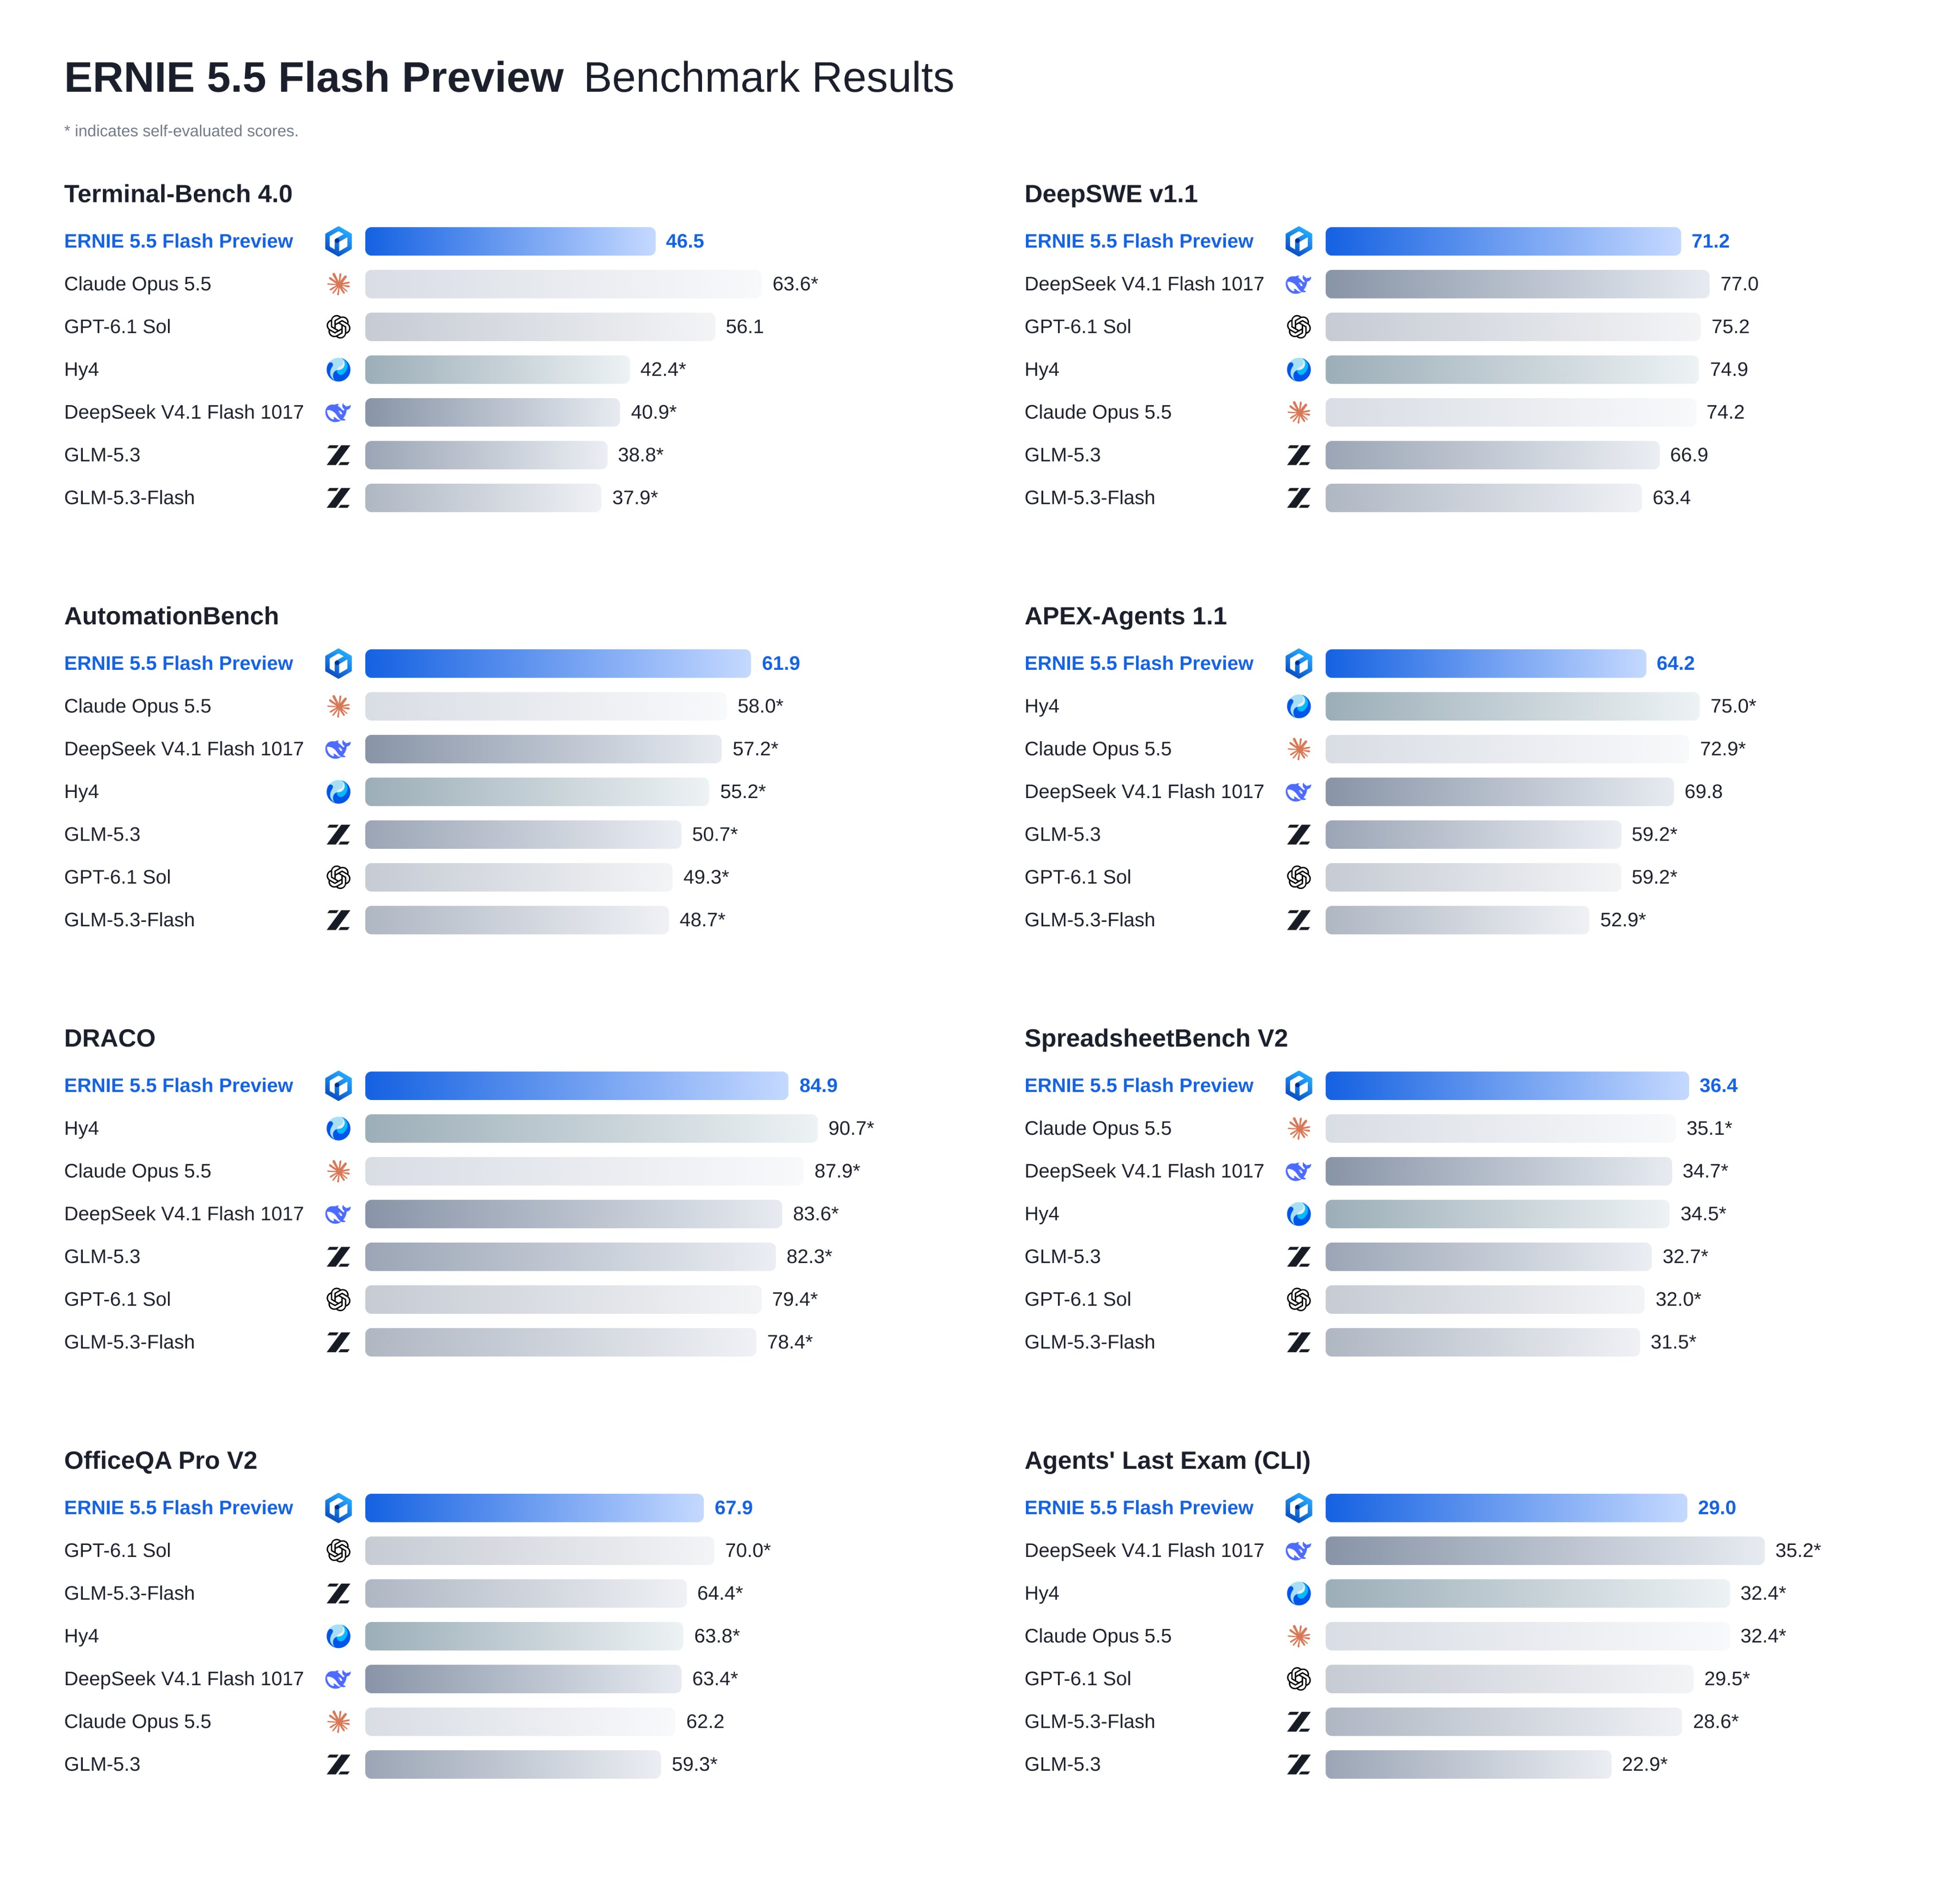
Jeder Anbieter benchmarkt in seinem eigenen Testrahmen, also rechnen Sie diese Zahlen nicht zu einem einzigen Test zusammen. Vergleichen Sie, was jedes Modell betont.
DeepSeek V4.1 Flash meldet 90,6 auf Terminal-Bench 2.1 und 74,2 auf DeepSWE v1.1 bei maximalem Reasoning-Aufwand, beides von DeepSeek in seinem eigenen Testrahmen gemessen. Der Reasoning-Aufwand ist ein Regler von 1 bis 100, und der Endpunkt spricht OpenAI-, Anthropic- und Responses-Formate, sodass es sich nahtlos in Claude Code, Codex oder OpenCode einfügt.
ERNIE 5.5 Flash Preview zeigt auf Baidus Release-Seite, wie es ein Unreal-Engine-5.8-Spiel in einer einzigen 11-stündigen Coding-Aufgabe und fast 100 mobile Mini-Games aus Design-Dokumenten erstellt. Es ist rein textbasiert, daher sind screenshotgesteuerte Agent-Schleifen vorerst ausgeschlossen. OpenRouters Dashboard zeigte außerdem über 3 Tage eine strukturierte Ausgabefehlerrate von 21,70 % und eine Tool-Call-Fehlerrate von 1,01 %, validieren Sie JSON-Ausgaben also, bevor Sie sie in einer Pipeline vertrauen.
GPT-6 Luna punktet bei der Tool-Breite. Die Responses API stellt ihr gehostete Shell, Apply-Patch, Computer-Use und MCP zur Verfügung. Eine Einschränkung: In Chat Completions funktioniert Function Calling nur, wenn reasoning_effort auf none gesetzt ist; nutzen Sie die Responses API für Tools mit aktiviertem Reasoning.
Welches günstige Modell sollten Sie wählen?
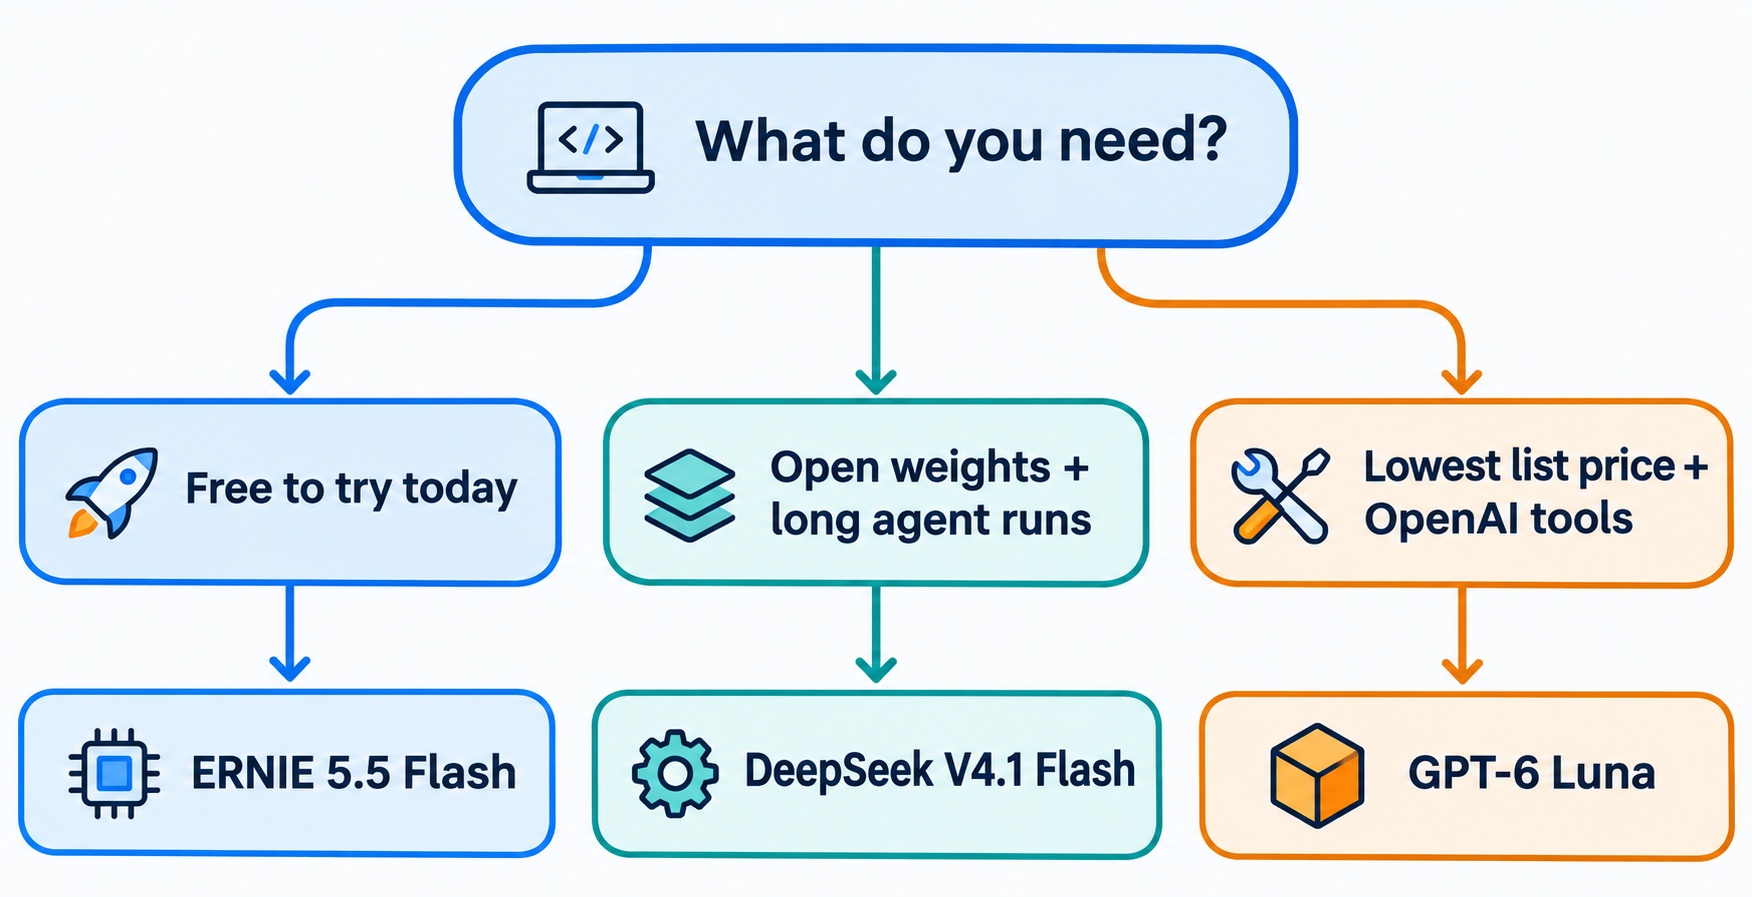
Wählen Sie nach Ihrer Einschränkung, nicht nach einer Bestenliste:
- Sie möchten heute ein neues Modell für $0 ausprobieren: ERNIE 5.5 Flash Preview auf OpenRouter. Rechnen Sie mit Preview-Verhalten und Rate-Limits.
- Sie brauchen offene Gewichte oder planen Self-Hosting: DeepSeek V4.1 Flash.
- Ihr Agent führt lange, inputlastige Sitzungen durch und Sie können Nebenzeiten einplanen: DeepSeek V4.1 Flash, wo Cache-Treffer in der Nebenzeit $0,003 pro 1M kosten.
- Sie wollen den niedrigsten Bezahlpreis und OpenAIs gehostete Tools: GPT-6 Luna.
- Sie brauchen Bildeingabe: DeepSeek V4.1 Flash oder GPT-6 Luna, nicht ERNIE.
Lassen Sie Ihren Coding-Agenten alle drei mit der Apidog CLI vergleichen
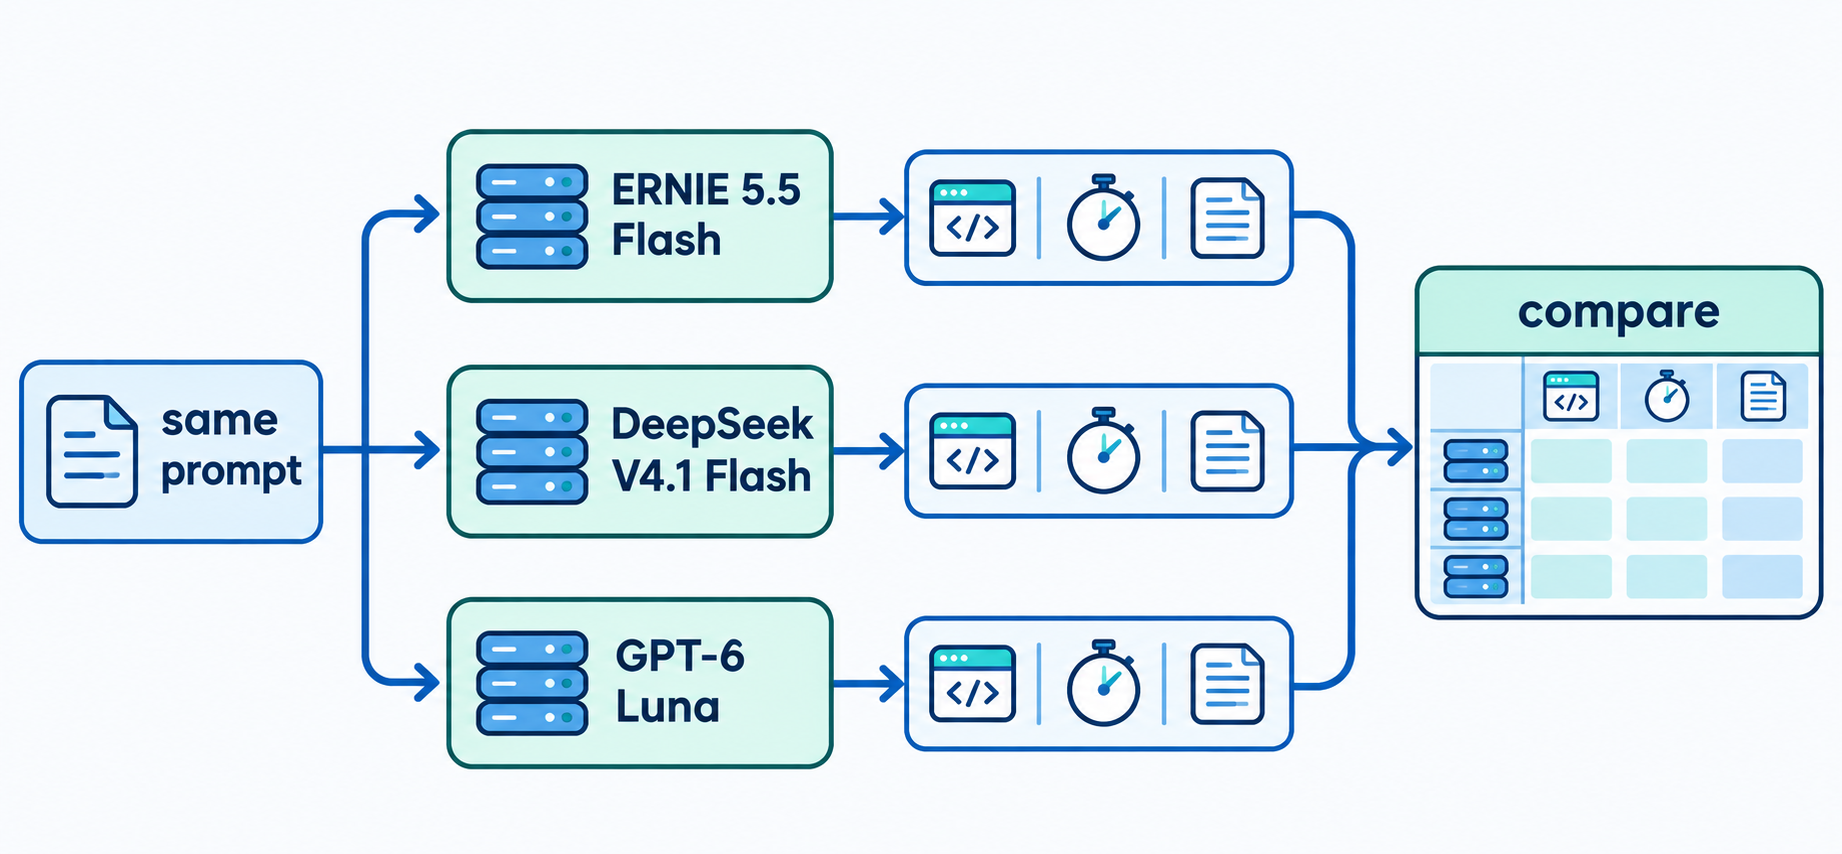
Klicken Sie nicht jedes Mal drei API-Aufrufe von Hand durch, wenn ein Modell aktualisiert wird. Lassen Sie Claude Code, Codex oder Cursor ein Szenario erstellen und es mit der Apidog CLI gegen jeden Anbieter laufen. Alle drei sprechen OpenAI Chat Completions, daher ändern sich nur Base-URL, Modell-ID und Schlüssel.
Richten Sie die CLI einmal ein:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Geben Sie Ihrem Agenten dann einen Prompt:
In Apidog project <projectId>, create three environments: ernie-flash
(base URL https://openrouter.ai/api/v1, model baidu/ernie-5.5-flash-preview:free),
deepseek-flash (https://api.deepseek.com, model deepseek-flash) and gpt-6-luna
(https://api.openai.com/v1, model gpt-6-luna). Create one test scenario that POSTs
the same prompt to {{baseUrl}}/chat/completions with model {{model}}, asserts
status 200 and a non-empty choices[0].message.content, and records
usage.completion_tokens. Run it 5 times per environment and give me a table of
pass rate, average response time and output tokens.
Der Agent erstellt die Umgebungen, prüft das Szenario-Payload gegen das Schema, schreibt es und führt es aus:
apidog environment create ernie-flash --project <projectId> --base-url https://openrouter.ai/api/v1 --variables '<json>'
apidog environment create deepseek-flash --project <projectId> --base-url https://api.deepseek.com --variables '<json>'
apidog environment create gpt-6-luna --project <projectId> --base-url https://api.openai.com/v1 --variables '<json>'
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <projectId> --file scenario.json
apidog test-scenario run <scenarioId> --project <projectId> -e <envId> -n 5 -r cli,json --env-var "apiKey=$OPENROUTER_API_KEY"
Schlüssel über --env-var zu übergeben hält sie aus der geteilten Umgebung heraus. Wiederholen Sie den Lauf pro Umgebung mit dem jeweiligen Anbieter-Schlüssel; die JSON-Berichte speisen Ihre Tabelle. Derselbe Lauf-Befehl mit -r junit lässt sich in CI integrieren; siehe den Apidog-CLI-CI/CD-Leitfaden und die Claude-Code-Einrichtungsanleitung. Apidogs Free-Plan deckt bis zu 4 Nutzer ab, sodass ein kleines Team dies ohne bezahlten Sitzplatz durchführen kann.
FAQ
Ist ERNIE 5.5 Flash günstiger als DeepSeek V4.1 Flash? Im Moment ja: Der :free-Endpunkt von OpenRouter kostet $0 innerhalb seiner Rate-Limits. Baidu hat keinen überprüfbaren Bezahlpreis veröffentlicht, daher ist ein Bezahl-zu-Bezahl-Vergleich noch nicht möglich.
Welches Modell hat das größte Kontextfenster? Sie liegen nah beieinander. GPT-6 Luna listet 1.050.000 Tokens, ERNIE 5.5 Flash Preview 1.024.000 auf OpenRouter, und DeepSeek V4.1 Flash 1M. Lunas Preis verdoppelt sich bei Eingaben über 272K Tokens.
Kann ich eines dieser Modelle lokal ausführen? DeepSeek V4.1 Flash, ja: MIT-Gewichte auf Hugging Face. Die Basismodell-Gewichte von ERNIE 5.5 Flash sind öffentlich, aber das Preview-Chat-Modell ist noch nicht veröffentlicht. GPT-6 Luna hat keine öffentlichen Gewichte.
Welches ist am besten für Coding-Agenten? Das hängt von Ihrem Testrahmen ab. DeepSeek V4.1 Flash meldet starke Agent-Werte in seinen eigenen Tests und unterstützt OpenAI- und Anthropic-Formate. GPT-6 Luna hat den breitesten Satz an gehosteten Tools. ERNIE 5.5 Flash Preview ist kostenlos zu testen, aber rein textbasiert und noch in der Preview.
Hat GPT-6 Luna einen kostenlosen API-Tarif? Nein. OpenAIs Modellseite listet den Free-Tier als „Nicht unterstützt“. Die kostenpflichtige Nutzung beginnt bei $0,10 pro 1M Eingabe-Tokens.