
KI-Modelle, die zu fortgeschrittenem mathematischem Denken fähig sind, werden schnell zu unverzichtbaren Werkzeugen für technische Teams. DeepSeekMath-V2 zeichnet sich durch die Kombination einer massiven 685-Milliarden-Parameter-Architektur mit robusten Selbstverifizierungsmechanismen aus – die es Entwicklern ermöglichen, Theoreme zu beweisen, automatisierte Bewertungen durchzuführen und offene mathematische Probleme über zugängliche APIs anzugehen.
Für API-Entwickler und Backend-Ingenieure erfordert die Integration solcher Modelle in bestehende Arbeitsabläufe zuverlässige und effiziente Werkzeuge. Apidog bietet eine leistungsstarke Plattform zum Entwerfen, Testen und Überwachen von APIs – einschließlich solcher, die mit hochmodernen Modellen wie DeepSeekMath-V2 interagieren. Laden Sie Apidog kostenlos herunter, um Ihre Experimente mit DeepSeekMath-V2-Endpunkten zu optimieren.
DeepSeekMath-V2-Architektur: Gebaut für rigorose mathematische Genauigkeit
DeepSeekMath-V2 wurde von DeepSeek-AI entwickelt, um schrittweise mathematische Korrektheit zu priorisieren, nicht nur Endergebnisse. Zu den wichtigsten Designmerkmalen gehören:
- Massiver Umfang: 685 Milliarden Parameter, Transformer-basiert, optimiert für Langkontext-Schlussfolgerung
- Flexible Bereitstellung: Unterstützt BF16-, F8_E4M3- und F32-Tensortypen für effiziente Inferenz über GPUs und TPUs hinweg
- Selbstverifizierungs-Schleifen: Ein integriertes Verifizierungsmodul prüft jeden Zwischenbeweisschritt in Echtzeit auf logische Konsistenz, kennzeichnet Fehler und fordert Korrekturen an
Wie Selbstverifizierung funktioniert
Im Gegensatz zu traditionellen Sprachmodellen, die Beweise in einer linearen Abfolge generieren, parst das Verifizierungsmodul von DeepSeekMath-V2 jeden Schritt – wie algebraische Manipulationen oder induktive Beweise – und wendet formale Regeln an. Jede Inkonsistenz wird sofort erkannt, was die Gesamtzuverlässigkeit verbessert und mathematische „Halluzinationen“ reduziert.
Langer Kontext und Sparse Attention
Aufbauend auf den Fortschritten der DeepSeek-V3-Serie verwendet DeepSeekMath-V2 Sparse Attention, um ausgedehnte Beweisketten zu verwalten, die oft Tausende von Token umfassen. Entwickler können dies über die Transformers-Bibliothek von Hugging Face implementieren und skalieren, indem sie das Modell mit Standard-Python-Tools laden.
Trainingsmethodik: Reinforcement Learning für zuverlässige Beweise
Das Trainingsregime von DeepSeekMath-V2 kombiniert überwachtes Lernen mit Reinforcement Learning aus menschlichem Feedback (RLHF), zugeschnitten auf mathematische Aufgaben.
- Überwachtes Fine-Tuning: Verwendet kuratierte Datensätze wie ProofNet und MiniF2F, um die grundlegende Theorem-Anwendung zu lehren
- Reinforcement Learning: Das Modell generiert Kandidatenbeweise; der Verifizierer vergibt Belohnungen basierend auf der Schrittgenauigkeit und der Gesamtverifizierbarkeit, wodurch die Erforschung komplexer Probleme gefördert wird
Rechenressourcen werden effizient zugewiesen, indem Beweise mit hohen Unsicherheitswerten für die Verifizierung priorisiert werden. Die Belohnungsfunktion ist definiert als:
r = α · s + β · v
Wobei:
s= Schrittgenauigkeitv= Verifizierbarkeitα, β= Hyperparameter (mittels Gittersuche abgestimmt)
Dieser Ansatz beschleunigt die Konvergenz (bis zu 20 % weniger Epochen) und stellt sicher, dass das Modell robust gegenüber Fehlern in allen mathematischen Domänen ist.
Ethische Überlegungen werden durch das Filtern voreingenommener Datenquellen durchgesetzt, wodurch eine faire Leistung von der algebraischen Geometrie bis zur Zahlentheorie unterstützt wird.
Benchmark-Ergebnisse: DeepSeekMath-V2 übertrifft in mathematischer Argumentation
DeepSeekMath-V2 setzt neue Standards bei wichtigen mathematischen Benchmarks:
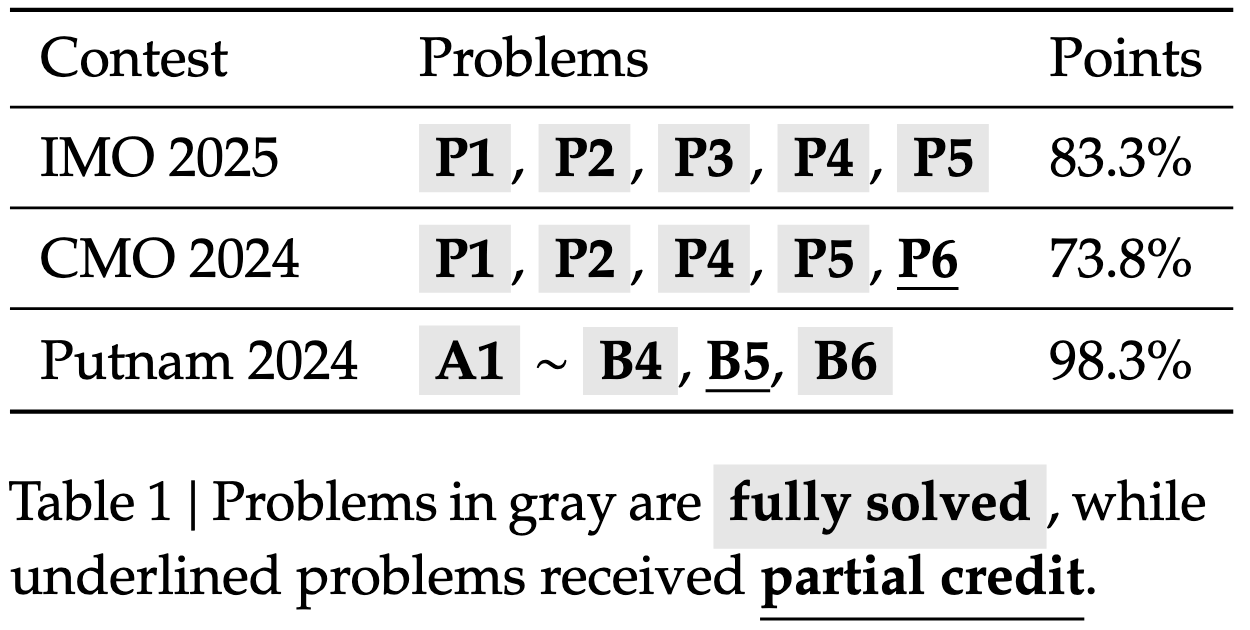
| Benchmark | DeepSeekMath-V2 Ergebnis | GPT-4o (Vergleich) | Hauptstärke |
|---|---|---|---|
| IMO 2025 | Gold (7/6 gelöst) | Silber (5/6) | Beweisverifizierung |
| CMO 2024 | 100% | 92% | Schritt-für-Schritt-Strenge |
| Putnam 2024 | 118/120 | 105/120 | Skalierte Rechenadaption |
| IMO-ProofBench | 85% pass@1 | 65% | Selbstkorrektur-Schleifen |
- Gold-Niveau bei IMO 2025: Löst alle Probleme mit verifizierbaren Beweisen
- 100 % bei CMO 2024: Vollständige Korrektheit mit Schritt-für-Schritt-Strenge
- Überlegene pass@1-Raten: 85 % für kurze Beweise, 70 % für erweiterte Beweise
Im Gegensatz zu Modellen, die Ableitungen abkürzen, betont DeepSeekMath-V2 die Vollständigkeit und Treue des Beweises und reduziert die Fehlerraten in Ablationsstudien um 40 %.
Einblick in selbstverifizierbares Denken: Sicherheit über die Generierung hinaus
Was DeepSeekMath-V2 wirklich auszeichnet, ist seine proaktive Selbstverifizierung:
- Verifizierungsmodul: Parsiert Beweise in abstrakte Syntaxbäume (ASTs) und prüft auf Regelverletzungen (z. B. Kommutativität, Induktionsbasen)
- MCTS für die Beweissuche: Die Monte-Carlo-Baumsuche erkundet mehrere Beweiszweige und schneidet ungültige Pfade mit Verifizierungs-Feedback ab
Beispiel-Pseudocode für die Generierung verifizierter Beweise:
def generate_verified_proof(problem):
    root = initialize_state(problem)
    while not terminal(root):
        children = expand(root, generator)
        for child in children:
            score = verifier.evaluate(child.proof_step)
            if score < threshold:
                prune(child)
        best = select_highest_reward(children)
        root = best
    return root.proof
Dieser Mechanismus ermöglicht es dem Modell, vertrauenswürdige Ergebnisse zu liefern, selbst für neuartige oder ungelöste Probleme.
Praktische Integration: DeepSeekMath-V2-APIs mit Apidog nutzen
Für API-fokussierte Teams eröffnet die Integration von DeepSeekMath-V2 neue Möglichkeiten in Bildung, automatisierter Bewertung, Forschung und Industrieoptimierung.
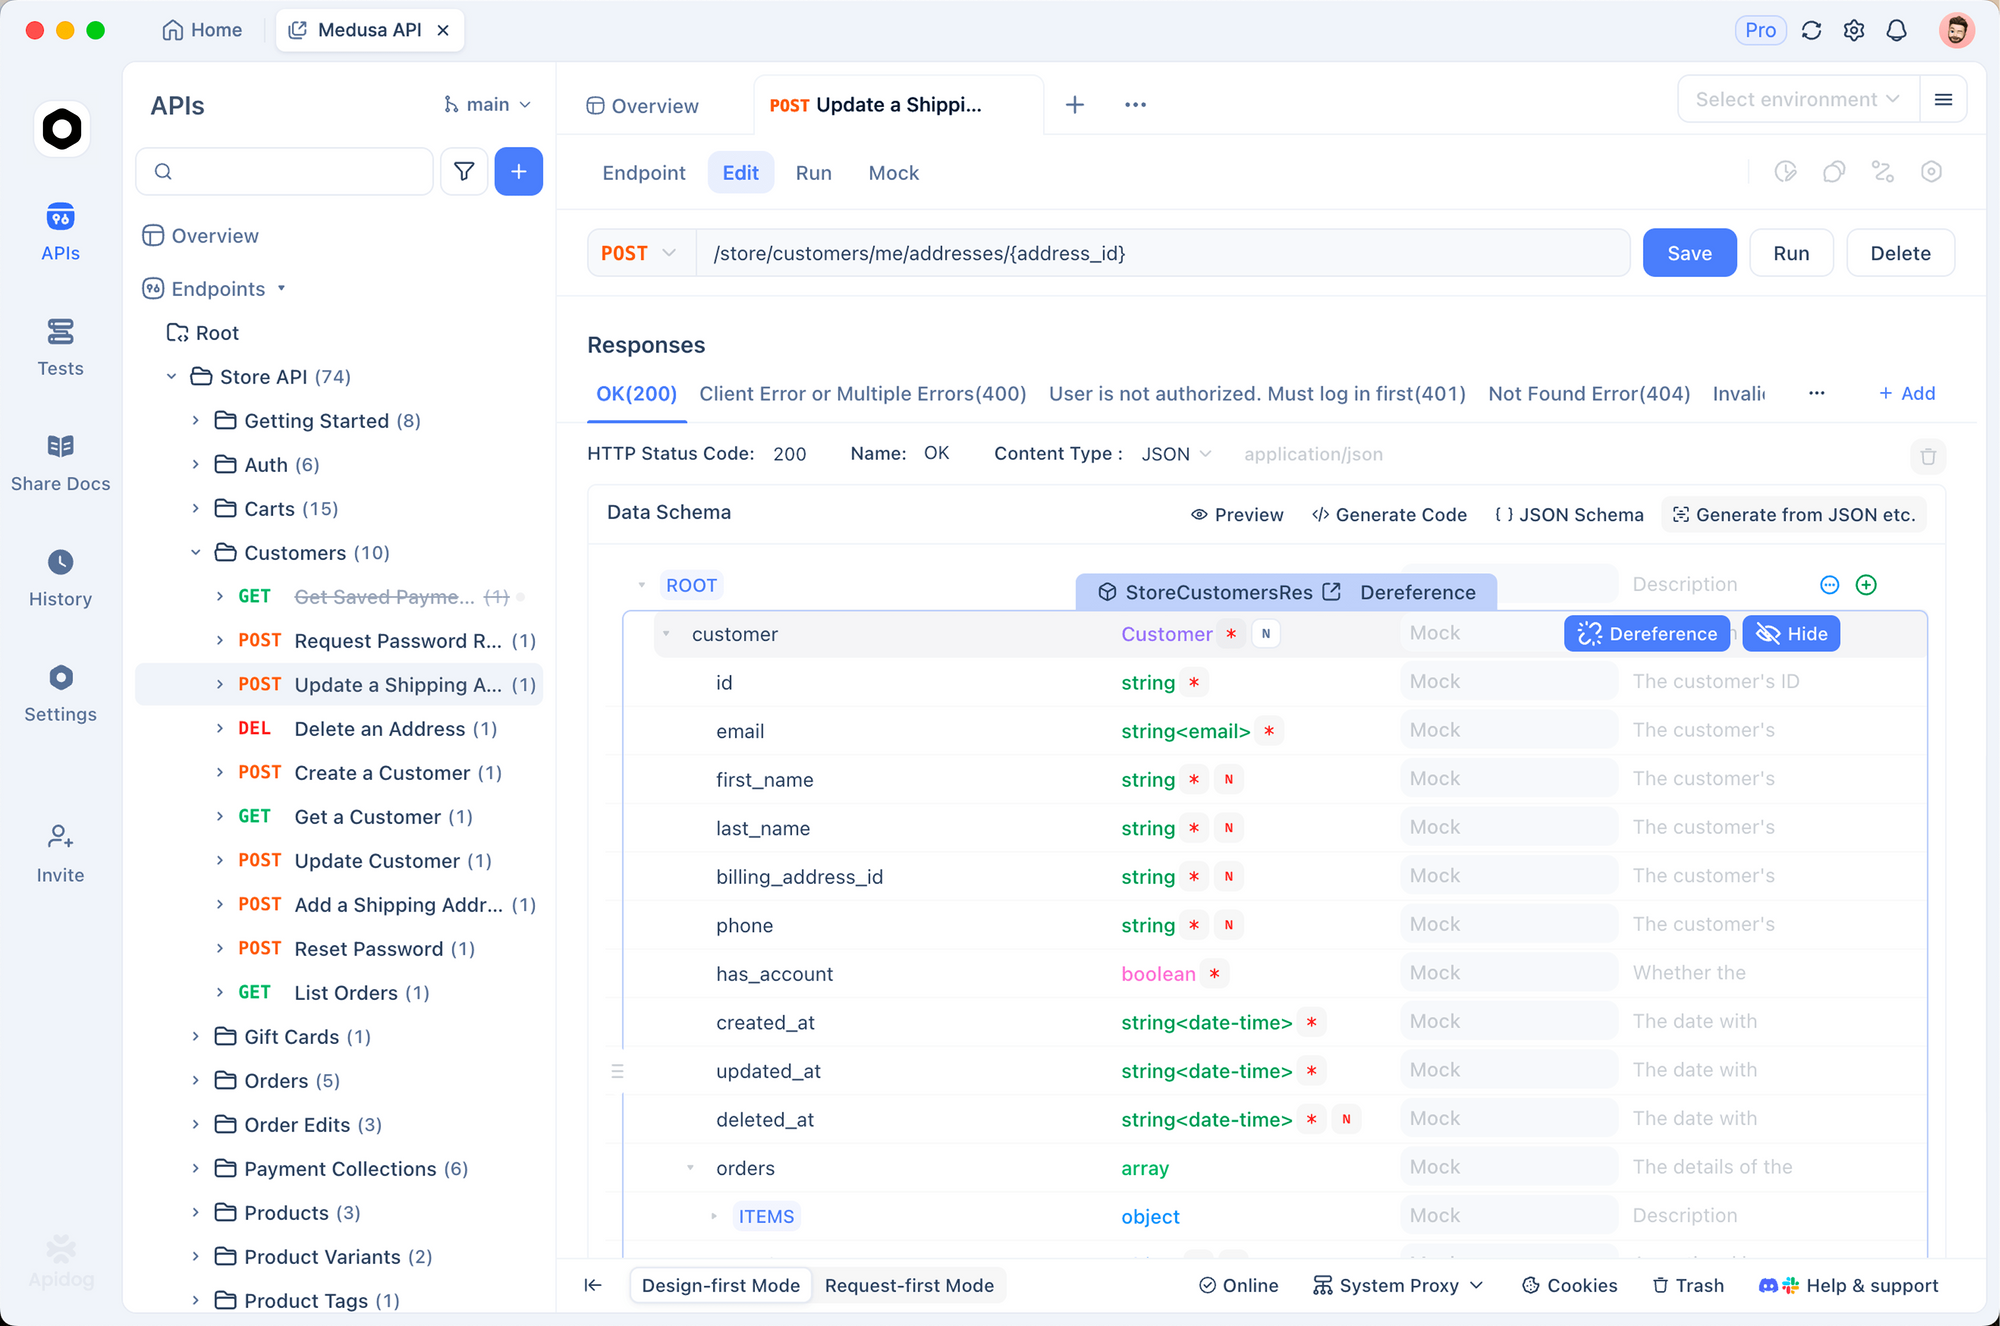
Wie Apidog DeepSeekMath-V2 API-Workflows optimiert
Schritt-für-Schritt-Integration:
- API-Schemata entwerfen: Endpunkte zur Beweisgenerierung und Eingabe-/Ausgabeformate definieren
- Antworten mocken und testen: Apidog verwenden, um DeepSeekMath-V2-Antworten zu simulieren, die sowohl Lösungen als auch Verifizierungsspuren enthalten
- Leistung überwachen: API-Latenz und Erfolgs-/Fehlerraten in Echtzeit-Dashboards verfolgen
- Batch-Verifizierung: Skalierung auf Batch-Verarbeitung mit Apidogs Caching- und Vertrags-Testfunktionen
Nach der Bereitstellung von DeepSeekMath-V2 über FastAPI und Hugging Face können Teams beispielsweise API-Verträge sofort validieren, Regressionstests automatisieren und Schema-Entwicklungen mit Apidog verwalten – das spart Zeit und reduziert den manuellen Aufwand.
Modellvergleiche und bekannte Einschränkungen
- Übertrifft Llama-3.1-405B und Open-Source-Modelle um 15–20 % in der Beweisgenauigkeit
- Erreicht die Leistung von Closed-Modellen (wie GPT-4o) bei verifizierungsintensiven Aufgaben
- Apache 2.0 Lizenz: Offen und produktionsfreundlich
Einschränkungen:
- Hohe VRAM-Anforderungen (mindestens 8x A100 GPUs für Inferenz)
- Verifizierung erhöht die Latenz bei langen Beweisen
- Hat Schwierigkeiten mit interdisziplinären Problemen, denen eine formale Struktur fehlt
Zukünftige Updates könnten diese durch Modelldestillation und breitere mehrsprachige Unterstützung angehen.
Zukünftige Richtungen: Mathematische KI mit API-First-Integration vorantreiben
DeepSeekMath-V2 ist darauf ausgelegt, multimodales Denken (z. B. diagrammbasierte Beweise) und eine tiefere Integration mit formalen Theorem-Provern wie Coq oder Isabelle zu unterstützen. Die automatisierte Verifizierer-Evolution mittels Reinforcement Learning ist eine weitere vielversprechende Richtung.
Für API-Entwickler stellt die Nutzung von Tools wie Apidog sicher, dass die Integration und Skalierung solch fortschrittlicher Modelle effizient, wartbar und zuverlässig bleibt – und so die Lücke zwischen Forschungsdurchbrüchen und realer Anwendung schließt.