DeepSeek veröffentlichte am 10. September 2026 die Modellkarte für DeepSeek-V4.1-Flash, und die Zahlen sind für V4-Pro-Kunden unangenehm. Das kleinere, günstigere Modell erzielt bei allen von DeepSeek aufgelisteten Coding- und Agenten-Benchmarks höhere Werte als das Flaggschiff, kostet in Spitzenzeiten 70 bis 77 % weniger pro Token, und am 14. September wird es V4-Pro vollständig absorbieren: Jede deepseek-v4-pro-Anfrage wird an V4.1-Flash weitergeleitet und zu Flash-Tarifen abgerechnet.
Dies ist nicht der übliche Kompromiss zwischen klein und groß. Es ist ein Vergleich mit einer Frist. Wenn Sie V4-Pro in der Produktion betreiben, haben Sie vier Tage Zeit, um herauszufinden, was sich ändert, wenn die Umleitung greift. Wenn Sie V4-Flash betreiben, ist die Änderung bereits erfolgt: Der Name deepseek-v4-flash wird heute von V4.1-Flash bedient.
Unten: alle drei Modelle hinsichtlich Architektur, von DeepSeek gemeldeten Benchmarks, USD-Preisen und Durchsatz, dann ein Workflow, um einen Satz von Prompts vor der Umstellung durch deepseek-v4-pro und deepseek-flash in Apidog laufen zu lassen, um Ausgaben, Latenz und Nutzungszählungen zu vergleichen. Für den detaillierten Architekturblick lesen Sie zuerst was DeepSeek-V4.1-Flash ist; für die Migrations-Checkliste, sehen Sie den Leitfaden zur V4-Pro-Außerbetriebnahme.
TL;DR
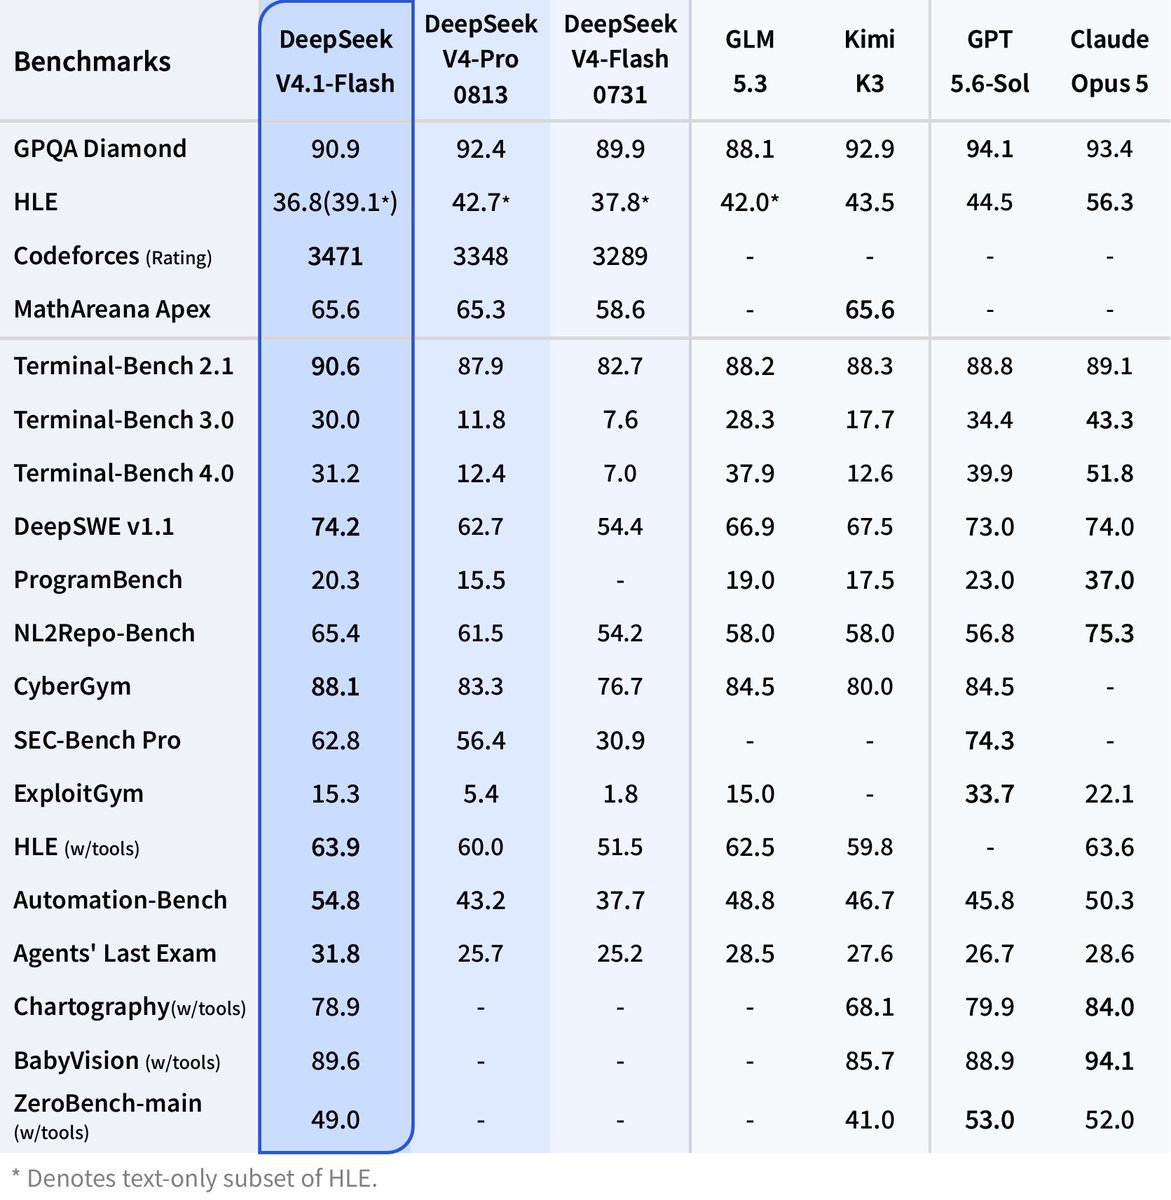
- V4.1-Flash gewinnt bei DeepSeeks eigenen Benchmarks. DeepSWE v1.1 ist die Schlagzeile: 74,2 gegenüber 62,7 für V4-Pro und 54,4 für V4-Flash.
- Es ist das günstigste der drei Modelle. Der Peak-Cache-Fehler-Input liegt bei 0,30 $ pro 1 Million Token gegenüber 1,32 $ für V4-Pro und 0,44 $ für das alte V4-Flash.
- Es ist auf Durchsatz ausgelegt. 8 Mrd. aktive Parameter beim Prefill, ein KV-Cache von 890 Byte pro Token und ein Parallelitätslimit von 2.500.
- Nach dem 14. September gibt es nur noch eine Wahl. Der V4-Pro-Traffic wird auf V4.1-Flash umgeleitet. Die Frage ist, was Sie gewinnen und verlieren, nicht, welches Sie wählen sollen.
Spezifikationen im Vergleich
Die V4.1-Generation ist eine neue Architektur, kein erneutes Post-Training. DeepSeek nennt sie einen Kausalen Encoder-Decoder (CED): 40 Schichten, aufgeteilt in 20 Encoder und 20 Decoder, mit 384 gerouteten Experten plus einem gemeinsam genutzten Experten pro Schicht. Die Modellkarte beziffert das Backbone auf 552 Mrd. Parameter (763 Mrd. mit dem Vision-Encoder).
| V4-Flash | V4-Pro | V4.1-Flash | |
|---|---|---|---|
| Architektur-Generation | V4 MoE | V4 MoE | V4.1 Kausaler Encoder-Decoder, 40 Schichten |
| Gesamtparameter | 284 Mrd. (OpenRouter-Angabe des Vision-Builds) | Hier nicht offengelegt | 552 Mrd. Backbone, 763 Mrd. mit Vision-Encoder |
| Aktive Parameter | 13 Mrd. | Hier nicht offengelegt | 8 Mrd. Prefill, 16 Mrd. Decode |
| Kontextfenster | 1 Mio. Token | 1 Mio. Token | 1 Mio. Token |
| Max. Ausgabe | 384 Tsd. Token | 384 Tsd. Token | 384 Tsd. Token |
| Vision | Separater Vision-Exp Build | Hier nicht offengelegt | Nativ, DeepSeek-ViT Encoder |
| Lizenz | Hier nicht behandelt | Hier nicht behandelt | MIT, Gewichte auf Hugging Face |
| Parallelitätslimit | 2.500 | 500 | 2.500 |
| API-Status | Außer Betrieb, Alias wird von V4.1-Flash bedient | Leitet am 14. September auf V4.1-Flash um | GA seit 10. September, Modell-ID deepseek-flash |
Die aufgeteilte Anzahl aktiver Parameter ist das Detail, auf das man achten sollte: V4-Flash verwendete 13 Mrd. für jedes Token, während V4.1-Flash 8 Mrd. für den Input und 16 Mrd. für den Output aufwendet, wo die Qualität liegt.
Benchmarks: Woher die 11,5 Punkte kommen
Jede unten aufgeführte Zahl wird von DeepSeek aus der Modellkarte gemeldet. Es wurden keine unabhängigen Tests veröffentlicht, und der Satz "Tests durch mehrere Parteien" in der Außerbetriebnahme-Mitteilung nennt diese nicht. Betrachten Sie sie als Herstellerangaben und überprüfen Sie sie mit Ihren eigenen Prompts.
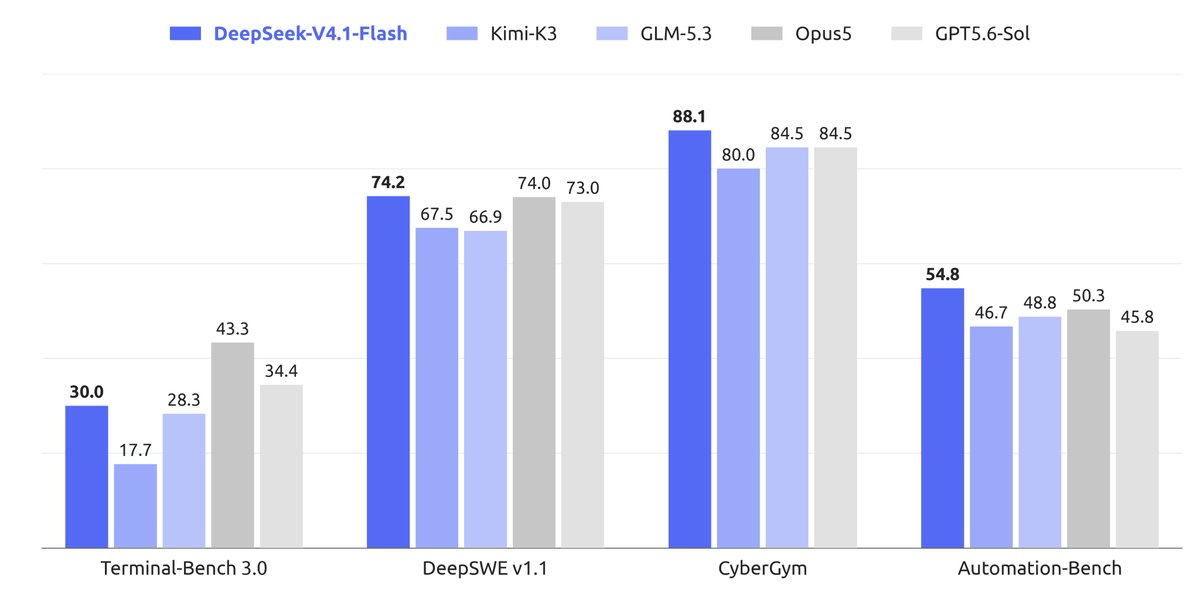
DeepSWE v1.1 (+11,5 gegenüber Pro, +19,8 gegenüber V4-Flash). Dies ist die Schlagzeile und der einzige Unterschied, der groß genug ist, um Entscheidungen zu ändern. DeepSWE misst Software-Engineering-Aufgaben über mehrere Dateien hinweg, die Arbeitslast, die Coding-Agenten den ganzen Tag über bearbeiten. Wenn dies für Ihre Repositories zutrifft, übertrifft V4.1-Flash das Modell, das viermal so viel kostet.
Terminal-Bench 2.1 (+2,7). Shell-gesteuerte Agentenaufgaben. V4-Flash-0731 hatte hier bereits im Juli V4-Pro-Preview geschlagen; V4.1 baut den Vorsprung um weniger als drei Punkte aus. Real, aber nicht entscheidend.
HumanEval (+2,6) und GSM8K (+0,4). Beide nähern sich der Sättigung: Jedes Modell erreicht über 90 Punkte bei GSM8K, und HumanEval sagt wenig über Produktionscode aus. Gewichten Sie diese Zeilen nicht.
MiniMax M3 vs DeepSeek V4 vs Qwen 3.7 zeigt die Zahlen der V4-Generation im Vergleich zu anderen offenen Modellen; keines enthält bisher V4.1.
Kosten: drei Modelle, sechs Preisstufen
Die Spitzenzeiten sind Montag bis Freitag, 01:00 bis 04:00 Uhr und 06:00 bis 10:00 Uhr UTC; alles andere ist außerhalb der Spitzenzeiten zum halben Preis. Die Tarife gelten pro 1 Million Token von der Preisseite, gültig ab dem 10. September. Die V4-Flash-Zeilen verwenden die USD-Tarife vom 21. August 2026 als "Vorher"-Spalte.
| Modell und Stufe | Input, Cache-Treffer | Input, Cache-Fehler | Output |
|---|---|---|---|
| V4-Flash, außerhalb der Spitzenzeiten (Tarife vom 21. Aug) | $0.007 | $0.22 | $0.66 |
| V4-Flash, Spitzenzeiten (Tarife vom 21. Aug) | $0.014 | $0.44 | $1.32 |
| V4-Pro, außerhalb der Spitzenzeiten | $0.022 | $0.66 | $1.98 |
| V4-Pro, Spitzenzeiten | $0.044 | $1.32 | $3.96 |
| V4.1-Flash, außerhalb der Spitzenzeiten | $0.003 | $0.15 | $0.60 |
| V4.1-Flash, Spitzenzeiten | $0.006 | $0.30 | $1.20 |
Gegenüber V4-Flash reduziert V4.1 den Cache-Treffer-Input um etwa 57 %, den Cache-Fehler-Input um etwa 32 % und den Output um etwa 9 %. Gegenüber V4-Pro liegen die Reduzierungen bei 77 % für den Cache-Fehler-Input und 70 % für den Output in Spitzenzeiten.
Ein gerechneter Monat. Ein Coding-Agent verarbeitet monatlich 2 Mrd. Input-Token mit einer Cache-Trefferquote von 70 % (System-Prompt und Repo-Kontext werden über mehrere Runden hinweg wiederverwendet) und generiert 300 Mio. Output-Token, alles in Spitzenzeiten.
| V4-Pro, Spitzenzeiten | V4-Flash, Spitzenzeiten | V4.1-Flash, Spitzenzeiten | V4.1-Flash, außerhalb der Spitzenzeiten | |
|---|---|---|---|---|
| 1,4 Mrd. Cache-Treffer-Input | $61.60 | $19.60 | $8.40 | $4.20 |
| 600 Mio. Cache-Fehler-Input | $792.00 | $264.00 | $180.00 | $90.00 |
| 300 Mio. Output | $1,188.00 | $396.00 | $360.00 | $180.00 |
| Gesamtkosten pro Monat | $2,041.60 | $679.60 | $548.40 | $274.20 |
Das sind 73 % weniger als bei V4-Pro, und die Verlagerung von Batch-Jobs außerhalb der Spitzenzeiten halbiert die Kosten noch einmal. Output-Token dominieren jede Spalte, daher ist die 70%ige Reduzierung des Outputs wichtiger als die Cache-Treffer-Schlagzeile. Die V4.1-Flash Preisaufschlüsselung erklärt die Cache-Treffer-Berechnung.
Geschwindigkeit und Durchsatz
DeepSeek veröffentlicht keine Token-pro-Sekunde-Angabe, daher basiert die Aussage zum Durchsatz auf drei architektonischen Fakten und einer Anekdote.
- KV-Cache mit 890 Byte pro Token. Das FP4-Haupt-KV-Caching reduziert den globalen Cache auf etwa ein Viertel des Speicherbedarfs von V4-Flash. Die Release Notes geben an, dass es 1/4 des HBM- und 1/8 des SSD-Speichers der vorherigen Generation benötigt. Ein voller 1M-Token-Kontext benötigt etwa 0,9 GB Cache.
- 8 Mrd. aktive Parameter beim Prefill. Weniger Rechenleistung pro Input-Token als die 13 Mrd. von V4-Flash, daher sollte die Zeit bis zum ersten Token bei großen Kontexten sinken.
- Parallelität 2.500 vs. 500. Der umgeleitete V4-Pro-Traffic übernimmt das Flash-Limit, ein 5-facher Gewinn für Agenten-Flotten.
- Bericht eines Benutzers: „fast 400 T/s“. Ein X-Benutzer hat dies bei Videotests während der Beta gepostet; es ist eine Anekdote, kein Benchmark. Der HN-Beta-Thread zeigt größtenteils die gleiche Begeisterung.
Messen Sie Ihre eigenen p50- und p95-Werte, bevor Sie dem Ganzen vertrauen.
Was Sie nach dem 14. September verlieren und gewinnen
Nach der Umstellung gibt es kein „welches Modell soll ich wählen“ mehr. deepseek-v4-pro wird zu einem Alias, daher ist die ehrliche Darstellung eine Bilanz.
Sie gewinnen: höhere Punktzahlen bei jedem gelisteten Benchmark, 70 bis 77 % niedrigere Spitzenpreise, 5-fache Parallelität, native Bildeingabe ohne separate Vision-Modell-ID und einen Regler für den Denkaufwand, den DeepSeek als kontinuierlich steuerbar auf einer Skala von 1 bis 100 beschreibt.
Sie verlieren: die Möglichkeit, einen Checkpoint der V4-Generation festzulegen. Prompts, die auf den Stil, die Ausführlichkeit oder die Tool-Call-Formatierung von V4-Pro abgestimmt sind, können abweichen. Die Ausgabelänge und die Anzahl der Reasoning-Token können sich ändern, was Ihre Rechnung auf eine Weise beeinflusst, die die Preistabelle nicht zeigt. Und die Umleitung erfolgt nach DeepSeeks Zeitplan, nicht nach Ihrem.
Diese zweite Liste ist der Grund, warum Sie vor dem 14. vergleichen sollten, nicht danach.
Vergleichen Sie V4-Pro mit V4.1-Flash in Apidog vor der Umstellung
Apidog testet die API-Schicht, daher ist es der richtige Ort, um einen Satz von Prompts durch beide Modell-IDs laufen zu lassen und die Ergebnisse zu vergleichen.
- Endpoint hinzufügen. Erstellen Sie ein Projekt und fügen Sie
POST https://api.deepseek.com/chat/completionshinzu oder importieren Sie eine OpenAPI-Spezifikation. - Schlüssel und Modell-ID in Umgebungen speichern. Speichern Sie
DEEPSEEK_API_KEYund eineMODEL-Variable. Erstellen Sie zwei Umgebungen,v4-promitMODEL=deepseek-v4-proundv41-flashmitMODEL=deepseek-flash, und referenzieren Sie diese alsBearer {{DEEPSEEK_API_KEY}}im Header und"model": "{{MODEL}}"im Body. - Ihre echten Prompts als Anfragen speichern. Wählen Sie 20 bis 30 Prompts aus, die die Produktion repräsentieren: Ihren System-Prompt, einen Tool-Call-Schritt, eine Langtext-Zusammenfassung, eine Code-Bearbeitung mehrerer Dateien. Speichern Sie jeden mit
stream: false, damit dasusage-Objekt im Antwort-Body landet. - Assertions auf Felder, die Ihre Rechnung ändern. Erstellen Sie ein Testszenario aus den gespeicherten Anfragen und fügen Sie Assertions für
usage.prompt_tokens,usage.completion_tokensundusage.prompt_cache_hit_tokenshinzu. Zeichnen Sie die Antwortzeit pro Schritt auf und fügen Sie ein Pre-Request-Skript hinzu, das den Umgebungsnamen in einen Header stempelt, damit die Läufe beschriftet sind. - Einmal pro Umgebung ausführen, dann vergleichen. Führen Sie das Szenario unter
v4-proaus, dann unterv41-flash. Vergleichen Sie die Zählungen der Completion-Token (die Umleitung ändert Ihre Output-Rechnung), die Latenz pro Schritt und den Inhalt selbst auf Formatierungsabweichungen. - Am 14. im CI erneut ausführen. Führen Sie dasselbe Szenario mit
apidog-cliin Ihrer Pipeline bei der Umstellung aus. Alles, was die Umleitung unterbrochen hat, wird als fehlgeschlagene Assertion angezeigt, anstatt als Support-Ticket.
Der gleiche Vergleich als Skript:
import os, time
from openai import OpenAI

client = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"],
                base_url="https://api.deepseek.com")

prompt = "Make payment retries in the checkout service idempotent. Return a unified diff."

for model in ("deepseek-v4-pro", "deepseek-flash"):
    start = time.perf_counter()
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, f"{time.perf_counter() - start:.2f}s",
          r.usage.prompt_tokens, r.usage.completion_tokens)
Führen Sie es in Spitzen- und Nebenzeiten aus und speichern Sie die Ausgaben. Laden Sie Apidog herunter, um den Diff, die Assertions und den Ausführungsverlauf an einem Ort zu behalten.
FAQ
Ist V4.1-Flash besser als V4-Pro beim Coding? Nach den von DeepSeek gemeldeten Zahlen, ja: 74,2 vs. 62,7 bei DeepSWE v1.1 und 90,6 vs. 87,9 bei Terminal-Bench 2.1. Wie sich die V4-Generation im Vergleich zu Claude beim Coding schlägt, sehen Sie unter DeepSeek V4 vs Claude Opus für Coding.
Was passiert mit meiner V4-Pro-Integration am 14. September? Ab 04:00 UTC wird jede deepseek-v4-pro-Anfrage von V4.1-Flash bedient und zu Flash-Tarifen abgerechnet. Ihr Code funktioniert weiterhin; das dahinterliegende Modell ändert sich. Der Migrationsleitfaden enthält die vollständige Checkliste.
Muss ich deepseek-v4-flash in deepseek-flash umbenennen? Nicht heute. deepseek-v4-flash und deepseek-v4-flash-vision-exp werden weiterhin von V4.1-Flash akzeptiert und bedient. DeepSeek hat kein Entfernungsdatum genannt, wechseln Sie also zu deepseek-flash, wenn Sie das nächste Mal die Konfiguration ändern.
Ist V4.1-Flash schneller als V4-Pro? DeepSeek behauptet dies, veröffentlicht aber keine Zahlen. Die Architektur unterstützt die Behauptung: 8 Mrd. aktive Parameter beim Prefill und ein KV-Cache, der ein Viertel der Größe von V4-Flash hat. Messen Sie Ihre eigenen Werte.
Kann ich V4-Pro noch irgendwo ausführen? Nicht über DeepSeeks API nach dem 14. Die Hintergründe der V4-Generation finden Sie in Was ist DeepSeek V4; die Gewichte von V4.1-Flash sind auf Hugging Face unter MIT verfügbar.
Die Kurzversion
V4.1-Flash ist kleiner, günstiger und erzielt gleichzeitig höhere Punktzahlen, zumindest nach den Herstellerangaben, und diese Tabelle kann Ihnen nicht sagen, ob es für Ihre Prompts besser ist. Führen Sie diese Woche beide Modell-IDs mit demselben Prompt-Set in Apidog aus, bewahren Sie die Unterschiede auf, und Sie werden vor Ihren Benutzern wissen, was sich am 14. September ändert.