
Entwickler und KI-Ingenieure stehen ständig vor der Herausforderung, visuelle Daten (wie Bilder und Dokumente) mit textbasierter Verarbeitung in großen Sprachmodellen (LLMs) zu verbinden. DeepSeek-AI löst dies mit DeepSeek-OCR, einem Modell, das speziell für die "kontextuelle optische Kompression" entwickelt wurde – es komprimiert komplexe visuelle Informationen effizient in prägnante, kontextreiche Text-Tokens, die LLMs verarbeiten können.
DeepSeek-OCR wurde im Oktober 2025 veröffentlicht und stellt einen Fortschritt für Teams dar, die an Dokumentenautomatisierung, Bild-zu-Text-Konvertierung und visueller Datenanalyse arbeiten. Sein LLM-fokussiertes Design ermöglicht hohe Genauigkeit, reduzierten Rechenaufwand und Unterstützung für Echtzeit-Workloads in großem Maßstab.
Was ist kontextuelle optische Kompression?
Kontextuelle optische Kompression ist der Prozess, Bilder in kompakte, informationsreiche Text-Tokens für eine effiziente LLM-Verarbeitung umzuwandeln. Im Gegensatz zu herkömmlicher OCR – oft beschränkt auf die einfache Textextraktion – bewahrt DeepSeek-OCR Layout, räumliche Beziehungen und Kontext und ermöglicht so aussagekräftigere und umsetzbarere Ergebnisse.
Wesentliche Vorteile:
- Reicher Kontext: Behält Dokumentenstruktur, Überschriften, Tabellen und räumliche Referenzen bei.
- Flexible Auflösungsmodi: Unterstützt Bilder von schnellen Vorschauen (Tiny-Modus) bis hin zu hochdetaillierten (Large-Modus) mit minimalen Tokens.
- Grounding-Fähigkeiten: Ermöglicht präzise Standortreferenzierung innerhalb von Bildern für fortgeschrittene Anwendungsfälle.
Herkömmliche OCR-Tools wie Tesseract können bei komplexen Layouts und Kontext Schwierigkeiten haben. DeepSeek-OCR nutzt tiefe neuronale Architekturen, die es ihm ermöglichen, handschriftliche Notizen, verzerrte Scans und mehrsprachige Inhalte mit hoher Wiedergabetreue zu verarbeiten.
Wie DeepSeek-OCR funktioniert: Technische Grundlagen
DeepSeek-OCR ist mit einem LLM-zentrierten Vision-Encoder ausgestattet, der visuelle Daten in einen minimalen, aber informativen Token-Satz komprimiert.
Kompressions-Workflow:
- Bildanalyse: Kodiert Bilder in nativer Auflösung und identifiziert Text, Layout und Abbildungen.
- Token-Generierung: Übersetzt visuelle Merkmale in komprimierte Darstellungen, die Abschnitte wie Überschriften, Haupttext und Tabellen unterscheiden.
- Dynamische Auflösung: Der "Gundam"-Modus kombiniert mehrere Bildsegmente für dichte oder überdimensionale Dokumente.
- Grounding-Tags: Verwendet spezielle Referenzen (z. B.
<|ref|>xxxx<|/ref|>) zur präzisen Lokalisierung von Elementen in Bildern – ideal für AR- oder interaktive Dokumentszenarien.
Token-Modi:
- Tiny: 512×512 px, 64 Tokens
- Small: 640×640 px, 100 Tokens
- Base: 1024×1024 px, 256 Tokens
- Large: 1280×1280 px, 400 Tokens
Diese Skalierbarkeit ermöglicht es Ihnen, je nach Workflow Geschwindigkeit, Ressourcennutzung oder Detailgrad zu optimieren.
DeepSeek-OCR in Aktion: Funktionen für Entwickler
DeepSeek-OCR ist vollgepackt mit Funktionen, die auf moderne KI- und API-Entwicklung zugeschnitten sind:
- Flexible native Auflösung: Wählen Sie den optimalen Modus für Ihren Anwendungsfall, von schnellen Vorschauen bis zu detaillierten Scans.
- Dynamischer „Gundam“-Modus: Verarbeitet ultrahochauflösende Dokumente durch Zusammenfügen mehrerer Segmente.
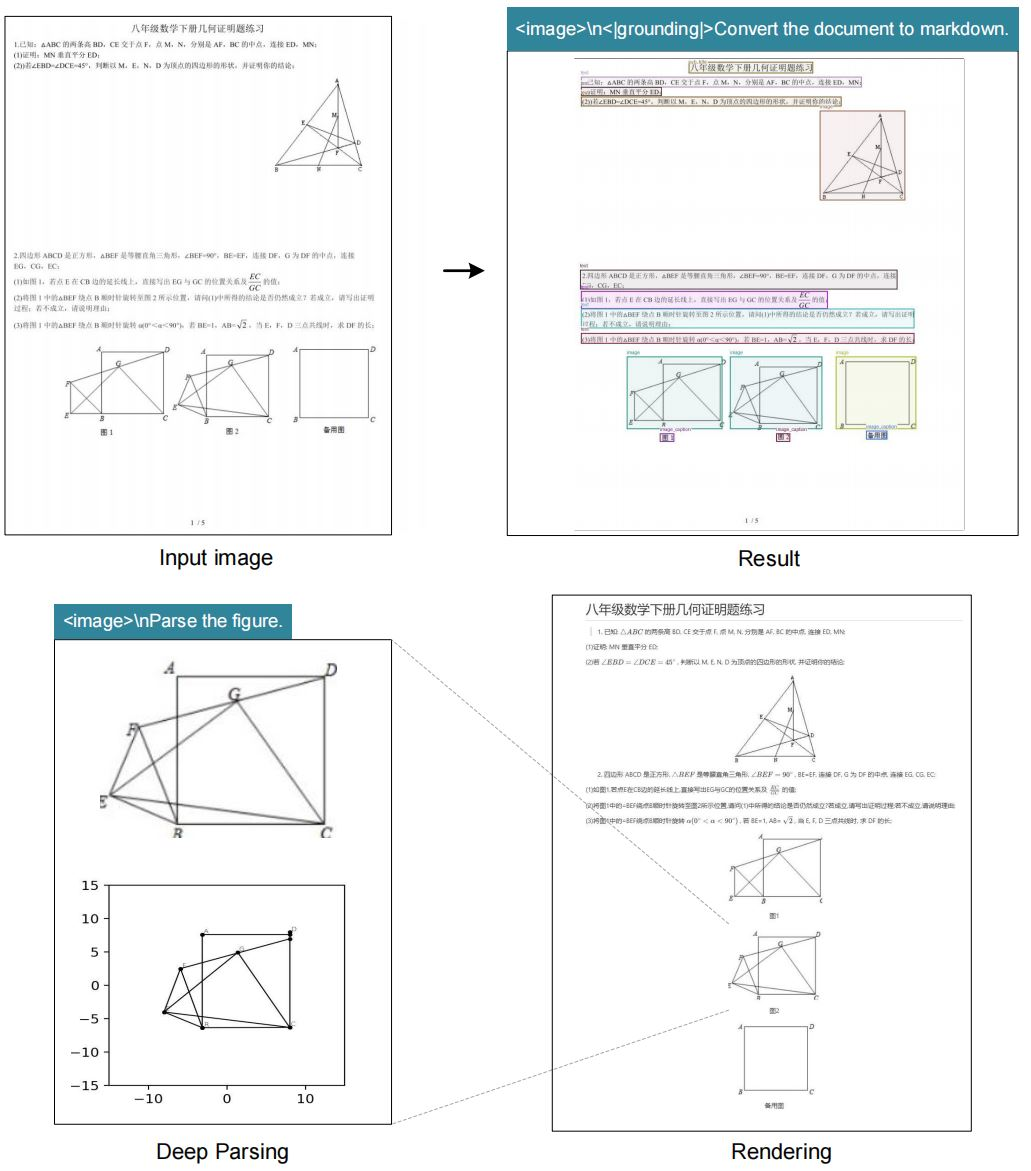
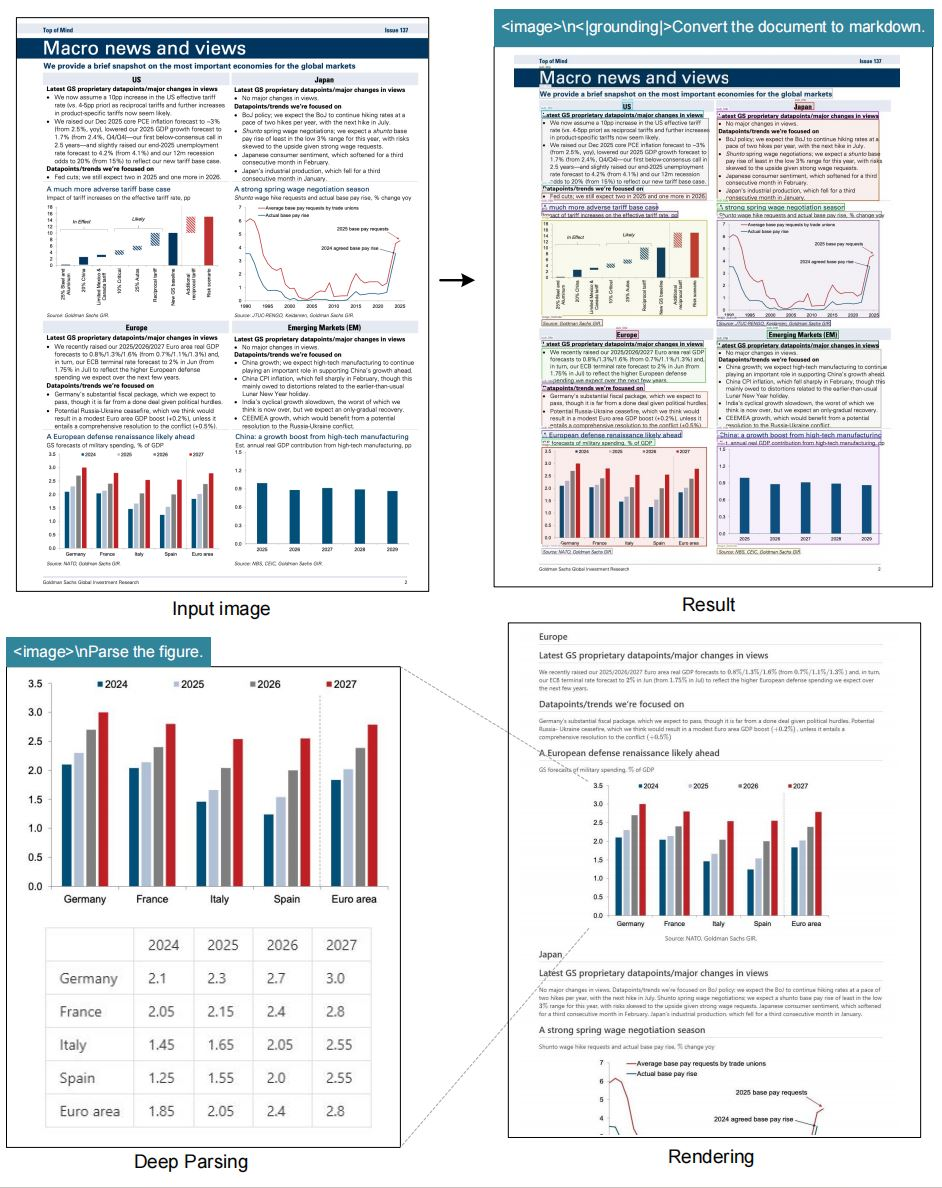
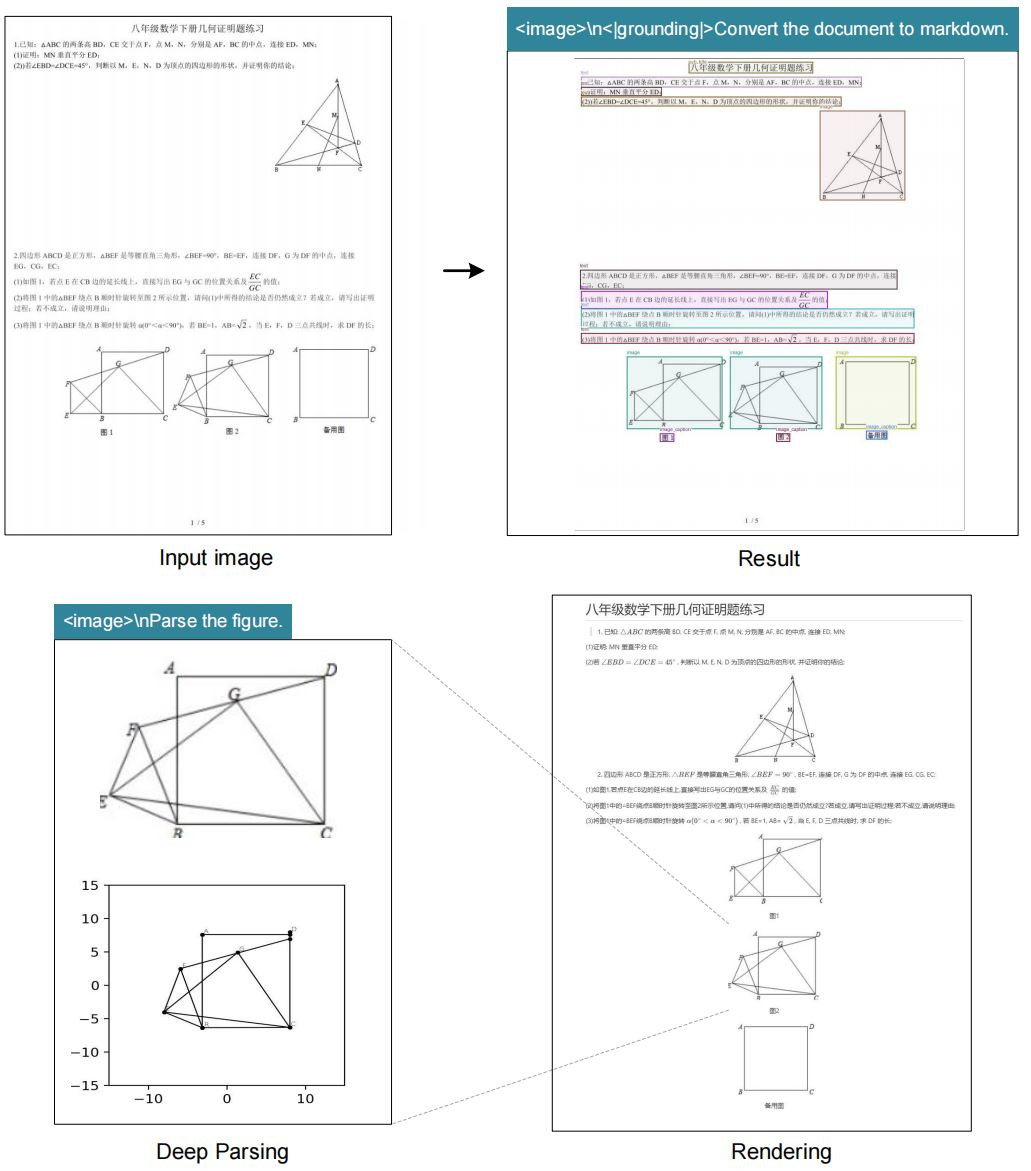
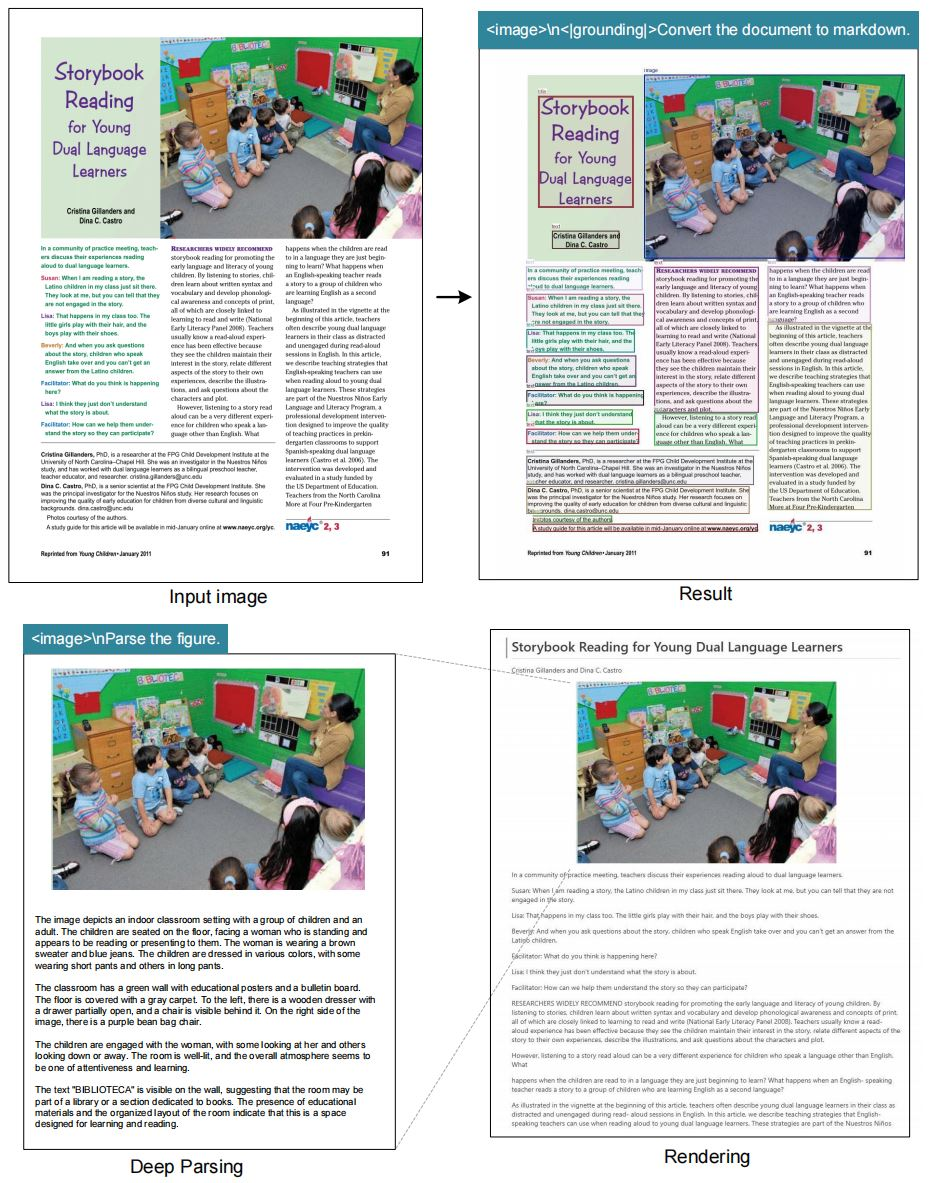
- Markdown-Ausgabe: Konvertiert Dokumente in strukturiertes Markdown, wobei Tabellen, Listen und Hierarchien erhalten bleiben.
- Figuren-Parsing: Extrahiert Daten und Beschreibungen aus Diagrammen und Grafiken.
- Allgemeine Bildbeschreibung: Erzeugt zugängliche, kontextbezogene Bildbeschreibungen.
- Ortsreferenzierung: Abfrage oder Extraktion von Daten zu spezifischen Elementen dank fortschrittlicher Verankerung (Grounding).
- Schnelle Inferenz: Erreicht bis zu 2500 Tokens/Sek. auf einer A100-40G GPU (vLLM- und Transformers-kompatibel).
- Leichte Bereitstellung: Minimale Abhängigkeiten für sichere, skalierbare Integration.
Beispiel-Anwendungsfälle:
- Automatisierte Dokumentenverarbeitung in Finanz- oder Rechts-Workflows
- Erstellung visueller Frage-Antwort-Systeme
- Verbesserung von Barrierefreiheits-Tools mit detaillierten Bildbeschreibungen
- API-gesteuerte Stapel-OCR-Pipelines für die digitale Archivierung
Unter der Haube: DeepSeek-OCR-Architektur
Die Architektur von DeepSeek-OCR ist auf effiziente, genaue und kontextbezogene OCR ausgelegt.
- Bildvorverarbeitung: Passt die Größe von Eingabebildern an und normalisiert sie.
- Vision Transformer Backbone: Teilt Bilder in Patches auf, die jeweils in Embeddings kodiert werden.
- Komprimierte Tokenisierung: Multi-Head-Attention- und Feed-Forward-Netzwerke synthetisieren visuellen Kontext zu prägnanten Tokens.
- LLM-Integration: Fügt Vision-Tokens vor Text-Prompts ein, um Kontextlänge und Speicherverbrauch zu minimieren.
- Räumliche Verankerung (Spatial Grounding): Spezielle Tokens aktivieren Module, die Abfragen bestimmten Koordinaten oder Regionen im Bild zuordnen.
- Optimiertes Training: Feinabgestimmt auf gepaarte Bild-Text-Datensätze, um Kompression und Genauigkeit auszubalancieren.
Dynamischer Modus: Fügt Embeddings aus mehreren Durchgängen dynamisch zusammen und gewährleistet Konsistenz bei der Verarbeitung von Dokumenten unterschiedlicher Größe.
Installationsanleitung: Erste Schritte mit DeepSeek-OCR
Richten Sie DeepSeek-OCR in einer modernen Python-Umgebung mit CUDA-Unterstützung ein. So geht's:
- vLLM installieren:
- Laden Sie das vLLM-0.8.5 Wheel von der offiziellen Version herunter.
Anforderungen installieren:
pip install -r requirements.txt
pip install flash-attn==2.7.3 --no-build-isolation
Installieren Sie:
pip install vllm-0.8.5+cu118-cp38-abi3-manylinux1_x86_64.whl
PyTorch & Abhängigkeiten installieren:
pip install torch==2.6.0 torchvision==0.21.0 torchaudio==2.6.0 --index-url https://download.pytorch.org/whl/cu118
Conda-Umgebung erstellen und aktivieren:
conda create -n deepseek-ocr python=3.12.9 -y
conda activate deepseek-ocr
Repository klonen:
git clone https://github.com/deepseek-ai/DeepSeek-OCR.git
cd DeepSeek-OCR
Hinweis: Ignorieren Sie alle Fehler im Zusammenhang mit vLLM und Transformers, wie in der Dokumentation angegeben.
Leistung & Benchmarking
DeepSeek-OCR ist für hohen Durchsatz und Genauigkeit konzipiert:
- Geschwindigkeit: Bis zu 2500 Tokens/Sek. (A100-40G GPU)
- Benchmarks:
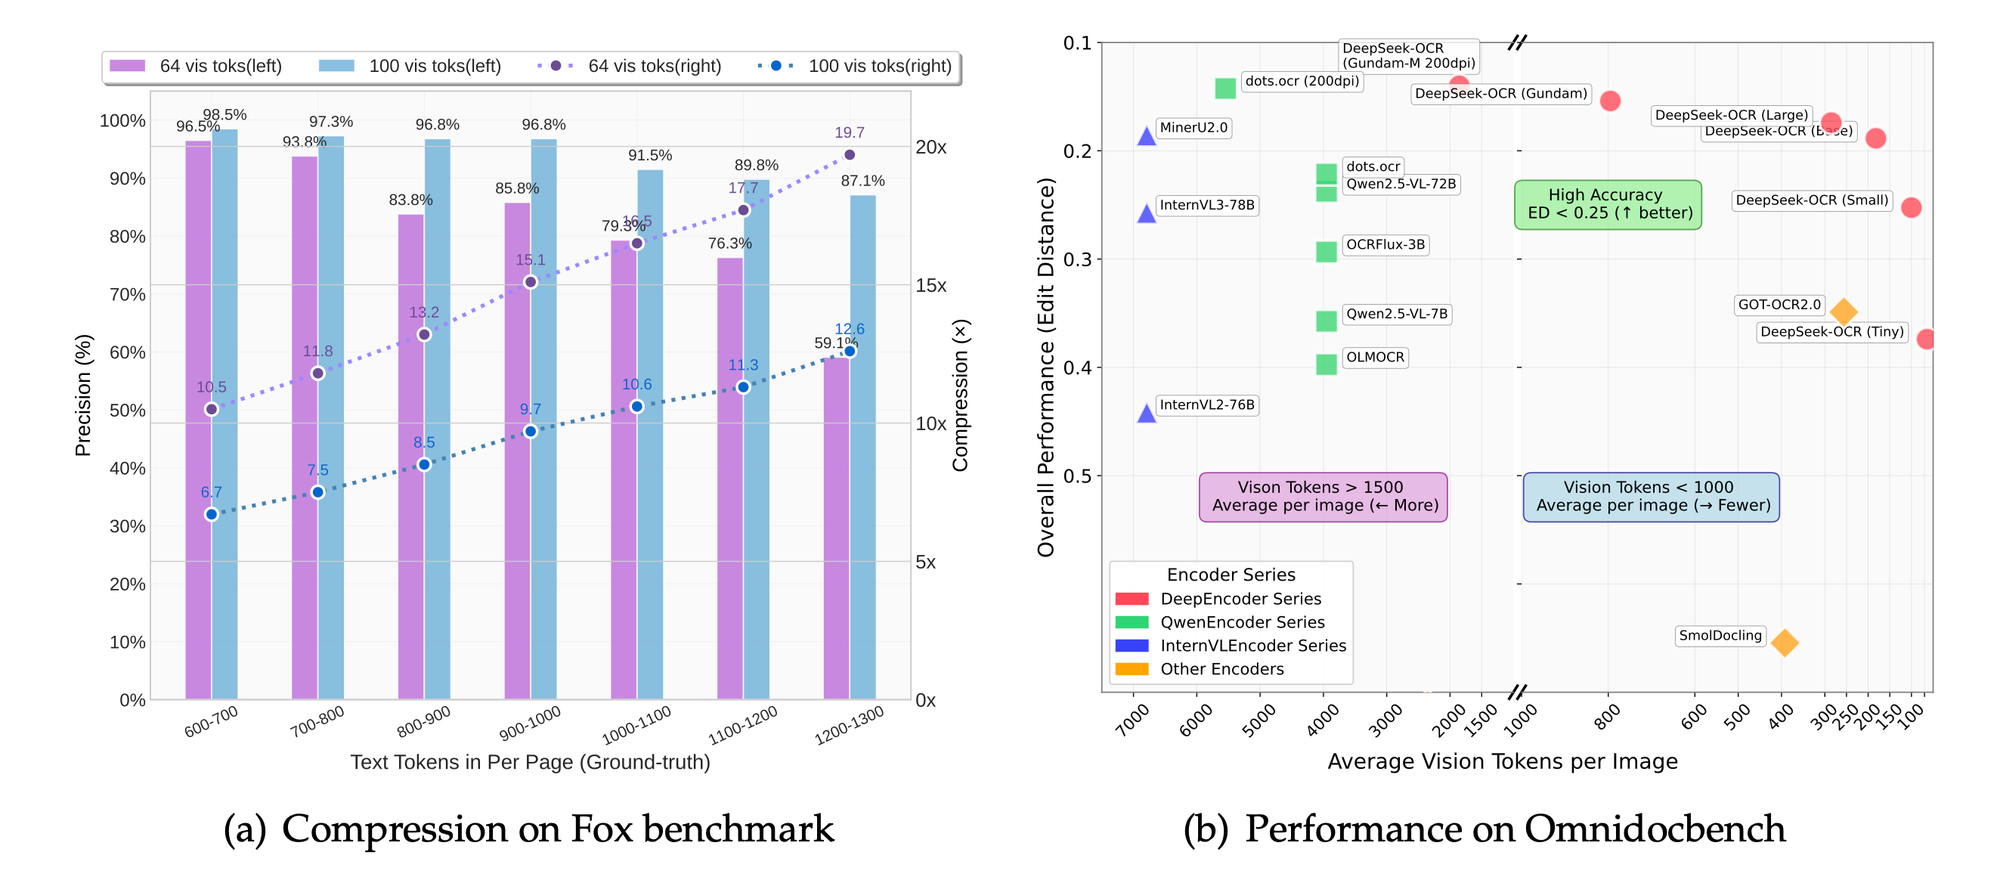
- Fox, OmniDocBench: Übertrifft bei OCR-Genauigkeit, Layout-Erfassung und Figurenanalyse.
- Kompression: Reduziert Tokens um 50%, während eine Extraktionsgenauigkeit von über 95% beibehalten wird.
- Auflösungsskalierung: Höhere Modi bieten feinere Details auf Kosten von mehr Tokens; der "Base"-Modus bietet ein starkes Gleichgewicht für die meisten Produktionsszenarien.
DeepSeek-OCR im Vergleich mit anderen OCR-Lösungen
| Funktion | DeepSeek-OCR | PaddleOCR | GOT-OCR2.0 | MinerU | Tesseract |
|---|---|---|---|---|---|
| LLM-Integration | Ja | Nein | Teilweise | Nein | Nein |
| Kontextbezogene Ausgabe | Ja | Nein | Teilweise | Nein | Nein |
| Dynamische Auflösung | Ja | Nein | Nein | Nein | Nein |
| Grounding-Unterstützung | Ja | Nein | Nein | Nein | Nein |
| Token-Kompression | Hoch | Mittel | Mittel | Niedrig | Niedrig |
| Markdown-Ausgabe | Ja | Nein | Nein | Nein | Nein |
DeepSeek-OCR zeichnet sich durch LLM-Kompatibilität, erweiterte Kontexterhaltung und effiziente visuelle Token-Kompression aus – ideal für moderne KI- und API-basierte Anwendungen.
Warum Apidog für die DeepSeek-OCR API-Integration wichtig ist
Beim Einsatz von DeepSeek-OCR in realen Projekten sind die Verwaltung von API-Endpunkten, das Testen von OCR-Antworten und die Überwachung der Leistung entscheidende Herausforderungen. Apidog bietet eine einheitliche Plattform für:
- Schnelles API-Testen: Validieren Sie OCR-Endpunkte, Payloads und Antworten in Echtzeit.
- Mocking und Automatisierung: Simulieren Sie OCR-APIs für Integration und Qualitätssicherung ohne Produktionsabhängigkeiten.
- Leistungsüberwachung: Verfolgen Sie Antwortzeiten und Fehler, um Workflows zu optimieren.
- Nahtlose Zusammenarbeit: Teilen Sie API-Sammlungen mit Ihrem Team für schnelleres Debugging und Iterationen.
Laden Sie Apidog herunter, um Ihre DeepSeek-OCR API-Entwicklung zu beschleunigen und robuste Produktionsbereitstellungen sicherzustellen.
Fazit
DeepSeek-OCR definiert neu, wie Entwickler und Teams visuelle Daten verarbeiten, indem es die Lücke zwischen Bildern und LLM-gestützten Text-Workflows schließt. Seine Architektur, Funktionen und Geschwindigkeit machen es zur ersten Wahl für fortschrittliche OCR und kontextreiche Dokumentenverarbeitung. In Kombination mit Tools wie Apidog ist die Integration von DeepSeek-OCR in Ihren API-Stack schneller, zuverlässiger und bereit für die Anforderungen moderner KI-Anwendungen.