Claude Sonnet 5.5 (claude-sonnet-5-5, veröffentlicht am 28. September 2026) kostet dasselbe wie Sonnet 5, 2 $ pro Million Input-Tokens und 10 $ pro Million Output, und verwendet denselben Tokenizer. Es ist weitaus leistungsfähiger, und Anthropic gibt an, dass es über 30 % schneller ist. Auf der Starttabelle steigt Terminal-Bench 4.0 von 10,3 % auf 70,6 %, CursorBench 4.0 von 34,1 % auf 55,5 % und OSWorld 2.1 von 57,0 % auf 80,1 %. Der Haken ist die API. Fünf Anfrage-Formate, die mit Sonnet 5 funktionierten, geben jetzt einen 400er-Fehler zurück, und eine Änderung passt das Antwortformat ohne Fehler an. Fazit: Upgrade durchführen, aber zuerst diese sechs Dinge beheben.
Unten: jede breaking change mit dem genauen Fehler und Vorher/Nachher-JSON, dann eine Checkliste. Spezifikationen finden Sie unter was ist Claude Sonnet 5.5; für den vorherigen Sprung, Claude Sonnet 5 vs Sonnet 4.6. Apidog hält alte und neue Anfragen während des Tests nebeneinander.
Sonnet 5 vs. Sonnet 5.5 auf einen Blick
| Claude Sonnet 5 | Claude Sonnet 5.5 | |
|---|---|---|
| Preis pro MTok (Input / Output / Cache-Lesen) | $2 / $10 / $0.20 | $2 / $10 / $0.20 |
| Kontext und Output | 1M Kontext | 1M Kontext, 128K Output |
Akzeptierter thinking.type |
adaptive, disabled |
adaptive, between_tools |
Standard display |
omitted |
omitted |
| Aufwand | low bis max |
Gleiche Stufen, neu kalibriert; API-Standard high |
| Minimaler cachefähiger Prompt | 1.024 Tokens | 512 Tokens |
| Aufwand pro Nachricht, Systemnachrichten während des Gesprächs | Nein | Ja |
Erzwungene tool_choice |
Unterstützt | 400er Fehler |
| Cyber-Schutzmaßnahmen im Opus-Stil | Nein | Ja; Cyber mit hohem Risiko fällt auf Sonnet 5 zurück |
| Denkblöcke | Keine Gesprächsprüfung | An Modell, Gespräch und Konto gebunden |
| Terminal-Bench 4.0 | 10.3% | 70.6% |
| CursorBench 4.0 | 34.1% | 55.5% |
| FrontierCode 1.1 (Main) | 42.4% | 46.2% (max), 52.1% (xhigh) |
| GDPval-AA v2.1 (Elo) | 1449 | 1844 |
| OSWorld 2.1 (partial) | 57.0% | 80.1% |
| HLE (mit Tools) | 54.9% | 64.5% |
| Einstellung | Wird weiterhin als Cyber-Fallback verwendet | Nicht vor dem 28. September 2027 |
Anthropic führte Terminal-Bench, HLE und OSWorld durch; Cursor führte CursorBench, Cognition FrontierCode und Artificial Analysis GDPval-AA durch. Die eigene Terminal-Bench-Ausführung von Artificial Analysis ergibt 63,6 % vs. 14,1 %, der Unterschied bleibt also bestehen. FrontierCode hat zwei 5.5-Werte, da es bei max häufiger Überprüfungs-Subagenten einsetzte und der Benchmark Bearbeitungen außerhalb des Geltungsbereichs bestraft. Siehe Claude Sonnet 5.5 Benchmarks.
Die fünf Breaking Changes
Jede gibt einen 400 invalid_request_error für Code zurück, der auf Sonnet 5 einwandfrei läuft.
1. thinking: disabled ist nicht mehr vorhanden; between_tools senden
Sonnet 5.5 lehnt thinking: {"type": "disabled"} ab:
"thinking.type.disabled" wird für dieses Modell nicht unterstützt. Verwenden Sie "thinking.type.between_tools" für die niedrigste Denkeinstellung, oder "thinking.type.adaptive" und "output_config.effort", um das Denkverhalten zu steuern.
Senden Sie between_tools, die niedrigste Einstellung. Es überspringt das initiale Denken; Fortschrittsnotizen zwischen Tool-Aufrufen kommen weiterhin als thinking-Blöcke an, die Sie unverändert zurückgeben. Es funktioniert nur bei low, medium oder high Aufwand, akzeptiert keine anderen Felder (display, budget_tokens oder block_binding geben einen 400er-Fehler zurück) und sperrt den Aufwand für das Gespräch.
// Vorher (claude-sonnet-5)
{"model": "claude-sonnet-5", "max_tokens": 16000,
 "thinking": {"type": "disabled"},
 "output_config": {"effort": "xhigh"}}

// Nachher (claude-sonnet-5-5)
{"model": "claude-sonnet-5-5", "max_tokens": 16000,
 "thinking": {"type": "between_tools"},
 "output_config": {"effort": "high"}}
Wenn Sie xhigh oder max benötigen, lassen Sie thinking weg, damit adaptives Denken ausgeführt wird.
2. Erzwingen von tool_choice gibt einen 400er-Fehler zurück
Eine tool_choice von any oder tool schlägt fehl, auch am Token-Zähl-Endpunkt:
tool_choice: Typ "tool" und "any" werden für dieses Modell nicht unterstützt.
Senden Sie auto, markieren Sie das Tool mit strict: true (jedes Objekt benötigt additionalProperties: false) und geben Sie im Prompt an, wann es verwendet werden soll. Das Modell kann nun stattdessen in Text antworten, behandeln Sie also Runden ohne Tool-Aufruf.
// Vorher (claude-sonnet-5)
"tool_choice": {"type": "tool", "name": "get_weather"}

// Nachher (claude-sonnet-5-5)
"tools": [{"name": "get_weather",
  "input_schema": {"type": "object",
    "properties": {"location": {"type": "string"}},
    "required": ["location"], "additionalProperties": false},
  "strict": true}],
"tool_choice": {"type": "auto"},
"messages": [{"role": "user",
  "content": "Wie ist das Wetter in Paris? Verwenden Sie das get_weather Tool."}]
Die Obergrenze liegt bei 20 strikten Tools pro Anfrage. Auf Amazon Bedrock sind strikte Tools für Sonnet 5.5 nicht verfügbar: Senden Sie auto ohne strict und validieren Sie den Input in Ihrem Code.
3. Denkblöcke sind an das Modell, das Gespräch und das Konto gebunden
Jeder Sonnet 5.5 Denkblock ist über alles, was davor liegt, signiert: system, tools und frühere Nachrichten. Für Konten, die am oder nach dem 31. August 2026 (00:00 UTC) erstellt wurden, gibt das Wiedergeben eines Blocks nach einer Bearbeitung einen 400er-Fehler in der Claude API, Bedrock und Google Cloud zurück:
messages.1.content.0: Ungültige `signature` im `thinking`-Block. Der Block ist an ein anderes Gespräch gebunden. Entfernen Sie den Block oder setzen Sie `thinking.block_binding.prefix_mismatch_behavior` auf "drop_block".
Ältere Konten erzwingen dies standardmäßig nicht, daher beweist ein sauberer Durchlauf mit einem alten Schlüssel nichts. Halten Sie Gespräche append-only und ändern Sie Anweisungen oder Tools mit Systemnachrichten während des Gesprächs. Wenn Sie bearbeiten müssen, senden Sie anthropic-beta: thinking-binding-controls-2026-08-01 und lassen Sie nicht übereinstimmende Blöcke fallen:
"thinking": {"type": "adaptive",
  "block_binding": {"prefix_mismatch_behavior": "drop_block"}}
Das funktioniert nur mit adaptivem Denken; mit between_tools entfernen Sie Denkblöcke ab der bearbeiteten Runde. Sonnet 5.5 liest Blöcke von Sonnet 5, Opus 4.8, Haiku 4.5 und früheren Versionen; es verwirft Opus 5, Opus 5.5, Fable und Mythos Blöcke sowie Sonnet 5.5 Blöcke von einem anderen Konto, ohne die Anfrage fehlschlagen zu lassen. Kein anderes Modell liest seine Blöcke. Siehe Claude Fable 5.1 preserved thinking.
4. computer_20251124 schlägt bei der Claude API und Google Cloud fehl
Dort erfordert die Computernutzung das neue Toolset. Der Fehler beginnt:
'claude-sonnet-5-5' unterstützt keine Tool-Typen: computer_20251124.
// Vorher (claude-sonnet-5)
"tools": [{"type": "computer_20251124", ...}]

// Nachher (claude-sonnet-5-5, Claude API und Google Cloud)
"tools": [{"type": "computer_toolset_20260801"}]
Entfernen Sie den alten Beta-Header für die Computernutzung und aktualisieren Sie Ihre Schleife für tool_use-Blöcke, gebündelte Aktionen und toolset_name bei den Ergebnissen. Bedrock akzeptiert weiterhin computer_20251124; computer_20250124 schlägt überall fehl.
5. Einige Advisor-Paarungen werden abgelehnt
Mit dem Advisor-Tool (Beta) akzeptiert ein Sonnet 5.5 Executor nur Opus 5, Opus 5.5, Sonnet 5.5, Fable 5, Fable 5.1, Mythos 5 oder Mythos 5.1 als Advisor. Sonnet 5, Opus 4.8 und Opus 4.7 Advisors geben nun einen 400er-Fehler zurück. Ratschläge kommen auch verschlüsselt als advisor_redacted_result-Block an, sodass Code, der Rattext parst, nichts erhält.
Die stille Änderung: Text zwischen Tool-Aufrufen wandert in Denkblöcke
Diese Änderung führt zu keinem Fehler. Auf Sonnet 5 kamen Notizen zwischen Tool-Aufrufen als text zurück. Auf Sonnet 5.5 kommt alles, was länger als ein oder zwei Sätze ist, als thinking-Block für Fortschrittsaktualisierungen an, der unter dem Standard display: "omitted" leer ist. Eine Agent-Benutzeroberfläche, die diese Notizen streamt, wird still, ohne Fehler. Drei Lösungen:
display: "updates"(adaptives Denken, Beta-Headerthinking-display-updates-2026-08-18) gibt die Updates allein zurück. Ohne den Header wird es abgelehnt.display: "summarized"mischt die Updates mit Zusammenfassungen der Argumentation.between_toolsgibt den Text ohne erforderlichesdisplayzurück.
// Header: anthropic-beta: thinking-display-updates-2026-08-18
"thinking": {"type": "adaptive", "display": "updates"}
Verhaltensänderungen ohne Codeänderung
Diese führen nicht zu fehlerhaften Anfragen, aber sie ändern Ausgabe und Kosten. Der Prompting Guide enthält Korrekturen.
- Der Aufwand wird neu kalibriert. Gleiche Namen, unterschiedlicher Denkaufwand. Führen Sie Ihren Durchlauf erneut aus: beginnen Sie bei
high,mediumfür gut spezifizierte agentische Codierung,mediumoderlowfür Chat; speichern Siexhighundmaxfür messbare Gewinne. - Das Ändern des übergeordneten
effortzwischen Anfragen invalidiert den Prompt-Cache. Verwenden Sie stattdessen den Beta-Aufwand pro Nachricht. - Es denkt vor fast jeder Antwort ab
mediumaufwärts. Reduzieren Sie den Aufwand; es dazu aufzufordern, weniger zu denken, ist nicht zuverlässig. - Es meldet sich frühzeitig bei
lowundmediumbei langen agentischen Aufgaben. - Es fügt unaufgeforderte Tests, Dokumente und Dateien hinzu, sowie Überprüfungs-Subagenten bei
xhighundmax. Der von Anthropic vorgeschlagene Prompt reduzierte die Sitzungskosten beimaxum etwa ein Drittel. - Mehr Ablehnungen. Es ist das erste Sonnet mit Cyber-Schutzmaßnahmen im Opus-Stil. Eine Ablehnung ist HTTP 200 mit
stop_reason: "refusal"und einerstop_details-Kategorie; der Beta-Server-seitige Fallback auf der Claude API (fallbacks: "default") versuchtcyber- undfrontier_llm-Ablehnungen auf Sonnet 5 erneut. - Sampling-Parameter. Nicht-Standard
temperature,top_podertop_kgeben einen 400er-Fehler zurück. Anthropic listet dies unter den Änderungen von Sonnet 4.6 und früher auf, daher haben Sie diese wahrscheinlich bereits entfernt.
Kosten pro Aufgabe: gleicher Preis, weniger Dollar pro Ergebnis
Anthropic’s Launch-Post besagt, dass Sonnet 5.5 in seinen Tests „bis zu 30 % weniger pro Aufgabe kostet als sein Vorgänger“. Die Preise sind identisch, daher resultiert die Einsparung aus weniger Tokens und Schritten. Seine Pro-Aufwands-Diagramme zeigen, dass ein geringerer Aufwand bei 5.5 den besten Lauf von Sonnet 5 übertrifft:
| Benchmark (Anthropic-Diagramme) | Sonnet 5.5 | Sonnet 5, bester Lauf |
|---|---|---|
| Terminal-Bench 4.0 | 28.8% bei medium, $0.83 | 10.3% bei max, $11.62 |
| FrontierCode 1.1 | 49.4% bei high, $0.42 | 42.7% bei xhigh, $10.07 |
| CursorBench 4.0 | 35.8% bei low, $0.50 | 34.1% bei max, $7.17 |
CursorBench-Kosten sind Anthropic’s Schätzungen zu Listenpreisen. Die Kehrseite ist max: Laut OfficeChai’s Bericht über Daten von Artificial Analysis verwendet Sonnet 5.5 bei max etwa 193.000 Output-Tokens pro Indexaufgabe, und die Kosten pro Aufgabe liegen etwa 50 % über denen von Sonnet 5. Die Einsparungen liegen bei high und darunter; siehe Claude Sonnet 5.5 Preisgestaltung.
Migrations-Checkliste
Tauschen Sie claude-sonnet-5 gegen claude-sonnet-5-5 aus und führen Sie dann die sechs Prüfungen aus Anthropic’s Migrationsleitfaden durch:
- Ersetzen Sie
disableddurchbetween_toolsbeihighAufwand oder darunter. - Ersetzen Sie erzwungenes
tool_choicedurchauto,strict: trueund eine Prompt-Zeile (auf Bedrock im Code validieren). - Halten Sie den Verlauf append-only; verwenden Sie Systemnachrichten während des Gesprächs für Änderungen.
- Verschieben Sie die Computernutzung auf
computer_toolset_20260801in der Claude API und Google Cloud. - Wählen Sie einen unterstützten Advisor und hören Sie auf, den Beratungstext zu parsen.
- Setzen Sie
thinking.display, wenn Ihre Benutzeroberfläche Text zwischen Tool-Aufrufen anzeigt.
Führen Sie dann Ihren Aufwands-Sweep erneut aus. Claude Code kann die Migration automatisieren:
/claude-api migriere dieses Projekt zu claude-sonnet-5-5
Das Opus-Äquivalent ist Claude Opus 5.5 vs. Opus 5 Migration.
Verwandeln Sie die Migration in einen Regressionstest in Apidog
In Apidog speichern Sie drei Anfragen an https://api.anthropic.com/v1/messages in einem Projekt, alle in derselben Umgebung:
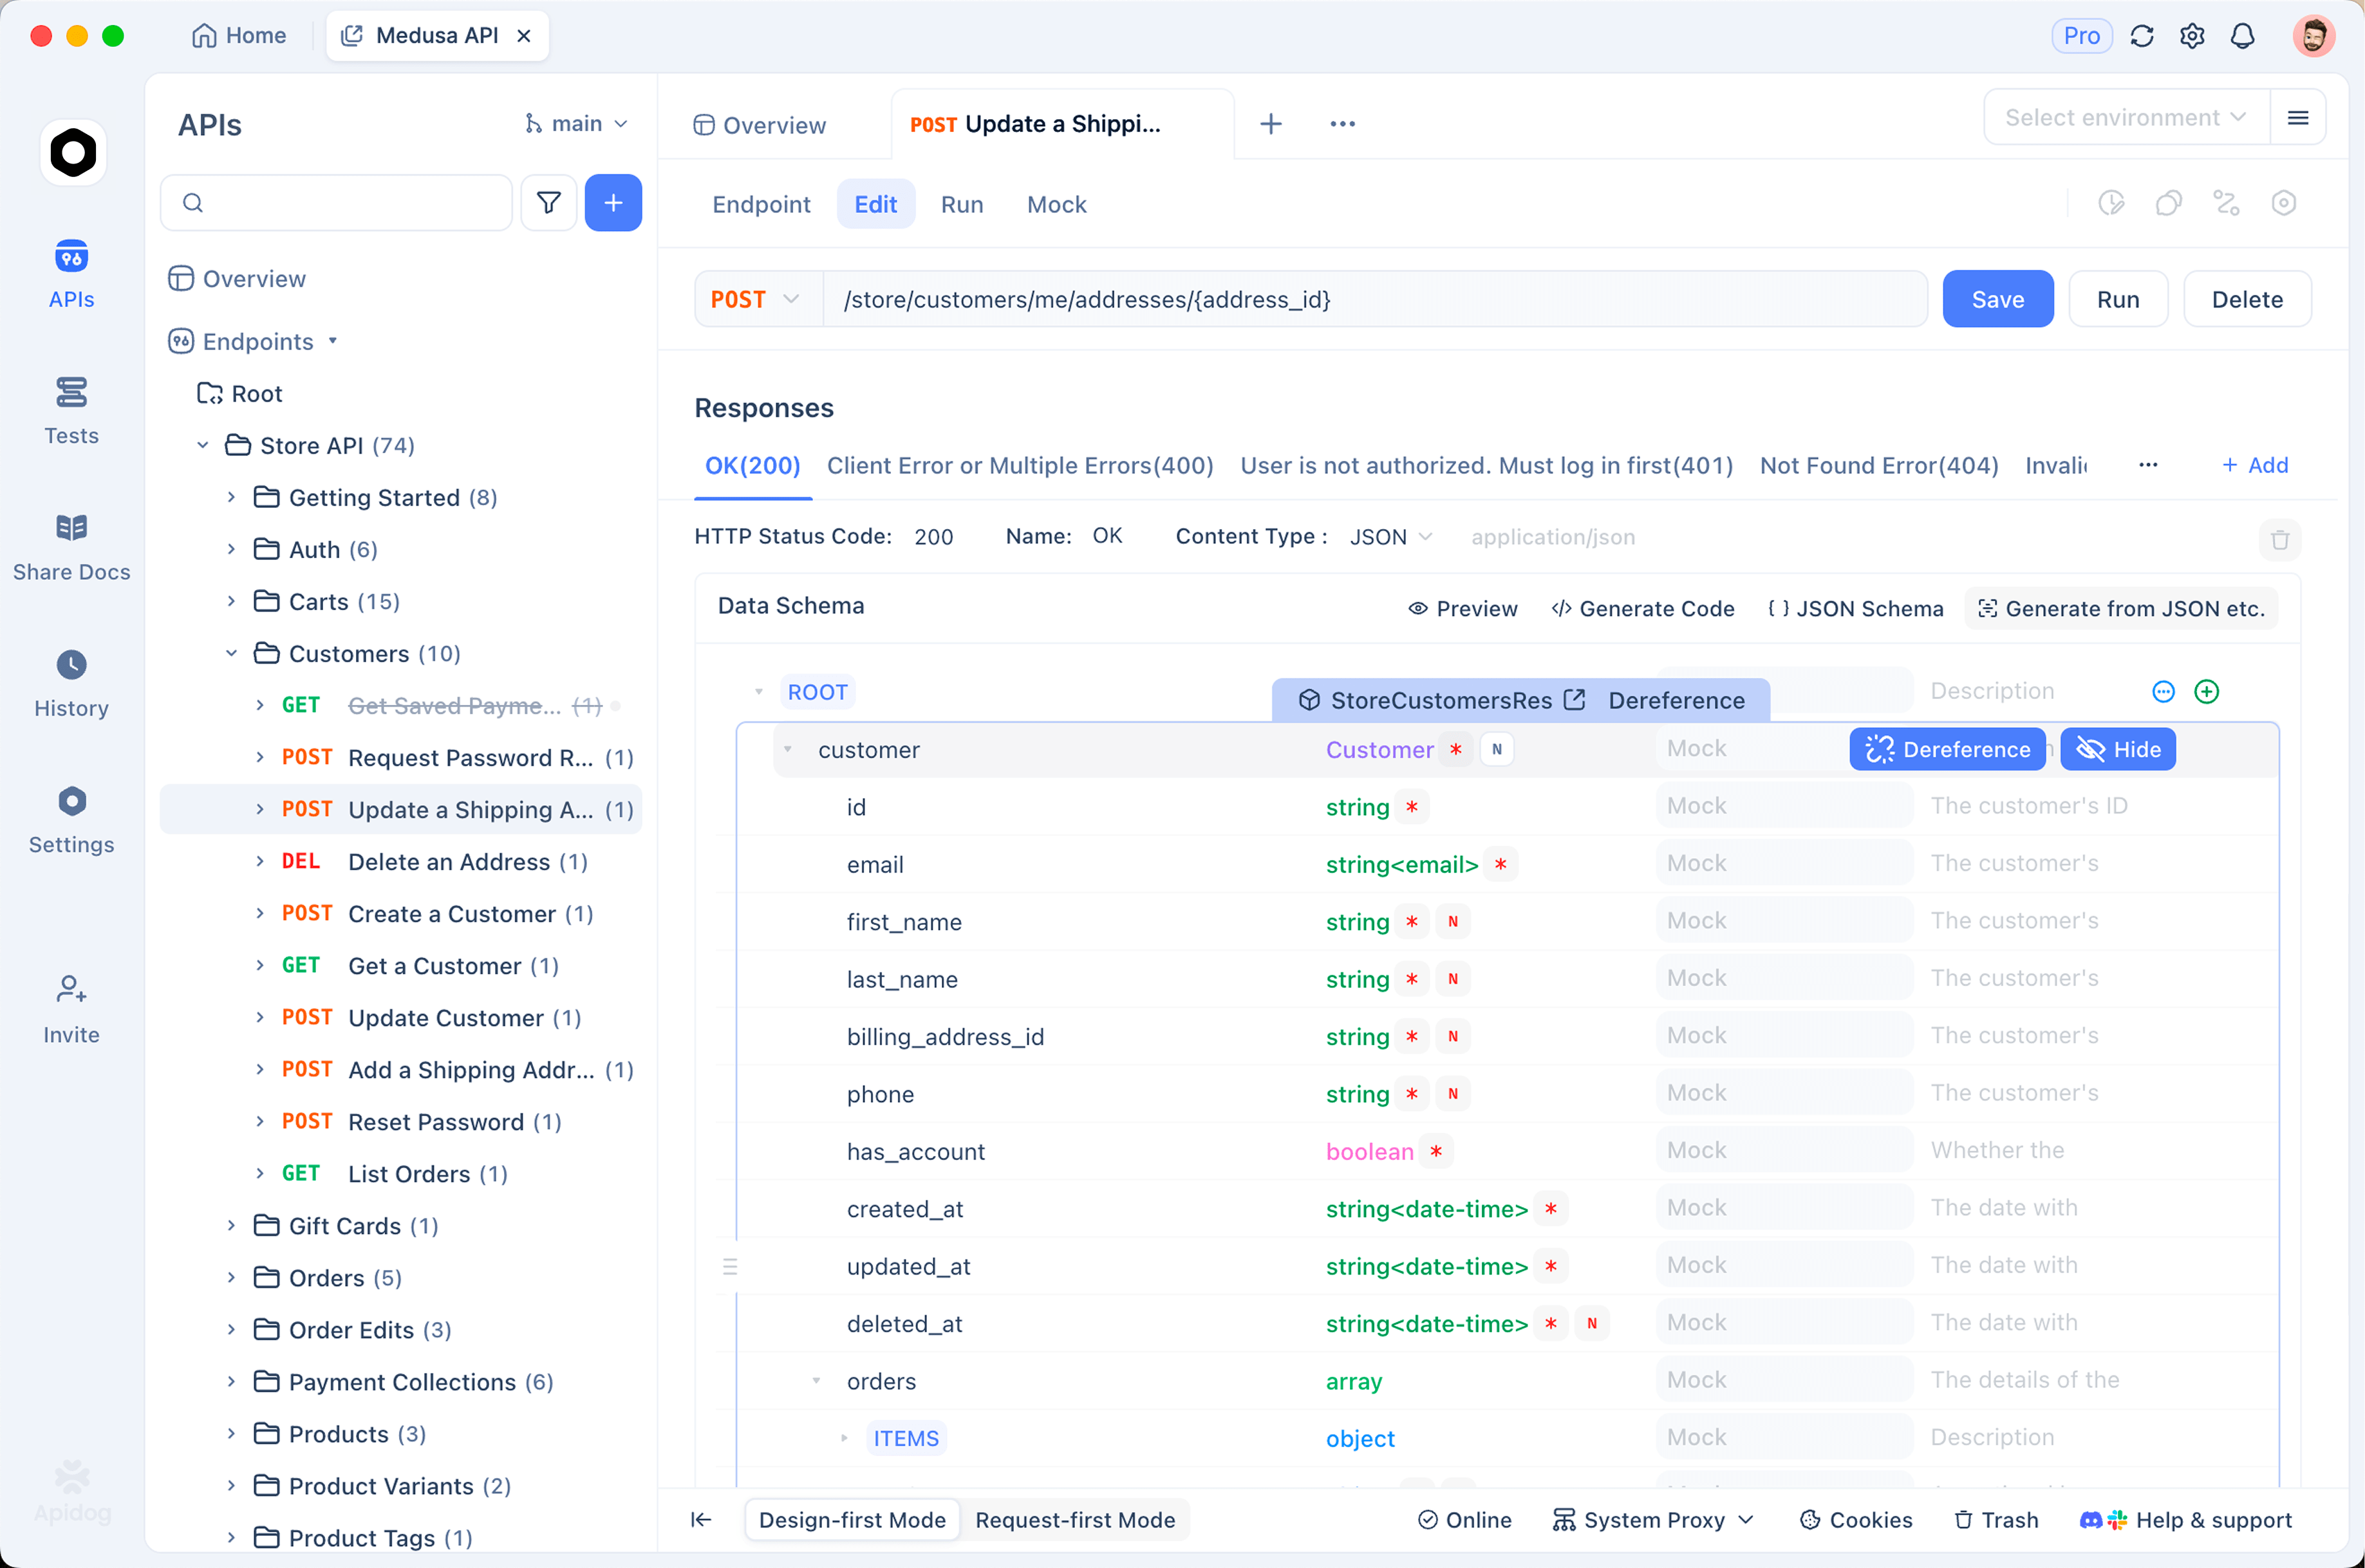
- Baseline: Ihr aktueller Sonnet 5 Body.
- Alter Body, neues Modell: nur
modelaufclaude-sonnet-5-5geändert. Bestätigen Sie den Status 400 und eine Fehlermeldung, diebetween_toolsodertool_choiceerwähnt. - Migriert: der korrigierte Body. Bestätigen Sie den Status 200, einen
stop_reason, der nichtrefusalodermax_tokensist, und einentool_use-Block für Tool-Anfragen.
Behalten Sie ANTHROPIC_API_KEY in der Umgebung und referenzieren Sie es als {{ANTHROPIC_API_KEY}} im x-api-key-Header. Vergleichen Sie usage.output_tokens über verschiedene Aufwandsebenen hinweg für Ihre eigene Kosten-pro-Aufgabe-Zahl. Als Testszenario gespeichert, führt eine Regression zu disabled zum Fehlschlagen des Laufs anstatt der Produktion. Anfrage-Grundlagen: wie man die Claude Sonnet 5.5 API verwendet.
FAQ
Ist Claude Sonnet 5.5 teurer als Sonnet 5? Nein. Beide kosten 2 $ / 10 $ pro Million Tokens mit 0,20 $ für Cache-Lesevorgänge, und der Tokenizer ist derselbe.
Warum erhalte ich „thinking.type.disabled is not supported“ auf Sonnet 5.5? disabled wurde entfernt. Senden Sie thinking: {"type": "between_tools"} mit low, medium oder high Aufwand, ohne andere thinking-Felder.
Werden Sonnet 5 Konversationen auf Sonnet 5.5 übertragen? Ja. Sonnet 5.5 liest Sonnet 5 Denkblöcke. Ein Zurückwechseln führt zum Verlust dieser Blöcke: kein anderes Modell liest Sonnet 5.5 Blöcke.
Sollte ich alles auf Sonnet 5.5 umstellen? Für die meisten Workloads ja. Beachten Sie Cyber-nahe Arbeiten, die möglicherweise auf Sonnet 5 zurückfallen, und Bedrock-Tool-Aufrufe, die den strikten Modus verlieren. Unser Claude Sonnet 5 Leitfaden behandelt das Modell, das Sie verlassen.
Ihr nächster Schritt
Speichern Sie Ihre Sonnet 5 Anfrage und ihr 5.5-Gegenstück nebeneinander, bestätigen Sie den 400er-Fehler, beheben Sie ihn und leiten Sie den Traffic um, sobald die Korrektur erfolgreich ist. Laden Sie Apidog herunter, um diesen Test zu erstellen.