
Für Claude Fable 5.2 vs. Opus 5.5 gilt: Beginnen Sie mit Opus 5.5 für alltägliche Coding- und Wissensarbeit. Testen Sie Fable 5.2, wenn schwierige Reasoning-Aufgaben, mehrdeutige Migrationen oder lange Agent-Projekte Ihre Opus-Basis übersteigen. Vergleichen Sie Effort-Einstellungen und Kosten pro akzeptiertem Ergebnis, bevor Sie Ihre gesamte Workload umstellen.
Diese Empfehlung folgt Anthropics Fable-5.2-Ankündigung, geprüft am 10. November 2026. Dies ist ein quellenbasierter Vergleich; wir haben keinen unabhängigen Direktvergleich (Benchmark) durchgeführt. Unser früherer Opus 5 vs. Fable 5 Vergleich behandelt die ältere Generation. Die folgenden Preise, Standardwerte und Belege beziehen sich auf diese neueren Versionen.
Claude Fable 5.2 vs. Opus 5.5 auf einen Blick
| Entscheidungspunkt | Claude Fable 5.2 | Claude Opus 5.5 |
|---|---|---|
| Standardrolle | Anspruchsvolles Reasoning und lange Agent-Arbeit | Standard für die meisten Workloads |
| Claude-API-Modell-ID | claude-fable-5-2 |
claude-opus-5-5 |
| Standardeingabe, pro Million Token | 8 $ | 4 $ |
| Standardausgabe, pro Million Token | 40 $ | 20 $ |
| API-Standard-Effort | High | Medium |
| Kontextfenster | 1 M Token | 1 M Token |
| Maximale Ausgabe | 128 K Token | 128 K Token |
| Vergleichende Latenzkennzeichnung | Moderat | Moderat |
Quelle: die aktuelle Claude-Modelle-Übersicht. Beide Modelle akzeptieren Text und Bilder, erzeugen Text, unterstützen Tools und verwenden durchgängig adaptives Thinking. Ein größeres Kontextfenster unterscheidet sie also nicht. Entscheidend ist ihre Fähigkeit, Ihre konkrete Aufgabe abzuschließen.
Fables Standard-Tokenpreise liegen doppelt so hoch wie die von Opus. Das macht Opus zum sinnvollen Startpunkt, wenn beide Modelle Ihre Akzeptanzkriterien bei ähnlichem Tokenvolumen erfüllen. Es legt jedoch nicht fest, welches Modell die niedrigere Rechnung verursacht, wenn Reasoning-Tiefe, Wiederholungsversuche und Tool-Aufrufe unterschiedlich ausfallen.
Welche Coding-Aufgaben rechtfertigen einen Wechsel zu Fable 5.2?
Verwenden Sie Opus für eingegrenzte Änderungen mit klaren Prüfungen. Testen Sie Fable, wenn der Agent das Problem erst entdecken, mehrere abhängige Änderungen koordinieren oder nach einem scheiternden Ansatz neu ansetzen muss. Dies sind Arbeitsempfehlungen, die aus Anthropics Positionierung und Ergebnissen abgeleitet sind – keine gemessenen Garantien für Ihr Repository.
| Ihre Aufgabe | Startwahl | Beleg, der einen Wechsel rechtfertigen würde |
|---|---|---|
| Einen dokumentierten Endpunkt hinzufügen | Opus 5.5 | Wiederholte Contract- oder Integrationsfehler |
| Tests nach einem kleinen Refactoring aktualisieren | Opus 5.5 | Der Agent kann die geänderte Invariante nicht identifizieren |
| Einen intermittierenden übergreifenden Servicefehler debuggen | Opus, dann Fable | Opus wiederholt Fixes, ohne konkurrierende Ursachen zu prüfen |
| Einen Service mit unklaren Abhängigkeiten migrieren | Beide vergleichen | Fable schließt mehr akzeptierte Änderungen innerhalb des Budgets ab |
| Ein langes technisches Projekt koordinieren | Fable testen | Eine bessere Planung übersteht Ausführung und Review |
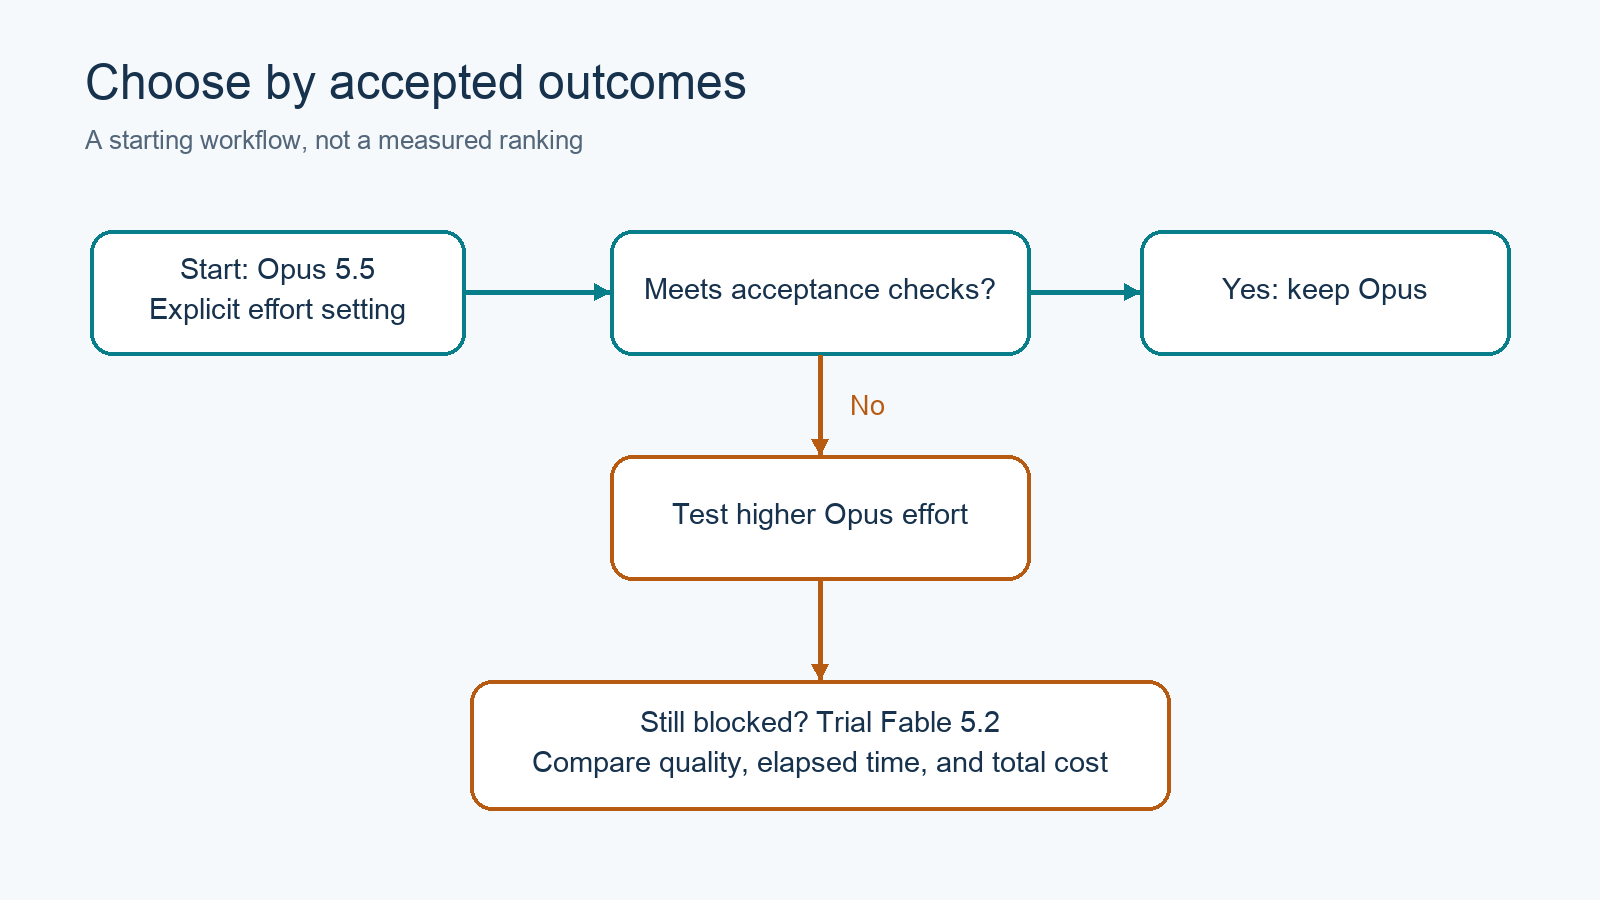
Selektive Eskalation: Routineaufgaben bleiben auf Ihrer Basis, schwierige Arbeit geht an das Modell, das Ihre Prüfungen besteht.
Betrachten Sie einen Payment-Webhook, der gelegentlich ein Ereignis doppelt verarbeitet. Wenn die benötigte Lösung bereits festgelegt ist, liegt bei Opus eine eingegrenzte Coding-Aufgabe vor. Wenn der Agent die Nebenläufigkeit über Retries, Storage und Downstream-Services erst rekonstruieren muss, ist die Untersuchung ein stärkerer Kandidat für einen Fable-Test.
Geben Sie beiden Modellen dieselben Incident-Daten und Randbedingungen. Ein teureres Modell kann fehlende Logs, nicht zugängliche Abhängigkeiten oder einen Akzeptanztest, der das falsche Verhalten belohnt, nicht kompensieren.
Was zeigen Anthropics Benchmarks?
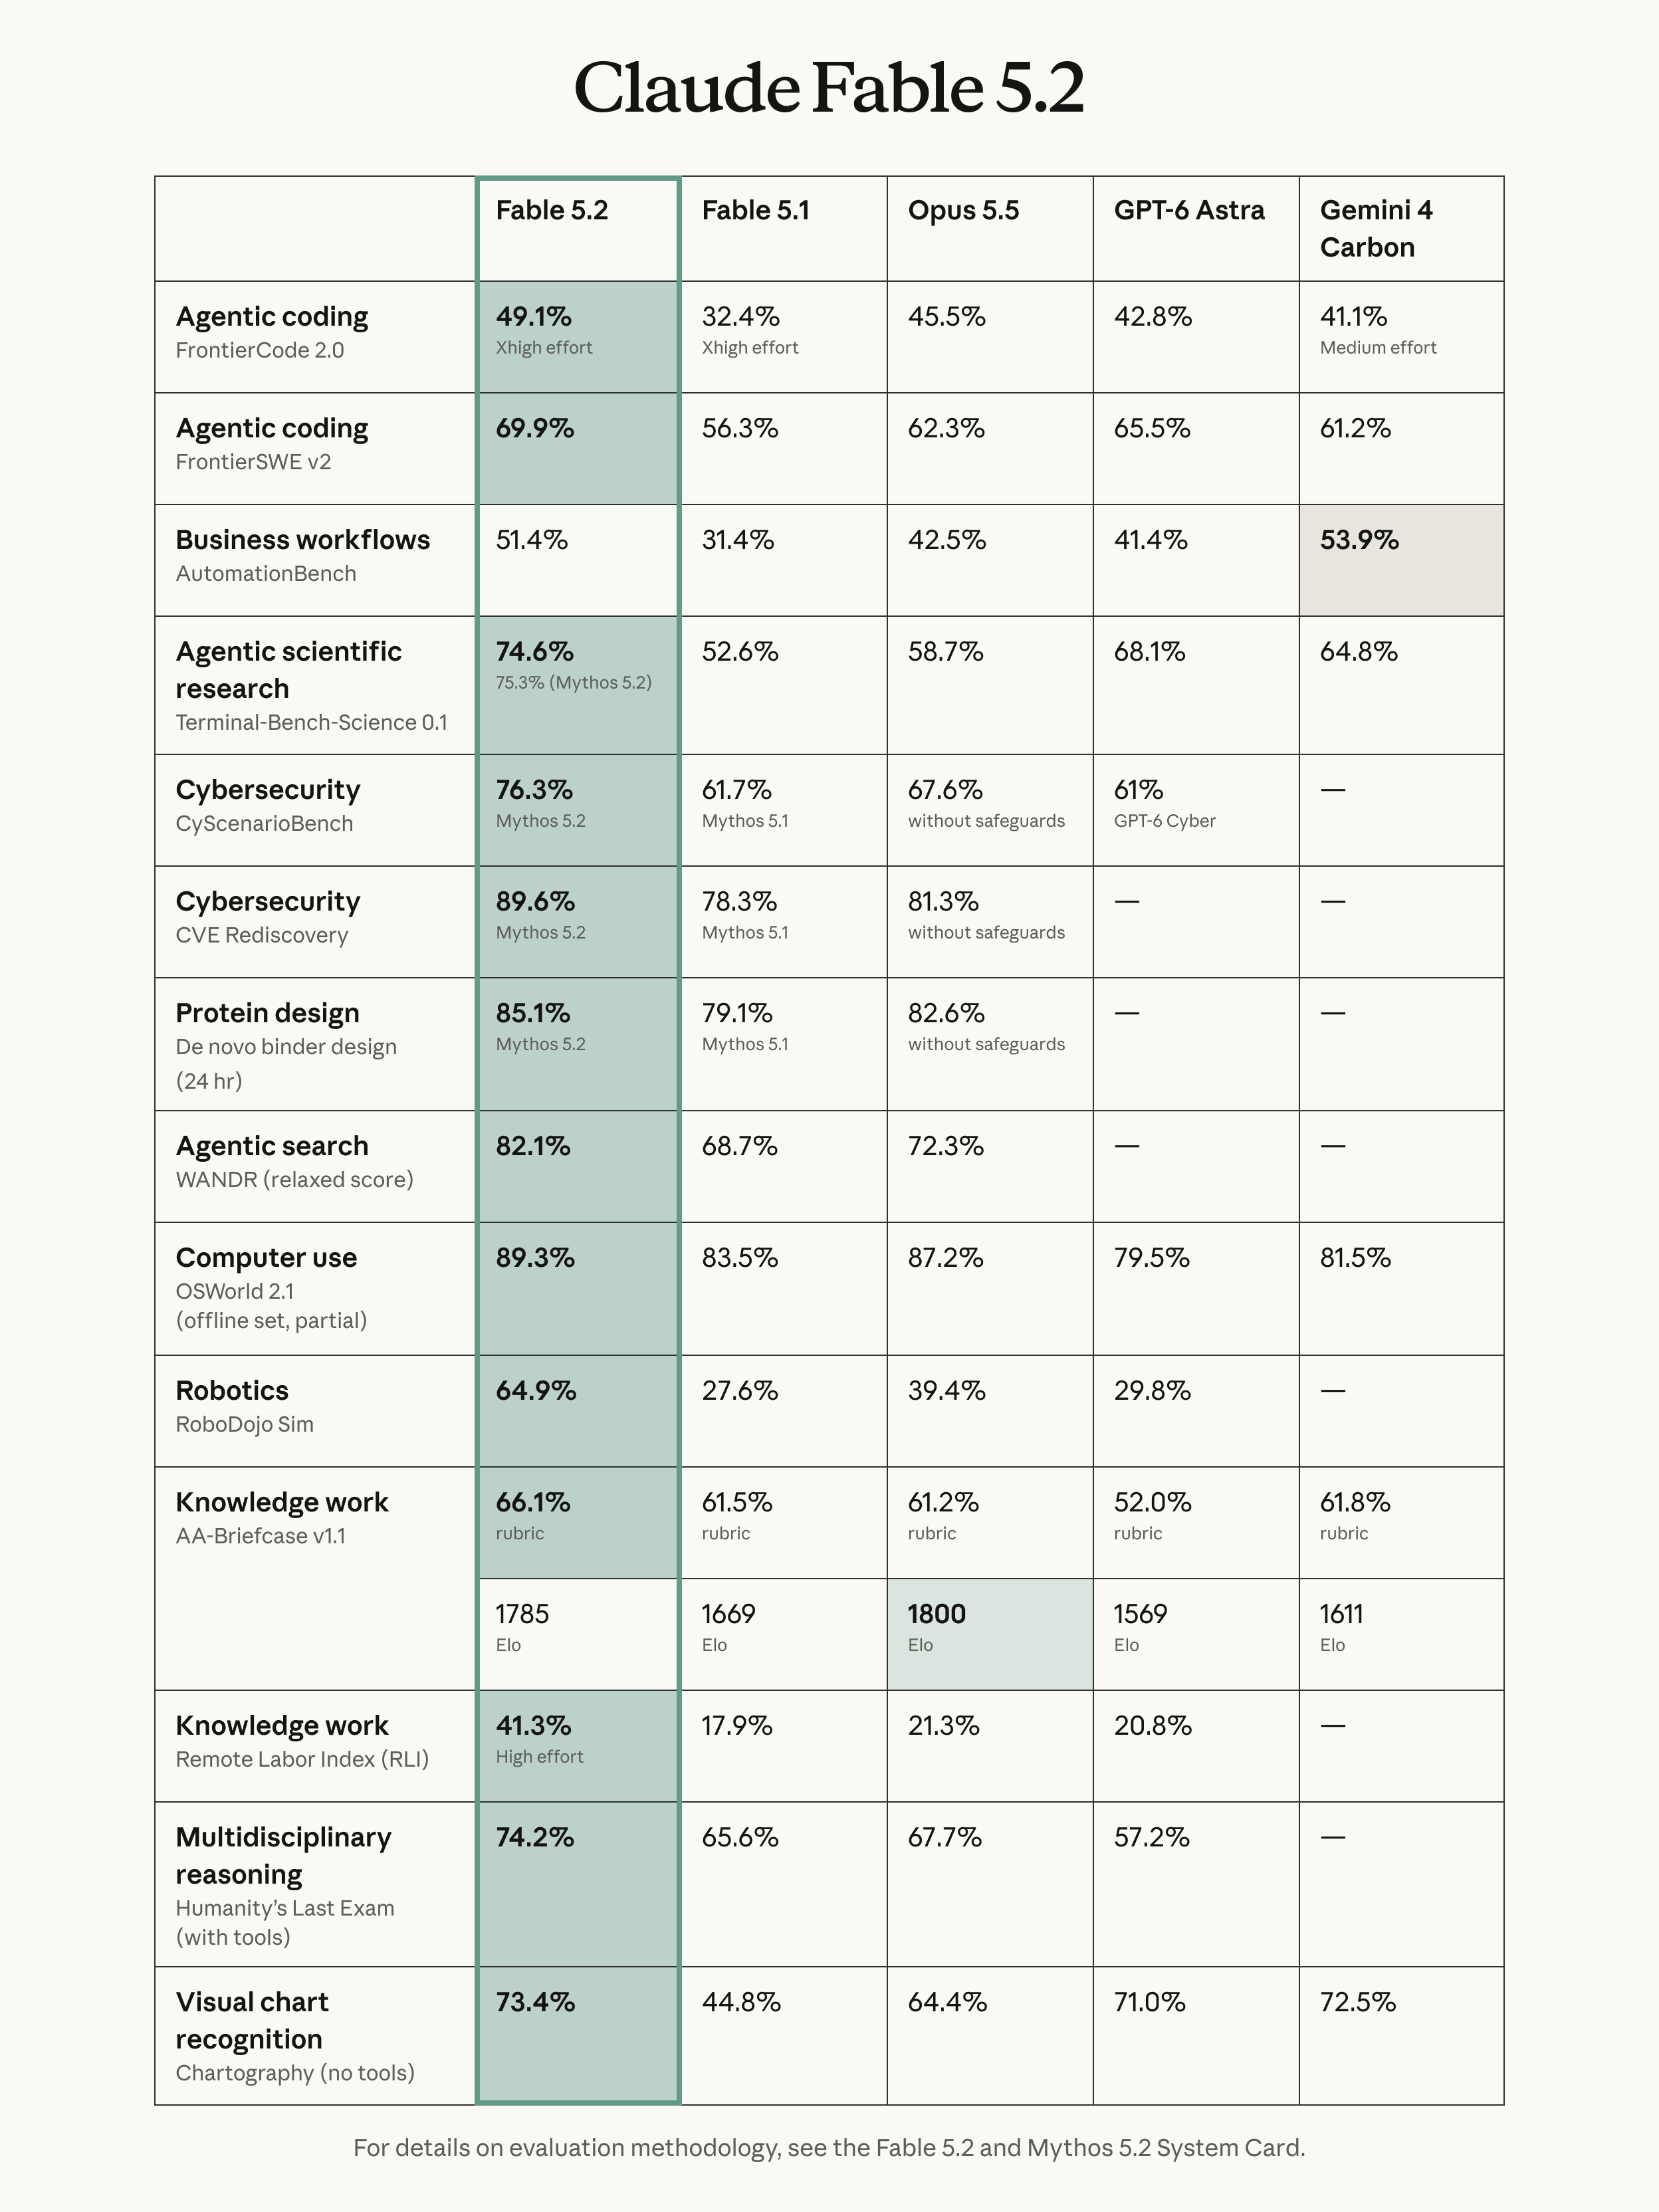
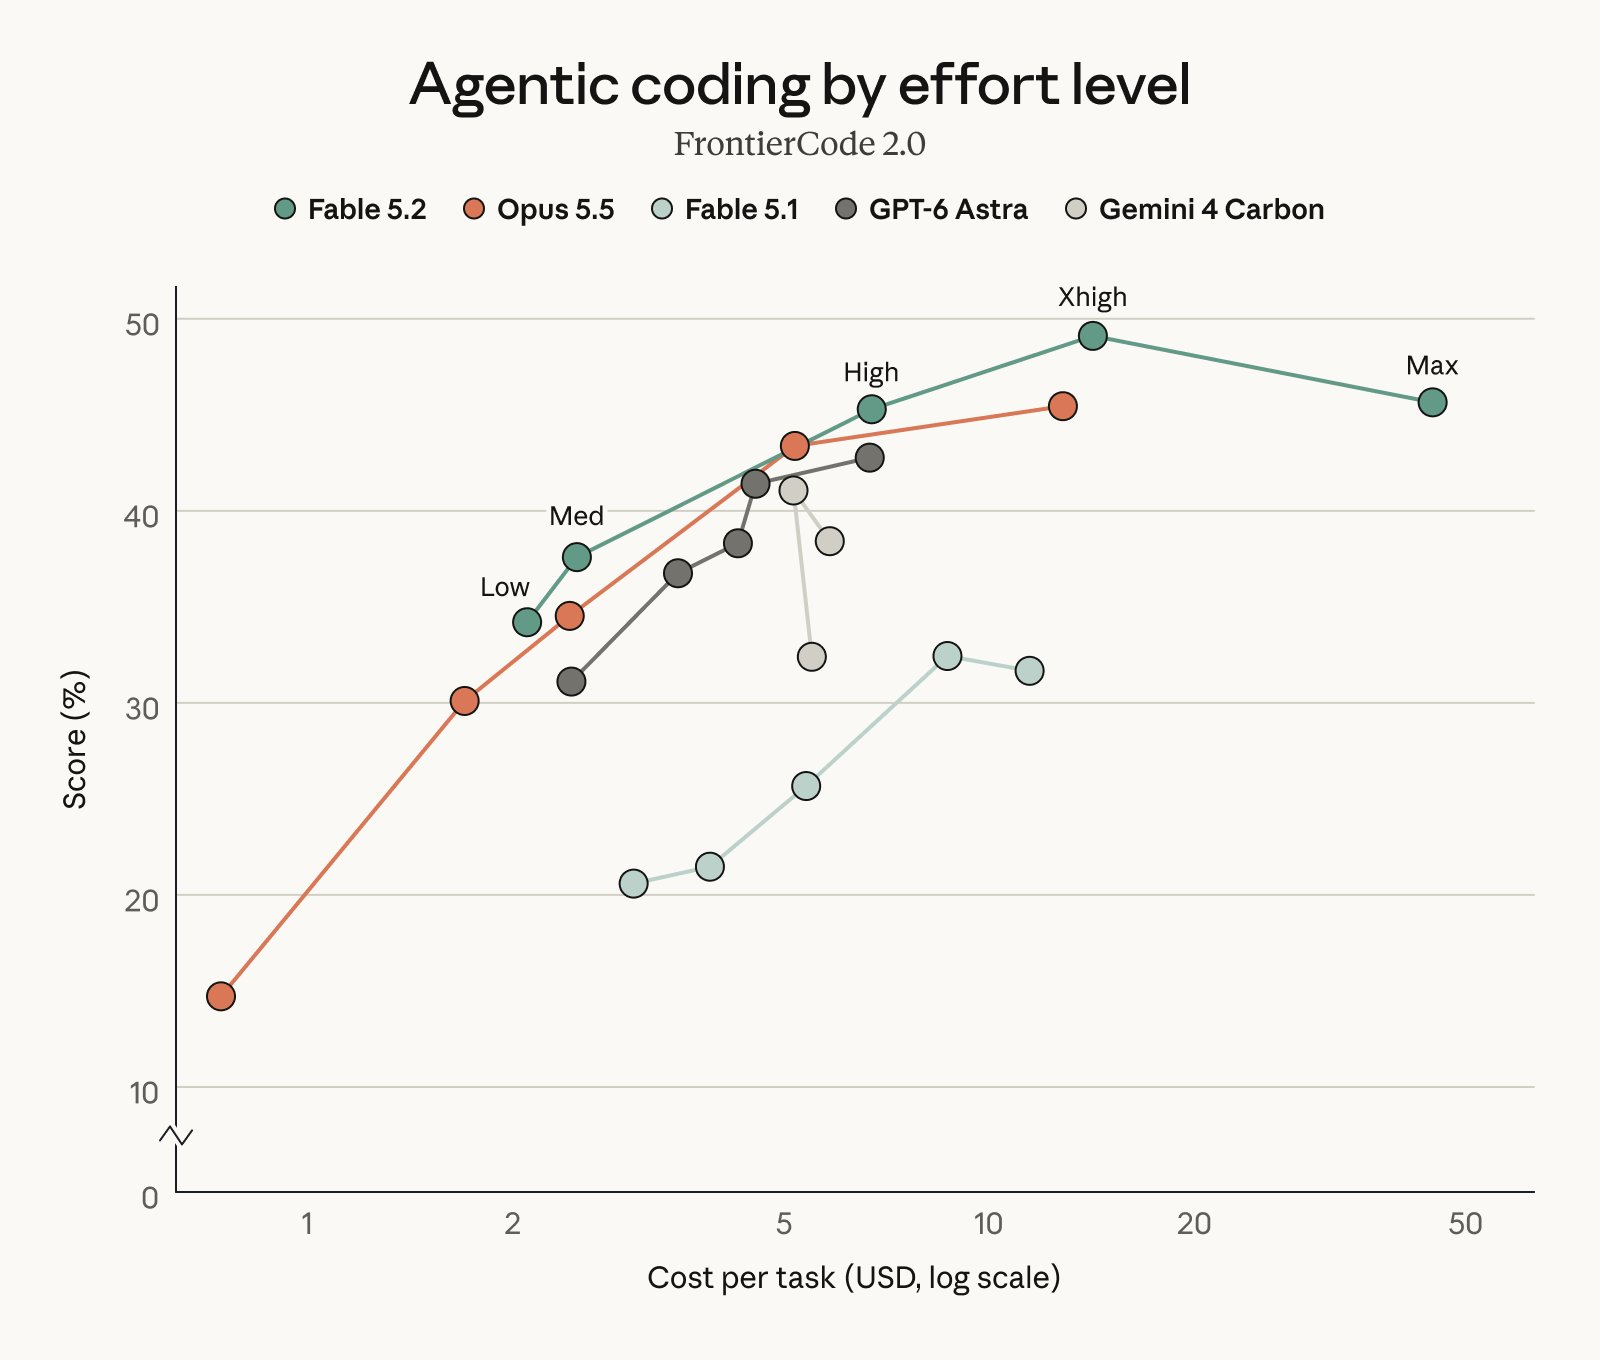
Anthropic meldet für Fable 5.2 höhere Punktwerte bei mehreren Coding- und Reasoning-Bewertungen. Das praktisch stärkste Signal ist das Ergebnis zu Effort im Verhältnis zu Kosten: Fable auf High erreicht auf FrontierCode 2.0 fast den Wert von Opus auf Max – bei etwa halben Kosten pro Aufgabe in Anthropics früher Tests.
| Vom Anbieter gemeldete Bewertung | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0, agentic Coding | 49,1 % auf Xhigh | 45,5 % |
| FrontierSWE v2, agentic Coding | 69,9 % | 62,3 % |
| WANDR, agentic Search, relaxed Score | 82,1 % | 72,3 % |
| OSWorld 2.1, partielles Offline-Set | 89,3 % | 87,2 % |
Diese Zahlen stammen aus der Ankündigung, die angibt, dass Punktwerte – sofern nicht anders angegeben – mit dem höchsten verfügbaren Effort erzielt wurden. Sie beschreiben Anthropics Testbedingungen, nicht die Standardeinstellungen oder eine erwartete Erfolgsquote bei Ihren Tickets.
Der Kostenvergleich ist noch enger gefasst. Fable auf High erzielt 45,3 %, gegenüber Opus’ bestem Wert von 45,5 %. Das spricht dafür, die günstigere Konfiguration für diese Bewertung zu testen. Es bedeutet nicht, dass jeder Fable-Workflow halb so viel kostet wie Opus.
Verwandeln Sie einen Benchmark-Prozentwert nicht in eine Produktivitätsprognose. Ein Coding-Score misst weder Ihre Review-Warteschlange, das Deployment-Risiko noch die Zeit für die Reparatur einer fehlerhaften Migration. Halten Sie zudem die Mythos-only-Ergebnisse aus Cybersicherheit und Biologie aus Fables Bewertung heraus: Die Ankündigung nennt ein gemeinsames Basismodell, aber unterschiedliche Schutzmaßnahmen und Zugänge.
Effort-Einstellungen verändern den Vergleich
Legen Sie den Effort beim Modellvergleich explizit fest. Die API-Standards sind High für Fable 5.2 und Medium für Opus 5.5. Anthropics Ankündigung beschreibt Medium separat als Standard in den Claude-Apps und Claude Code. Dokumentieren Sie das Produkt und die Einstellung, statt anzunehmen, dass ein Standard überall gilt.
Die Effort-Dokumentation definiert low, medium, high, xhigh und max für beide Modelle. Effort beeinflusst Antworttext, Tool-Argumente und Thinking. Es ist ein Verhaltenssignal, kein hartes Ausgabenlimit.
Beginnen Sie mit Ihrer funktionierenden Opus-Konfiguration. Falls sie nicht ausreicht, vergleichen Sie einen höheren Opus-Effort mit Fable auf Medium oder High. Reservieren Sie Xhigh- und Max-Tests für Aufgaben, bei denen das zusätzliche Reasoning einen plausiblen Nutzen hat und Sie die Kosten tolerieren können.
Ein Vergleich bei gleichem Effort beantwortet eine Frage: Wie verhalten sich diese Modelle unter derselben benannten Einstellung? Ein kostenangepasster Vergleich beantwortet eine andere: Welche Konfiguration liefert das stärkste akzeptable Ergebnis für Ihr Budget? Das eine ersetzt das andere nicht.
Latenz: Messen Sie die gesamte Aufgabe
Beide Modelle tragen in Anthropics Übersicht die Kennzeichnung „Moderat“ für die vergleichende Latenz. Daraus lässt sich kein universeller Gewinner ableiten. Messen Sie die Zeit bis zu einem geprüften Ergebnis – einschließlich Tools und Retries – statt die Ausgabegeschwindigkeit als Geschwindigkeit Ihres gesamten Entwicklungsworkflows zu betrachten.
Anthropic gibt an, dass Fable 5.2 bis zu 30 % schneller ausgibt als Fable 5.1. Dieser Vergleich bezieht sich auf den Vorgänger, nicht auf Opus 5.5. Der optionale Fast Mode bietet bis zu 2,5-fache Token-Generierungsgeschwindigkeit – ebenfalls eine Anbieterangabe und kein gemessener Zeitgewinn bei Ihrer Aufgabe.
Eine Aufgabe, die von Kompilierung oder einer langsamen Datenbank dominiert wird, beschleunigt sich nicht proportional zur schnelleren Token-Generierung. Umgekehrt kann ein Agent, der zwei fehlerhafte Ansätze vermeidet, früher fertig sein, obwohl er langsamer Token erzeugt. Verfolgen Sie beides getrennt, bevor Sie für Geschwindigkeit zahlen.
Kosten pro akzeptiertem Ergebnis vergleichen
Nutzen Sie als Entscheidungsmetrik die Gesamtausgaben des Workflows geteilt durch die akzeptierten Ergebnisse. Tokenpreise bestimmen den Preis, aber Tokenvolumen, Caching, fehlgeschlagene Versuche, Tools und Review bestimmen, was Sie dafür bekommen. Die folgende Rechnung ist illustrierend und keine Messung des Verhaltens eines der Modelle.
Gehen Sie davon aus, dass eine Anfrage 100.000 nicht gecachte Eingabe-Token und 10.000 Ausgabe-Token verbraucht, mit Standard-Global-Routing und ohne zusätzliche Tool-Kosten:
| Konfiguration | Eingabekosten | Ausgabekosten | Gesamt |
|---|---|---|---|
| Opus 5.5 standard | 0,40 $ | 0,20 $ | 0,60 $ |
| Fable 5.2 standard | 0,80 $ | 0,40 $ | 1,20 $ |
| Opus 5.5 fast | 0,80 $ | 0,40 $ | 1,20 $ |
| Fable 5.2 fast | 1,60 $ | 0,80 $ | 2,40 $ |
Die Preise wurden am 10. November 2026 mit Anthropics Preisdokumentation abgeglichen. Abonnement-Kontingente sind von diesen API-Preisen getrennt. Cloud-Anbieter, Caching, Residency-Optionen und weitere Funktionen können die Rechnung verändern.
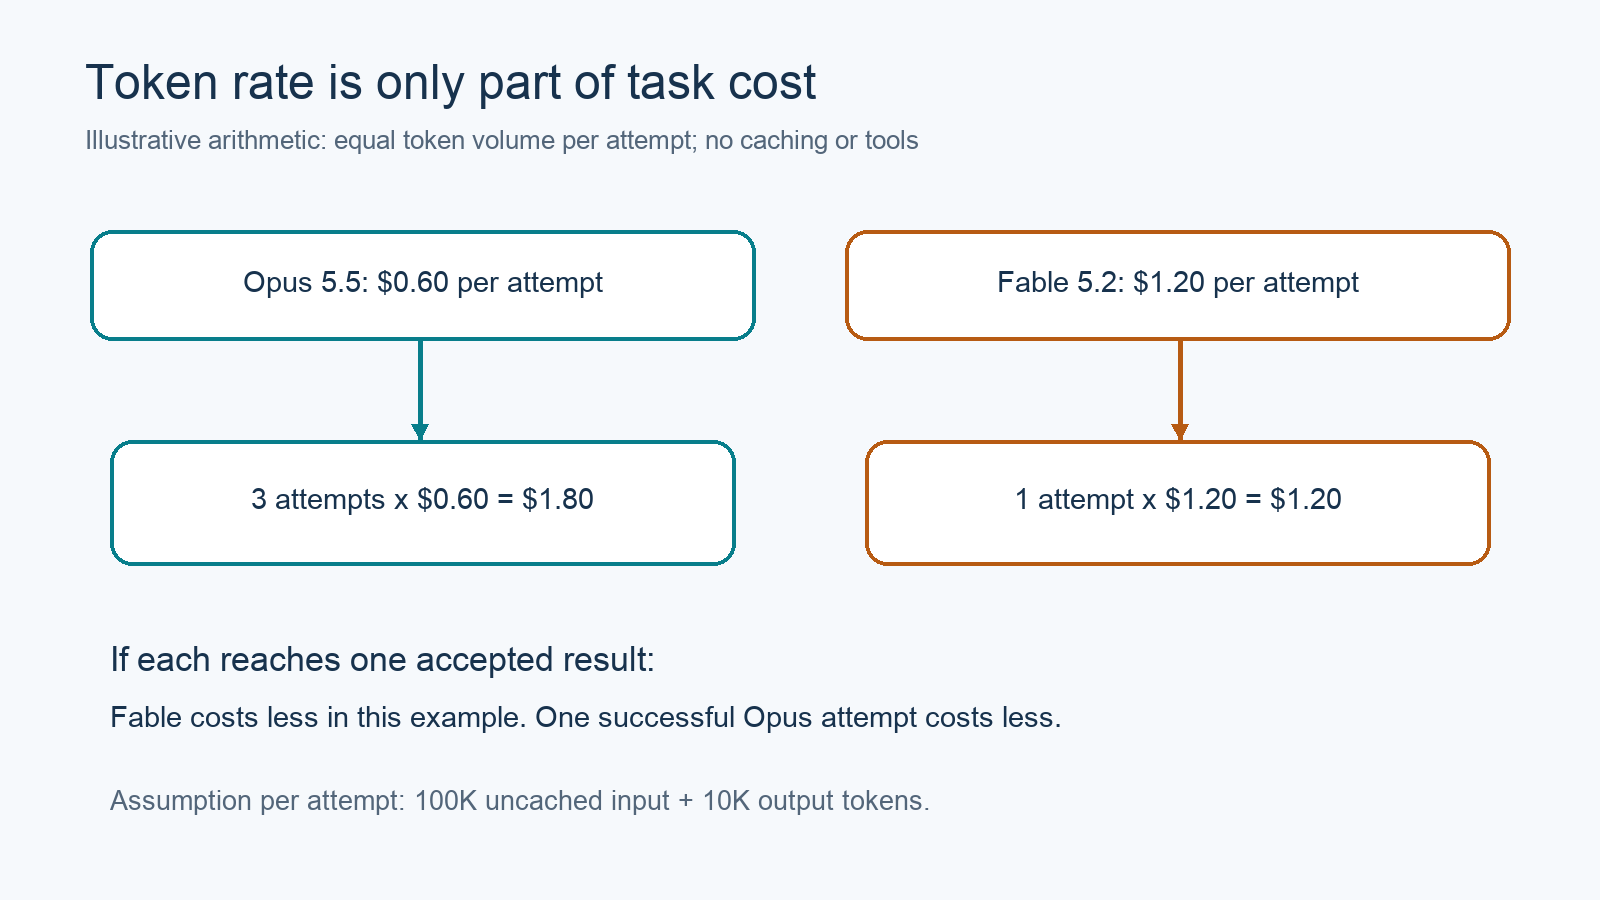
Vergleichen Sie alle Versuche bis zu einem erfolgreichen Ergebnis, einschließlich Retries und Review.
In diesem vereinfachten Beispiel kosten drei Opus-Versuche mit identischem Volumen 1,80 $; ein Fable-Versuch kostet 1,20 $. Fable ist nur dann günstiger, wenn es das akzeptierte Ergebnis in diesem einen Versuch erreicht. Ein erfolgreicher Opus-Versuch bleibt billiger. Echte Retries verbrauchen oft unterschiedliche Volumina – nutzen Sie daher aufgezeichnete Nutzungsdaten statt eines geschätzten Durchschnitts.
Stellen Sie die Zeit für das Engineering-Review neben die API-Ausgaben. Ein Patch, der Tests besteht, aber umfangreiche Nacharbeit erfordert, hat dieselbe Hürde nicht genommen wie ein review-fertiger Patch.
Lassen Sie Ihren Coding-Agenten die API mit Apidog CLI prüfen
Verwenden Sie Apidog CLI, um Ihren Coding-Agenten wiederholbare API-Prüfungen erstellen und ausführen zu lassen. Diese Prüfungen können Request- oder Response-Regressionen aufdecken, wenn Sie das Modell wechseln. Sie belegen nicht, ob die Repository-Änderungen eines Agenten korrekt sind; ergänzen Sie daher Repository-Tests und menschliches Review.
Richten Sie die CLI ein und lassen Sie Ihren Agenten die offizielle Installationsanleitung lesen:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
Geben Sie Claude Code oder Ihrem bevorzugten Agenten diesen Prompt:
Read https://apidog.com/apidog-cli-installation-guide.md.
In project <PROJECT_ID>, create a test case for our Claude Messages
request. Compare claude-opus-5-5 and claude-fable-5-2 using the same
prompt and explicit medium effort. Keep API credentials in private
variables. Assert the expected status and response structure, record
usage and elapsed time, and summarize failures. Don't claim these
checks measure coding quality. Validate every write payload first.
Der Agent prüft das Schema, wählt eine gültige Testfall-Kategorie, erstellt case.json und führt anschließend Befehle wie diese aus. Die Flags wurden mit der Hilfe der installierten CLI 2.2.12 abgeglichen:
apidog test-case category --project <PROJECT_ID>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <PROJECT_ID> --file case.json
apidog run --test-case <CASE_ID> --project <PROJECT_ID> \
  -e <ENVIRONMENT_ID> -r cli,json
Ersetzen Sie die Platzhalter durch Ihre Projekt-Ressourcen. Dies ist eine Workflow-Vorlage, kein durchgeführter Modellvergleich. Folgen Sie für die Agenten-Einrichtung dem Apidog CLI in Claude Code Guide oder der Codex-Integrationsanleitung.
FAQ
Ist Fable 5.2 für jede Coding-Aufgabe besser als Opus 5.5?
Nein. Anthropic empfiehlt Opus 5.5 für die meisten Coding- und Wissensaufgaben. Fable lohnt sich zu testen, wenn anspruchsvolle Arbeit diese Basis übersteigt. Seine höheren Anbieter-Benchmarkwerte garantieren kein besseres Ergebnis bei jeder Aufgabe.
Kostet Fable 5.2 doppelt so viel?
Seine Standard-Input- und -Output-Tokenpreise liegen doppelt so hoch wie die von Opus 5.5. Die Gesamtkosten einer Aufgabe können abweichen, da Konfigurationen unterschiedliche Tokenmengen verbrauchen und eine unterschiedliche Zahl von Versuchen erfordern.
Sollte man immer den maximalen Effort verwenden?
Nein. Vergleichen Sie die Einstellungen anhand Ihrer Akzeptanzprüfungen und Ihres Budgets. Höherer Effort erlaubt mehr Token-Ausgaben; er garantiert keine sinnvolle Verbesserung bei einer eingegrenzten Aufgabe.
Ist Fable 5.2 schneller als Opus 5.5?
Die hier geprüften Quellen legen keinen universellen Latenz-Sieger im Direktvergleich fest. Beide haben die Kennzeichnung „Moderat“. Messen Sie Ihren tatsächlichen Workflow und betrachten Sie den Fast Mode als eigene Konfiguration.
Kann Apidog entscheiden, welches Modell den besseren Code schreibt?
Apidog CLI kann Ihrem Agenten helfen, API-Prüfungen auszuführen und Response-Daten zu sammeln. Codequalität erfordert weiterhin Repository-Tests und Review. Nutzen Sie diese akzeptierten Ergebnisse, um zu entscheiden, welches Modell und welche Effort-Einstellung ihre Kosten rechtfertigen.