Claude Fable 5.1 kostet 10 $ und 50 $ pro Million Token. Claude Opus 5 kostet 5 $ und 25 $. Anthropic’s eigene Dokumentation empfiehlt, mit Opus 5 zu beginnen und erst dann zu Fable 5.1 zu wechseln, „wenn Ihre Evaluierungen auf Claude Opus 5 bei höherem Aufwand immer noch unzureichend sind“. Das ist eine überprüfbare Regel, und dieser Vergleich basiert darauf: wo Anthropic’s Zahlen zeigen, dass Fable 5.1 Opus 5 deutlich übertrifft, wo sie einige Punkte zeigen, die durch Prompt-Tuning behoben werden könnten, und wo die Preisberechnung interessant wird, weil Fable 5.1’s Cache-Reads die Hälfte von Opus 5’s betragen.
Die Quellen sind Anthropic’s Launch-Post, die Fable 5.1 Modellseite und die Preisseite. Für eine allgemeine Übersicht jedes Modells siehe was Claude Fable 5.1 ist und was Claude Opus 5 ist.
Nebeneinander
| Claude Fable 5.1 | Claude Opus 5 | |
|---|---|---|
| Modell-ID | claude-fable-5-1 |
claude-opus-5 |
| Veröffentlicht | 1. September 2026 | 24. Juli 2026 |
| Positionierung | Anspruchsvolle Argumentation und agentische Arbeit mit langem Zeithorizont | Komplexe agentische Kodierung und Unternehmensarbeit; die empfohlene Standardeinstellung |
| Eingabe / Ausgabe | $10 / $50 | $5 / $25 |
| Cache-Lesen | $0.25 | $0.50 |
| Cache-Schreiben (5 Min. / 1 Std.) | $12.50 / $20 | $6.25 / $10 |
| Batch | $5 / $25 | $2.50 / $12.50 |
| Schnellmodus | Nein | Ja ($10 / $50) |
| Prioritätsstufe | Nein | Nein |
| Kontext / Max. Ausgabe | 1M / 128K | 1M / 128K (300K im Batch mit Beta) |
| Wissensstand | Juni 2026 | Mai 2026 |
| Vergleichbare Latenz | Langsamer | Mäßig |
| Denken | Immer an; disabled gibt 400 zurück |
Standardmäßig an; disabled bei high oder darunter erlaubt |
Erzwungene tool_choice |
400 | Akzeptiert |
| Sicherheitsklassifikatoren | Cyber, Bio, Frontier-LLM, Reasoning-Extraktion, Allgemeine Schäden | Nur Cyber |
| Keine Datenaufbewahrung | Nicht verfügbar, es sei denn autorisiert | Verfügbar |
| Aufwand pro Nachricht (Beta) | Ja | Ja |
| Verlauf-Bearbeitungsprüfung | Ja | Nein |
Was die Benchmarks sagen
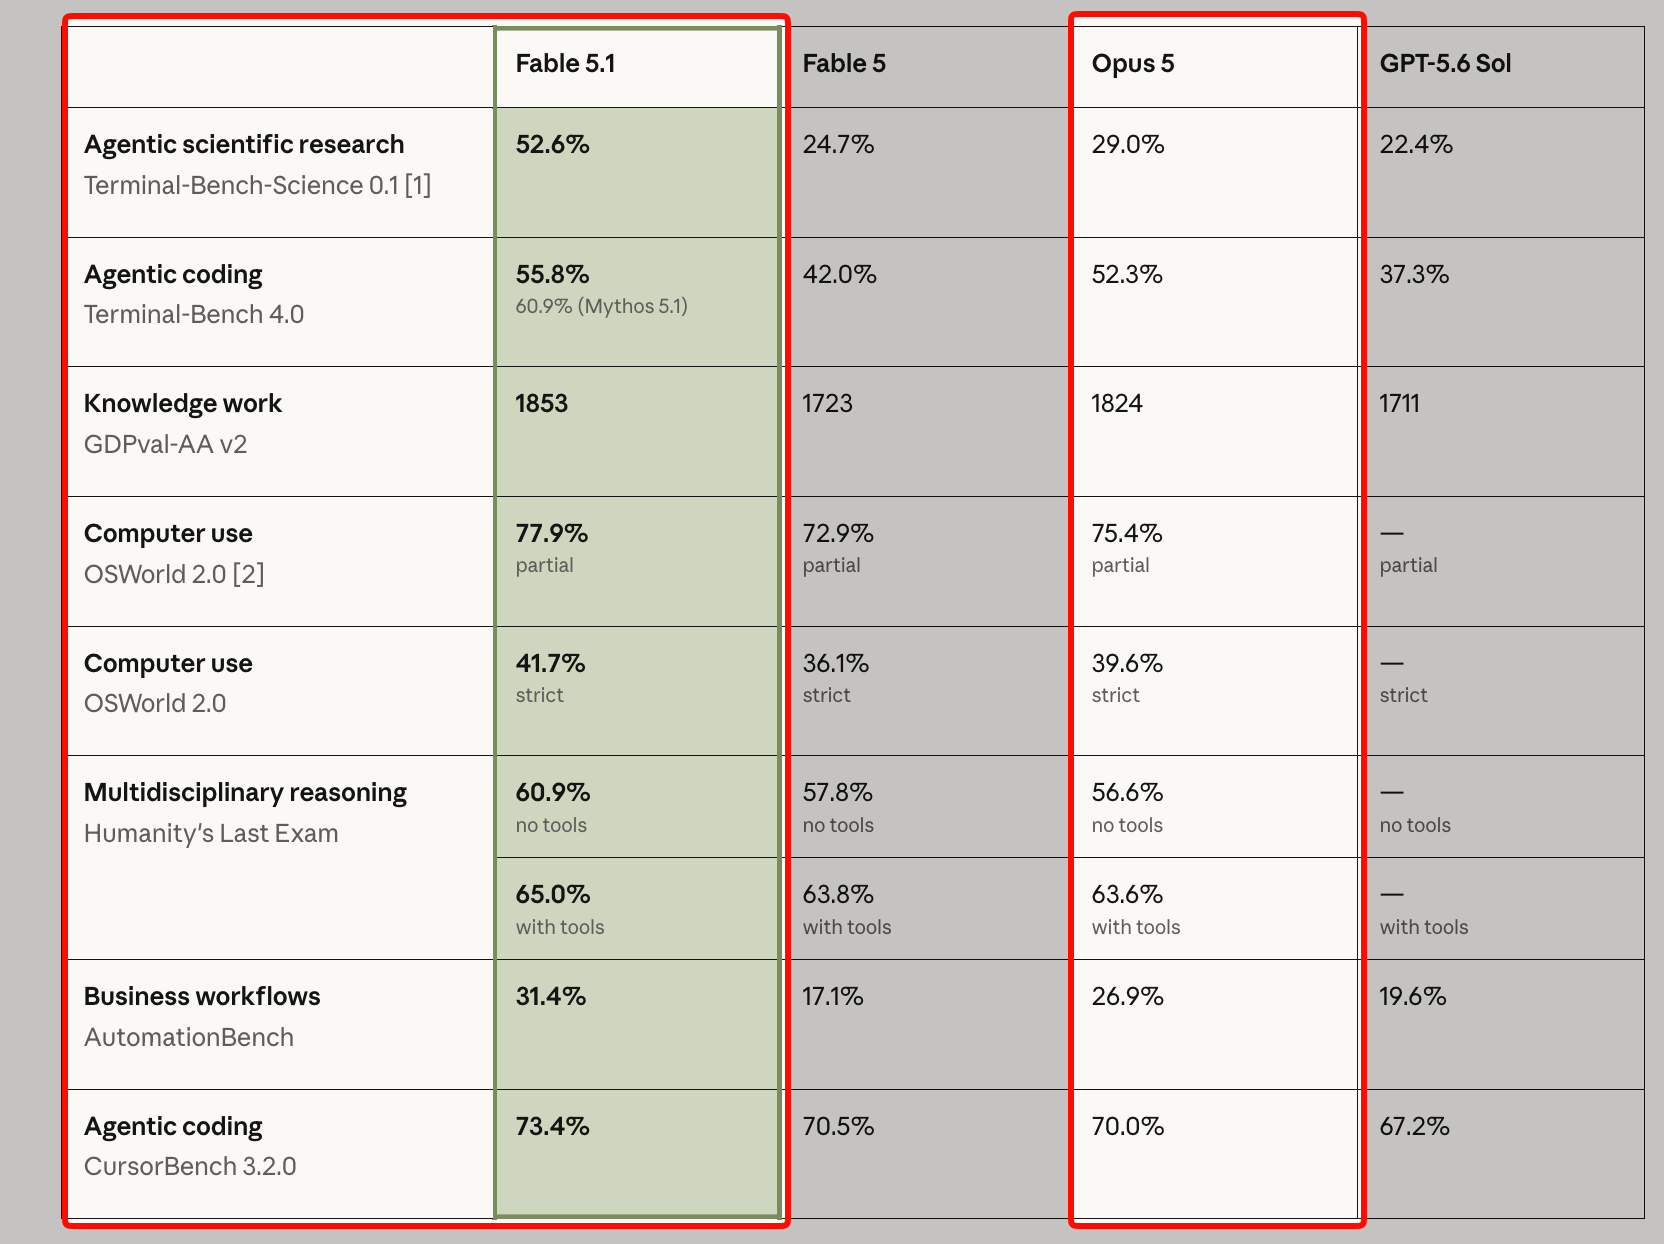
Alle Zahlen stammen von Anthropic, von Anthropic durchgeführt, noch ohne unabhängige Reproduktion.
| Benchmark | Fable 5.1 | Opus 5 | Unterschied |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 29.0% | +23.6 |
| AutomationBench | 31.4% | 26.9% | +4.5 |
| Humanity’s Last Exam (ohne Tools) | 60.9% | 56.6% | +4.3 |
| Terminal-Bench 4.0 | 55.8% | 52.3% | +3.5 |
| CursorBench 3.2.0 | 73.4% | 70.0% | +3.4 |
| OSWorld 2.0 (teilweise) | 77.9% | 75.4% | +2.5 |
| OSWorld 2.0 (streng) | 41.7% | 39.6% | +2.1 |
| Humanity’s Last Exam (mit Tools) | 65.0% | 63.6% | +1.4 |
| GDPval-AA v2 | 1853 | 1824 | +29 Elo |
Lesen Sie diese Tabelle als zwei Geschichten. Bei Terminal-Bench-Science verdoppelt Fable 5.1 fast Opus 5, und das ist ein langwieriger, werkzeugintensiver Forschungs-Benchmark, bei dem das Modell über lange Zeit Experimente in einem Terminal ausführt. Bei allem anderen liegt der Unterschied zwischen einem und fünf Punkten. Eine Fünf-Punkte-Lücke bei AutomationBench ist bedeutsam. Eine 1,4-Punkte-Lücke bei „Humanity’s Last Exam with tools“ oder 29 Elo bei GDPval liegt innerhalb des Bereichs, in dem Ihr Prompt und Ihre Aufwandseinstellung das Ergebnis stärker beeinflussen als die Modellwahl.
Ein weiterer wichtiger Datenpunkt: Opus 5 wurde im Juli mit 52,3 % bei Terminal-Bench 4.0 eingeführt, vor Fable 5’s 42,0 %. Fable 5.1 eroberte die Führung mit 55,8 % zurück, aber mit 3,5 Punkten, nicht 13,8. Der Vorteil der Fable-Stufe gegenüber der Opus-Stufe bei der agentischen Kodierung ist real und schmaler, als er im Juni war. Der Opus 5 vs. Fable 5 Vergleich erfasste den früheren Stand dieses Rennens.
Die Preisberechnung ist nicht einfach 2x
Ohne Cache ist Fable 5.1 bei jeder Zeile genau doppelt so teuer wie Opus 5. Aber Cache-Reads kehren sich um: 0,25 $ bei Fable 5.1 gegenüber 0,50 $ bei Opus 5. Der effektive Multiplikator hängt also davon ab, wie viel Ihres Inputs ein gecachtes Präfix ist.
Nehmen Sie einen agentischen Zug mit 150.000 gecachten Tokens, 1.000 ungecachten Eingabe-Tokens und 800 Ausgabe-Tokens. Opus 5: `5(0.001) + 0.5(0.15) + 25(0.0008)` = 0.005 $ + 0.075 $ + 0.02 $ = 0.10 $. Fable 5.1: `10(0.001) + 0.25(0.15) + 50(0.0008)` = 0.01 $ + 0.0375 $ + 0.04 $ = 0.0875 $. Bei diesem Zug ist Fable 5.1 günstiger.
Nehmen Sie nun eine Code-Review mit 30.000 ungecachten Eingabe-Tokens und 4.000 Ausgabe-Tokens. Opus 5: 0,15 $ + 0,10 $ = 0,25 $. Fable 5.1: 0,30 $ + 0,20 $ = 0,50 $. Genau das Doppelte.
Der Übergang: Die Kosten pro Zug von Fable 5.1 fallen unter die von Opus 5, wenn die gecachten Eingabe-Tokens das etwa 20-fache der Summe aus ungecachten Eingabe-Tokens und dem 5-fachen der Ausgabe-Tokens überschreiten. Für Agenten-Loops mit hohem Präfixanteil ist diese Bedingung häufig. Bei allem, was ausgabeintensiv ist, tritt dies nie auf. Cache-Schreibvorgänge sind bei Fable 5.1 ebenfalls doppelt so teuer, sodass eine Sitzung, die ihren Cache oft zurücksetzt, den Vorteil verliert. Die Fable 5.1 Preisübersicht und die Opus 5 Preisübersicht enthalten die vollständigen Tabellen.
Wo Opus 5 eindeutig gewinnt
Alles, was Sie mit ausgeschaltetem „Denken“ ausführen können. Opus 5 akzeptiert thinking: {"type": "disabled"} bei high Aufwand oder darunter. Fable 5.1 tut dies niemals. Für Klassifizierungs-, Extraktions- und Kurzantwort-Routen ist Opus 5 mit ausgeschaltetem Denken (oder bei low Aufwand) sowohl günstiger als auch schneller.
Schnellmodus. Opus 5 verfügt über einen Fast-Modus für Forschungsvorschauen mit bis zu 2,5-facher Ausgabegeschwindigkeit für 10 $ und 50 $. Fable 5.1 hat kein Äquivalent. Wenn die Antwortzeit wichtiger ist als die letzten paar Benchmark-Punkte, ist dies entscheidend.
Latenz generell. Anthropic listet Fable 5.1 als „langsamer“ und Opus 5 als „moderat“ auf. Einzelne Fable 5.1-Züge bei schwierigen Aufgaben mit hohem Aufwand können viele Minuten dauern.
Keine Datenaufbewahrung. Opus 5 ist unter ZDR (Zero Data Retention) verfügbar. Fable 5.1 ist ein „Covered Model“ und gibt einen 400er-Fehler zurück, es sei denn, Anthropic autorisiert den ZDR-Zugriff ausdrücklich.
Weniger Ablehnungen. Opus 5 verwendet nur Cybersicherheits-Klassifikatoren. Fable 5.1 verwendet den vollständigen Fable-Satz: Cyber, Bio, Frontier LLM-Entwicklung, Reasoning-Extraktion und allgemeine Schäden. Eine harmlose Biowissenschafts- oder ML-Arbeitslast, die Opus 5 nie auslöst, kann Fable 5.1 auslösen, und wenn dies geschieht, ist der Fallback-Ziel ohnehin Opus 5.
Erzwungene `tool_choice`. Opus 5 akzeptiert weiterhin tool_choice any und tool. Fable 5.1 gibt einen 400er-Fehler zurück. Wenn Ihre Integration auf erzwungene Aufrufe angewiesen ist, erspart Ihnen Opus 5 das Umschreiben.
Keine Überprüfung der Verlauf-Bearbeitung. Opus 5 ist es egal, ob Sie frühere Züge bearbeiten. Fable 5.1 invalidiert bei solchen Bearbeitungen spätere Denkblöcke. Eine Harness, die clientseitig komprimiert oder pro Zug Erinnerungen einfügt, funktioniert heute mit Opus 5 und muss vor Fable 5.1 überprüft werden.
Wo Fable 5.1 eindeutig gewinnt
Langfristige Forschung und Terminal-Agenten. Das Ergebnis von 52,6 % gegenüber 29,0 % bei Terminal-Bench-Science ist die größte Einzel-Lücke in Anthropic’s Tabelle. Wenn Ihre Agenten Experimente durchführen, mehrstufige Webrecherche betreiben oder stundenlang operieren, ist dies die Arbeitslast, für die das Modell entwickelt wurde.
Automatisierung von Geschäftsprozessen. 31,4 % gegenüber 26,9 % bei AutomationBench ist ein echter Unterschied in einem Benchmark, der End-to-End-Aufgaben über Anwendungen hinweg modelliert.
Cache-Präfix-intensive Agenten. Oben behandelt: Das 0,25 $-Cache-Lesen macht Fable 5.1 pro Zug in präfixdominierten Loops günstiger.
Wissensstand. Juni 2026 gegenüber Mai 2026. Ein Monat, aber es ist der aktuellste von allen Claude-Modellen.
Vision auf dichten Dokumenten. Anthropic listet die verbesserte Lesbarkeit von Diagrammen, Einreichungen und Tabellen in PDFs, insbesondere mit Zuschneide- und Zoom-Tools, als einen Vorteil von Fable 5.1 auf. Opus 5 wird nicht mit einem veröffentlichten Vision-Benchmark verglichen, daher ist dies als Behauptung zu behandeln, die getestet werden muss.
Wenn Opus 5 bei `xhigh` fehlschlägt. Dies ist Anthropic’s Regel, und sie ist die richtige. Wenn eine Aufgabe bei Ihrer Evaluierung von Opus 5 bei `xhigh` fehlschlägt, versuchen Sie Fable 5.1 bei `high`, bevor Sie etwas anderes versuchen.
Aufwand ändert den Vergleich
Beide Modelle bieten fünf Aufwandsstufen, und Anthropic macht eine spezifische Aussage über Fable 5.1 am unteren Ende: Bei `low` Aufwand ist es „oft wettbewerbsfähig mit Claude Opus und Claude Sonnet Modellen in Bezug auf die Kosten pro Aufgabe, während es höher punktet“. Das rückt die Wahl in ein neues Licht. Statt Opus 5 bei `high` versus Fable 5.1 bei `high` könnte der faire Vergleich für Routinearbeiten Opus 5 bei `high` versus Fable 5.1 bei `low` oder `medium` sein. Die Anzahl der Ausgabe-Tokens bei geringerem Aufwand ist kleiner, was den doppelten Preis pro Token ausgleicht.
Das Gegenteil trifft ebenfalls zu. Die Verbesserungen von Fable 5.1 gegenüber Fable 5 sind am größten bei `xhigh` und `max`, was bedeutet, dass die Leistungsobergrenze über Opus 5 bei den Aufwandsstufen am höchsten ist, die auch die meiste Zeit kosten. Vergleichen Sie beide Modelle über alle Aufwandsstufen hinweg mit Ihren eigenen Evaluierungen, bevor Sie Schlussfolgerungen aus den Einführungstabellen ziehen. Der Opus 5 Aufwandsleitfaden behandelt die fünf Stufen; die Semantik ist bei Fable 5.1 dieselbe.
Ein Entscheidungsrahmen
- Beginnen Sie mit Opus 5 bei `high`. Anthropic’s Standardempfehlung: halber Preis, weniger Klassifikatoren, ZDR verfügbar.
- Erhöhen Sie Opus 5 auf `xhigh` für die Aufgaben, die fehlschlagen. Günstiger als der Modellwechsel.
- Verschieben Sie die immer noch fehlschlagenden Aufgaben zu Fable 5.1 bei `high`. Pro Route, nicht global. Behalten Sie Opus 5 für alles bei, was funktioniert.
- Überprüfen Sie das Cache-Profil dessen, was Sie verschoben haben. Wenn es sich um eine präfix-lastige Schleife handelt, könnte Fable 5.1 pro Zug günstiger sein als Opus 5.
- Überprüfen Sie das Harness vor Schritt 3. Erzwungene `tool_choice` und Verlaufsbearbeitungen funktionieren bei Fable 5.1 nicht. Der Migrationsleitfaden enthält die Checkliste.
Den Vergleich in Apidog durchführen
Erstellen Sie eine Sammlung mit Ihren Produktions-Prompts und `model` als Umgebungsvariable. Führen Sie sie gegen `claude-opus-5` bei `high`, dann erneut bei `xhigh`, dann gegen `claude-fable-5-1` bei `high` und `low` aus. Notieren Sie für jeden Durchlauf die Antwort, `usage.output_tokens` und `usage.cache_read_input_tokens` bei einem wiederholten Senden. Multiplizieren Sie mit den Raten jedes Modells in einem Post-Response-Skript, und Sie haben die Kosten pro Aufgabe pro Modell pro Aufwand in einer Tabelle. Apidog speichert jeden Lauf als Verlauf, sodass der Vergleich die nächste Modelleinführung überdauert. Laden Sie Apidog herunter, um es einzurichten.
FAQ
Ist Claude Fable 5.1 besser als Opus 5? Bei jedem von Anthropic veröffentlichten Benchmark: Ja, mit Margen von 1,4 bis 23,6 Punkten. Die große Lücke besteht bei Terminal-Bench-Science; die meisten anderen liegen unter fünf Punkten. Dies sind vom Anbieter durchgeführte Ergebnisse.
Ist Fable 5.1 den doppelten Preis von Opus 5 wert? Für langfristige Forschung und Terminal-Agenten, Geschäftsautomatisierung und präfix-lastige Agentenschleifen (wo günstigere Cache-Lesevorgänge die Kosten pro Zug senken können), oft ja. Für ausgabeintensive, latenzempfindliche oder Klassifizierungsarbeiten, nein. Anthropic’s eigene Regel: Nur dann aufrüsten, wenn Opus 5 bei höherem Aufwand Ihre Evaluierungen nicht besteht.
Welches ist schneller, Fable 5.1 oder Opus 5? Opus 5. Anthropic listet es als „moderate“ Latenz im Vergleich zu „langsamer“ für Fable 5.1 auf, und Opus 5 hat einen Schnellmodus mit bis zu 2,5-facher Ausgabegeschwindigkeit. Fable 5.1 hat keinen.
Hat Opus 5 die gleichen Sicherheitsklassifikatoren wie Fable 5.1? Nein. Opus 5 verwendet nur Cybersicherheits-Klassifikatoren. Fable 5.1 fügt Bio, Frontier LLM, Reasoning-Extraktion und allgemeine Schäden hinzu. Wenn Fable 5.1 ablehnt, ist Opus 5 eines der beiden zulässigen Fallback-Ziele.
Kann ich Fable 5.1 wie Opus 5 unter Zero Data Retention nutzen? Nein. Fable 5.1 erfordert eine 30-tägige Aufbewahrung und ist ein „Covered Model“. Opus 5 ist unter ZDR verfügbar.
Kann eine Konversation zwischen Opus 5 und Fable 5.1 wechseln? Nach oben, ja: Fable 5.1 liest die Denkblöcke von Opus 5. Nach unten verwirft die API die Denkblöcke von Fable 5.1, bevor Opus 5 sie unberechnet sieht, und Opus 5 plant diesen Zug neu.