
Kurze Antwort: Die Claude Batch API verarbeitet Anfragen an die Messages API asynchron mit 50 % Rabatt auf sowohl Input- als auch Output-Tokens. Sie übermitteln bis zu 100.000 Anfragen (oder 256 MB) in einem Aufruf, pollen, bis der Batch abgeschlossen ist, und lesen dann die Ergebnisse, die über Ihre eigene custom_id verschlüsselt sind. Die meisten Batches sind innerhalb einer Stunde fertig, die harte Obergrenze liegt bei 24 Stunden.
Sie haben 40.000 Support-Tickets zu klassifizieren, einen Produktkatalog umzuschreiben oder einen Monat an Transkripten zusammenzufassen. Nichts davon ist dringend. Jeder dieser Aufrufe wird trotzdem zum vollen Preis abgerechnet, wenn Sie sie einzeln abschicken, und Sie verbringen den Nachmittag damit, Wiederholungsversuche gegen Ihr Rate Limit zu beaufsichtigen.
Die Claude Batch API existiert genau für diese Art von Arbeit. Sie übergeben Anthropic eine Liste von Anfragen, gehen weg und kommen zu einer Ergebnisdatei zurück, die halb so viel gekostet hat wie dieselben Aufrufe synchron gekostet hätten. Keine Warteschlange zu betreiben, kein Concurrency-Tuning, keine Backoff-Logik.
Dieser Leitfaden behandelt, was der Batch-Endpunkt tut, was er kostet, wie Sie einen Job übermitteln und abholen und wie Sie Ihren Coding-Agenten das Ganze mit Apidog CLI testen lassen, bevor Sie ihn auf echte Daten richten.
Was ist die Claude Batch API?
Die Claude Batch API ist ein asynchroner Endpunkt unter /v1/messages/batches, der viele Anfragen an die Messages API in einer einzigen Übermittlung annimmt und deren Ergebnisse zurückgibt, sobald die Verarbeitung endet. Sie tauscht Latenz gegen einen Rabatt von 50 %. Anthropic dokumentiert sie unter Batch-Verarbeitung.
Die Einschränkungen, um die Sie herum planen müssen:
- Größe: bis zu 100.000 Anfragen oder 256 MB pro Batch, je nachdem, was zuerst erreicht wird.
- Timing: die meisten Batches sind innerhalb einer Stunde abgeschlossen; 24 Stunden sind das Maximum, bevor unfertige Anfragen verfallen.
- Aufbewahrung: Ergebnisse bleiben 29 Tage nach Erstellung des Batches verfügbar.
- Funktionsparität: Vision, Tool-Nutzung, System-Prompts und Prompt-Caching funktionieren alle innerhalb eines Batches.
- Reihenfolge: Ergebnisse kommen in beliebiger Reihenfolge zurück, also verschlüsseln Sie sie über
custom_idund niemals über die Position.
Der letzte Punkt ist der, der Leute beißt. Ein Batch ist ein Beutel, keine Warteschlange.
Was die Claude Batch API kostet
Der Rabatt ist ein pauschaler Abzug von 50 % auf sowohl Input- als auch Output-Tokens und wird auf das Modell angewendet, das jede Anfrage benennt. Sie können Modelle innerhalb eines Batches mischen, sodass ein günstiger Klassifizierer und ein teurer Zusammenfasser gemeinsam mitfahren können.
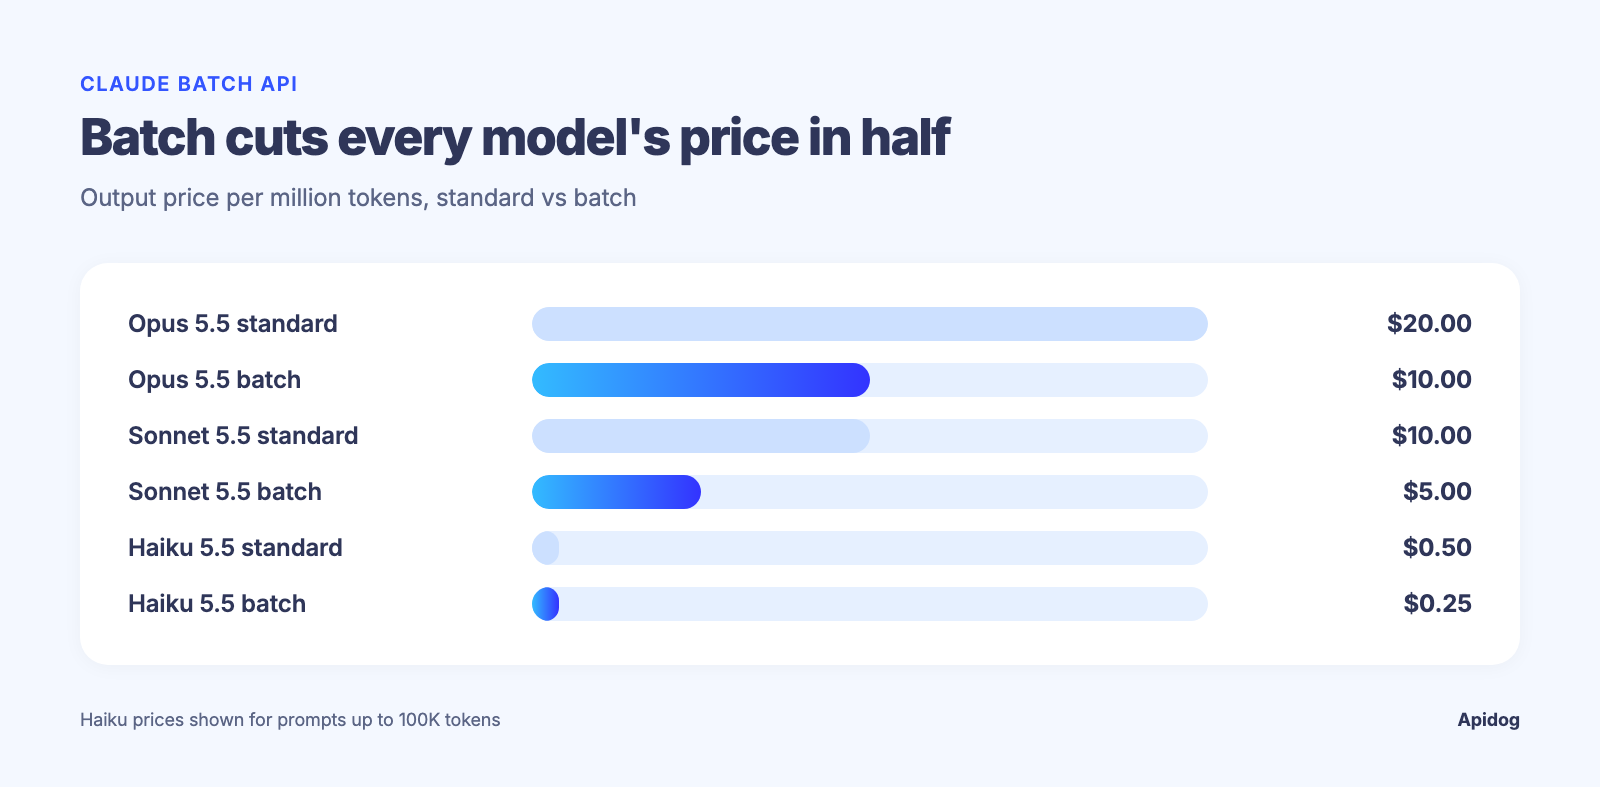
| Modell | Standard Input / Output pro MTok | Batch Input / Output pro MTok |
|---|---|---|
| Claude Opus 5.5 | $4.00 / $20.00 | $2.00 / $10.00 |
| Claude Sonnet 5.5 | $2.00 / $10.00 | $1.00 / $5.00 |
| Claude Haiku 5.5 (Prompts bis 100K) | $0.10 / $0.50 | $0.05 / $0.25 |
| Claude Haiku 5.5 (Prompts über 100K) | $0.50 / $2.50 | $0.25 / $1.25 |
Lesen Sie die Haiku-Zeilen sorgfältig. Haiku 5.5 bepreist nach Prompt-Größe, sodass ein Prompt, der 100.000 Tokens überschreitet, das 5-fache des Kurz-Prompt-Tarifs in Rechnung stellt, Batch-Rabatt hin oder her. Kalkulieren Sie Long-Context-Haiku-Arbeit mit $0.25 / $1.25, nicht mit $0.05 / $0.25. Prüfen Sie Anthropics Preisseite, bevor Sie eine Prognose auf diesen Zahlen aufbauen, und lesen Sie unsere Aufschlüsselung dazu, wohin die Claude-API-Ausgaben fließen, wenn die Rechnung der Grund ist, warum Sie hier sind.
Die Batch-Preisgestaltung lässt sich außerdem mit Prompt-Caching stapeln, wo die wahren Ersparnisse liegen. Mehr dazu unten.
Übermitteln Sie Ihren ersten Batch
Installieren Sie das offizielle Python SDK und bauen Sie eine Liste von Anfragen. Jede trägt eine custom_id, die Sie wählen, und ein params-Objekt, das genau wie ein normaler messages.create()-Aufruf aussieht.
import anthropic
from anthropic.types.message_create_params import MessageCreateParamsNonStreaming
from anthropic.types.messages.batch_create_params import Request

client = anthropic.Anthropic()

tickets = [
    "Card declined three times, support chat timed out.",
    "Love the new dashboard, the export button is hidden though.",
    "Webhook stopped firing after the 2.4 upgrade.",
]

batch = client.messages.batches.create(
    requests=[
        Request(
            custom_id=f"ticket-{i}",
            params=MessageCreateParamsNonStreaming(
                model="claude-haiku-5-5",
                max_tokens=1024,
                output_config={"effort": "low"},
                messages=[{
                    "role": "user",
                    "content": f"Label this ticket billing, bug, or praise. One word.\n\n{text}",
                }],
            ),
        )
        for i, text in enumerate(tickets)
    ]
)

print(batch.id, batch.processing_status)
Geben Sie der custom_id Bedeutung. Ein Datenbank-Primärschlüssel oder ein Dateipfad spart Ihnen später einen Join, und es ist das Einzige, was ein Ergebnis mit seiner Eingabe verbindet.
Wenn Sie rohes HTTP bevorzugen, geht dieselbe Nutzlast an POST https://api.anthropic.com/v1/messages/batches mit Ihren Headern x-api-key und anthropic-version. Die Referenz zum Erstellen eines Message-Batches enthält das vollständige Schema.
Den Batch pollen und Ergebnisse einsammeln
Rufen Sie den Batch ab, bis processing_status ended lautet, und streamen Sie dann die Ergebnisse. Jedes Ergebnis trägt die custom_id, die Sie gesetzt haben, und einen result.type von succeeded, errored, canceled oder expired.
import time

while True:
    batch = client.messages.batches.retrieve(batch.id)
    if batch.processing_status == "ended":
        break
    print("still working:", batch.request_counts.processing)
    time.sleep(30)

labels, retry = {}, []
for result in client.messages.batches.results(batch.id):
    if result.result.type == "succeeded":
        msg = result.result.message
        labels[result.custom_id] = next(b.text for b in msg.content if b.type == "text")
    elif result.result.type == "errored":
        retry.append(result.custom_id)

print(f"{len(labels)} labeled, {len(retry)} need another pass")
Zwei Fehlermodi verdienen eine separate Behandlung. Ein invalid_request-Fehler bedeutet, dass der Anfrage-Body falsch war, also korrigieren Sie ihn, bevor Sie erneut übermitteln. Alles andere ist serverseitig und kann unverändert sicher erneut versucht werden. Ein expired-Ergebnis bedeutet, dass das 24-Stunden-Fenster sich geschlossen hat, bevor diese Anfrage ausgeführt wurde, und diese übermitteln Sie ebenfalls erneut.
Pollen Sie mit einem Timer von 30 bis 60 Sekunden. Den Retrieve-Endpunkt jede Sekunde zu hämmern, bringt Ihnen nichts und zählt gegen Ihre Claude-API-Rate-Limits.
Batch-Preisgestaltung mit Prompt-Caching stapeln
Der größte Gewinn entsteht durch die Kombination der beiden Rabatte. Wenn jede Anfrage in Ihrem Batch ein langes Präfix teilt – einen Styleguide, eine Taxonomie, einen 40-seitigen Vertrag – markieren Sie dieses Präfix mit cache_control und senden dasselbe markierte Präfix bei allen 10.000 Anfragen.
shared_system = [
    {"type": "text", "text": "You are a support triage analyst."},
    {
        "type": "text",
        "text": taxonomy_document,          # thousands of tokens, identical every time
        "cache_control": {"type": "ephemeral"},
    },
]
Setzen Sie diesen system-Block auf jede Request im Batch. Jede Anfrage, deren Präfix byte-für-byte mit einem aktiven Cache-Eintrag übereinstimmt, wird für dieses Präfix zu Cache-Read-Tarifen abgerechnet, und der 50 % Batch-Rabatt gilt gleichermaßen für Cache-Reads und -Writes. Kalkulieren Sie nicht mit einer perfekten Trefferquote: Ein Batch verarbeitet seine Anfragen nebenläufig statt in Reihenfolge, sodass Cache-Treffer innerhalb eines Batches nach bestem Bemühen erfolgen. Anthropics Prompt-Caching-Leitfaden behandelt die Präfix-Regeln: Jedes Byte, das sich vor Ihrem Breakpoint ändert, invalidiert alles danach, also halten Sie Zeitstempel und Item-spezifischen Text nach dem gecachten Block.
Lassen Sie Claude Code den Endpunkt mit Apidog CLI testen
Bevor Sie Geld für 100.000 Live-Anfragen ausgeben, möchten Sie einen Regressionstest für den Batch-Lebenszyklus: create, retrieve, results. Das von Hand in einer GUI zu schreiben, ist langsam. Lassen Sie Ihren Coding-Agenten es stattdessen mit Apidog CLI erledigen.
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install   # pick Claude Code when prompted
Dann ein Prompt an Claude Code:
In Apidog project 4820193, create a test case for POST https://api.anthropic.com/v1/messages/batches
that submits two Haiku 5.5 requests with custom_id ticket-0 and ticket-1, asserts the response
has an id and processing_status, then polls GET /v1/messages/batches/{id} until processing_status
is ended. Run it against the anthropic-staging environment and summarize failures.
Der Agent liest das Nutzlast-Schema, validiert sein eigenes JSON und erstellt und führt dann den Testfall aus:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file batch-case.json
apidog test-case create --project 4820193 --file batch-case.json
apidog run --test-case 77214 --project 4820193 -e 992301 -r cli,json
Ihr API-Schlüssel bleibt in einer Apidog-Umgebungsvariable, sodass er niemals in einem Prompt oder einem Repo landet. Wechseln Sie den Reporter zu -r junit und derselbe Befehl läuft in CI bei jedem Merge – das ist das Setup in unserem Apidog CLI Pipeline-Leitfaden. Wenn Sie die CLI noch nicht in Ihren Agenten eingebunden haben, beginnen Sie mit Apidog CLI in Claude Code verwenden.
Wann Batch die falsche Wahl ist
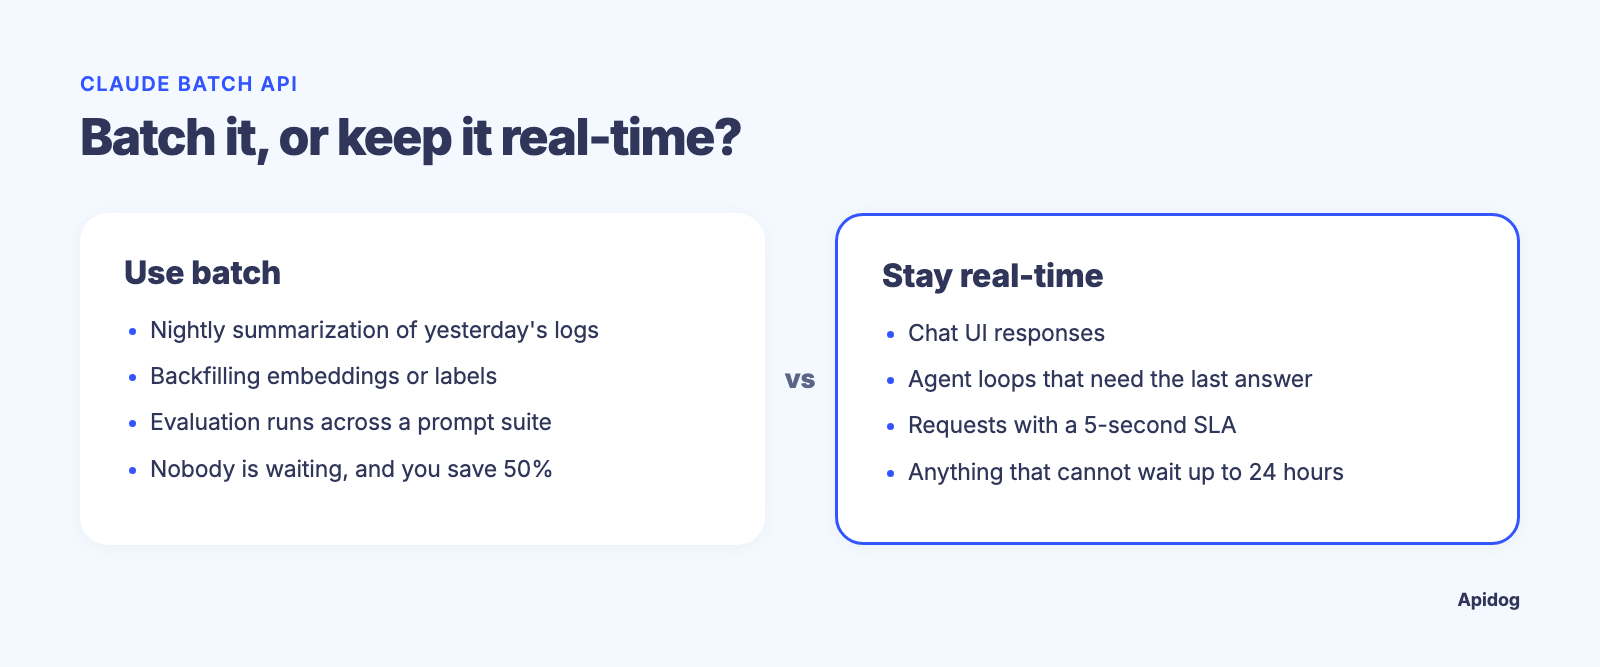
| Workload | Batch verwenden? | Warum |
|---|---|---|
| Nächtliche Zusammenfassung der Logs von gestern | Ja | Niemand wartet; 50 % Rabatt |
| Backfilling von Embeddings oder Labels über einen Korpus | Ja | Passt unter die Obergrenze von 100.000 Anfragen |
| Evaluierungsläufe über eine Prompt-Suite | Ja | Ergebnisse, verschlüsselt über custom_id, lassen sich Test-IDs zuordnen |
| Antworten der Chat-UI | Nein | Benutzer werden nicht eine Stunde warten |
| Eine Agent-Schleife, die die letzte Antwort braucht, um den nächsten Schritt zu wählen | Nein | Batch-Anfragen können sich nicht gegenseitig sehen |
| Eine Anfrage, die ein 5-Sekunden-SLA einhalten muss | Nein | Keine Latenzgarantie unterhalb von 24 Stunden |
Ein paar Dinge übertragen sich ebenfalls nicht. Der Fast Mode ist auf der Batch API nicht verfügbar, serverseitige Refusal-Fallbacks werden dort abgelehnt, und bei Claude Opus 5.5 und Claude Sonnet 5.5 liefert ein erzwungenes tool_choice von any oder tool innerhalb eines Batches genau wie bei einem normalen Aufruf einen 400 zurück. Verwenden Sie stattdessen tool_choice: auto mit strict: true.
Wenn Sie Multi-Provider-Infrastruktur betreiben, existiert dasselbe Muster auch anderswo: siehe die OpenAI Batch API und den Gemini API Batch-Modus. Die Formen unterscheiden sich, die Ökonomie nicht.
FAQ
Was ist die Claude Batch API?
Es ist ein asynchroner Endpunkt, der standardmäßige Messages API-Anfragen in großen Mengen zu 50 % der normalen Token-Preise ausführt. Sie übermitteln eine Liste von Anfragen mit Ihren eigenen IDs, pollen, bis der Batch endet, und lesen die Ergebnisse innerhalb von 29 Tagen.
Wie viel kostet die Claude Batch API?
Die Hälfte des Standardtarifs auf sowohl Input als auch Output. Bei Claude Sonnet 5.5 sind das $1.00 pro Million Input-Tokens und $5.00 pro Million Output-Tokens, gegenüber $2.00 und $10.00 synchron.
Wie lange dauert ein Claude-Batch?
Die meisten Batches sind innerhalb einer Stunde fertig. Das Maximum sind 24 Stunden, danach liefert jede unverarbeitete Anfrage ein expired-Ergebnis zurück und Sie übermitteln sie erneut.
Kann ich Prompt-Caching innerhalb eines Batches verwenden?
Ja, und die Rabatte stapeln sich. Markieren Sie ein gemeinsames Präfix mit cache_control, wiederholen Sie dieses identische Präfix über jede Anfrage, und gecachte Reads werden zu einem Bruchteil des Input-Preises zusätzlich zum Batch-Rabatt abgerechnet.
Was passiert, wenn eine Anfrage in einem Batch fehlschlägt?
Nur diese Anfrage schlägt fehl. Ihr Ergebnis trägt type: "errored" mit einem Fehlerobjekt; alles andere ist weiterhin erfolgreich. Validierungsfehler benötigen eine korrigierte Nutzlast, Serverfehler können unverändert sicher erneut versucht werden.
Kann ich einen laufenden Batch abbrechen?
Ja. client.messages.batches.cancel(batch_id) versetzt den Batch in canceling. Bereits abgeschlossene Anfragen behalten ihre Ergebnisse; die übrigen kommen als canceled zurück.
Unterstützt die Batch API Tools und Bilder?
Ja. Jede Messages API-Funktion funktioniert innerhalb eines Batches, einschließlich Vision, Tool-Definitionen und System-Prompts. Die Ausnahmen sind Fast Mode, serverseitige Fallbacks und erzwungene Tool-Wahl bei den 5.5-Modellen.
Zusammenfassung
Batch-Verarbeitung ist nach dem Prompt-Caching die zweitgrößte kostenlose Einsparung bei der Claude API, und sie kostet Sie nichts an Qualität: gleiche Modelle, gleiche Funktionen, halber Preis, bezahlt mit Latenz, die Sie wahrscheinlich sowieso nicht genutzt hätten. Verschlüsseln Sie Ihre Ergebnisse über custom_id, cachen Sie das gemeinsame Präfix und behandeln Sie expired wie einen Wiederholungsversuch statt wie einen Fehler.
Testen Sie den Lebenszyklus, bevor Sie ihn skalieren. Installieren Sie Apidog CLI, richten Sie Ihren Coding-Agenten auf die Batch-Endpunkte und halten Sie den generierten Testfall in CI laufen, damit eine Schemaänderung Sie nie bei 100.000 Anfragen überrascht. Der kostenlose Plan deckt 4 Benutzer ab, und Sie können Apidog herunterladen und den ersten Testfall in wenigen Minuten laufen haben.