
Chain of Recall ist ein Ansatz, um langlebigen KI-Agenten ein Gedächtnis zu geben, ohne deren Kontextfenster zu überladen. Jeder Trigger, Thread und Worker erhält eine dauerhafte ID. Im Kontext verbleiben lediglich IDs, kurze Zusammenfassungen und benachbarte Nachrichten – der Agent folgt dann den Verknüpfungen zwischen den IDs, um ältere Fakten in wenigen Schritten abzurufen.
Der Begriff stammt aus dem Design-Essay „Exploring Super-agent Design“ von DeepSeek Harness, der am 01.11.2026 veröffentlicht wurde. Ein wichtiger Hinweis vorab: Der Essay beschreibt eine Architektur, kein fertiges Produktfeature. Teile davon finden sich in einem Prototyp-Plugin namens dsh-superagent-prototype, das die Autoren ausdrücklich als „kein offizielles DeepSeek-Produkt“ bezeichnen. Es gibt keinen Schalter, mit dem sich Chain of Recall einfach aktivieren ließe – es handelt sich um ein Entwurfsmuster, das man selbst implementiert.
Das Kontextfenster-Problem bei langlebigen Agenten
Ein langlebiger Agent stößt unweigerlich an seine Kontextgrenzen, da kontinuierlich neue Aufgaben eingehen. Ein Super-Agent, der Chats, GitHub und CI-Pipelines überwacht, verarbeitet täglich Hunderte von Ereignissen – und das Fenster, das die Aufgaben von gestern enthielt, kann die von heute nicht auch noch aufnehmen.
Die üblichen Lösungsansätze haben alle ihren Preis:
- Alles behalten. Das Kontextfenster läuft voll und die Kosten steigen mit jedem Durchlauf.
- Ältere Abschnitte zusammenfassen. Eine Zusammenfassung lässt oft genau die Fehlermeldung oder PR-Nummer unter den Tisch fallen, die man später benötigt.
- Ähnlichkeitsbasierter Abruf (Similarity Search). Funktioniert so lange, bis die gesuchte Information semantisch nicht zur Suchanfrage passt.
Anthropics Leitfaden zu Context Engineering für KI-Agenten beschreibt den Kontext als begrenzte Ressource, die man gezielt kuratieren muss. Chain of Recall ist ein konkreter Weg für diese Kuration – und unser Übersichtsartikel darüber, wie das Gedächtnis von KI-Agenten funktioniert, beleuchtet das gesamte Spektrum der Möglichkeiten.
Inline vs. Spill: Der Kontext als Cache
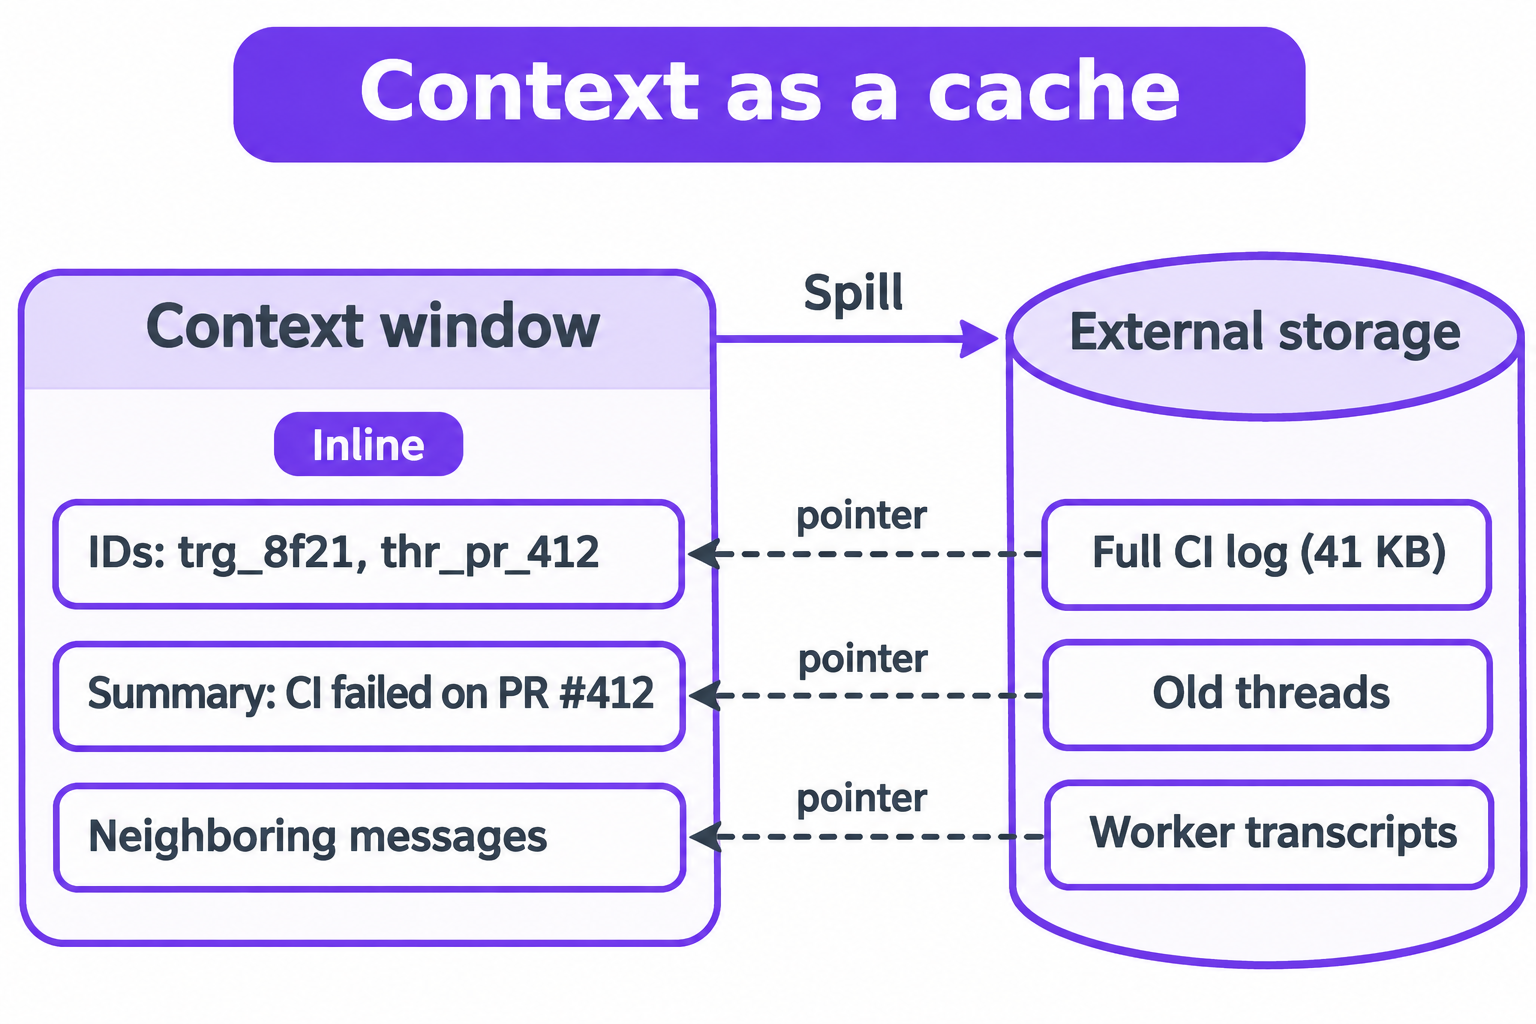
Der Essay betrachtet das Kontextfenster wie einen Cache mit zwei zentralen Operationen:
- Inline: Was der Agent unmittelbar benötigt, bleibt direkt im Kontext – IDs, kurze Zusammenfassungen, benachbarte Nachrichten.
- Spill: Alles andere wird ausgelagert – gekürzt und mit einem Zeiger versehen, dem der Agent bei Bedarf folgen kann.
Ein ausgelagertes Element wird nicht gelöscht; lediglich sein Zeiger verbleibt im Prompt.
So sieht das beispielsweise für einen CI-Fehlschlag aus, der beim Router eingeht. Diese Struktur dient der Veranschaulichung und stellt keinen Originalcode von DeepSeek dar:
{
  "trigger_id": "trg_8f21",
  "source": "github.check_run",
  "thread_id": "thr_pr_412",
  "summary": "CI failed on PR #412: 3 of 118 tests red in payments/",
  "neighbours": ["trg_8f1c: review comment asking for retry logic"],
  "spilled": {
    "full_log": "GET /triggers/trg_8f21/payload (41 KB, truncated)"
  }
}
Reicht die einzeilige Zusammenfassung aus, fallen für den Agenten keine Token-Kosten für das 41-KB-Log an. Reicht sie nicht, ruft er das Log gezielt über die ID ab.
Stabile IDs und der Referenzgraph
Chain of Recall funktioniert deshalb, weil sich die IDs niemals ändern. Im Design des Essays tragen drei Arten von Objekten solche IDs:
| Objekt | Beschreibung | Beispiel-ID |
|---|---|---|
| Trigger | Ein einzelnes eingehendes Ereignis: eine Chat-Nachricht, ein Webhook, ein CI-Callback | trg_8f21 |
| Thread | Eine Abfolge zusammenhängender Ereignisse zu einem PR, Chat-Thema oder E-Mail-Verlauf | thr_pr_412 |
| Worker | Eine isolierte Agenten-Sitzung, die eine bestimmte Aufgabe bearbeitet | wkr_77a0 |
Ein Trigger gehört zu einem Thread, ein Thread wird von einem oder mehreren Workern verwaltet, und der Bericht eines Workers verweist auf die Trigger, auf deren Basis er agiert hat. Diese Verknüpfungen bilden einen Referenzgraphen – und dieser Graph ist das Gedächtnis des Agenten.
Der Abruf erfolgt Schritt für Schritt durch das Verfolgen dieser Verknüpfungen – nicht durch das Laden des gesamten Verlaufs oder das Durchsuchen nach ähnlichen Texten. Der ergänzende Leitfaden zum Aufbau eines Super-Agenten erklärt, wie sich Trigger, Threads und Worker in das Gesamtdesign aus Router und Workern einfügen.
Schritt-für-Schritt: Multi-Hop-Recall in der Praxis
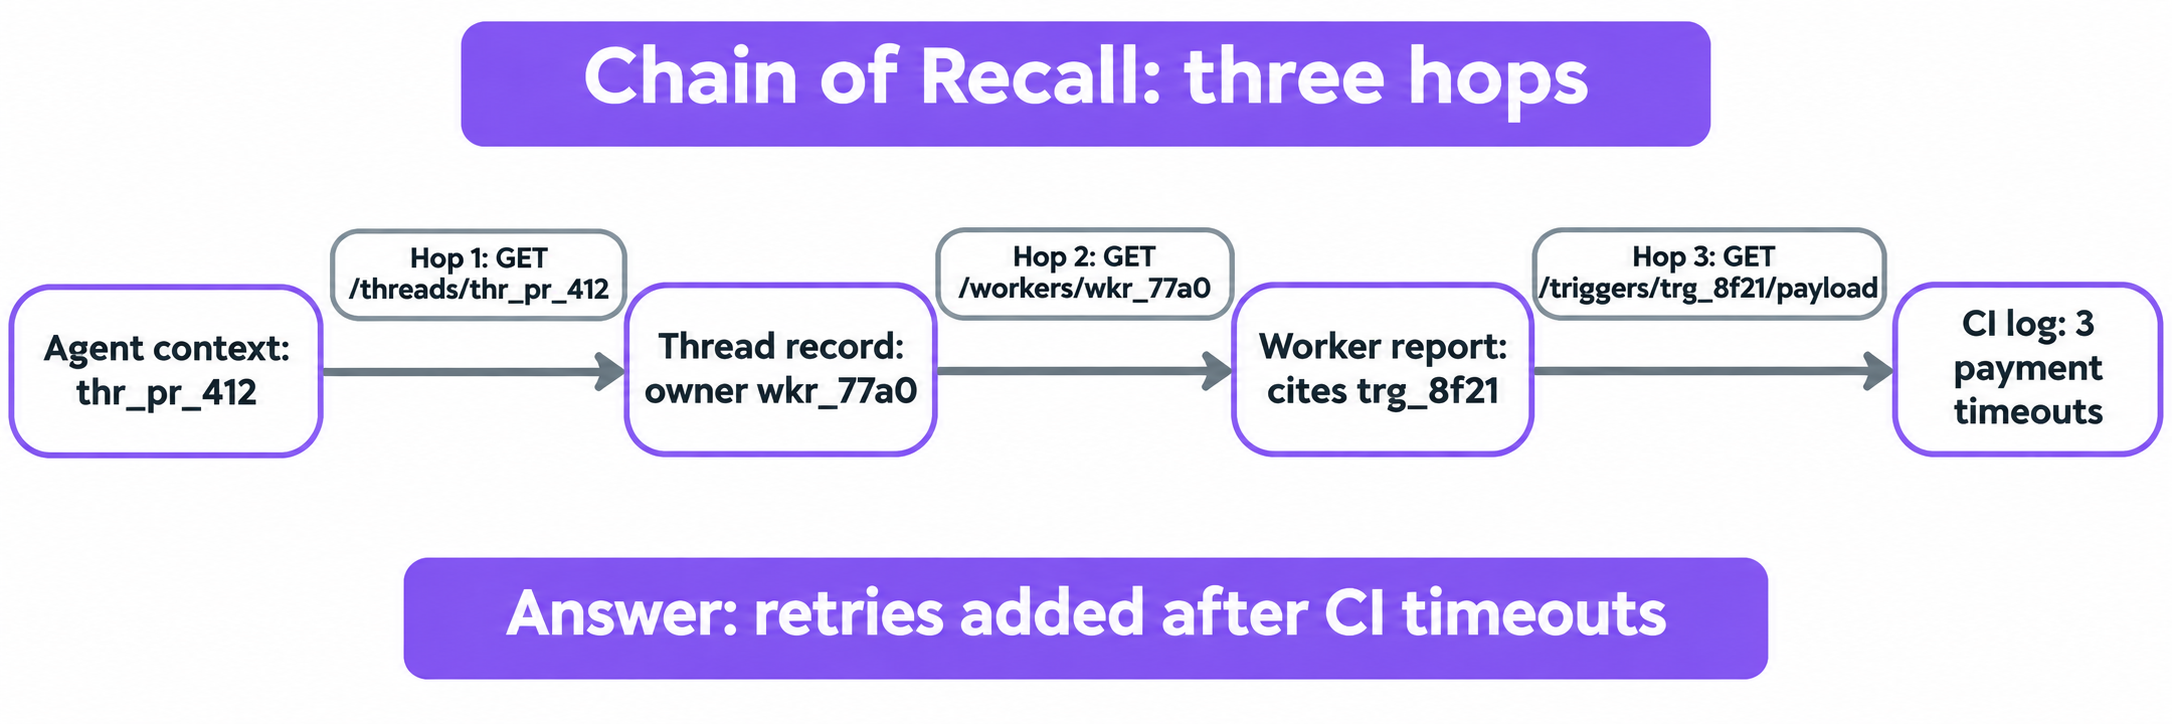
Angenommen, ein Teammitglied fragt den Router am Freitag: „Warum haben wir dem Payments-Client eine Retry-Logik hinzugefügt?“ Die ursprüngliche Diskussion fand am Dienstag statt und wurde längst ausgelagert. So läuft der Abruf ab:
- Schritt 1: Den Thread finden. Im Kontext des Routers befindet sich noch ein einzeiliger Indexeintrag:
thr_pr_412: payments retry PR, merged Wed. Er ruftGET /threads/thr_pr_412ab. - Schritt 2: Den Worker finden. Der Thread-Datensatz listet
owner_workers: ["wkr_77a0"]auf. Der Router ruftGET /workers/wkr_77a0ab und liest dessen Abschlussbericht. - Schritt 3: Die Ursache ermitteln. Der Bericht verweist auf
trg_8f21, den CI-Fehlschlag. Der Router ruft den Payload dieses Triggers ab und analysiert die Timeout-Fehler im Protokoll. - Antwort. „Die CI bei PR #412 schlug am Dienstag mit 3 Payment-Timeouts fehl. Worker wkr_77a0 hat Retries mit Backoff hinzugefügt, und der PR wurde am Mittwoch gemergt.“
Drei kleine, präzise API-Aufrufe. Nichts wurde erraten, und nichts musste drei Tage lang unnötig im Prompt verweilen.
Chain of Recall im Vergleich zu Vektorspeichern und Zusammenfassungen
Chain of Recall ersetzt andere Gedächtnistechniken nicht, sondern beantwortet eine grundlegend andere Frage. Der Vektorabruf, bekannt geworden durch das Paper zu Retrieval-Augmented Generation, fragt: „Was sieht dem hier ähnlich?“ Chain of Recall fragt hingegen: „Was ist damit verknüpft?“
| Chain of Recall | Vektorgedächtnis (RAG) | Fortlaufende Zusammenfassungen | Memory-MCP-Server | |
|---|---|---|---|---|
| Abrufmechanismus | Folgt Verknüpfungen über stabile IDs | Ähnlichkeitssuche über Embeddings | Liest einen komprimierten Verlauf | Ruft ein vom Server bereitgestelltes Memory-Tool auf |
| Präzision | Exakter Datensatz anhand der ID | Approximativ, nach Relevanz-Score sortiert | Konzeptionsbedingt verlustbehaftet | Hängt vom Speicher des Servers ab |
| Ideal für | Ereignisverläufe: PRs, Tickets, CI-Läufe | Große Dokumentenmengen, vage Fragestellungen | Kürzere Sitzungen, Chat-Kontinuität | Fakten, die über Tools und Sitzungen hinweg geteilt werden |
| Voraussetzungen | Unveränderliche IDs, Fetch-by-ID-APIs | Ein Embedding-Modell und einen Index | Einen Zusammenfassungsschritt (Summarizer) | Einen laufenden MCP-Server |
| Schwachstelle | Kann nichts finden, was nicht verknüpft ist | Übersieht Fakten, die anders formuliert sind | Verliert Details | Ein weiterer Dienst, der betrieben und abgesichert werden muss |
In der Praxis wird man diese Ansätze kombinieren: Ein Vektorindex findet eine anfängliche Thread-ID, und Chain of Recall navigiert von dort aus zu den exakten Fakten. Die an Betriebssysteme angelehnte Speicherhierarchie aus dem MemGPT-Paper ist ein eng verwandtes Konzept. Wenn Sie lieber mit einer vorgefertigten Speicherlösung starten möchten, hilft Ihnen unser Leitfaden zum Hinzufügen von persistentem Speicher für KI-Agenten mit MCP weiter.
Zwei Einschränkungen: Der Essay führt Langzeitgedächtnis unter den ungelösten Problemen auf und beansprucht keineswegs, dass Chain of Recall dieses Problem löst. Zudem stieg im dortigen Experiment durch das Entfernen des Thread-Pass-Throughs die Zahl der Cache-Read-Tokens von 23,2 Mio. auf 31,8 Mio. pro Durchlauf – ein Zuwachs von rund 37 %. Dies waren jedoch die Kosten eines fehlenden Features und keine Ersparnis durch Chain of Recall selbst.
Welche Garantien die zugrunde liegenden APIs bieten müssen
Jeder Schritt in diesem Ablauf ist ein API-Aufruf. Wenn ein einziger Aufruf einen falschen oder gar keinen Datensatz zurückgibt, reißt die Kette ab – und der Agent bleibt entweder hängen oder greift auf bloße Vermutungen zurück. Daher müssen die APIs hinter Chain of Recall vier verbindliche Zusagen erfüllen:
- IDs ändern sich niemals. Eine heute zurückgegebene ID muss auch im nächsten Monat noch auf dasselbe Objekt verweisen. Keine Wiederverwendung nach dem Löschen, keine Neunummerierung nach einer Migration.
- Fetch-by-ID ist ressourcenschonend und exakt.
GET /threads/{id}liefert genau diesen einen Datensatz zurück – ohne Suche und ohne „ähnlichste Treffer“. - Unbekannte IDs schlagen eindeutig fehl. Eine nicht gefundene ID liefert ein
404 Not Foundgemäß Definition in RFC 9110 mit einem aussagekräftigen Fehlertext. Ein200mit einem leeren Objekt signalisiert dem Agenten fälschlicherweise, dass ein Eintrag existiert. - Cursor-Paginierung ohne Lücken.
GET /threads/{id}/events?cursor=durchläuft einen langen Thread in der richtigen Reihenfolge. Jedes Ereignis erscheint genau einmal, nichts wird ausgelassen, und ein Cursor bleibt auch dann gültig, wenn neue Ereignisse eintreffen.
Solche Vereinbarungen brechen bei Refactorings oft unbemerkt und gehören daher zwingend in automatisierte Tests. Zudem müssen die Antworten von Tools kompakt gehalten werden, worauf unser Leitfaden zu Tool-Antworten bei Agenten und dem Kontextfenster detailliert eingeht.
Recall-APIs mit Ihrem Coding-Agenten und Apidog CLI testen
Chain of Recall ist nur so zuverlässig wie seine Fetch-by-ID-Endpunkte – und ein Coding-Agent kann diese Prüfungen für Sie erstellen und regelmäßig ausführen. Apidog CLI stellt dem Agenten Befehle bereit, um Endpunkte zu definieren, Testfälle zu erstellen und diese direkt über das Terminal auszuführen.
Die einmalige Einrichtung:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Geben Sie Claude Code, Codex oder dem von Ihnen genutzten Agenten anschließend folgenden Prompt:
In Apidog project <projectId>, define three endpoints for our agent memory
service: GET /threads/{id}, GET /threads/{id}/events?cursor=, and
GET /workers/{id}. Then create test cases that check:
1. A thread_id returned by GET /threads/{id} resolves to the same record
   on a second call, and each owner worker ID resolves via GET /workers/{id}.
2. An unknown thread ID and an unknown worker ID both return 404.
3. Paging GET /threads/{id}/events with the cursor returns every event
   once, in order, with no gaps.
Run them against the staging environment and summarize any failures.
Der Agent liest jedes Payload-Schema ein, validiert das JSON, bevor Daten geschrieben werden, und erstellt sowie führt die Testfälle aus:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file thread-get.json
apidog endpoint create --project <projectId> --file thread-get.json

apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file id-resolves.json
apidog test-case create --project <projectId> --file id-resolves.json

apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Der cli-Reporter gibt Bestanden- und Fehlgeschlagen-Meldungen pro Assertion im Terminal aus, während der json-Bericht dem Agenten eine Datei liefert, anhand derer er genau erklären kann, welcher Zwischenschritt fehlgeschlagen ist. Sollte eine ID nach einer Migration nicht mehr auflösbar sein, erkennen Sie dies im Bericht, noch bevor Ihr Agent falsche Antworten aus einer unterbrochenen Kette generiert. Um dieselben Prüfungen bei jedem Merge auszuführen, wechseln Sie einfach zum Reporter -r junit; unsere Anleitung zu Apidog CLI in Claude Code zeigt den gesamten Agenten-Workflow im Detail.
Wann sich Chain of Recall eignet
Setzen Sie auf Chain of Recall, wenn das Gedächtnis Ihres Agenten aus einer Historie einzelner, verknüpfbarer Ereignisse besteht: PRs, Tickets, CI-Läufe, Support-Threads oder Deployments. Diese besitzen von Natur aus bereits IDs, und typische Benutzerfragen dazu („Warum haben wir das gemacht?“, „Was geschah danach?“) zielen direkt auf solche Verknüpfungen ab.
Nutzen Sie Vektorabrufe für unstrukturierte Dokumente und vage Fragestellungen, und Zusammenfassungen für kurze Sitzungen, bei denen der Verlust von Details keine Rolle spielt.
Chain of Recall entspringt einem einzelnen Essay und einem Prototyp – eine klare, überprüfbare Idee, kein fertiges Produkt. Mehr über das Werkzeug hinter dem Essay erfahren Sie in unserem Beitrag darüber, was DeepSeek Harness ist.
FAQ
Ist Chain of Recall ein Feature von DeepSeek, das ich einfach aktivieren kann? Nein. Es handelt sich um einen Begriff aus dem Super-Agenten-Essay von DeepSeek Harness, und einzelne Teile existieren in einem Prototyp-Plugin, das laut den Autoren kein offizielles DeepSeek-Produkt ist. Sie müssen das Muster selbst implementieren.
Was ist der Unterschied zwischen Inline und Spill? Bei „Inline“ verbleiben IDs, kurze Zusammenfassungen und benachbarte Nachrichten direkt im Prompt. Bei „Spill“ wird der Rest gekürzt und durch einen Zeiger ersetzt, den der Agent bei Bedarf über die ID abrufen kann.
Ersetzt Chain of Recall RAG? Nein. RAG findet ähnliche Inhalte; Chain of Recall folgt exakten ID-Verknüpfungen. Viele Agenten kombinieren beide Ansätze.
Hat Chain of Recall den Token-Verbrauch um 37 % reduziert? Nein. Die 37 % beziehen sich auf den Thread-Pass-Through: Dessen Entfernung erhöhte im Experiment des Essays die Cache-Read-Tokens von 23,2 Mio. auf 31,8 Mio. pro Durchlauf. Für Chain of Recall selbst wird im Essay keine Token-Ersparnis ausgewiesen.
Was sollte eine Fetch-by-ID-API bei einer unbekannten ID zurückgeben? Ein 404 Not Found mit einem eindeutigen Fehlertext. Die Rückgabe von 200 mit einem leeren Objekt lässt den Agenten fälschlicherweise glauben, ein Datensatz existiere, was die Abrufkette unbemerkt unterbricht.
Wie teste ich, ob die Gedächtnis-APIs meines Agenten stabil bleiben? Schreiben Sie Testfälle, die sicherstellen, dass eine ID aus einem Aufruf im nächsten aufgelöst werden kann, unbekannte IDs einen 404-Statuscode liefern und Cursor lückenlos paginieren. Ein Coding-Agent kann diese Prüfungen mit Apidog CLI bei jedem Merge automatisch erstellen und ausführen.