
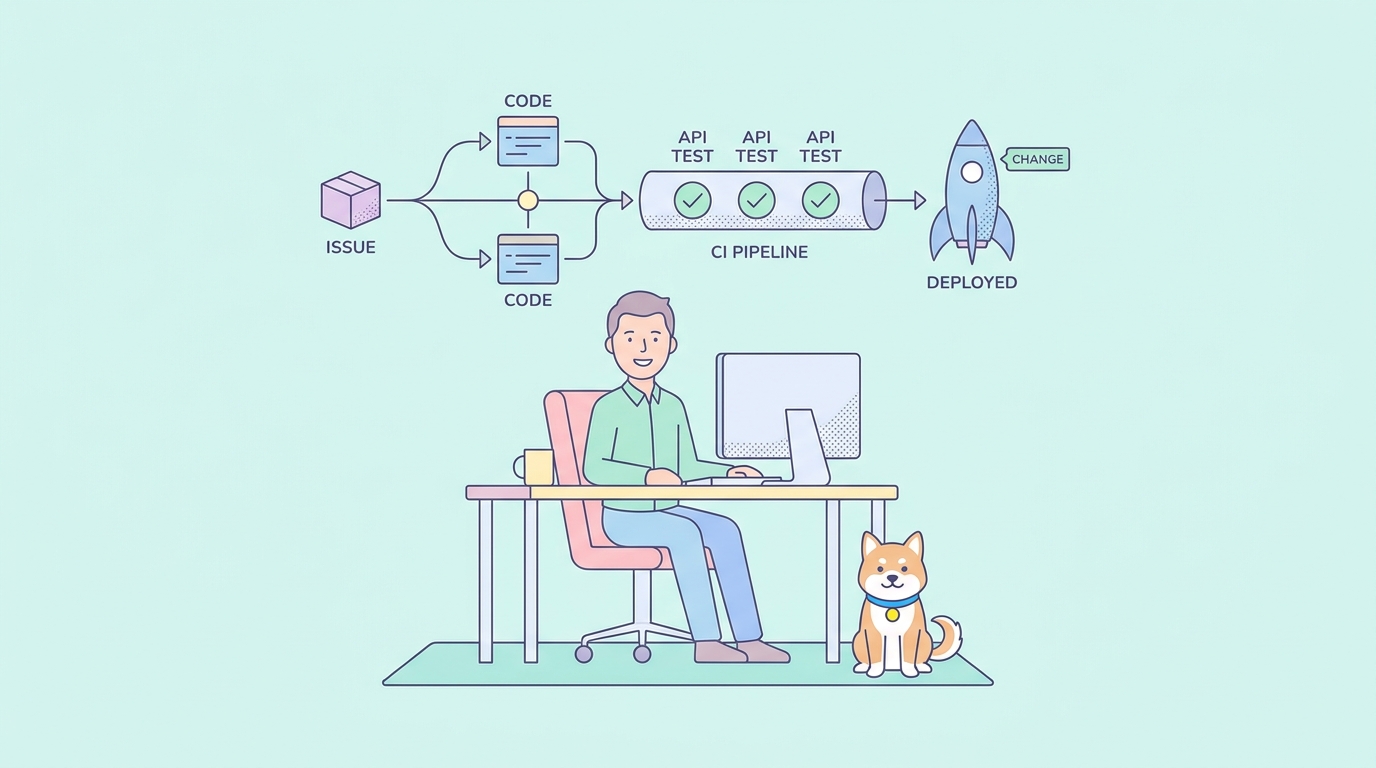
Gergely Orosz's Diagram von OpenAIs interner Softwarefabrik machte diese Woche die Runde: Ein Entwickler meldet ein Ergebnis, Codex schreibt den Code, eine Flotte spezialisierter Prüfungsagenten diskutiert über Risiken, und ein Agent überwacht die Bereitstellung, während er selbst erstellte Dashboards beobachtet. Für die Teile, die OpenAIs eigenen Ingenieuren am wichtigsten sind, ist es auch eine Beschreibung interner Tools, die Sie nicht installieren können.
Perf Factory, Sevbot und die agentenbasierte Bereitstellung mit selbst erstellten Dashboards laufen auf OpenAIs eigenem Observability-Stack und sind nicht Teil des Codex-Produkts, das Sie kaufen können. Was Sie diese Woche aufbauen können, ist eine kleinere Schleife, die dennoch echte Arbeit leistet: Ein Entwickler definiert das Ergebnis als ein Problem, Codex bearbeitet den Branch, CI prüft, ob die Änderung tatsächlich wie erwartet funktioniert, ein oder zwei Prüfungsagenten sehen sich das an, und ein Mensch genehmigt alles Risikoreiche, bevor es hinter einem Feature-Flag ausgeliefert wird. Das Ganze hängt von einem Detail ab, das das ursprüngliche Diagramm übergeht: „CI bestanden“ bedeutet nur etwas, wenn CI die richtigen Dinge prüft. Für eine API bedeutet das, die API zu testen, nicht nur den Code, der sie aufruft.
Was das Diagramm richtig macht (und was Sie nicht kopieren können)
Der öffentliche Teil des Artikels von Pragmatic Engineer beschreibt eine Kernschleife, in der Codex „eine Reihe von Codeänderungen vornimmt, bis es sein Ziel erreicht hat, und dann überprüft, ob die Software wie erwartet funktioniert.“ Bereiche mit geringem Risiko können automatisch genehmigt werden; Änderungen mit höherem Risiko erhalten mehr KI-Überprüfung oder eine obligatorische menschliche Freigabe. Diese Struktur – vorschlagen, überprüfen, nach Risikostufe prüfen – ist portierbar. Teams haben dies seit Jahren mit Pull-Request-Bots und CI-Gates angenähert; Agenten machen die Schleife lediglich schneller und weniger überwacht.
Nicht portierbar ist die interne Maschinerie drumherum. Perf Factory filtert Alerts und Dashboards, um Latenz-Regressionen zu finden und Behebungen vorzuschlagen. Sevbot untersucht Incidents und beantwortet Fragen in Slack, führt jedoch selbst keine Abhilfemaßnahmen aus. Agentic Deploy überwacht eine Änderung in der Produktion und erstellt ein eigenes Monitoring unter Verwendung von OpenAIs internem Telemetrie-Stack. Keines dieser drei ist im externen Codex-Produkt enthalten. Geliefert wurden die Desktop-App, der Befehl /goal für langlaufende Aufgaben sowie Rollen-Plugins und Fähigkeiten, die Sie selbst konfigurieren. OpenAIs Codex-Produktseite deckt ab, was tatsächlich verfügbar ist.
Die Fünf-Schritte-Schleife, die Sie diese Woche ausführen können
Eine verkleinerte Version sieht so aus:
- Ein Entwickler meldet das Ergebnis als Problem. Keine Aufgabenliste, sondern eine Beschreibung des Endzustands: „Bestellungen können einen optionalen Rabattcode enthalten, der den Gesamtbetrag reduziert.“ Die Übergabe desselben GitHub-Problems an einen Agenten in Sharkly ist die ausgelieferte Integration: Das Problem wird zu einer Aufgabe, und der Durchlauf kommt als PR zurück, anstatt als separates Ticket zur Abstimmung. Es ist derzeit kostenlos für Organisationen mit bis zu 10 Personen.
- Codex bearbeitet den Branch mit
/goal. Wie in der Funktionsweise des/goal-Befehls für autonome Codex- und Claude-Code-Läufe beschrieben, geben Sie dem Agenten ein Ziel und lassen ihn selbstständig iterieren, bis das Ziel erreicht ist. - CI führt Build, Unit-Tests und API-Testszenarien aus. Dies ist der Schritt, den die meisten Teams überspringen oder nur halb umsetzen.
- Ein oder zwei Prüfungsagenten überprüfen den Diff, und ein Mensch überprüft alles, was über ein geringes Risiko hinausgeht. KI-Code-Review-Tools können vieles abfangen, bevor ein Mensch überhaupt den PR öffnet. In Sharkly ist dies der Punkt, an dem „Ready for Release“ die Arbeit erledigt: Ein Mensch muss die Aufgabe aus diesem Status verschieben, bevor etwas als „Erledigt“ gilt, und ein separater Prüfungsagent kann in derselben Crew sitzen wie derjenige, der den Code geschrieben hat.
- Bereitstellung hinter einem Feature-Flag, damit ein fehlerhafter Merge ein Schalter ist und kein Vorfall.
Schritt 3 ist der Punkt, an dem die Schleife entweder funktioniert oder Sie anlügt.
Warum CI die API testen muss, nicht nur den Code
Die eigene Überprüfungsfunktion von Codex, die in der Funktionsweise der Codex-Code-Überprüfung beschrieben wird, liest den Diff und markiert offensichtliche Probleme. Sie führt Ihren Dienst nicht aus und prüft nicht, was er zurückgibt. Unit-Tests, falls der Agent sie geschrieben oder beibehalten hat, überprüfen hauptsächlich, ob der Code das tut, was der Code beabsichtigt, was nicht dasselbe ist wie die Überprüfung, ob die API das tut, was der Vertrag verspricht. Ein Agent, der einen Handler bearbeitet, kann jeden Unit-Test bestehen, während er stillschweigend die Antwort bricht, auf die jeder Client angewiesen ist.
Nehmen wir an, Sie betreiben eine Bestell-API. POST /api/orders erstellt eine Bestellung und gibt deren Datensatz zurück; GET /api/orders/{id} ruft eine Bestellung anhand der ID ab. Sie pflegen eine OpenAPI-Spezifikation für beide und haben Apidog-Testszenarien dagegen erstellt: Erstellen Sie eine Bestellung, rufen Sie sie ab und überprüfen Sie vier Dinge, die ein Unit-Test typischerweise nicht tun würde:
- Statuscodes.
POST /api/ordersgibt201zurück, nicht200oder einen stillen500bei einem Validierungs-Grenzfall. - Antwortschema gegen die OpenAPI-Spezifikation. Das Feld
total_amountbleibt eine Zahl,statusbleibt einer der von Ihnen definierten Enum-Werte, und kein Feld, auf das Clients angewiesen sind, verschwindet stillschweigend oder wird umbenannt. - Auth-Fehler. Eine Anfrage ohne gültiges Token gibt
401zurück, nicht 200 mit leerem Body, was eine überraschend häufige Regression ist. - Ein Latenzschwellenwert. Das Szenario bestätigt, dass die Antwort innerhalb eines festgelegten Limits zurückkommt, sodass eine Änderung, die einen ungebatched Datenbankaufruf im Handler hinzufügt, abgefangen wird, bevor ein Kunde dies bemerkt.
Das sind genau die Prüfungen, die eine Refaktorierung auf Handler-Ebene stillschweigend unterbrechen kann, während jeder Unit-Test immer noch bestanden wird, da Unit-Tests normalerweise die Grenze mocken, die das API-Szenario tatsächlich trainiert.
Integration in die Pipeline
Sie führen die CLI-Version dieser Szenarien bereits lokal aus, wenn Sie die Verwendung der Apidog CLI in Codex befolgt haben. Derselbe Befehl läuft in CI. Ein GitHub Actions Job, der baut, Unit-Tests ausführt und dann das Apidog-Szenario startet, sieht so aus:
name: CI

on:
  pull_request:
  push:
    branches: [main]

jobs:
  build-test-verify:
    runs-on: ubuntu-latest
    steps:
      - name: Check out repository
        uses: actions/checkout@v4

      - name: Set up Node.js
        uses: actions/setup-node@v4
        with:
          node-version: '20'

      - name: Install dependencies
        run: npm ci

      - name: Build and run unit tests
        run: npm run build && npm test

      - name: Install Apidog CLI
        run: npm install -g apidog-cli

      - name: Run orders API test scenario
        env:
          APIDOG_ACCESS_TOKEN: ${{ secrets.APIDOG_ACCESS_TOKEN }}
        run: |
          apidog run \
            --access-token $APIDOG_ACCESS_TOKEN \
            -t 88214 \
            -e 3301 \
            -r cli,junit

      - name: Upload Apidog reports
        if: always()
        uses: actions/upload-artifact@v4
        with:
          name: apidog-reports
          path: apidog-reports/
Die Werte für -t und -e sind Ihre echten Szenario- und Umgebungs-IDs von Apidog, keine Platzhalter, die Sie sich ausdenken. Die Referenz zum Befehl apidog run deckt jedes Flag ab, und Apidog CLI-Testberichte erklären die JUnit-Ausgabe, die der Job hochlädt. apidog run beendet sich mit einem Nicht-Null-Wert bei jeder fehlgeschlagenen Assertion, sodass GitHub Actions den Job auf dieselbe Weise als fehlgeschlagen markiert, wie es bei einem fehlgeschlagenen Unit-Test der Fall wäre.
Wie der Prompt des Agenten aussieht
Der Sinn von /goal ist, dass Sie das Ergebnis und die Abbruchbedingung beschreiben, und Codex iteriert, ohne dass Sie jeden Schritt genehmigen müssen. Für das Beispiel mit dem Rabattcode wäre ein vernünftiger Prompt:
/goal Add an optional `discount_code` field to POST /api/orders. Validate it
against the promotions service and apply the discount to `total_amount` in
the response. Do not rename or remove any existing response field. Run
`npm test` and `apidog run --access-token $APIDOG_ACCESS_TOKEN -t 88214 -e 3301
-r cli` before you finish. Both must exit 0. If the Apidog run fails, read the
failing assertion and fix the handler, not the test.
Diese letzte Zeile ist wichtig. Ein Agent, der unter Druck steht, einen Check auf Grün zu stellen, wird manchmal die Assertion anstatt den Fehler bearbeiten. Indem man ihm explizit sagt, welche Seite der Schleife zu korrigieren ist, bleibt das Testszenario die Quelle der Wahrheit und kein Hindernis, das umgangen werden muss.
Wenn der Agent den Vertrag bricht
Codex fügt das Rabattfeld hinzu und benennt dabei total_amount in totalAmount um, da dies die Konvention in einer Datei ist, die es in der Nähe gelesen hat. Unit-Tests bestehen immer noch; sie prüfen die Rabattberechnung, nicht den Feldnamen. Der Build ist erfolgreich. Dann läuft das Apidog-Szenario in CI, validiert die Antwort gegen die OpenAPI-Spezifikation und schlägt fehl: Die Spezifikation sagt total_amount, die Antwort hat jetzt totalAmount, und die Schema-Assertion fängt es sofort ab.
CI meldet einen Exit-Code ungleich Null und verweist auf die fehlgeschlagene Schema-Assertion in der JUnit-Ausgabe. Codex liest den Fehler, erkennt, dass die Umbenennung die Ursache ist, und macht sie rückgängig, während die Rabattlogik beibehalten wird. Das Szenario besteht, der Build wird grün, und der Pull Request geht zur Überprüfung mit einer tatsächlichen Garantie hinter dem Wort „bestanden“. Ohne die API-Level-Prüfung würde diese Umbenennung ausgeliefert, und jeder Client, der total_amount parst, würde bei der nächsten Veröffentlichung brechen.
Risikostufung, die Sie in der Spezifikation verankern können
Anstatt eines vagen Gefühls dafür, was als geringes Risiko gilt, verknüpfen Sie Ihre Risikoklassifizierung mit dem OpenAPI-Diff. Eine Änderung, die ein optionales Feld mit einem Standardwert hinzufügt, ist ein Kandidat für ein Auto-Merge, sobald die Tests bestanden sind. Eine Änderung, die ein Feld entfernt, umbenennt oder einen Statuscode ändert, ist niemals ein geringes Risiko, unabhängig davon, wie der Rest des Diffs aussieht. Diese einzige Regel fängt das meiste ab, was ein spezialisierter Prüfungsagent ohnehin markieren würde. Leiten Sie alles, was die Regel markiert, an einen menschlichen Prüfer oder einen zweiten Durchlauf durch ein KI-Code-Review-Tool weiter, bevor Sie es mergen.
Hinter einem Flag ausliefern, nicht ins Leere
Sobald eine Änderung CI und Überprüfung durchlaufen hat, stellen Sie sie hinter einem Feature-Flag bereit, anstatt sie direkt an jeden Benutzer zu liefern. Dies ist der günstige Ersatz für OpenAIs agentenbasierten Bereitstellungsschritt: kein Agent, der den Rollout überwacht oder eigene Dashboards erstellt. Ein Flag, das bei 5 % des Datenverkehrs beginnt, und eine Person, die die Fehlerraten überprüft, bevor sie auf 100 % umgestellt wird, bietet Ihnen den Großteil der Sicherheit ohne die internen Tools. Wenn etwas nicht stimmt, schalten Sie das Flag aus, anstatt einen Merge unter Druck rückgängig zu machen.
Ein Gerüst, das bereits existiert
Sie müssen nicht alle fünf Schritte von Grund auf neu verdrahten. orchflows ist ein Open-Source-Projekt, das in den Antworten auf Orosz' Thread auftauchte: ein MIT-lizenziertes /software-factory-Kommando für Claude Code und Codex, das auf einer kleinen Anzahl wiederverwendbarer Fähigkeiten aufbaut. Es ist ein Startgerüst, kein Ersatz für die oben genannten CI- und Review-Schritte; Sie weisen es immer noch auf Ihre eigenen Testszenarien und Risikoregeln hin.
Was man nicht bauen sollte
Versuchen Sie nicht, Perf Factory, Sevbot oder agentenbasierte Bereitstellung mit selbst erstellten Dashboards zu reproduzieren. Dies sind interne OpenAI-Systeme, die an Telemetriedaten angeschlossen sind, die die meisten Teams nicht verwenden. Menschen bei OpenAI definieren immer noch Ergebnisse, genehmigen risikoreiche Änderungen, autorisieren Incident-Mitigationen und halten Rufbereitschaft; wie OpenAI es ausdrückte: „Rufbereitschaft gehört nicht der Vergangenheit an.“ Kopieren Sie die Teile der Schleife, die einfach gute Ingenieursdisziplin sind: vor dem Mergen überprüfen, das Risiko nach dem, was sich tatsächlich geändert hat, staffeln und bei allem, was nicht offensichtlich sicher ist, einen Menschen hinzuziehen.
Die Schleife in Gang bringen
Beginnen Sie mit dem CI-Schritt; er macht jeden anderen Schritt vertrauenswürdig. Erstellen Sie Ihr Bestell-API-Testszenario in Apidog, das Statuscodes, Schema, Authentifizierung und ein Latenzbudget abdeckt. Integrieren Sie es mit der CLI in Ihre Pipeline, richten Sie /goal auf ein echtes Problem und lassen Sie Codex gegen eine Überprüfung iterieren, die tatsächlich das API-Verhalten bestätigt, anstatt dem Wort des Agenten zu vertrauen. Laden Sie Apidog herunter, um das erste Szenario zu erstellen, und fügen Sie dann die Überprüfungs- und Flag-Schritte hinzu, sobald sich die Schleife bewährt hat.