
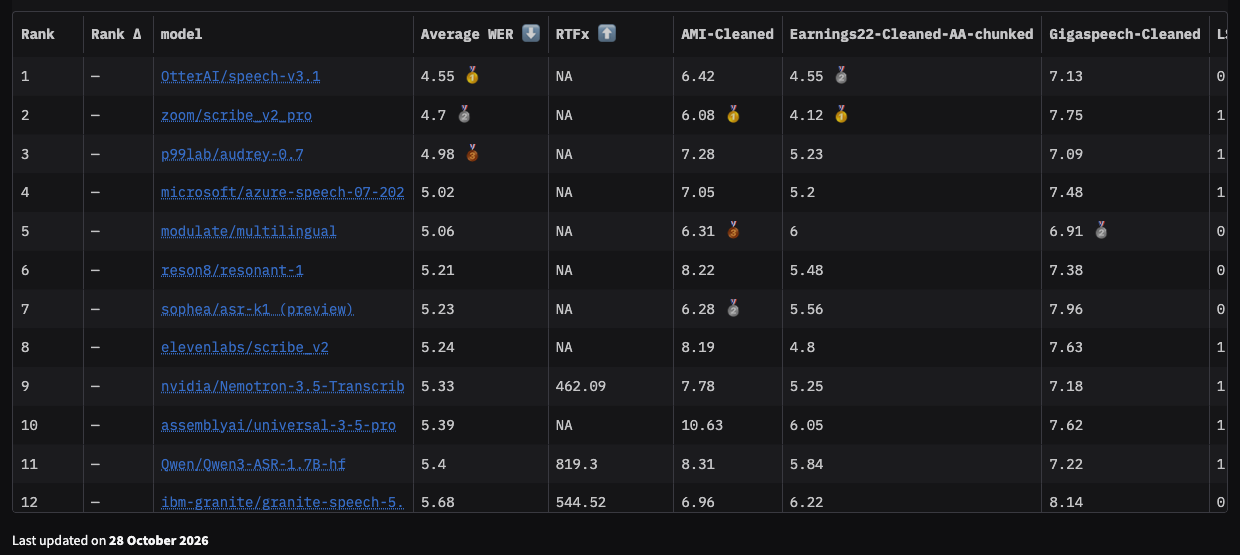
Das beste Open-Source-Sprache-zu-Text-Modell im Oktober 2026 ist NVIDIAs Nemotron 3.5 Transcribe, veröffentlicht am 28. Oktober. Auf dem am selben Tag aktualisierten Hugging Face Open ASR Leaderboard erreicht es durchschnittlich 5,33 % Wortfehlerrate und belegt Platz 9 von 61 Modellen. Alle acht Modelle darüber sind geschlossene kommerzielle APIs. OpenAIs whisper-large-v3, in vielen Tutorials noch Standard, liegt mit 7,16 % auf Platz 41.
Im Folgenden finden Sie die neun derzeit erwägenswerten Open-Weight-Spracherkennungsmodelle, geordnet nach diesem Leaderboard, mit Geschwindigkeit, Stärken und der Aufgabe, für die jedes geeignet ist. Jede WER- und Geschwindigkeitsangabe stammt aus dem Leaderboard mit Stand vom 29. Oktober 2026.
Wenn Sie stattdessen zwischen gehosteten APIs wählen, lesen Sie unseren Nemotron 3.5 Transcribe API-Leitfaden und den Whisper API-Leitfaden.
Wie wir sie bewertet haben
Das Open ASR Leaderboard testet jedes Modell auf denselben englischen Testsets: Meetings (AMI), Earnings Calls (Earnings22), Podcasts und YouTube (GigaSpeech), Hörbücher (LibriSpeech), Finanzgespräche (SPGISpeech), verrauschte Sprache (URGENT24), Konversationsaudio (Voice Arena Monsoon), Parlamentsreden (VoxPopuli) und zwei private Sets. Die Ranking-Metrik ist die durchschnittliche WER, wobei niedriger besser ist.
Wir listen außerdem RTFx auf, das Geschwindigkeitsmaß des Leaderboards: Sekunden transkribierten Audios pro Sekunde Rechenzeit. Höher ist schneller. Geschlossene APIs zeigen „NA“, weil sie auf derselben Hardware nicht gemessen werden können.
Wir haben ein Modell als Open-Weight gezählt, wenn sein Checkpoint herunterladbar ist und das Leaderboard eine RTFx dafür meldet. Prüfen Sie jede Lizenz vor der kommerziellen Nutzung.
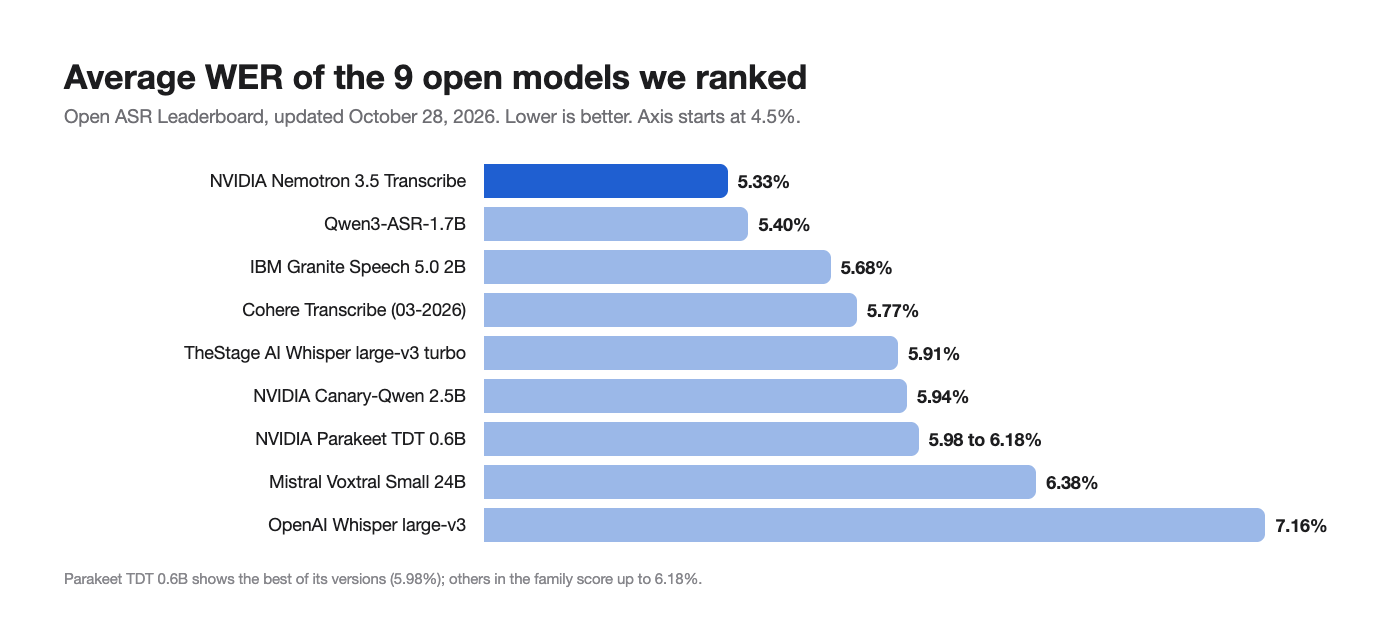
Die Rangliste auf einen Blick
| Rang (offen) | Modell | Durchschn. WER | RTFx | Gesamtrang |
|---|---|---|---|---|
| 1 | NVIDIA Nemotron 3.5 Transcribe 30B-A4B | 5,33 % | 462 | 9 |
| 2 | Qwen3-ASR-1.7B | 5,40 % | 819 | 11 |
| 3 | IBM Granite Speech 5.0 2B | 5,68 % | 545 | 12 |
| 4 | Cohere Transcribe (03-2026) | 5,77 % | 902 | 14 |
| 5 | TheStage AI Whisper large-v3 turbo | 5,91 % | 1.177 | 17 |
| 6 | NVIDIA Canary-Qwen 2.5B | 5,94 % | 862 | 21 |
| 7 | NVIDIA Parakeet TDT 0.6B (Versionen) | 5,98 % bis 6,18 % | nicht verglichen | 24 bis 31 |
| 8 | Mistral Voxtral Small 24B | 6,38 % | nicht verglichen | 35 |
| 9 | OpenAI Whisper large-v3 | 7,16 % | nicht verglichen | 41 |
Zum Vergleich die besten geschlossenen APIs auf demselben Board: Otter speech-v3.1 mit 4,55 %, Zoom Scribe v2 Pro mit 4,70 %, ElevenLabs Scribe v2 mit 5,24 %, AssemblyAI Universal-3.5 Pro mit 5,39 % und OpenAI gpt-transcribe mit 5,96 %. Nemotron 3.5 Transcribe schlägt AssemblyAI und OpenAIs gehostetes Modell und ist dabei kostenlos herunterladbar.
1. NVIDIA Nemotron 3.5 Transcribe: insgesamt am besten
5,33 % WER, RTFx 462, OpenMDW-1.1-Lizenz
NVIDIAs neues Modell ist kein klassisches ASR-Netzwerk. Es ist ein sprachaugmentiertes Sprachmodell: Ein ASR-Encoder mit 600 Mio. Parametern und ein Sprecher-Encoder speisen ein hybrides Mamba-2- und Transformer-Mixture-of-Experts-LLM mit insgesamt 34 Mrd. und etwa 4,3 Mrd. aktiven Parametern. Dieses Design ist der Grund, warum es mehr als nur transkribieren kann.
Warum es den ersten Platz belegt:
- 40 Sprachen, davon 13 als „führend“ eingestuft
- Dateien von einer Stunde Länge in einem Durchgang, mit 65.536-Token-Kontext
- Sprecherzuordnung (bis zu acht Sprecher) und Wort-Zeitstempel aus einem Modell
- Prompts: wörtlicher oder bereinigter Wortlaut, Kontextbegriffe für Fachjargon, Übersetzung
- Genauigkeit bei Langform: 10,98 % mittlere WER auf den Langform-Sets des Leaderboards, gegenüber 13,37 % für Parakeet-TDT-0.6B-v3, laut Model Card
- Meetings: 15,80 % mittlere cpWER auf Multi-Speaker-Sets, vor der DiCoW-plus-DiariZen-Pipeline mit 16,83 %
Nachteile: Es benötigt eine große GPU (eine H100 mit 80 GB in BF16 oder eine RTX 5090 mit NVFP4-Gewichten), es streamt nicht, und Audio-Question-Answering ist nur auf Englisch möglich.
Wählen Sie es für: Meetings, Podcasts, Earnings Calls, mehrsprachige Archive und alles, bei dem Sprecherbezeichnungen oder einstündige Dateien wichtig sind. Beginnen Sie mit den kostenlosen Wegen oder führen Sie es lokal aus.
2. Qwen3-ASR-1.7B: beste Genauigkeit pro GPU-Dollar
5,40 % WER, RTFx 819
Alibabas Qwen3-ASR-1.7B liegt beim englischen Durchschnitt nur 0,07 Punkte hinter Nemotron, läuft aber auf der Hardware des Leaderboards etwa 1,8-mal schneller – mit einem Modell, das ein Zwanzigstel der Gesamtgröße hat. In NVIDIAs eigenem mehrsprachigen Vergleich über sieben Sprachen führt Nemotron deutlicher: 4,62 % mittlere WER gegenüber 6,49 %.
Wählen Sie es für: stark englischlastige Batch-Transkription auf kleineren GPUs, wo Sie keine integrierte Sprecherzuordnung benötigen. Wenn Sie bereits Qwens multimodale Modelle nutzen, lesen Sie unseren Leitfaden zu Qwen3.5-Omni.
3. IBM Granite Speech 5.0 2B: am besten für Meeting-Audio in seiner Größenklasse
5,68 % WER, RTFx 545
IBMs Granite Speech 5.0 erzielt eine WER von 6,96 % bei AMI-Meetingaufnahmen, den besten AMI-Wert unter den sechs besten offenen Modellen hier und besser als Nemotrons 7,78 % dort. Seine Schwachstelle sind SPGISpeech-Finanzgespräche mit 3,36 %.
Wählen Sie es für: Unternehmensteams, die sich auf IBMs Granite-Stack standardisieren, und Meeting-Transkription auf Mittelklasse-GPUs.
4. Cohere Transcribe: schnell und genau
5,77 % WER, RTFx 902
Das Transkriptionsmodell von Cohere Labs vom März 2026 kombiniert einen Genauigkeitswert unter den Top fünf der offenen Modelle mit einer der höchsten Geschwindigkeiten hier. Am stärksten ist es bei LibriSpeech (0,97 % clean, 2,05 % other) und schwächer bei VoxPopuli mit 5,38 %.
Wählen Sie es für: englischsprachige Pipelines mit hohem Volumen, bei denen der Durchsatz genauso wichtig ist wie die Genauigkeit.
5. TheStage AI Whisper large-v3 turbo: schnellstes in der Spitzengruppe
5,91 % WER, RTFx 1.177
Dies ist ein optimierter Whisper-large-v3-turbo-Build von TheStage AI und das schnellste Modell in unserer Liste. Es erzielt 1,62 % bei SPGISpeech, den drittbesten Wert in diesem Set über alle 61 Modelle hinweg. Es zeigt, wie viel Leben noch in der Whisper-Familie steckt, wenn jemand sie optimiert.
Wählen Sie es für: Teams mit vorhandenem Whisper-Code, die ein Drop-in-Upgrade bei Geschwindigkeit und Genauigkeit wünschen.
6. NVIDIA Canary-Qwen 2.5B: das vorherige NVIDIA-Flaggschiff
5,94 % WER, RTFx 862
Canary-Qwen war NVIDIAs früheres Speech-plus-LLM-Modell, und Nemotron 3.5 Transcribe ersetzt es an der Spitze. Es ist immer noch schnell, und sein SPGISpeech-Wert von 1,70 % ist hervorragend. In NVIDIAs Preference-ASR-Test erzielt Nemotron 7,56 % gegenüber Canary-Qwens 8,16 %.
Wählen Sie es für: bestehende NeMo-Deployments, die noch nicht auf eine 80-GB-GPU umsteigen können.
7. NVIDIA Parakeet TDT 0.6B: kleinste ernstzunehmende Option
5,98 % bis 6,18 % WER je nach Version
Parakeet TDT hat mehrere Versionen mit 0,6 Mrd. Parametern auf dem Board, alle innerhalb von etwa 0,2 Punkten zueinander. Mit 600 Mio. Parametern ist es das kleinste Modell hier, das nahe an 6 % WER bleibt, sodass es auf bescheidenen GPUs läuft. Seine Schwäche ist Langform-Audio, wo Nemotron es um mehr als zwei Punkte schlägt.
Wählen Sie es für: Edge-Geräte, günstige GPUs und kurze Clips wie Sprachbefehle oder Ausschnitte aus Anrufen.
8. Mistral Voxtral Small 24B: Sprache plus ein starkes LLM
6,38 % WER
Voxtral Small kombiniert Spracheingabe mit einem 24-Mrd.-Mistral-Sprachmodell, kann also wie Nemotron Fragen zu Audio beantworten und nicht nur transkribieren. Bei der reinen WER liegt es hinter den Top fünf. Unsere Gegenüberstellung Voxtral vs. Whisper behandelt seine frühere Veröffentlichung ausführlich.
Wählen Sie es für: Sprachassistenten und Audio-Q&A, wo das Sprachmodell wichtiger ist als der letzte Punkt WER.
9. OpenAI Whisper large-v3: die Baseline
7,16 % WER, Gesamtplatz 41
Whisper large-v3 ist immer noch das am weitesten verbreitete offene Modell, mit dem größten Ökosystem aus Wrappern, Fine-Tunes und Tutorials. Bei der Genauigkeit liegt es jetzt hinter jedem anderen Modell in dieser Liste. Wenn Sie es in Produktion einsetzen, ist ein Wechsel zu einem der Top sechs das günstigste verfügbare Qualitätsupgrade.
Wählen Sie es für: Prototypen, die auf Whisper-spezifisches Tooling angewiesen sind, oder als Baseline, die es zu schlagen gilt.
Welches sollten Sie wählen?
| Ihre Aufgabe | Wahl |
|---|---|
| Meetings mit mehreren Sprechern | Nemotron 3.5 Transcribe |
| Einstündige Podcasts oder Anrufe in einem Durchgang | Nemotron 3.5 Transcribe |
| Mehrsprachige Archive | Nemotron 3.5 Transcribe |
| Englische Batch-Jobs auf kleineren GPUs | Qwen3-ASR-1.7B |
| Maximaler Durchsatz | TheStage Whisper large-v3 turbo oder Cohere Transcribe |
| Edge- oder kostengünstige Hardware | Parakeet TDT 0.6B |
| Audio-Q&A plus Transkription | Nemotron 3.5 Transcribe oder Voxtral Small |
| Vorhandener Whisper-Code, minimale Änderung | TheStage Whisper large-v3 turbo |
Eine Warnung: Leaderboard-Durchschnitte verdecken Domänenlücken. Nemotron ist insgesamt am besten, doch Granite schlägt es bei AMI, und mehrere Modelle schlagen es bei LibriSpeech. Testen Sie die besten zwei oder drei mit 50 bis 100 Ihrer eigenen Aufnahmen, bevor Sie sich festlegen.
Benchmark-Kandidaten mit Ihrem Coding-Agenten und der Apidog CLI
Der schnellste Weg, diesen Vergleich durchzuführen, ist, Ihren Coding-Agenten damit zu beauftragen. Stellen Sie zwei oder drei Modelle hinter OpenAI-konformen /v1/audio/transcriptions-Endpunkten bereit (SGLang-Omni stellt Nemotron so bereit), und lassen Sie den Agenten dann mit der Apidog CLI dieselben Prüfungen für jedes davon erstellen und ausführen.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Geben Sie Ihrem Agenten dann einen Prompt:
In Apidog project <id>, create one environment per speech server (nemotron, qwen3-asr,
whisper) with its baseUrl. Create test cases that POST each file in samples/ to
{{baseUrl}}/v1/audio/transcriptions, assert status 200 and non-empty text, and save the
transcript to a variable. Run the cases against each environment and give me a table
of failures and response times per server.
Der Agent liest das Schema, validiert seine Payload, schreibt die Testfälle und führt sie pro Umgebung aus:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Bewerten Sie die gespeicherten Transkripte mit einem beliebigen WER-Skript gegen Ihren Referenztext und behalten Sie den Lauf der Gewinnerumgebung mit -r junit in der CI bei. Siehe Apidog CLI in Claude Code und Apidog CLI in einer CI/CD-Pipeline.
Häufige Fragen
Was ist das genaueste Open-Source-Sprache-zu-Text-Modell? NVIDIA Nemotron 3.5 Transcribe mit durchschnittlich 5,33 % WER im Open ASR Leaderboard vom 28. Oktober 2026.
Ist Whisper noch gut? Es funktioniert, aber whisper-large-v3 belegt mit 7,16 % Platz 41. Optimierte Whisper-Builds wie TheStages large-v3 turbo erreichen 5,91 %.
Welches offene Modell ist am schnellsten? Von den hier aufgeführten Modellen TheStage AIs Whisper large-v3 turbo mit einer RTFx von 1.177.
Schlagen offene Modelle jetzt bezahlte APIs? Einige. Nemotron 3.5 Transcribe schlägt AssemblyAI Universal-3.5 Pro (5,39 %) und OpenAI gpt-transcribe (5,96 %). Otter, Zoom und ElevenLabs führen insgesamt noch. Für gehostete Optionen siehe unsere Übersicht der Speech-to-Text-APIs.
Welches unterstützt Sprecher-Diarisierung? Nemotron 3.5 Transcribe erledigt das im selben Modell, mit bis zu acht Sprechern. Die meisten anderen benötigen einen separaten Diarisierungsschritt.
Das Fazit
Für die meisten Teams Ende 2026 gilt: Beginnen Sie mit Nemotron 3.5 Transcribe, wenn Sie eine 80-GB-GPU haben oder 0,12 $ pro Stunde für eine gehostete API zahlen können. Wählen Sie Qwen3-ASR-1.7B, wenn das GPU-Budget knapp ist, und Parakeet, wenn die Hardware noch knapper ist. Was auch immer Sie wählen, testen Sie es mit Ihrem eigenen Audio und lassen Sie Ihren Agenten Apidog-Prüfungen laufen, damit das gewählte Modell nach jedem Upgrade weiter überzeugt.