Kurzantwort: Asynchrone Tool-Aufrufe für KI-Agenten unterteilen einen einzelnen blockierenden run()-Aufruf in einen schlanken Vertrag: start() liefert sofort ein Job-Handle zurück, status() meldet den Fortschritt, stop() bricht die Ausführung ab, und das Ergebnis wird später als Event zurückgegeben, das der Agent in seinem nächsten Turn einliest. Der Agent kann weiter kommunizieren und neue Anweisungen entgegennehmen, während langwierige Aufgaben im Hintergrund laufen.
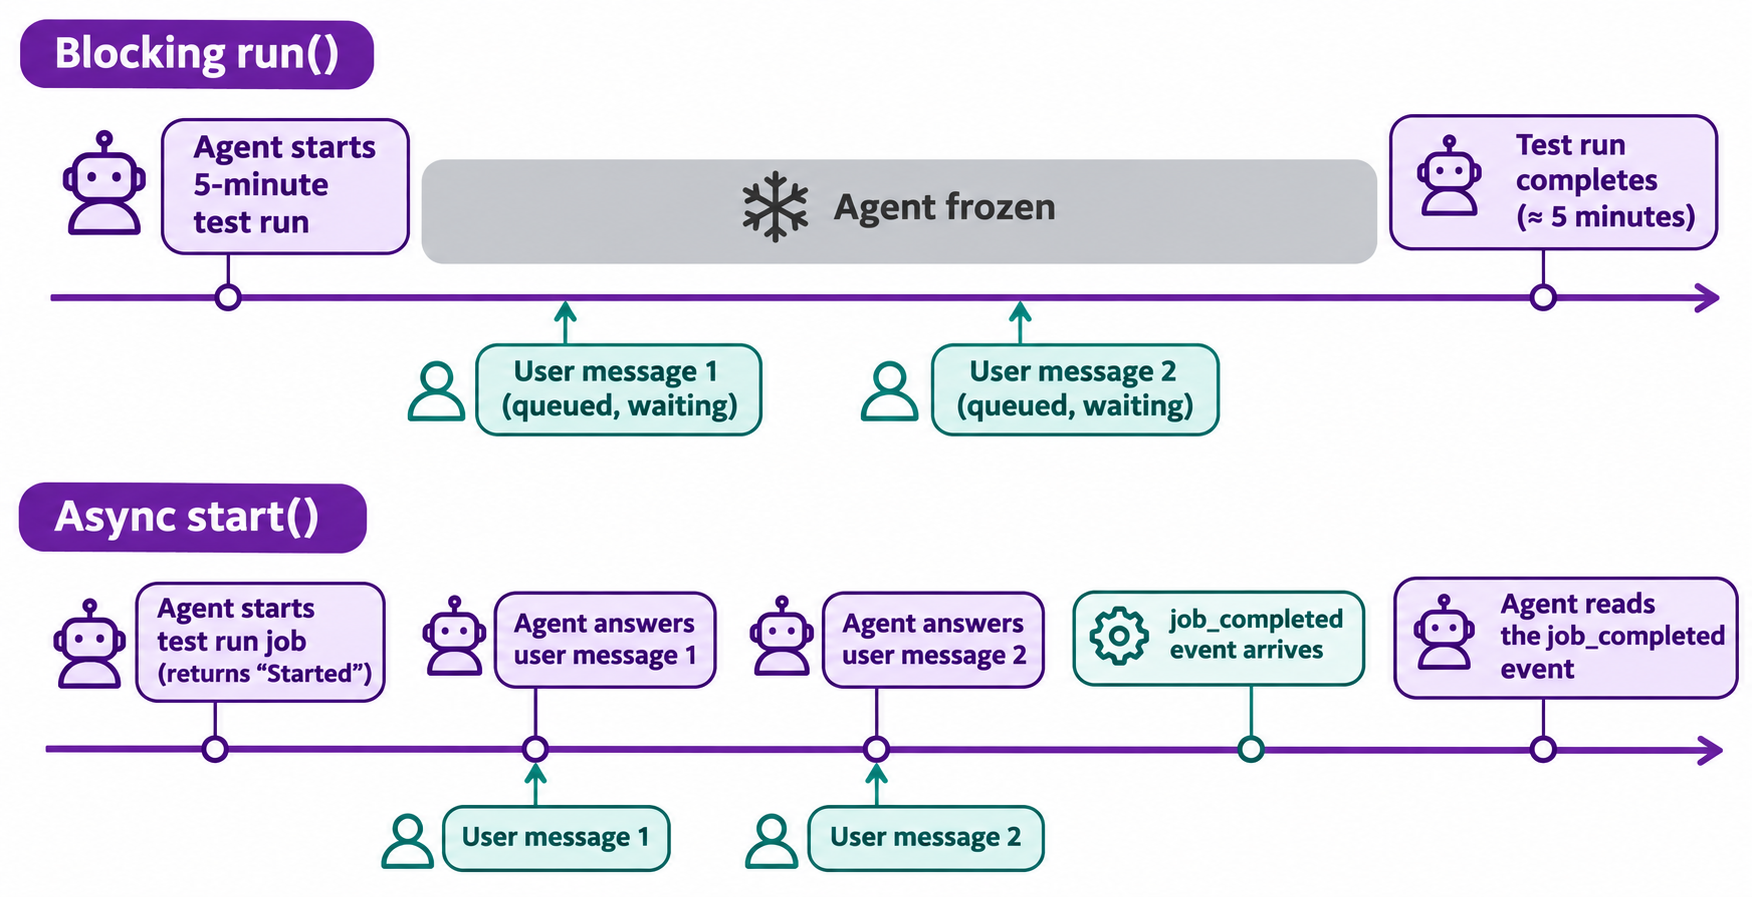
Die meisten heutigen Agenten rufen ein Tool auf und warten. Stellt man während eines 6-minütigen Testlaufs eine zweite Frage, bleibt sie in einer Warteschlange hängen. Für eine 200-ms-Abfrage ist das völlig in Ordnung, bei einem Deployment oder einem Crawl-Vorgang hingegen extrem lästig.
Ein aktueller Essay des DeepSeek-Harness-Teams, „Exploring Super-agent Design“, bezeichnet die Lösung als „Vollduplex“ (Full-Duplex): Das blockierende run() wird durch start() und stop() ersetzt. Dieser Leitfaden beleuchtet die Seite des Agent Loops: den Tool-Vertrag, den Rückfluss von Ergebnissen, Stornierungen sowie die API, die jedes Tool benötigt. Die HTTP-Seite einzelner langsamer Aufrufe wird im Artikel AI Agents and Long-Running API Calls: Polling vs Webhooks ausführlich beschrieben.
Was sind asynchrone Tool-Aufrufe in einem Agent Loop?
Ein asynchroner Tool-Aufruf ist ein Funktionsaufruf, der anstelle eines Ergebnisses sofort ein Handle zurückgibt. Der Agent Loop speichert dieses Handle, beendet seinen Turn und bleibt für den Nutzer ansprechbar. Sobald die Aufgabe abgeschlossen ist, speist die Runtime ein Abschluss-Event in die Konversation ein, das das Modell bei seinem nächsten Turn wie jede andere Nachricht liest.
Der Unterschied liegt darin, wer wartet: Bei run() wartet das Modell, bei start() die Runtime.
Blockierendes run() |
Asynchrones start() |
|
|---|---|---|
| Rückgabe | Endergebnis | Job-ID, „Started“ |
| Agent während der Ausführung | Blockiert (eingefroren) | Kommuniziert, plant, startet weitere Jobs |
| Neue Nutzernachricht | Eingereiht, bis das Tool fertig ist | Wird sofort verarbeitet |
| Abbruch | Gesamten Turn abbrechen | stop(job_id) |
Der DeepSeek-Essay beschreibt dies als Architekturansatz, nicht als fertiges Feature zum Einschalten. Full-Duplex sei zwar in DeepSeek Harness implementiert, aber standardmäßig deaktiviert, und Teile davon befinden sich in einem Prototyp-Plugin namens dsh-superagent-prototype, das laut den Autoren kein offizielles DeepSeek-Produkt ist. Betrachten Sie es als Entwurfsmuster zum Nachbauen. Hintergrundinformationen finden Sie in den Artikeln darüber, was DeepSeek Harness ist, und wie man einen Super-Agenten baut.
Das Blockierungs-Problem: Ein langsames Tool friert den Agenten ein
Stellen Sie sich einen Coding-Agenten vor, der die Testsuite ausführen soll (Dauer: 5 Minuten) und gleichzeitig eine Frage zu einem fehlerhaften Import beantworten soll. Bei blockierenden Aufrufen wartet Ihre Frage hinter den Tests, obwohl sie keinerlei Daten von ihnen benötigt. Dabei treten drei typische Probleme auf:
- Latenzen summieren sich. Jedes langsame Tool schlägt mit seiner vollen Laufzeit auf alle nachfolgenden Aktionen durch.
- Anweisungen veralten. Wenn Sie nach zwei Minuten sagen: „Überspringe eigentlich die E2E-Tests“, erfährt der Agent erst nach Abschluss des gesamten Testlaufs davon.
- Timeouts schlagen zu. Gateways trennen Verbindungen, die über Minuten hinweg offen gehalten werden. Ein langer
run()-Aufruf kann dadurch fehlschlagen, obwohl der eigentliche Vorgang erfolgreich war.
Der Essay bezeichnet diese gewünschte Eigenschaft als „produktiv“: Der Agent nimmt die nächste Anweisung entgegen, bevor die vorherige abgeschlossen ist. Asynchrone Tools sind der Schlüssel dazu.
start, status, stop: Der Vertrag für asynchrone Tools
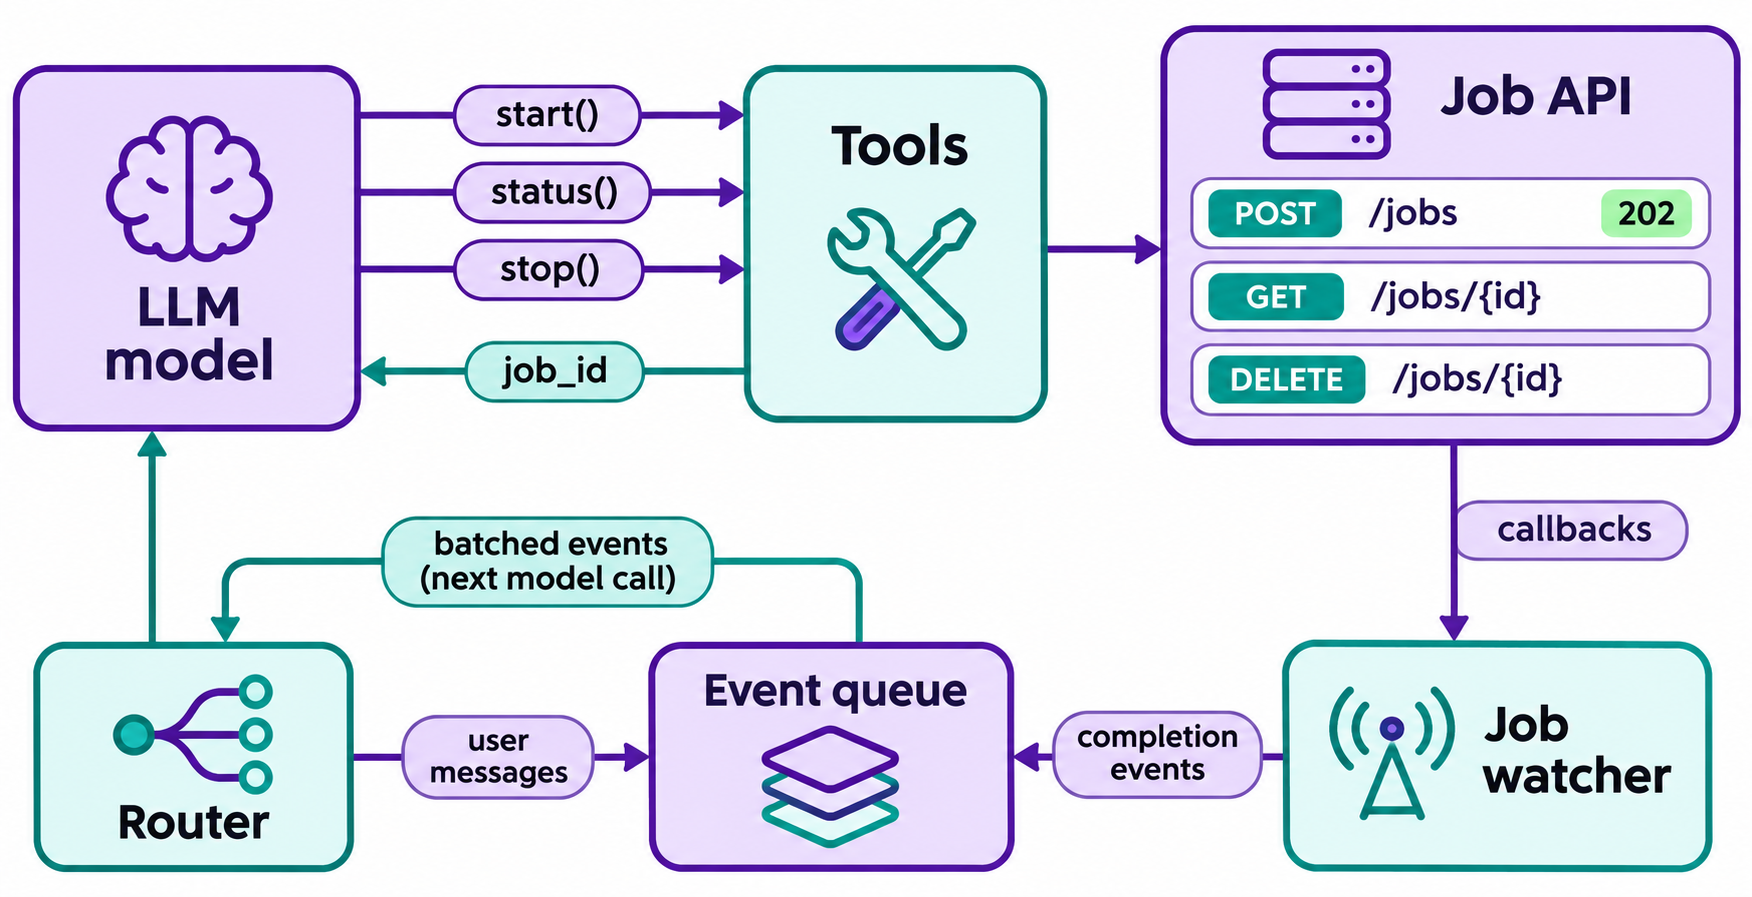
Stellen Sie dem Modell pro zeitintensiver Funktion drei separate Tools anstelle eines einzelnen zur Verfügung – jeweils mit minimalen Rückgabestrukturen.
{
  "name": "start_test_run",
  "description": "Start the test suite. Returns immediately with a job_id. The result arrives later as a job_completed event; do not wait for it.",
  "input_schema": {
    "type": "object",
    "properties": {
      "suite": { "type": "string", "enum": ["unit", "e2e", "all"] },
      "idempotency_key": { "type": "string" }
    },
    "required": ["suite", "idempotency_key"]
  }
}
start_test_run gibt {"job_id": "job_8f2", "status": "queued"} zurück und sonst nichts. get_job_status(job_id) liefert queued, running, done oder failed zurück, ergänzt durch einen kurzen Fortschrittshinweis. stop_job(job_id) fordert den Abbruch an und meldet den erreichten Zustand zurück.
Zwei Regeln sorgen dafür, dass das Modell zuverlässig arbeitet: Weisen Sie in der Beschreibung explizit darauf hin („do not wait“), da es get_job_status sonst in einer engen Schleife abfragt (Polling); und geben Sie bei start niemals Nutzdaten zurück, da das Modell sonst erraten müsste, welche Datenstruktur es gerade vor sich hat.
Wie Ergebnisse in den Loop zurückfließen
Polling durch das Modell sollte lediglich der Notfallplan sein, nicht die primäre Architektur. Der bessere Ansatz besteht darin, dass die Runtime die Jobs überwacht und ein Abschluss-Event als neue Nachricht in die Konversation einspeist:
[event] job_completed job_id=job_8f2 tool=start_test_run status=done
summary: 412 passed, 3 failed (auth/session.test.ts)
details: get_job_result(job_8f2)
Halten Sie das Event kompakt und machen Sie die vollständigen Nutzdaten über ein separates Abruf-Tool verfügbar, damit ein Log mit 40.000 Zeilen niemals direkt im Kontextfenster landet.
Führen Sie anschließend Batching ein. Der DeepSeek-Essay beschreibt einen Router, der während eines Turns eintreffende Trigger sammelt und sie in den nächsten Modellaufruf bündelt – lange Eingabe und kurze Ausgabe, zusammengefasst im Prefill. In ihrem Experiment stieg die Trigger-Zahl von 1 auf 40 pro Minute, die durchschnittliche Batch-Größe wuchs von 1,0 auf 2,8 und die Zeit pro Entscheidung sank von 6,4 s auf 1,6 s. Dies sind zwar interne Testwerte des Essays und kein allgemeingültiger Benchmark, aber ein einziger Aufruf, der drei Events verarbeitet, ist allemal effizienter als drei Aufrufe für jeweils ein einzelnes Event. Eine einfache Faustregel: Während das Modell generiert, werden Events und Nutzernachrichten in einer Queue gesammelt; endet der Turn, werden sie gebündelt in der Reihenfolge ihres Eintreffens übergeben.
Reihenfolge, Stornierung und Idempotenz-Schlüssel
Reihenfolge. Jobs werden in beliebiger Reihenfolge fertiggestellt. Wenn Job B von Job A abhängt, machen Sie diese Abhängigkeit explizit: Starten Sie B erst nach dem Abschluss-Event von A oder gestalten Sie die API so, dass sie einen depends_on-Parameter akzeptiert.
Stornierung. stop ist eine Anforderung, keine Garantie. Geben Sie den tatsächlichen Endzustand zurück (cancelled oder done, falls der Vorgang zuvor bereits abgeschlossen war) und lassen Sie das Modell diesen wahrheitsgemäß melden. Die Tasks-Erweiterung von MCP verfolgt denselben Ansatz: In ihrer Dokumentation wird Stornierung als kooperativ bezeichnet, sodass eine Aufgabe durchaus einen anderen Endzustand als cancelled erreichen kann.
Idempotenz-Schlüssel. Modelle führen bei Fehlern Wiederholungsversuche durch; eine verlorene Antwort kann somit einen zweiten start-Aufruf auslösen. Verlangen Sie bei jedem start einen idempotency_key und lassen Sie die API den bereits existierenden Job zurückgeben, sobald der Schlüssel erneut auftaucht. Ohne diesen Schutz könnte eine Anweisung wie „Führe die Migration aus“ versehentlich doppelt ausgeführt werden.
Teilergebnisse. Stellen Sie Zwischenergebnisse (wie die ersten 50 gecrawlten Seiten) über get_job_result(job_id, cursor) bereit, anstatt bis zum vollständigen Abschluss zu warten.
Kontextwachstum. Fassen Sie erledigte Jobs in einer einzigen Zeile zusammen, sobald das Modell darauf reagiert hat.
Timeouts. Versehen Sie jeden Job mit einer Frist und lösen Sie ein job_timed_out-Event aus, wenn diese überschritten wird.
Wie die zugrunde liegende API aufgebaut sein muss
Ein asynchrones Tool ist immer nur so gut wie die dahinterliegende Job-API: Sie nimmt den Auftrag an, gibt eine ID zurück und ermöglicht Statusabfragen. Laut RFC 9110 bedeutet 202 Accepted: „Die Anfrage wurde zur Bearbeitung angenommen, die Bearbeitung ist jedoch noch nicht abgeschlossen“, und die 202-Referenz von MDN beschreibt den Praxiseinsatz.
Eine minimale Job-API für ein start()-Tool sieht folgendermaßen aus:
| Aufruf | Antwort | Verwendet von |
|---|---|---|
POST /jobs (mit Idempotency-Key-Header) |
202 + {"job_id", "status":"queued"} + Location: /jobs/{id} |
start |
GET /jobs/{id} |
200 + queued, running, done oder failed |
status, Job-Watcher |
GET /jobs/{id}/result |
200 mit Ausgabe oder 409, falls noch nicht fertig |
Fetch-Tool |
DELETE /jobs/{id} |
202 Abbruch angefordert, danach 404 oder 409 bei späteren Aufrufen |
stop |
| Optionale Callback-URL | POST an den Aufrufer bei Fertigstellung |
Job-Watcher |
Der Callback ermöglicht es der Runtime, Events aktiv zu pushen, anstatt Polling einzusetzen. Wenn Sie Hilfe bei der Entscheidung benötigen, finden Sie die Vor- und Nachteile im Artikel Webhooks vs. Polling; die Seite der ereignisgesteuerten APIs wird in Was ist AsyncAPI? behandelt.
Falls Ihre Tools MCP unterstützen, gibt es dafür mittlerweile einen Standard. Die MCP-Spezifikation (Version 2026-07-28) führt Tasks als optionale Erweiterung auf: Ein Server kann auf tools/call mit einem CreateTaskResult antworten, das eine taskId enthält; der Client fragt tasks/get ab (oder lauscht auf notifications/tasks), und tasks/cancel fordert einen Abbruch an. Die Statuswerte lauten working, input_required, completed, failed und cancelled. Sowohl Client als auch Server müssen diese Erweiterung unterstützen, und der Host-Support variiert – prüfen Sie daher Ihren Client, bevor Sie darauf aufbauen.
Lassen Sie Ihren Coding-Agenten die Job-API mit der Apidog CLI erstellen und testen
Die Job-API ist die Komponente, die Sie vollständig verifizieren können, bevor überhaupt ein Agent darauf zugreift. Übergeben Sie das Design und die Tests an Ihren Coding-Agenten und lassen Sie ihn die Apidog CLI steuern. Sie formulieren einen einzigen Prompt; der Agent erstellt die Spezifikation sowie die Testfälle und führt sie aus.
Die Einrichtung erfordert lediglich drei Befehle:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Geben Sie Ihrem Agenten anschließend folgenden Prompt:
In Apidog project <projectId>, design the job API a start() tool needs:
POST /jobs returns 202 with job_id, GET /jobs/{id} returns queued|running|done|failed,
DELETE /jobs/{id} cancels. Create the endpoints, then create test cases that assert:
202 and a job_id on create, a status that reaches done within 60 seconds,
the same job_id when the Idempotency-Key repeats, and 409 or 404 on GET result after cancel.
Run them against the staging environment <envId> and summarize failures.
Der Agent liest die jeweiligen Payload-Strukturen über die CLI ein, validiert sie, schreibt sie und führt sie aus:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file post-jobs.json
apidog endpoint create --project <projectId> --file post-jobs.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case-create-202.json
apidog test-case create --project <projectId> --file case-create-202.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Der cli-Reporter gibt Erfolge und Fehlschläge pro Assertion im Terminal aus, und der json-Report liefert dem Agenten ein strukturiertes Format, das er auswerten und erläutern kann. Führen Sie denselben Befehl mit -r junit in der CI aus, sobald alle Tests bestanden sind; der Leitfaden zum Apidog-CLI-Agent-Workflow erklärt diesen Ablauf Schritt für Schritt, und der Artikel zu Apidog CLI in Claude Code beschreibt das Agenten-Setup. Der Free-Tarif von Apidog deckt bis zu 4 Benutzer ab.
Wann sich asynchrone Tools lohnen – und wann nicht
Asynchron lohnt sich, wenn:
- Ein Tool regelmäßig mehr als ein paar Sekunden benötigt (Builds, Testsuites, Crawls, Rendering-Vorgänge, Deployments).
- Nutzer mit dem Agenten interagieren möchten, während die Ausführung läuft.
Blockierend bleiben sollte es, wenn:
- Der Aufruf in weniger als ein bis zwei Sekunden abgeschlossen ist.
- Der nächste Schritt ohnehin nicht ohne das Ergebnis fortgesetzt werden kann.
- Keine echte Job-API dahintersteht. Ein scheinbar asynchrones Tool, das intern blockiert, erhöht lediglich unnötig die Komplexität.
Eine praxiserprobte Faustformel: Leseoperationen blockierend halten, zeitintensive Schreibvorgänge und rechenaufwendige Berechnungen asynchron ausführen.
FAQ
Was ist der Unterschied zwischen asynchronen und parallelen Tool-Aufrufen? Parallele Tool-Aufrufe führen mehrere Tools gleichzeitig innerhalb eines einzelnen Turns aus, wobei das Modell weiterhin auf den Abschluss aller Tools wartet. Asynchrone Tool-Aufrufe hingegen liefern sofort eine Antwort zurück und werden erst in späteren Turns abgeschlossen, sodass das Modell während der Ausführung weiter kommunizieren kann.
Wird MCP benötigt, um asynchrone Tools zu bauen? Nein. Jedes Tool, das eine Job-ID zurückgibt, und jede Runtime, die Abschluss-Events einspeist, funktionieren. Die optionale Tasks-Erweiterung von MCP standardisiert lediglich das Handle sowie die Abfrage- und Stornierungsaufrufe, sofern Client und Server dies unterstützen.
Woher weiß der Agent, wann ein Job beendet ist? Die Runtime teilt es ihm mit. Ein Job-Watcher fragt die Job-API ab oder empfängt einen Callback und fügt der Konversation anschließend ein kurzes Abschluss-Event hinzu. Das Modell liest dieses in seinem nächsten Turn.
Was passiert, wenn der Nutzer während des Jobs abbricht? Der Agent ruft stop(job_id) auf, die API erfasst die Anforderung, und der Job meldet seinen tatsächlichen Endzustand. War der Vorgang bereits abgeschlossen, bevor der Abbruch wirksam wurde, sollte der Agent dies auch so mitteilen, statt fälschlicherweise zu behaupten, der Vorgang sei gestoppt worden.
Kann man den Full-Duplex-Modus von DeepSeek einfach aktivieren? Nicht als fertiges Produktfeature. Dem Essay zufolge ist er zwar in DeepSeek Harness implementiert, aber standardmäßig deaktiviert, und das zugehörige Plugin ist lediglich ein Prototyp, der laut den Autoren kein offizielles DeepSeek-Produkt darstellt. Nutzen Sie das Konzept stattdessen als Referenzarchitektur.