
Kurze Antwort: KI-Videogeneratoren ohne Einschränkungen im eigentlichen Sinne gibt es nur auf Ihrer eigenen Hardware: Open-Weight-Modelle wie Wan2.2, HunyuanVideo-1.5 und LTX-2 laufen ohne serverseitigen Filter. Jeder gehostete Dienst wendet eine Inhaltsrichtlinie an. Wenn Sie weniger falsch-positive Ablehnungen ohne GPU wollen, können Sie bei einer Multi-Modell-Plattform wie A2E das Modell wechseln, sobald eines einen harmlosen Prompt ablehnt.
„Ohne Einschränkungen“ bedeutet in diesem Leitfaden kreative Freiheit: weniger Ablehnungen bei legitimen Prompts wie einem Horror-Kurzfilm, einer Kriegsszene, einem Stunt oder einem medizinischen Erklärvideo. Gemeint ist nicht expliziter Inhalt, und niemals die Nutzung des Gesichts oder der Stimme einer echten Person ohne deren Zustimmung. Dies ist der Video-Begleiter zu unserem Leitfaden zu KI-Bildgeneratoren ohne Einschränkungen.
Was „ohne Einschränkungen“ bei KI-Videogeneratoren bedeutet
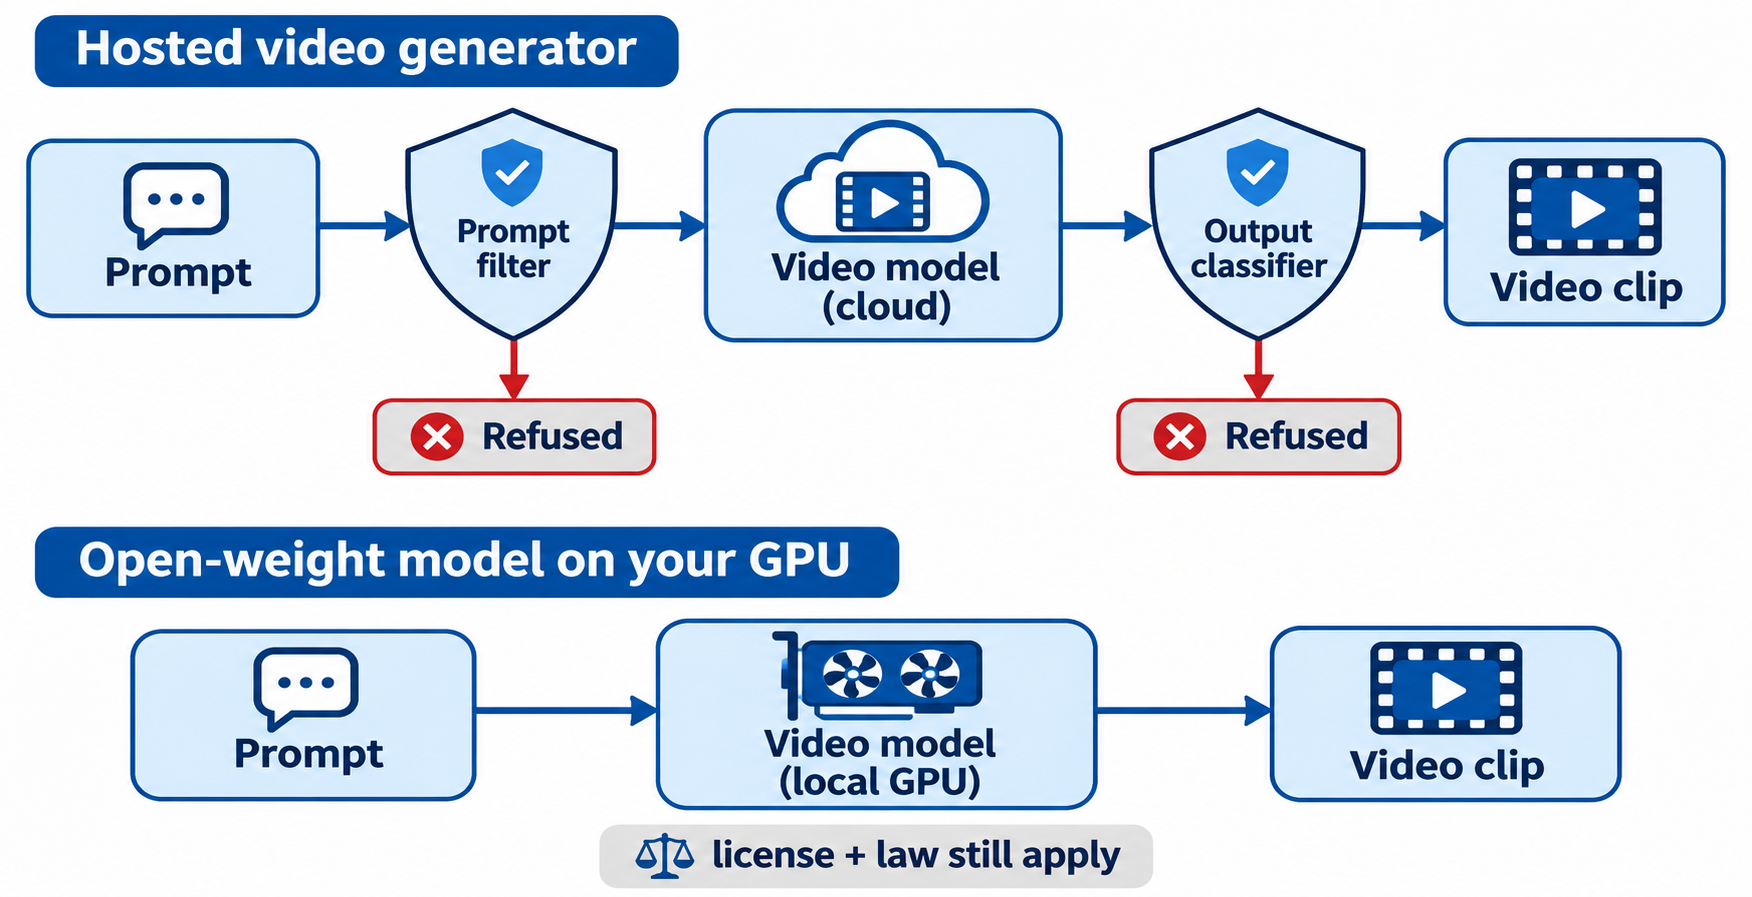
Ein KI-Videogenerator ohne Einschränkungen ist einer, der Ihren Prompt ohne anbieterseitigen Inhaltsfilter ausführt. In der Praxis trifft das nur auf Open-Weight-Modelle zu, die Sie selbst betreiben. Gehostete Tools filtern alle, unterscheiden sich aber darin, wie oft sie harmlose Prompts ablehnen und wie viele Modelle Sie unter einem Konto ausprobieren können.
Gehostete Videogeneratoren prüfen normalerweise zweifach: Ein Prompt-Filter liest zunächst Ihren Text, und ein Output-Klassifikator untersucht die Frames, bevor der Clip zurückkommt. Beide können ablehnen. Betreiben Sie ein Modell lokal, existiert keine dieser Ebenen.
Beste KI-Videogeneratoren ohne Einschränkungen: die Kurzliste
So vergleichen sich die wichtigsten Optionen. Preise und Credits stammen von den jeweiligen offiziellen Seiten, geprüft am 13. November 2026.
| Tool | Typ | Filter | Kostenloser Weg | Am besten für |
|---|---|---|---|---|
| A2E | Gehostet, Multi-Modell | Anbieter-Richtlinie | 30 Credits/Tag, Wasserzeichen, 720p | Viele Modelle in einem Konto, plus API |
| Kling 4.0 | Gehostet | Anbieter-Richtlinie | Offizielle Seite prüfen | Szenen mit großen Bewegungen inklusive Audio |
| Gemini Omni Flash | Gehostet (Google) | Google-Richtlinie | Offizielle Seite prüfen | Clips von 3 bis 15 Sekunden mit nativem Audio |
| Grok Imagine | Gehostet (xAI) | xAI-Richtlinie | Kostenpflichtige API, Abrechnung pro Sekunde | Kurze Clips bis 15 s, 1080p auf 1.5 |
| Seedance 2.5 | Gehostet (ByteDance) | ByteDance-Richtlinie | Offizielle Seite prüfen | Einzelshots bis 30 s |
| Wan2.2 | Open Weights | Keiner auf Ihrem Rechner | Kostenlose Gewichte | Lokales 720p mit 24 fps auf einer High-End-GPU |
| HunyuanVideo-1.5 | Open Weights | Keiner auf Ihrem Rechner | Kostenlose Gewichte | Leichtere lokale Läufe (14 GB mit Offloading) |
| LTX-2 | Open Weights | Keiner auf Ihrem Rechner | Kostenlose Gewichte | Video mit synchronisiertem Audio, lokal |
1. A2E: ein Konto, viele Videomodelle
A2E ist eine All-in-One-Plattform für KI-Bilder und -Videos. Sie schafft es auf die Liste wegen ihrer Breite, nicht weil sie Richtlinien ignoriert: Lehnt ein Modell einen harmlosen Prompt ab, führen Sie ihn mit demselben Konto und denselben Credits auf einem anderen Modell erneut aus. Zu den Videomodellen gehören Seedance 2.5, Kling 4.0, Wan 3.0, Veo 3.1, Sora 2 und Grok Imagine, dazu Face Swap, Talking Photo, Lip Sync und Voice Clone.
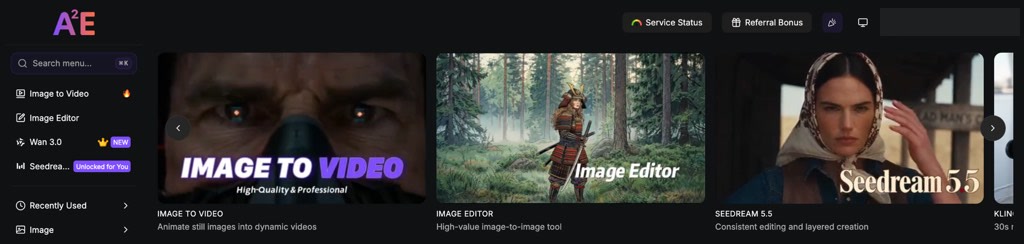
Neue Konten erhalten 100 kostenlose Credits plus 30 pro Tag über das tägliche Check-in, mit Wasserzeichen und 720p-Ausgabe. Pro kostet 14,9 $ für einen Monat mit 1.500 Credits, ohne Wasserzeichen und mit API-Zugang. In unserem Test am 13. November 2026 kostete ein 5-Sekunden-Image-to-Video-Clip auf A2Es V2-Modell 40 Credits und wurde in etwa 2 Minuten gerendert. Ein Face Swap am selben Clip lief kostenlos innerhalb des Kontingents, und das neue Gesicht blieb in jedem Frame stabil.
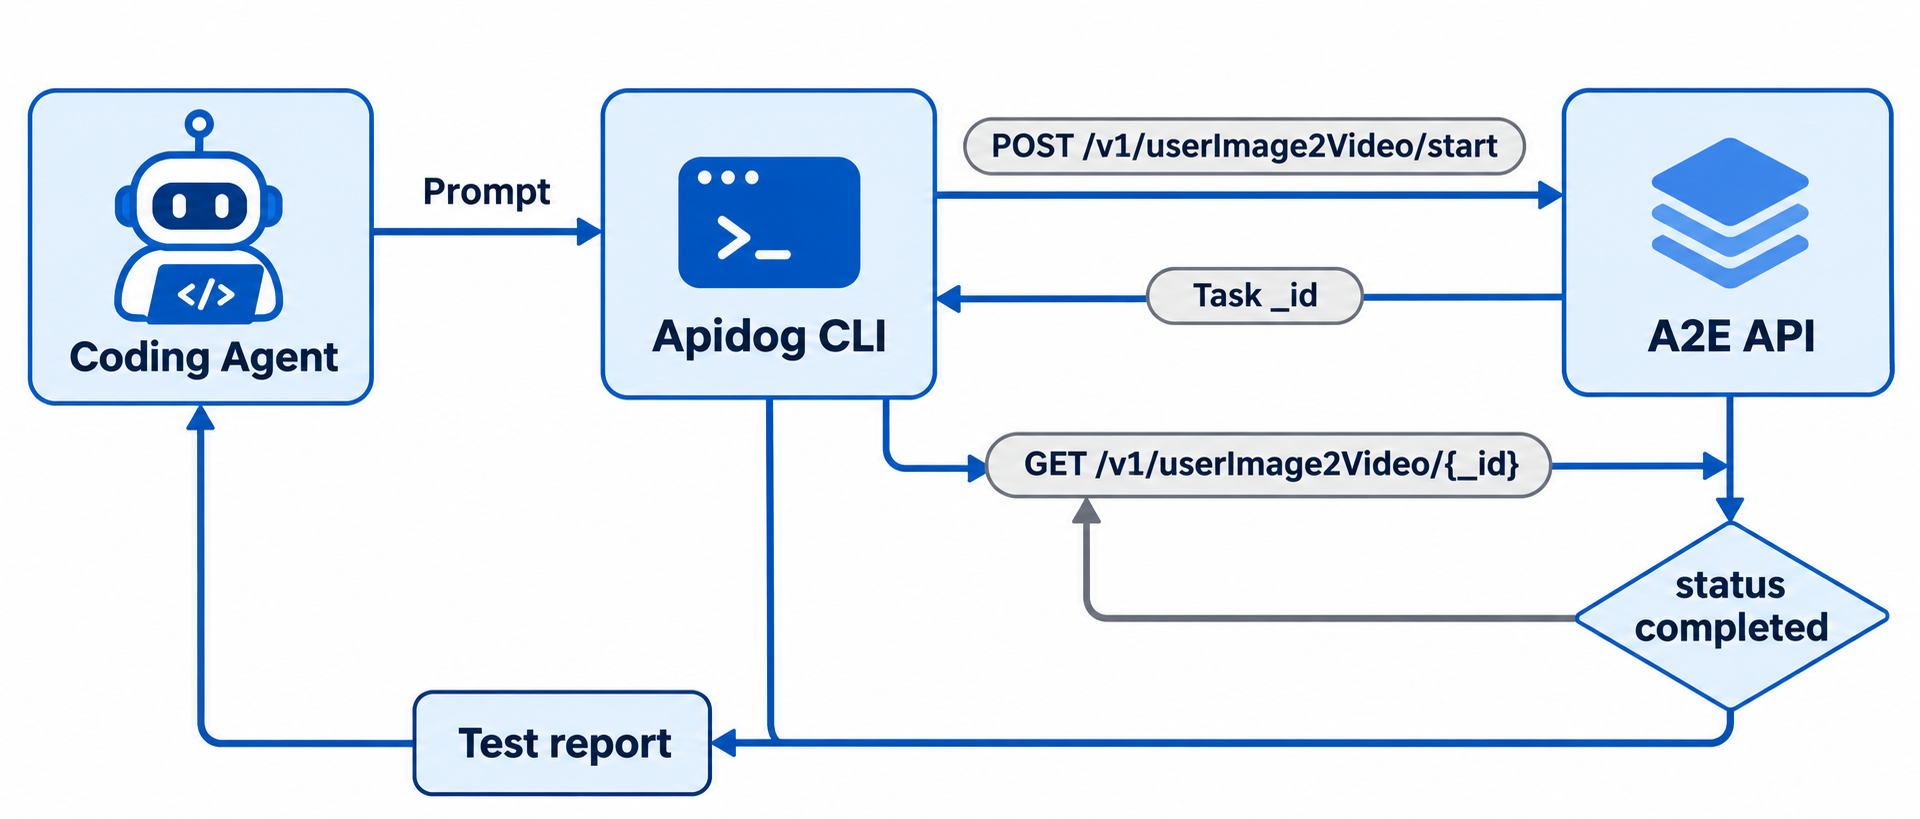
Entwickler erhalten eine REST-API unter https://api.a2e.ai mit einer OpenAPI-Spezifikation und einer SKILL.md für Coding-Agents. Jobs laufen asynchron: Sie starten eine Aufgabe und pollen dann ihre _id, bis sie abgeschlossen ist.
Fazit: Der einfachste gehostete Weg zu weniger Ablehnungen, weil der Modellwechsel ein Dropdown kostet, kein neues Abo. A2Es Nutzungsbedingungen gelten weiterhin, und die Seite verlinkt ein CSAM-Meldeformular.
2. Kling 4.0
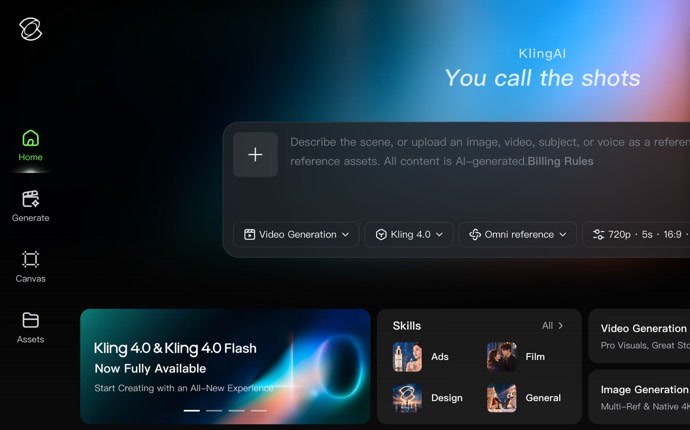
Gehostet. Kling bewirbt Kling 4.0 auf seiner Website mit audiovisuellem Realismus und stabilen Szenen mit großen Bewegungen. Das Prompt-Feld nimmt Text plus ein Bild, Video, Subjekt oder eine Stimme als Referenz auf und startet bei 720p, 5 Sekunden und 16:9. Dazu kommen Bewegungssteuerung, Lip Sync, Talking Avatars und Video zu Audio, außerdem ein node-basiertes Canvas sowie ein MCP- und API-Weg für Batch-Aufgaben. Bezahlte Pläne starten bei 6,99 $, und Kling ist auch im A2E-Angebot enthalten.
Fazit: Eine starke Wahl für actionreiche Clips. Prüfen Sie das kostenlose Kontingent zuerst auf kling.ai.
3. Google Gemini Omni Flash (früher Veo)
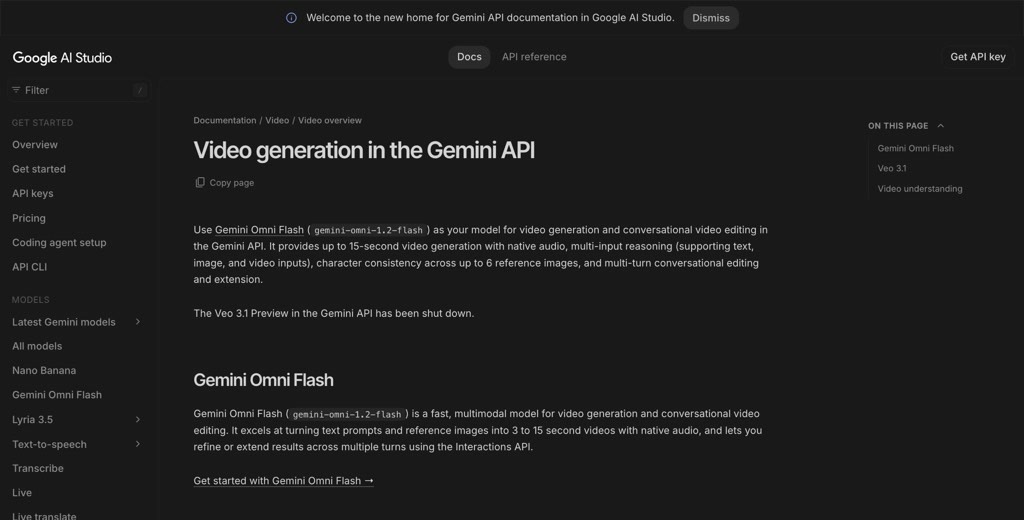
Gehostet. Google schaltete die Veo-3.1-Vorschau-Modelle in der Gemini-API am 22. Oktober 2026 ab, und seine Video-Dokumentation verweist Entwickler nun auf Gemini Omni Flash (gemini-omni-1.2-flash). Es erstellt Clips bis zu 15 Sekunden mit nativem Audio aus Text-, Bild- oder Videoeingaben, hält eine Figur über bis zu 6 Referenzbilder hinweg konsistent und erlaubt es, einen Clip über mehrere Runden zu verfeinern oder zu verlängern. Googles Generative AI Prohibited Use Policy regelt, was Sie erstellen dürfen.
Fazit: Gute Qualität im Google-Ökosystem, aber nicht die Wahl, wenn Ablehnungen Ihr Hauptproblem sind.
4. Grok Imagine
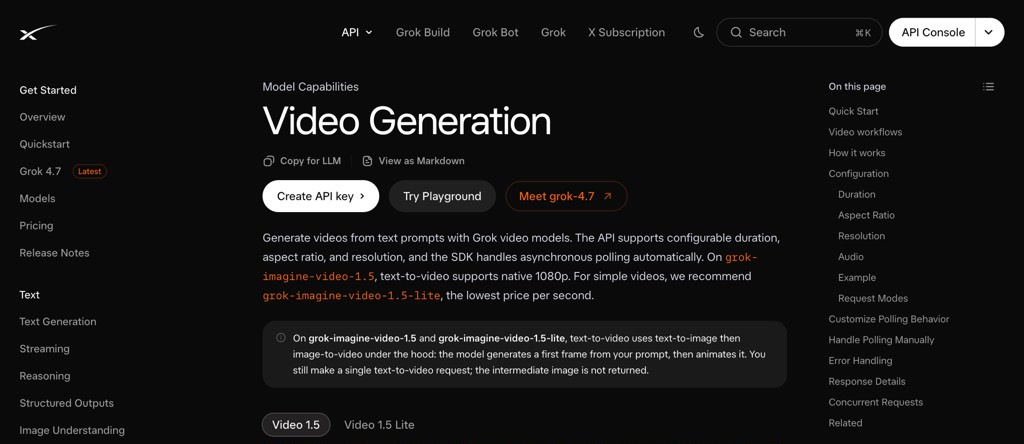
Gehostet. xAIs Videomodell läuft in der Grok-App und über die xAI-API. Auf grok-imagine-video-1.5 rendert Text zu Video in nativem 1080p, und das 1.5-lite-Modell ist das günstigste pro Sekunde. Clips laufen 1 bis 15 Sekunden mit standardmäßig aktiviertem Audio, und xAIs SDK übernimmt das asynchrone Polling für Sie. Die Moderation ist in App und API identisch, die API lehnt also nicht weniger ab, aber jeder Job meldet seinen eigenen Status. Es ist auch im A2E-Angebot enthalten. Unsere Analyse zu Grok Imagine ohne Einschränkungen deckt ab, was sich geändert hat und was weiterhin funktioniert.
Fazit: Schnelle, günstige Kurzclips, mit einem Filter, der weiterhin bei harmlosen Prompts anschlägt.
5. Seedance 2.5
Gehostet. ByteDances Seedance 2.5 erzeugt Audio und Video gemeinsam und ist für 30-sekündiges Storytelling in einem einzelnen Shot bei bis zu 1080p gebaut. Es nimmt bis zu 30 Referenzbilder, 10 Videos und 10 Audioclips entgegen. Sie erreichen es über ByteDances Apps, die BytePlus-ModelArk-API und Drittanbieter-Hosts, eingeschlossen A2E. Es blockiert echte menschliche Gesichter in Referenzbildern auf jedem Weg. Unser Leitfaden zu Seedance-2-Prompts, die Inhaltsmarkierungen vermeiden, behandelt Formulierungen, die seinen Filter versehentlich auslösen.
Fazit: Die beste Wahl für lange Einzelshots, solange Sie echte Gesichter weglassen.
6. Wan2.2
Open Weights, läuft lokal. Wan2.2 ist unter Apache 2.0 lizenziert und bringt Text-zu-Video-, Image-to-Video- und Speech-to-Video-Modelle mit. Es nutzt ein Mixture-of-Experts-Design und wurde mit 65,6 % mehr Bildern und 83,2 % mehr Videos trainiert als Wan2.1. Sein TI2V-5B-Modell beherrscht sowohl Text- als auch Image-to-Video bei 720p und 24 fps, und das README sagt, es laufe auf Consumer-Karten wie einer RTX 4090. Ein separates Animate-14B-Modell übernimmt Charakteranimation und -ersetzung.
Fazit: Der beste lokale Einstieg, wenn Sie eine High-End-GPU haben.
7. HunyuanVideo-1.5
Open Weights, läuft lokal. HunyuanVideo-1.5 ist ein Modell mit 8,3 Milliarden Parametern für Text-zu-Video und Image-to-Video, gebaut für den Betrieb auf Consumer-GPUs. Sein README listet ein Minimum von 14 GB GPU-Speicher mit aktiviertem Model Offloading, und ein step-distilliertes 480p-Image-to-Video-Modell rendert einen Clip in etwa 75 Sekunden auf einer einzelnen RTX 4090. Trainingscode und ein LoRA-Tuning-Skript sind ebenfalls offen. Es erscheint unter Tencents eigener Community-Lizenz, lesen Sie diese also vor der kommerziellen Nutzung.
Fazit: Die leichteste lokale Option, sofern die Lizenz zu Ihrer Nutzung passt.
8. LTX-2
Open Weights, läuft lokal. LTX-2 von Lightricks erzeugt Video mit synchronisiertem Audio in einem einzigen Modell, mit mehreren Leistungsmodi. Der Code ist Apache 2.0, während die Gewichte ihre eigene Modelllizenz tragen, die im README aufgeführt ist, und Hugging Face bittet Sie, die Bedingungen vor dem Download zu akzeptieren. Der aktuelle Quick Start lädt etwa 66 GiB an LTX-2.5-Gewichten, planen Sie also Festplattenspeicher ein. Es unterstützt fp8-Quantisierung und Offload, wenn der GPU-Speicher knapp ist, und das Repository enthält einen LoRA-Trainer.
Fazit: Die lokale Wahl, wenn Sie Ton im selben Durchlauf brauchen.
Für alle drei Open-Weight-Modelle ist ComfyUI das übliche Frontend: Gewichte laden, einen Workflow verdrahten und offline generieren. Sie tauschen den Anbieterfilter gegen Hardware und Einrichtungszeit.
Wie Sie falsch-positive Ablehnungen bei gehosteten Tools reduzieren
Die meisten Ablehnungen bei legitimen Prompts stammen aus der Formulierung, nicht aus der Absicht:
- Beschreiben Sie die Aufnahme wörtlich. „Ein Koch schneidet Zwiebeln mit einem großen Messer“ schlägt einen Prompt voller gewalttätiger Verben.
- Streichen Sie echte Namen. Die meisten Anbieter blockieren Prompts mit Namen öffentlicher Personen, aus gutem Grund.
- Starten Sie mit Ihrem eigenen Bild. Es gibt dem Modell ein klares, mit Einwilligung versehenes Subjekt.
- Nutzen Sie den negativen Prompt, um Gore, Unschärfe und Verzerrung auszuschließen.
- Wechseln Sie das Modell. Ein Prompt, den ein Modell ablehnt, besteht oft bei einem anderen.
Lassen Sie Ihren Coding-Agent die A2E-API mit Apidog CLI testen
Bei einer Video-API besteht das riskante Element aus dem asynchronen Job, der mit failed zurückkommt, oder der Ablehnung, die Ihr UI nicht behandelt. Lassen Sie Ihren Coding-Agent diese Prüfungen mit der Apidog CLI schreiben und ausführen.
Richten Sie es einmal ein:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
curl -sL https://video.a2e.ai/dev/openapi-spec -o a2e-openapi.json
apidog import --project <projectId> --format openapi --file ./a2e-openapi.json
Geben Sie dann Ihrem Agenten (Claude Code, Codex, Cursor oder OpenCode) einen Prompt:
In Apidog project <projectId>, create a test case for POST /v1/userImage2Video/start
with a Bearer token from the environment variable A2E_TOKEN. Assert the response
has code 0 and a data._id. Then call GET /v1/userImage2Video/{_id} until
current_status is completed or failed, and fail the test on failed with the
reason. Run it against environment <envId> and summarize the result.
Echte Läufe verbrauchen A2E-Credits, lassen Sie den Agenten also eine Mock-Expectation für den failed-Zustand hinzufügen (apidog cli-schema get mock-create, dann apidog mock create) und die Fehlerbehandlung dagegen testen. In CI liefert apidog run --test-case <caseId> -r junit einen JUnit-Bericht; siehe Apidog CLI in einer CI/CD-Pipeline.
Welchen KI-Videogenerator sollten Sie wählen?
- Keine Anbieterfilterung, GPU mit 14 GB oder mehr: HunyuanVideo-1.5 oder Wan2.2 TI2V-5B in ComfyUI.
- Audio und Video aus einem lokalen Modell: LTX-2.
- Viele gehostete Modelle in einem Konto: A2E.
- Actionreiche Clips: Kling 4.0.
- Lange Einzelshots: Seedance 2.5.
- Produktentwicklung: A2Es API plus Apidog-CLI-Tests für den Lebenszyklus asynchroner Jobs.
FAQ
Gibt es KI-Videogeneratoren mit wirklich keinen Einschränkungen?
Nur Open-Weight-Modelle, die Sie selbst betreiben, wie Wan2.2, HunyuanVideo-1.5 und LTX-2. Sie haben keinen anbieterseitigen Filter. Ihre Lizenzen und Ihr lokales Recht gelten weiterhin, und jeder gehostete Dienst setzt eine gewisse Inhaltsrichtlinie durch.
Ist A2E kostenlos nutzbar?
A2E hat einen kostenlosen 0-$-Plan mit 30 Bonus-Credits pro Tag über das Check-in, einem Wasserzeichen und 720p-Ausgabe. API-Zugang beginnt bei Pro für 14,9 $ pro Monat.
Warum lehnt mein KI-Videogenerator harmlose Prompts ab?
Prompt-Filter und Output-Klassifikatoren schlagen bei Wörtern an, die mit Gewalt oder echten Personen verknüpft sind, selbst in harmlosen Szenen. Beschreiben Sie die Aufnahme wörtlich und probieren Sie ein anderes Modell.
Wird Image-to-Video seltener abgelehnt als Text-to-Video?
Oft ja, weil Ihr eigenes Bild dem Modell ein klares Subjekt gibt. Output-Klassifikatoren prüfen weiterhin die Frames, es ist also keine Garantie.