
OpenAI LifeVal là một benchmark gồm 169 tác vụ trong cuộc sống hằng ngày, chẳng hạn như đăng ký cho con vào trường, quản lý ngân sách gia đình hay giải quyết thủ tục với cơ quan nhà nước, mà một AI agent hoàn thành thông qua việc dùng trình duyệt, dùng máy tính và các connector. Một rubric sẽ chấm điểm từng lần thử, và điểm số là phần thưởng trung bình từ 0 đến 1. GPT-6 Astra đạt 80,6% ở mức effort xhigh.
Đó là phiên bản ngắn gọn. Dưới đây bạn sẽ thấy cách OpenAI xây dựng LifeVal, mọi điểm số của các model mà họ công bố (bao gồm cả các con số theo từng mức effort chỉ nằm trong biểu đồ tương tác của trang), những con số đó nói lên điều gì về reasoning effort, và những gì benchmark này bỏ sót.
OpenAI LifeVal là gì?
LifeVal là một benchmark của OpenAI Research, đo lường mức độ hoàn thành các công việc vặt trong cuộc sống thường nhật của một model, thay vì các câu hỏi về lập trình hay bài thi. 169 tác vụ của nó mang tính agentic: model duyệt web, vận hành máy tính và gọi các connector, và một rubric dành riêng cho từng tình huống sẽ chấm điểm kết quả.
OpenAI nêu tên bảy lĩnh vực tác vụ:
- Chăm sóc người thân
- Sức khỏe
- Giáo dục
- Quản lý việc nhà
- Tài chính cá nhân
- Mua sắm
- Truy cập các dịch vụ công
Chỉ số chính là phần thưởng trung bình. Mỗi điểm số lấy trung bình các lần thử trong một tác vụ, sau đó lấy trung bình có trọng số bằng nhau của 169 giá trị trung bình tác vụ. Điểm 80,6% nghĩa là phần thưởng 0,806. Phần ghi chú của biểu đồ ghi "No WTP weighting" (không có trọng số WTP), chúng ta sẽ quay lại vấn đề này.
OpenAI đã xây dựng bộ tác vụ LifeVal như thế nào
OpenAI không phát minh danh sách tác vụ từ con số không. Họ bắt đầu từ cách mọi người thực sự dành thời gian, sử dụng hai bộ dữ liệu công khai và một khảo sát của riêng mình:
- American Time Use Survey của Cục Thống kê Lao động Hoa Kỳ, ghi lại người Mỹ làm gì theo từng giờ.
- Multinational Time Use Study, bộ dữ liệu hài hòa hóa nhật ký sử dụng thời gian giữa các quốc gia.
- Khảo sát riêng của họ với 3.995 người trả lời đại diện theo nhân khẩu học, hỏi họ muốn AI giúp ở đâu.
Dữ liệu sử dụng thời gian cho OpenAI biết những hoạt động nào lấp đầy ngày của mọi người. Khảo sát cho họ biết những hoạt động nào trong số đó mà người ta sẵn sàng giao cho một agent. Phần giao nhau trở thành 169 tình huống.
Trang web hiển thị năm thẻ tác vụ ví dụ, mỗi thẻ kèm một điểm số. Đây là những ví dụ do OpenAI chọn, không phải mẫu ngẫu nhiên:
| Tác vụ ví dụ (lựa chọn của OpenAI) | Điểm |
|---|---|
| Đăng ký đúng trường mẫu giáo sau khi chuyển nhà | 93,1% |
| Quản lý tình nguyện viên trước một trận lũ | 98,0% |
| Tìm nhà mới cho gia đình tôi | 100% |
| Xem trận đấu với bà từ xa | 96,3% |
| Chuẩn bị bữa ăn cho phụ huynh mới được chẩn đoán tiểu đường | 90,4% |
Điểm LifeVal: mọi model của OpenAI
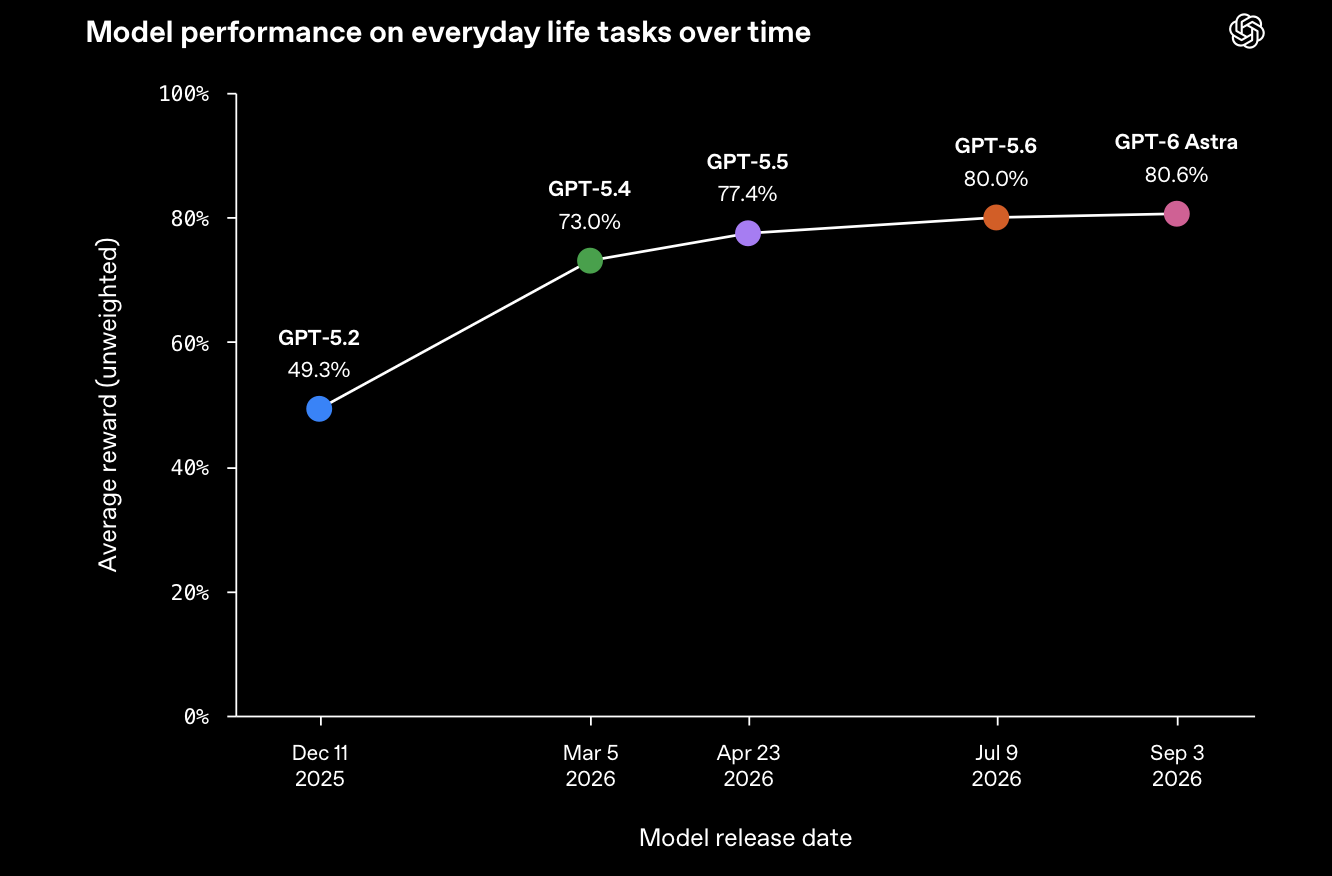
Biểu đồ đầu tiên của OpenAI vẽ từng model ở mức reasoning effort xhigh theo ngày phát hành. GPT-6 Astra dùng "cấu hình xhigh của blog ra mắt".
| Model | Ngày phát hành | Phần thưởng trung bình LifeVal (xhigh) |
|---|---|---|
| GPT-5.2 | 2025-12-11 | 49,3% |
| GPT-5.4 | 2026-03-05 | 73,0% |
| GPT-5.5 | 2026-04-23 | 77,4% |
| GPT-5.6 | 2026-07-09 | 80,0% |
| GPT-6 Astra | 2026-09-03 | 80,6% |
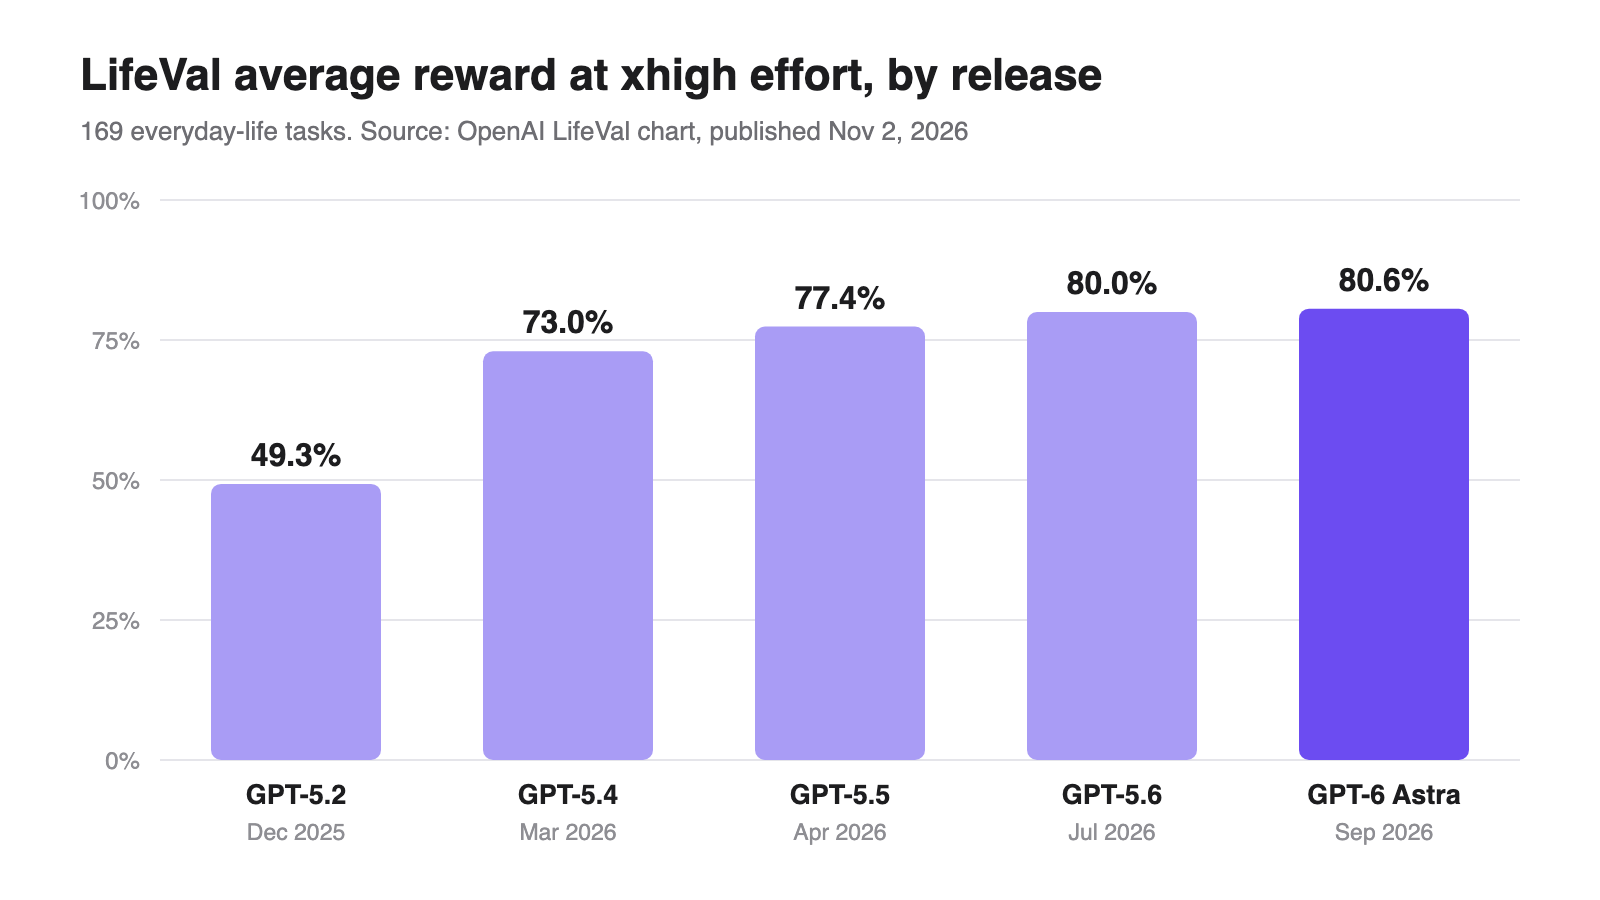
Đường cong dốc rồi phẳng. Từ GPT-5.2 đến GPT-5.4 tăng 23,7 điểm trong ba tháng. Ba bản phát hành tiếp theo cộng lại tăng 7,6 điểm, và GPT-6 Astra chỉ hơn GPT-5.6 vỏn vẹn 0,6 điểm.
Bước nhảy của GPT-5.4 không chỉ nằm ở chất lượng. Ở mức xhigh, độ trễ trung bình giảm từ 121,0 giây xuống 16,7 giây và số token sinh ra giảm từ 202,0K xuống 30,6K mỗi tác vụ. Model mới hơn đạt câu trả lời tốt hơn nhiều chỉ với khoảng một phần bảy lượng đầu ra.
GPT-6.1 Sol và GPT-6.1 Terra không xuất hiện trong cả hai biểu đồ, dù cả hai đã được phát hành. Dòng thời gian dừng ở ngày 3 tháng 9 năm 2026. Nếu bạn đang cân nhắc giữa GPT-6.1 Sol và Astra cho một sản phẩm agent, LifeVal hiện chưa giúp được gì.
LifeVal theo reasoning effort
Biểu đồ thứ hai hữu ích hơn, và bạn chỉ thấy nó khi di chuột vào. Nó chia từng model theo mức reasoning effort, với bốn con số cho mỗi điểm: phần thưởng, độ trễ, số token sinh ra và chi phí API. Dưới đây là phần thưởng cho từng cấu hình:
| Model | low | medium | high | xhigh | max |
|---|---|---|---|---|---|
| GPT-5.2 | 27,7% | 37,2% | 45,2% | 49,3% | n/a |
| GPT-5.4 | 62,8% | 70,1% | 72,0% | 73,0% | n/a |
| GPT-5.5 | 57,1% | 71,3% | 75,6% | 77,4% | n/a |
| GPT-5.6 | 63,9% | 75,0% | 78,8% | 80,0% | 82,6% |
| GPT-6 Astra | 66,6% | 77,6% | 80,7% | 80,6% | 82,5% |
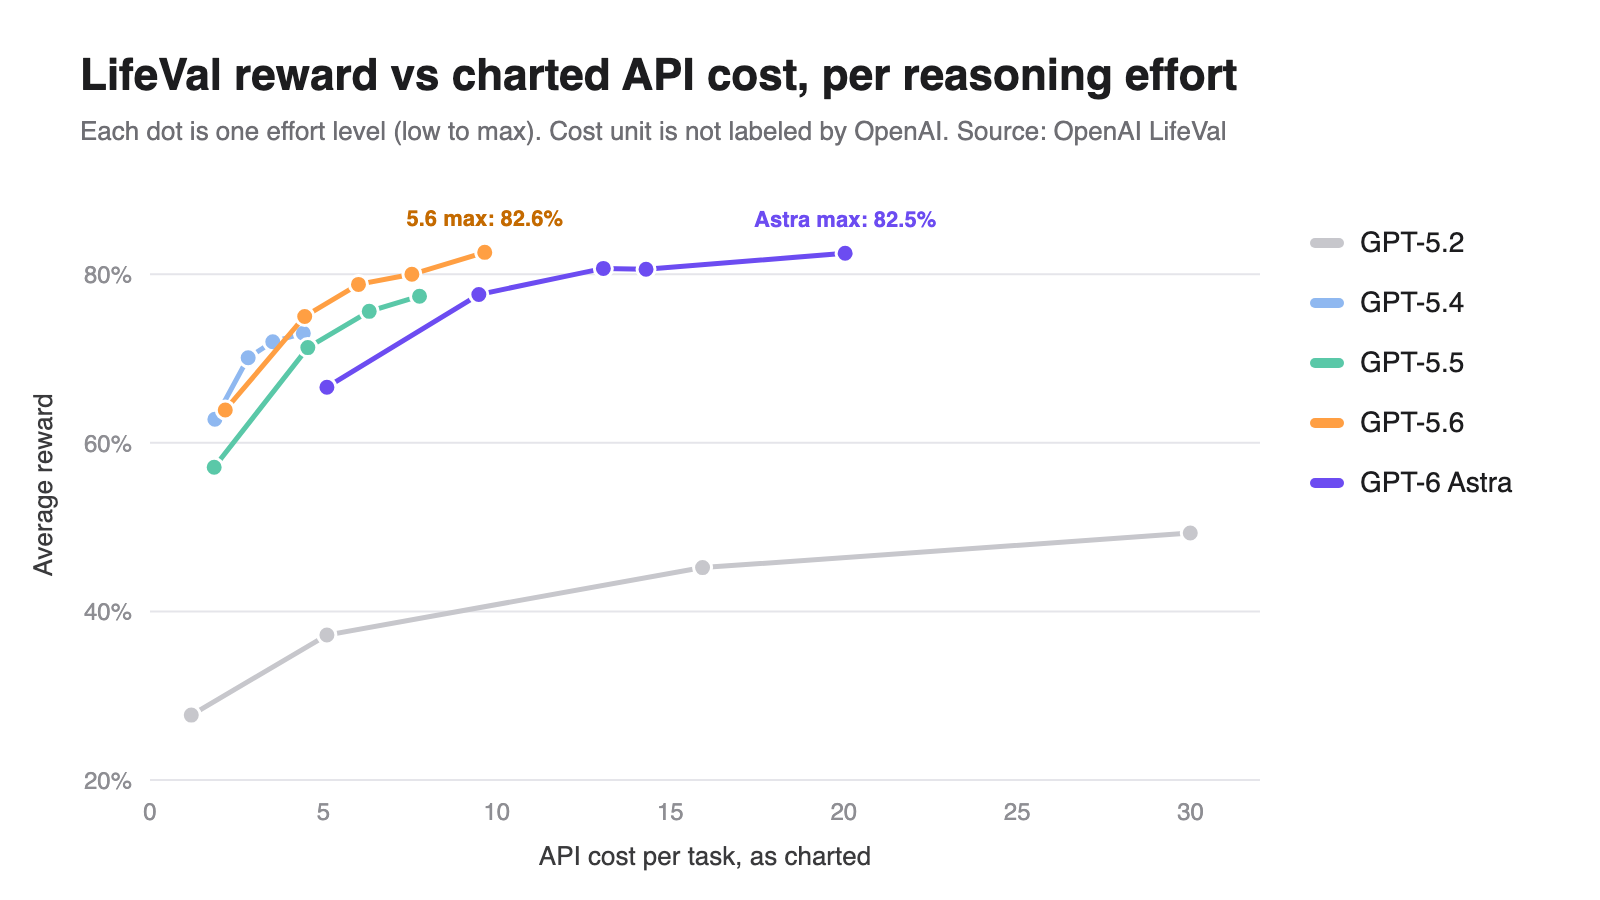
Một lưu ý về cột chi phí. OpenAI gọi nó là chi phí API nhưng không nêu đơn vị, nên hãy coi các con số dưới đây là "chi phí API mỗi tác vụ như được vẽ trên biểu đồ", hữu ích để so sánh tỷ lệ, chứ không phải đơn vị đô la.
GPT-5.6 ở mức max ngang bằng GPT-6 Astra ở mức max
| Cấu hình | Phần thưởng | Độ trễ | Token | Chi phí trên biểu đồ |
|---|---|---|---|---|
| GPT-5.6, max | 82,6% | 22,2 s | 29,7K | 9,65 |
| GPT-6 Astra, max | 82,5% | 20,6 s | 26,3K | 20,04 |
| GPT-5.6, xhigh | 80,0% | 17,5 s | 20,7K | 7,55 |
| GPT-6 Astra, high | 80,7% | 13,6 s | 12,4K | 13,07 |
GPT-5.6 ở mức max nhỉnh hơn Astra ở mức max 0,1 điểm với chi phí trên biểu đồ chỉ bằng khoảng một nửa. Ở cùng mức effort, khoảng cách dẫn trước của Astra so với GPT-5.6 dưới ba điểm ở mọi cấu hình, 0,6 điểm ở xhigh, và không còn ở mức max. Astra nhanh hơn một chút và dùng ít token hơn, nhưng với những tác vụ này bạn phải trả khoảng gấp đôi cho nó. Bài phân tích chi tiết giá GPT-5.6 và hướng dẫn API GPT-6 Astra của chúng tôi có mức giá theo token nếu bạn muốn đối chiếu tỷ lệ đó với lưu lượng thực tế của mình.
Suy luận nhiều hơn mức "high" gần như chẳng mang lại gì
Với GPT-6 Astra, mức high đạt 80,7% và xhigh đạt 80,6%. Phần effort tăng thêm tốn 1,4 giây và 2,1K token nữa để đổi lấy điểm số thấp hơn một chút. GPT-5.4 cũng cho thấy hình dạng tương tự: chỉ hơn một điểm từ high lên xhigh.
Những mức tăng lớn nằm ở phần dưới của đường cong. Chuyển GPT-5.5 từ low lên medium tăng 14,2 điểm. Chuyển từ high lên xhigh chỉ tăng 1,8 điểm. Nếu agent của bạn chạy những tác vụ thường ngày như thế này, medium hoặc high là cấu hình nên thử trước. Hướng dẫn reasoning của OpenAI giải thích cách tham số effort hoạt động trong Responses API.
LifeVal bỏ sót những gì
LifeVal là một tín hiệu hữu ích, nhưng nó là tín hiệu tự công bố. Trước khi trích dẫn nó, hãy biết những giới hạn của nó.
- Nó không công khai. Không có bộ tác vụ nào để tải về và không có bảng xếp hạng công khai, và OpenAI cũng chưa công bố các rubric hay cách họ hiệu chỉnh người chấm điểm. Bạn không thể chạy lại nó.
- Nó chỉ chấm điểm các model của OpenAI. Không có Claude, Gemini hay model trọng số mở nào xuất hiện, nên nó không nói lên điều gì về việc GPT-6.1 Sol so với Claude Sonnet 5.5 hay bất kỳ cặp so sánh liên nhà cung cấp nào khác.
- Một phiên bản có trọng số tồn tại ở đâu đó. Biểu đồ ghi "No WTP weighting", WTP nghĩa là willingness to pay (mức sẵn lòng chi trả). Điều đó ngụ ý OpenAI đã tính hoặc đã cân nhắc một biến thể có trọng số theo mức người ta sẵn lòng trả cho mỗi tác vụ, và đã không công bố nó.
- Các thẻ ví dụ được chọn thủ công. Năm thẻ trên trang đạt từ 90,4% đến 100%. Trung bình của 169 tác vụ đối với model tốt nhất là 80,6%. Các ví dụ cho thấy những ngày đẹp nhất của benchmark, chứ không phải ngày điển hình.
Không điều nào trong số này khiến LifeVal sai. Nó chỉ khiến nó trở thành một benchmark của nhà cung cấp. Hãy đọc nó như cách bạn đọc mọi biểu đồ ra mắt: như một tuyên bố mà bạn có thể tự kiểm chứng trên chính tác vụ của mình.
Tự chạy thử nghiệm reasoning effort của bạn với Apidog CLI
Bảng theo từng mức effort của LifeVal chính là một đường cong phần thưởng so với chi phí. Bạn có thể vẽ đường cong tương tự cho prompt của riêng mình. Thay vì tự tay gửi từng request, hãy giao việc đó cho coding agent của bạn và để nó điều khiển Apidog CLI.
Cài CLI, đăng nhập và thêm skill Apidog vào agent của bạn:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Sau đó đưa cho Claude Code, Codex hoặc Cursor một prompt:
In Apidog project <projectId>, add a POST https://api.openai.com/v1/responses
endpoint that sends {{model}}, reasoning.effort = {{effort}} and my test prompt.
Create a test case that asserts status 200 and saves latency,
usage.output_tokens and usage.output_tokens_details.reasoning_tokens.
Add a test data set with effort = low, medium, high, xhigh, run the case
once per row against environment <envId>, and give me a table of
latency, tokens and estimated cost per effort.
Agent sẽ đọc schema của từng payload, kiểm tra JSON của nó rồi thực thi:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json

apidog test-case category --project <projectId>
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json

apidog cli-schema validate test-data-create --file efforts.json
apidog test-data create --project <projectId> --file efforts.json

apidog run --test-case <caseId> --project <projectId> -e <envId> \
  -d <testDataId> -r cli,json --out-dir ./effort-runs
Cờ -d cấp một lần lặp cho mỗi dòng dữ liệu, và -r cli,json đưa cho agent một báo cáo JSON để dựng bảng từ đó. Thêm --upload-report nếu bạn muốn xem lại các lần chạy trong ứng dụng Apidog sau đó. Tài liệu tham chiếu lệnh apidog run liệt kê mọi cờ, và hướng dẫn thiết lập Claude Code đề cập đến phần phía agent.
Hãy chạy nó trên năm hoặc mười prompt thật của bạn, chứ không phải một. LifeVal lấy trung bình 169 tác vụ là có lý do: một prompt duy nhất sẽ cho bạn biết nhiều về phương sai hơn là về effort.
Bạn có nên tin LifeVal khi chọn model không?
Hãy dùng nó để định hướng, không phải để quyết định. LifeVal cho bạn biết ba điều có thể hành động dựa trên: các model của OpenAI đã tiến bộ hơn nhiều ở các tác vụ thường ngày gồm nhiều bước trong khoảng từ tháng 12 năm 2025 đến tháng 3 năm 2026, mức tăng từ đó đến nay là nhỏ, và reasoning effort cao hơn mức high hiếm khi đáng giá với kiểu công việc này.
Điều nó không thể cho bạn biết là một model không thuộc OpenAI sẽ đạt bao nhiêu điểm, các tác vụ của bạn so với 169 tác vụ của OpenAI ra sao, hay người chấm điểm thưởng cho điều gì. Để biết những điều đó, hãy tự chạy một lượt khảo sát effort như trên, và so sánh những con số bạn nhìn thấy. Bài thử nghiệm thực tế GPT-6 Astra của chúng tôi là một điểm khởi đầu cho kiểu kiểm tra đáng làm.
Câu hỏi thường gặp
LifeVal là viết tắt của gì?
OpenAI không giải thích tên này trên trang. Đó là một đánh giá ("Val") về các tác vụ trong cuộc sống thường nhật ("Life"): 169 tình huống agentic trải khắp chăm sóc người thân, sức khỏe, giáo dục, quản lý việc nhà, tài chính cá nhân, mua sắm và các dịch vụ công.
Điểm LifeVal của GPT-6 Astra là bao nhiêu?
Phần thưởng trung bình 80,6% ở mức effort xhigh, cấu hình mà OpenAI dùng trong blog ra mắt Astra. Ở mức max, Astra đạt 82,5%, và ở mức high, nó đạt 80,7%.
Tôi có thể tự chạy LifeVal không?
Không. OpenAI chưa phát hành bộ tác vụ, rubric hay người chấm điểm. Bạn có thể mô phỏng phân tích effort-so-với-chi-phí của nó trên prompt của riêng mình bằng một khung kiểm thử như Apidog CLI, nhưng bạn không thể tái tạo điểm LifeVal.
LifeVal có bao gồm Claude hay Gemini không?
Không. Cả hai biểu đồ chỉ bao gồm các model OpenAI, từ GPT-5.2 đến GPT-6 Astra. GPT-6.1 Sol và GPT-6.1 Terra cũng vắng mặt.
Cột chi phí của LifeVal có tính bằng đô la không?
OpenAI gọi nó là chi phí API nhưng không nêu đơn vị. Hãy dùng nó để so sánh các cấu hình với nhau, ví dụ GPT-5.6 max là 9,65 so với Astra max là 20,04, chứ không phải như một con số đô la mỗi tác vụ.
Tôi nên dùng reasoning effort nào cho các tác vụ agent thường ngày?
Trên LifeVal, mức medium hoặc high nắm bắt phần lớn mức tăng. GPT-6 Astra đạt 80,7% ở mức high và 80,6% ở mức xhigh, vì vậy hãy thử medium và high trên tác vụ của chính bạn trước khi trả thêm tiền cho mức cao hơn.