
Nếu bạn thấy gpt-6-sol xuất hiện trong nhật ký thay đổi vào ngày 22 tháng 9 năm 2026 và cho rằng đó là GPT-5.6 Sol mà bạn đã tích hợp, hãy dừng lại. Đó không phải là cùng một mô hình. OpenAI đã sử dụng lại tên phân cấp và phát hành một mô hình mới bên dưới nó, được đào tạo bằng các phương pháp tương tự như GPT-6 Astra, với mức giá khác, cửa sổ ngữ cảnh khác và hồ sơ đánh giá hiệu suất khác.
Quyết định đặt tên đó sẽ khiến các nhóm tốn tiền và nhiều giờ gỡ lỗi. Bài viết này trình bày chi tiết về GPT-6 Sol thực sự là gì: ID mô hình, chi phí, các con số OpenAI đã công bố, một phép đo đã lỗi thời và nơi bạn có thể gọi nó ngay hôm nay.
GPT-6 Sol: Tổng quan
| Mục | Giá trị |
|---|---|
| ID mô hình API | gpt-6-sol |
| Giá đầu vào | $2 mỗi triệu token |
| Giá đầu ra | $10 mỗi triệu token |
| Đọc đầu vào được lưu vào bộ nhớ đệm | Giảm giá 90% |
| Cửa sổ ngữ cảnh | 872.000 token |
| Chỉ số Trí tuệ Phân tích Nhân tạo | 48 |
| Được công bố | Ngày 22 tháng 9 năm 2026, cùng với GPT-6 Luna |
| Có sẵn tại | ChatGPT Work và Codex, cộng với API |
| Chưa có sẵn tại | Trò chuyện, tính đến thời điểm ra mắt |
Để so sánh trong cùng một dòng sản phẩm: GPT-6 Astra có giá $10/$50, và GPT-6 Luna có giá $0.10/$0.50 với cửa sổ ngữ cảnh 1M và chỉ số 37. Dòng sản phẩm của OpenAI cho biết Astra “tiếp tục là mô hình tốt nhất của chúng tôi trên mọi phương diện,” vì vậy Sol không phải là sản phẩm chủ lực. Đây là cấp độ mà chi phí cho mỗi tác vụ đã thay đổi.
Đây là một mô hình mới, không phải là một cấp độ được đổi tên
Dòng GPT-5.6 gồm Sol, Terra và Luna. Dòng GPT-6 gồm Astra, Sol và Luna. Hai tên được giữ lại, một tên bị bỏ và một tên mới.
Không có GPT-6 Terra. Nếu bạn đã xây dựng một hệ thống cấp bậc dựa trên sơ đồ đặt tên GPT-5.6, thì bậc thang ở giữa đã biến mất và các bậc còn lại nằm ở những độ cao khác nhau. So sánh cũ của chúng tôi về Sol với Terra và Luna mô tả thế hệ trước và nên được đọc như một phần lịch sử.
Lịch sử giá làm cho sự thay đổi trở nên rõ ràng:
| Cấp độ | Giá niêm yết GPT-5.6 | Giá khuyến mãi GPT-5.6 | Giá GPT-6 |
|---|---|---|---|
| Sol | $5 / $30 | $4 / $20 | $2 / $10 |
| Terra | $2.50 / $15 | $2 / $12 | không có GPT-6 Terra |
| Luna | $1 / $6 | $0.20 / $1.20 | $0.10 / $0.50 |
Giá được tính trên mỗi triệu token đầu vào và mỗi triệu token đầu ra. Các hàng giá niêm yết và khuyến mãi của GPT-5.6 đến từ các bài viết của chúng tôi vào thời điểm đó: định giá GPT-5.6 và đợt giảm giá GPT-5.6.
“Rẻ hơn 50%” thực sự có nghĩa là gì
OpenAI mô tả Sol và Luna rẻ hơn 50% so với giá khuyến mãi của GPT-5.6. Từ "khuyến mãi" là của OpenAI, và nó rất quan trọng. So sánh này là với mức giá đã chiết khấu, chứ không phải giá niêm yết mà GPT-5.6 đã ra mắt.
So với giá niêm yết của GPT-5.6 Sol là $5/$30, GPT-6 Sol với giá $2/$10 là mức giảm 60% cho đầu vào và 67% cho đầu ra. Mức giảm thực tế lớn hơn tiêu đề, và tiêu đề được đo từ một mức chiết khấu. Cả hai tuyên bố đều đúng cùng một lúc, và bạn muốn cái thứ hai trong mô hình ngân sách của mình hơn là cái đầu tiên.
Một điều không thay đổi là mức giá mỗi token rẻ hơn không tự động tạo ra một hóa đơn rẻ hơn. Các mô hình suy luận dành token đầu ra để "suy nghĩ". Một mô hình có giá mỗi token bằng một nửa nhưng suy nghĩ lâu gấp ba lần thì không phải là tiết kiệm. Đó là lý do tại sao OpenAI dẫn đầu các con số ra mắt của mình bằng chi phí cho mỗi tác vụ thay vì chi phí cho mỗi token.
Các điểm chuẩn được công bố
Mỗi con số dưới đây đều từ tài liệu ra mắt của OpenAI. Cài đặt mức độ nỗ lực suy luận được đặt trong dấu ngoặc đơn vì các mô hình này đạt điểm rất khác nhau ở các mức độ nỗ lực khác nhau, và một hàng điểm chuẩn không có cài đặt mức độ nỗ lực của nó thì không phải là một con số có thể sử dụng được.
| Điểm chuẩn | GPT-6 Sol | Điểm so sánh |
|---|---|---|
| AutomationBench 1.0.6 | 33.2% (xhigh) với $0.27 mỗi tác vụ | GPT-6 Astra (low) 30.3% với chi phí gấp 3.9 lần Sol; Claude Opus 5 (max) 26.9% với chi phí gấp 11.1 lần Sol |
| Agents’ Last Exam V1 | 56.4% (max) | Vượt qua điểm cao nhất của Claude Opus 5, với chi phí mỗi tác vụ thấp hơn 60% |
| DeepSWE 1.1 | 68.8% (max) | Chênh lệch 1.1 điểm so với Claude Fable 5 ở mức xhigh (69.9%), rẻ hơn khoảng 80% mỗi tác vụ |
| OSWorld 2.0 ngoại tuyến | 60.5% (xhigh) | Claude Opus 5 (medium) 60.3%, rẻ hơn khoảng 80% mỗi tác vụ |
Mẫu hình nhất quán trên cả bốn điểm: Sol đạt ngang hoặc nhỉnh hơn một chút so với các mô hình tiên phong được so sánh, với một phần nhỏ chi phí cho mỗi tác vụ. Trên AutomationBench, Sol ở mức xhigh đánh bại Claude Opus 5 ở mức tối đa với 9% chi phí cho mỗi tác vụ của Opus 5. Một thiết lập Claude Fable 5.1 với Opus 5 dự phòng đạt 31.4%, thấp hơn Sol, với chi phí cao hơn 8.9 lần.
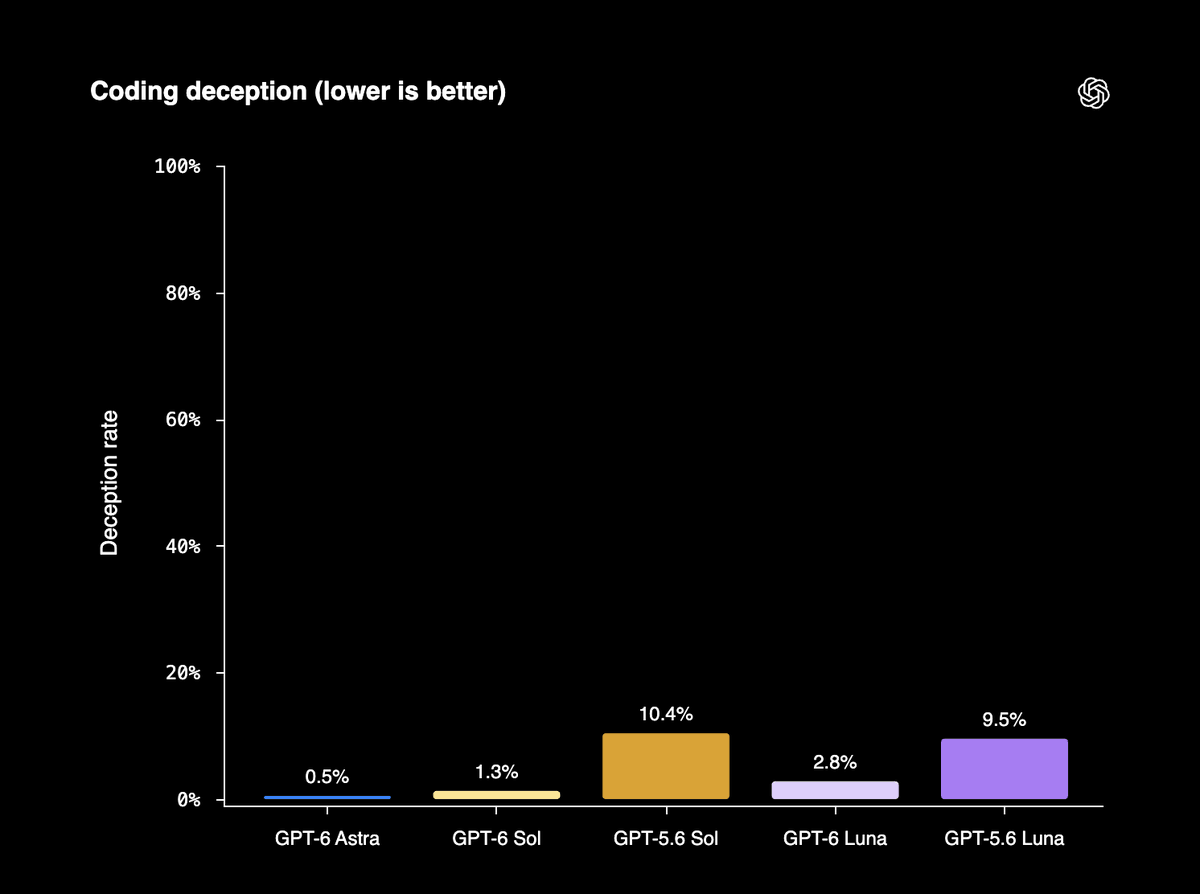
OpenAI cũng tuyên bố rằng Sol mắc ít lỗi sai sự thật hơn khoảng một nửa so với người tiền nhiệm của nó.
So sánh đã hết hạn vào ngày ra mắt
Đọc lại bảng đó và lưu ý mô hình Claude nào nó dùng để đánh giá. Claude Opus 5.
Anthropic đã phát hành Claude Opus 5.5 cùng ngày, với giá $4/$20 so với $5/$25 của Opus 5, và nó đã chiếm vị trí số một trong số 212 mô hình được xếp hạng trên Chỉ số Trí tuệ Phân tích Nhân tạo, với điểm số 58. Bài đăng ra mắt của OpenAI được viết trước khi mô hình đó tồn tại, vì vậy mỗi câu "đánh bại Opus 5 với 9% chi phí" được đo lường dựa trên một mô hình đã bị thay thế trong vòng vài giờ.
Điều đó không làm cho các con số của OpenAI sai. Chúng chính xác cho so sánh mà họ đã thực hiện. Điều đó có nghĩa là bạn không nên đưa chúng vào một tài liệu mua sắm năm 2027 như là tình hình hiện tại. Nếu bạn cần câu trả lời so sánh Sol với Opus 5.5, chưa ai công bố cả, và các con số đối đầu đang lan truyền trên mạng xã hội là từ các tester cá nhân chứ không phải từ nhà cung cấp nào.
Bài viết trụ cột về cuộc chiến giá AI của chúng tôi theo dõi cả ba lần ra mắt trong một bảng.
Mô hình rẻ không phải là mô hình nhanh
Các phép đo từ bên thứ ba của Artificial Analysis cho thấy GPT-6 Sol đạt 115.2 token đầu ra mỗi giây với thời gian đến token đầu tiên là 102.15 giây trong cấu hình suy luận tối đa của nó. GPT-6 Luna, mô hình rẻ hơn, có thời gian đến token đầu tiên chậm hơn ở mức 124.23 giây.
Hai lưu ý trước khi bạn lập kế hoạch dựa trên những con số đó. Chúng là của bên thứ ba, không phải do nhà cung cấp công bố. Và chúng dành riêng cho các biến thể suy luận tối đa, vốn là cài đặt đắt nhất để chạy và phản hồi chậm nhất. Các mức độ nỗ lực thấp hơn sẽ hoạt động khác, và OpenAI chưa công bố số liệu độ trễ của riêng mình.
Ngay cả với cả hai lưu ý, hình dạng của kết quả là điều cần nắm bắt. Thời gian chờ 102 giây trước khi token đầu tiên đến không phải là một khoảng trống mà cấu hình thời gian chờ hiện có của bạn có thể chịu đựng được. Thời gian chờ mặc định của client HTTP nằm ở 30 hoặc 60 giây. Các bộ cân bằng tải sẽ hết thời gian chờ. Các hàm không máy chủ đạt giới hạn thực thi của chúng. Nếu bạn đang chuyển một điểm cuối đồng bộ từ GPT-5.6 Sol sang GPT-6 Sol ở mức độ nỗ lực cao, công việc tích hợp nằm ở lớp thời gian chờ và truyền tải của bạn, chứ không phải ở prompt.
Điều này đáng để bạn tự đo lường hơn là tin tưởng chúng tôi hay Artificial Analysis. Trong Apidog, bạn có thể hướng một yêu cầu đến điểm cuối OpenAI, đặt ID mô hình làm biến môi trường để một bộ sưu tập bao gồm mọi cấp độ, và đọc thời gian phản hồi trực tiếp từ mỗi lần chạy. Xây dựng cùng một yêu cầu ba lần ở ba mức độ nỗ lực, lưu chúng dưới dạng một kịch bản kiểm thử, và bạn sẽ có bảng độ trễ của riêng mình cho các prompt của mình trong khoảng mười phút. Con số đó là con số mà cấu hình thời gian chờ của bạn nên được xây dựng dựa trên.
Bộ nhớ đệm nhắc nhở đã được phát hành thực sự
- Giảm giá 90% cho việc đọc đầu vào được lưu vào bộ nhớ đệm. Với đầu vào $2, một lần đọc được lưu vào bộ nhớ đệm là $0.20 mỗi triệu token.
- Tỷ lệ truy cập bộ nhớ đệm thành công cao hơn theo mặc định, không yêu cầu thay đổi mã.
- Việc thay đổi mức độ nỗ lực suy luận hoặc tính khả dụng của công cụ không còn làm hỏng bộ nhớ đệm. Trước đây, việc tăng mức độ nỗ lực giữa cuộc trò chuyện sẽ làm mất hiệu lực tiền tố được lưu vào bộ nhớ đệm.
- Các điểm ngắt rõ ràng, vì vậy bạn chọn nơi tiền tố được lưu vào bộ nhớ đệm kết thúc thay vì đoán.
- Bảng điều khiển Bộ nhớ đệm Nhắc nhở và công cụ chẩn đoán, để tỷ lệ truy cập thành công không còn bị ẩn.
GitHub báo cáo rằng hơn 50% số token prompt không cần xử lý mới trên hàng tỷ yêu cầu. Trong một cửa sổ ngữ cảnh 872.000 token, sự khác biệt giữa tỷ lệ truy cập thành công 20% và 80% là sự khác biệt giữa một sản phẩm agent khả thi và một sản phẩm bạn lặng lẽ ngừng hoạt động.
Sự thay đổi về mức độ nỗ lực và tính khả dụng của công cụ là một yếu tố bất ngờ. Các vòng lặp agent thường xuyên tăng cường nỗ lực khi một tác vụ trở nên khó khăn và hoán đổi các bộ công cụ giữa các bước lập kế hoạch và thực thi. Theo hành vi cũ, cả hai động thái này đều loại bỏ bộ nhớ đệm chính xác vào thời điểm ngữ cảnh dài nhất.
Bạn có thể gọi nó ở đâu hôm nay
| Nền tảng | GPT-6 Sol |
|---|---|
| API | Có, ID mô hình gpt-6-sol |
| ChatGPT Work | Có, cho Plus, Pro, Business, Enterprise và Edu |
| Codex | Có, cho Plus, Pro, Business, Enterprise và Edu |
| Trò chuyện | Chưa có |
| Các gói Free và Go | GPT-6 Luna trong ứng dụng máy tính để bàn |
Khoảng trống trong Chat là điều khiến mọi người vấp ngã. Nếu bạn thường kiểm tra sơ bộ một prompt trong giao diện người dùng tiêu dùng của ChatGPT trước khi đưa nó vào mã, bạn sẽ không tìm thấy GPT-6 Sol ở đó. Hãy sử dụng Codex hoặc truy cập trực tiếp API.
Một lời gọi tối thiểu trông như thế này:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-sol",
    "input": "Summarize the breaking changes in this OpenAPI diff.",
    "reasoning": { "effort": "high" }
  }'
Xác nhận định dạng yêu cầu so với tài liệu tham khảo mô hình hiện tại của OpenAI trước khi bạn triển khai. ID mô hình là phần chúng tôi đã xác minh.
Giá trị của điều này đối với bạn
Một con số từ lần ra mắt của OpenAI cho thấy đối tượng mà mức giá này hướng đến: nhà nghiên cứu OpenAI trung vị chi hơn 600 đô la mỗi ngày cho các tác nhân mã hóa, và phân vị thứ 90 chi 7.000 đô la mỗi ngày. Ở quy mô đó, mức giảm 80% chi phí cho mỗi tác vụ là một khoản mục trong ngân sách, chứ không phải là một lỗi làm tròn.
Đối với hầu hết các nhóm, phép tính nhỏ hơn và cụ thể hơn:
| Xuất phát từ | Trường hợp cho GPT-6 Sol |
|---|---|
| GPT-5.6 Sol | Giảm 60% cho đầu vào và 67% cho đầu ra so với giá niêm yết, và độ chính xác tốt hơn. Hãy kiểm tra trước, các đầu ra sẽ khác. |
| GPT-6 Astra | Từ $10/$50 xuống còn $2/$10, và Sol ở mức xhigh đã đánh bại Astra ở mức low trên AutomationBench. Nhưng OpenAI vẫn gọi Astra là mô hình tốt nhất của họ trên mọi phương diện, vì vậy hãy giữ Astra cho những công việc khó nhất. |
| Claude Opus 5 | Các con số của OpenAI thiên về Sol rất nhiều. Những con số đó có trước Opus 5.5 với giá $4/$20, vì vậy hãy tự chạy lại so sánh. |
| GPT-6 Luna | Luna rẻ hơn 20 lần với giá $0.10/$0.50 với cửa sổ 1M lớn hơn. Nếu khối lượng công việc của bạn lớn và không quá khó, hãy bắt đầu từ đó. |
Dù bạn đi theo cách nào, việc chuyển đổi là một thay đổi về hành vi, chứ không phải thay đổi cấu hình. Cùng một prompt, mô hình mới, đầu ra khác. Chạy bộ kiểm thử API hiện có của bạn với ID mô hình mới trước khi bạn định tuyến lưu lượng truy cập sản xuất đến nó, và khẳng định lược đồ phản hồi và độ trễ, chứ không chỉ mã trạng thái 200. Đó chính xác là khoảng cách giữa một mô hình hoạt động tốt trên các điểm chuẩn và một mô hình hoạt động trong ngăn xếp công nghệ của bạn.