
Hạng rẻ nhất trong một dòng mô hình thường là hạng mà bạn không tin tưởng. Bạn gửi các tác vụ phân loại, tóm tắt và yêu cầu thử lại đến đó, giữ mọi tác vụ yêu cầu trí tuệ đại lý trên mô hình hàng đầu, và chấp nhận rằng mô hình ngân sách sẽ gặp khó khăn ngay khi một tác vụ cần nhiều hơn một bước.
GPT-6 Luna, được công bố vào ngày 22 tháng 9 năm 2026, có giá tương tự hạng đó nhưng lại không hoạt động như vậy. Nó có giá $0.10 cho mỗi triệu token đầu vào và $0.50 cho mỗi triệu token đầu ra, nó có cửa sổ ngữ cảnh 1 triệu token, và các số liệu được OpenAI công bố cho thấy nó nằm trong phạm vi của các mô hình tiên tiến trên các điểm chuẩn mã hóa đại lý với chi phí chỉ bằng một phần nhỏ so với chi phí trên mỗi tác vụ của các mô hình đó.
Một điều cần làm rõ trước: đây không phải là GPT-5.6 Luna mà bạn có thể đã tích hợp vào chuỗi dự phòng. Cùng tên hạng, mô hình mới, giá mới, cửa sổ ngữ cảnh mới. Giả định khác đi là một cách dễ dàng để triển khai một thay đổi hành vi âm thầm và chỉ phát hiện ra từ một yêu cầu hỗ trợ.
GPT-6 Luna sơ lược
| Mục | Giá trị |
|---|---|
| ID mô hình API | gpt-6-luna |
| Giá đầu vào | $0.10 mỗi triệu token |
| Giá đầu ra | $0.50 mỗi triệu token |
| Đọc đầu vào đã lưu vào bộ nhớ cache | Giảm giá 90% |
| Cửa sổ ngữ cảnh | 1.000.000 token |
| Chỉ số Trí tuệ Phân tích Nhân tạo | 37 |
| Công bố | Ngày 22 tháng 9 năm 2026, cùng với GPT-6 Sol |
| Có sẵn trong | ChatGPT Work và Codex, ứng dụng máy tính để bàn cho người dùng miễn phí và Go, cùng với API |
| Chưa có sẵn trong | Trò chuyện, tính đến thời điểm ra mắt |
Trong cùng dòng, GPT-6 Sol có giá $2/$10 với cửa sổ 872.000 token và chỉ số 48, còn GPT-6 Astra là $10/$50. OpenAI tuyên bố rằng Astra “tiếp tục là mô hình tốt nhất của chúng tôi trên mọi phương diện,” vì vậy Luna không được bán như mô hình thông minh nhất. Nó được bán như mô hình mà chi phí cho mỗi tác vụ đã giảm mạnh.
Đây là một mô hình mới, không phải một hạng đổi tên
Dòng GPT-5.6 là Sol, Terra và Luna. Dòng GPT-6 là Astra, Sol và Luna. Hai tên được giữ lại, Terra thì không, và Astra là tên mới. OpenAI mô tả Sol và Luna được đào tạo bằng các phương pháp tương tự GPT-6 Astra, nghĩa là chúng là các mô hình mới chia sẻ quy ước đặt tên với các mô hình cũ.
Không có GPT-6 Terra. Nếu bạn đã xây dựng một hệ thống định tuyến dựa trên sơ đồ đặt tên GPT-5.6, thì bậc trung gian đó không còn tồn tại, và so sánh trước đây của chúng tôi về Sol với Terra và Luna giờ đây chỉ là lịch sử chứ không phải là hướng dẫn hiện hành.
Lịch sử giá cho thấy hạng này đã thay đổi như thế nào:
| Hạng | Giá niêm yết GPT-5.6 | Giá khuyến mãi GPT-5.6 | GPT-6 |
|---|---|---|---|
| Sol | $5 / $30 | $4 / $20 | $2 / $10 |
| Terra | $2.50 / $15 | $2 / $12 | không có GPT-6 Terra |
| Luna | $1 / $6 | $0.20 / $1.20 | $0.10 / $0.50 |
Tất cả các con số đều tính trên mỗi triệu token đầu vào và mỗi triệu token đầu ra. Các hàng GPT-5.6 đến từ bài viết của chúng tôi vào thời điểm đó, giá GPT-5.6 và việc giảm giá GPT-5.6.
OpenAI mô tả Sol và Luna rẻ hơn 50% so với giá khuyến mãi của GPT-5.6. Từ khuyến mãi là của chính OpenAI và nó làm thay đổi ý nghĩa của tuyên bố: so sánh được thực hiện với mức giá chiết khấu, chứ không phải mức giá mà GPT-5.6 ra mắt. Khi so sánh với giá niêm yết GPT-5.6 Luna là $1/$6, GPT-6 Luna với giá $0.10/$0.50 là giảm 90% cho đầu vào và 92% cho đầu ra. Mức giảm thực tế lớn hơn so với tiêu đề, và tiêu đề được tính toán từ một mức giảm giá. Hãy đưa con số thứ hai vào mô hình ngân sách của bạn, chứ không phải con số đầu tiên.
Mô hình giá rẻ có cửa sổ ngữ cảnh lớn hơn
Đây là chi tiết mà hầu hết các bài đưa tin ra mắt đã bỏ qua. Luna được trang bị cửa sổ ngữ cảnh 1.000.000 token. Sol, với giá gấp hai mươi lần, lại chỉ có 872.000.
Điều đó đảo ngược một giả định mà nhiều mã định tuyến đã mã hóa: rằng bạn sẽ nâng cấp một yêu cầu lên một mô hình đắt tiền hơn khi tải trọng tăng lên. Với GPT-6, cửa sổ lớn nhất trong dòng lại nằm ở cuối danh sách giá. Một tài liệu 900.000 token không vừa trong Sol nhưng lại vừa trong Luna.
Phép tính theo sau từ hai mức giá. Điền đầy cửa sổ của Luna một lần mất $0.10 tiền token đầu vào. Điền đầy cửa sổ 872.000 token của Sol một lần tốn khoảng $1.74. Điền đầy cửa sổ 1M của Claude Opus 5.5 với giá $4 mỗi triệu token tốn $4.00. Cùng loại tải trọng, nhưng chi phí bạn phải trả để đọc nó lại chênh lệch gấp bốn mươi lần.
Thêm lớp công việc lưu trữ vào bộ nhớ cache của OpenAI lên trên và khoảng cách lại càng nới rộng. GPT-6 áp dụng chiết khấu 90% cho các lần đọc đầu vào đã lưu vào bộ nhớ cache, vì vậy một tiền tố 1 triệu token được giữ trong bộ nhớ cache qua các lệnh gọi sẽ tốn khoảng $0.01 để đọc lại thay vì $0.10. OpenAI cũng cho biết GPT-6 có tỷ lệ truy cập bộ nhớ cache cao hơn theo mặc định, rằng việc thay đổi mức độ nỗ lực suy luận hoặc tính khả dụng của công cụ không còn làm mất hiệu lực bộ nhớ cache, và các điểm ngắt rõ ràng cho phép bạn kiểm soát nơi một tiền tố được lưu vào bộ nhớ cache kết thúc. GitHub báo cáo số lượng token lời nhắc cần xử lý mới giảm hơn 50% trên hàng tỷ yêu cầu.
Những gì OpenAI đã công bố
Mọi con số dưới đây đều lấy từ tài liệu ra mắt của OpenAI. Cài đặt mức độ nỗ lực suy luận xuất hiện trong dấu ngoặc đơn, bởi vì các mô hình này đạt điểm rất khác nhau ở các mức độ nỗ lực khác nhau và một hàng điểm chuẩn không có cài đặt nỗ lực thì không phải là một con số có thể sử dụng được.
| Điểm chuẩn | GPT-6 Luna | Điểm so sánh |
|---|---|---|
| DeepSWE 1.1 | 66.6% (tối đa) | Tương đương Claude Opus 5 và Claude Fable 5 ở mức trung bình, rẻ hơn 93% mỗi tác vụ so với Opus 5 và rẻ hơn 96% so với Fable 5 |
| AutomationBench 1.0.6 | Vượt trội hơn thế hệ trước 5.4 điểm (cao) | Với chi phí mỗi tác vụ thấp hơn 58% |
| OSWorld 2.0 ngoại tuyến | Vượt trội hơn GPT-5.6 Sol (trung bình) ở mức nỗ lực tối đa | Với chi phí khoảng một phần mười |
| Tính chính xác | Tương đương GPT-5.6 Sol ở mức nỗ lực cao hơn | Với chi phí khoảng một phần trăm |
Hàng DeepSWE là điều đáng chú ý. Một mô hình có giá $0.10 cho mỗi triệu token đầu vào đạt 66.6% trên điểm chuẩn kỹ thuật phần mềm đại lý, cùng phạm vi với hai mô hình tiên tiến ở mức nỗ lực trung bình, và rẻ hơn 93% mỗi tác vụ so với một trong số đó, là một đề xuất khác hẳn so với một hạng ngân sách. Điều đó không có nghĩa là Luna thay thế một mô hình tiên tiến trong công việc khó khăn nhất của bạn. Nó có nghĩa là ranh giới giữa “chuyển tác vụ này đến mô hình giá rẻ” và “tác vụ này cần mô hình đắt tiền” đã dịch chuyển, và bất kỳ nơi nào bạn đã vạch ra ranh giới đó trước tháng 9 năm 2026 giờ đây đã bị đặt sai chỗ.
Kết quả về tính chính xác là điều có khả năng quan trọng nhất đối với công việc sản phẩm thông thường. Đạt được độ chính xác thực tế tương đương với hạng trung của thế hệ trước, với chi phí chỉ khoảng một phần trăm, là điều khiến Luna khả thi cho việc tóm tắt và trích xuất hướng người dùng thay vì chỉ các công việc xử lý hàng loạt nội bộ.
Mọi so sánh ở đây đều với Claude Opus 5
Lưu ý mô hình Claude nào mà các hàng đó được so sánh. Claude Opus 5.
Anthropic đã phát hành Claude Opus 5.5 cùng ngày, với giá $4/$20 so với Opus 5 là $5/$25, và nó đã chiếm vị trí dẫn đầu trên Chỉ số Trí tuệ Phân tích Nhân tạo ở mức 58, xếp thứ nhất trong số 212 mô hình. Bài đăng ra mắt của OpenAI được viết trước khi Opus 5.5 tồn tại, vì vậy mọi so sánh chi phí trên mỗi tác vụ với Opus 5 đều được đo lường với một mô hình đã bị thay thế trong vòng vài giờ sau khi công bố.
Điều đó không làm cho các số liệu của OpenAI sai. Chúng chính xác cho so sánh đã được thực hiện. Điều đó có nghĩa là bạn không nên đưa “rẻ hơn 93% so với Opus 5” vào tài liệu mua sắm như tình trạng hiện tại của thị trường mà không nói rõ đó là Opus nào. Chưa có nhà cung cấp nào công bố so sánh trực tiếp Luna với Opus 5.5, và các so sánh đang lưu hành trên mạng xã hội đến từ các tester cá nhân chứ không phải từ bất kỳ phòng thí nghiệm nào. Trụ cột cuộc chiến giá cả AI của chúng tôi theo dõi cả ba lần ra mắt so với nhau trong một bảng.
Độ trễ: mô hình giá rẻ không phải là mô hình nhanh
Các phép đo của bên thứ ba từ Artificial Analysis đặt GPT-6 Luna ở mức 153.9 token đầu ra mỗi giây với thời gian cho token đầu tiên là 124.23 giây. Hai lưu ý quan trọng cần được áp dụng. Đây là số liệu của bên thứ ba, không phải do nhà cung cấp công bố. Và chúng được đo trên biến thể suy luận tối đa, cấu hình chậm nhất và đắt nhất hiện có.
Ngay cả với cả hai lưu ý, hướng đi vẫn đáng để suy ngẫm: Luna đo được thời gian cho token đầu tiên chậm hơn Sol, vốn là 102.15 giây. Giá và độ trễ không tương quan trong dòng mô hình này. Thời gian chờ hai phút trước khi token đầu tiên đến sẽ phá vỡ giới hạn thời gian chờ mặc định của client HTTP, làm bộ cân bằng tải trở nên không hoạt động, và vượt quá giới hạn thực thi trên hầu hết các runtime phi máy chủ. Nếu bạn đang định tuyến một điểm cuối đồng bộ đến Luna ở mức nỗ lực cao, công việc tích hợp sẽ nằm ở lớp thời gian chờ và truyền tải của bạn, chứ không phải trong lời nhắc của bạn.
Hãy kiểm tra với khối lượng công việc của riêng bạn trước khi định tuyến đến nó
Các bảng điểm chuẩn là tổng hợp. Lời nhắc của bạn thì không. Câu hỏi hữu ích là liệu Luna có đáp ứng được lưu lượng truy cập của bạn ở mức độ nỗ lực mà bạn có thể chi trả, và việc trả lời đúng câu hỏi đó mất khoảng mười phút.
Thiết lập một yêu cầu cho mỗi mô hình, tham số hóa ID mô hình và chạy cùng tải trọng trên toàn bộ hạng:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "Extract every endpoint, method and required parameter from the OpenAPI document below as JSON.",
    "reasoning": { "effort": "high" }
  }'
Xác nhận tên điểm cuối và tham số dựa trên tài liệu tham chiếu mô hình hiện tại của OpenAI trước khi bạn xây dựng dựa trên cấu trúc này. ID mô hình gpt-6-luna là phần được xác nhận từ tài liệu ra mắt.
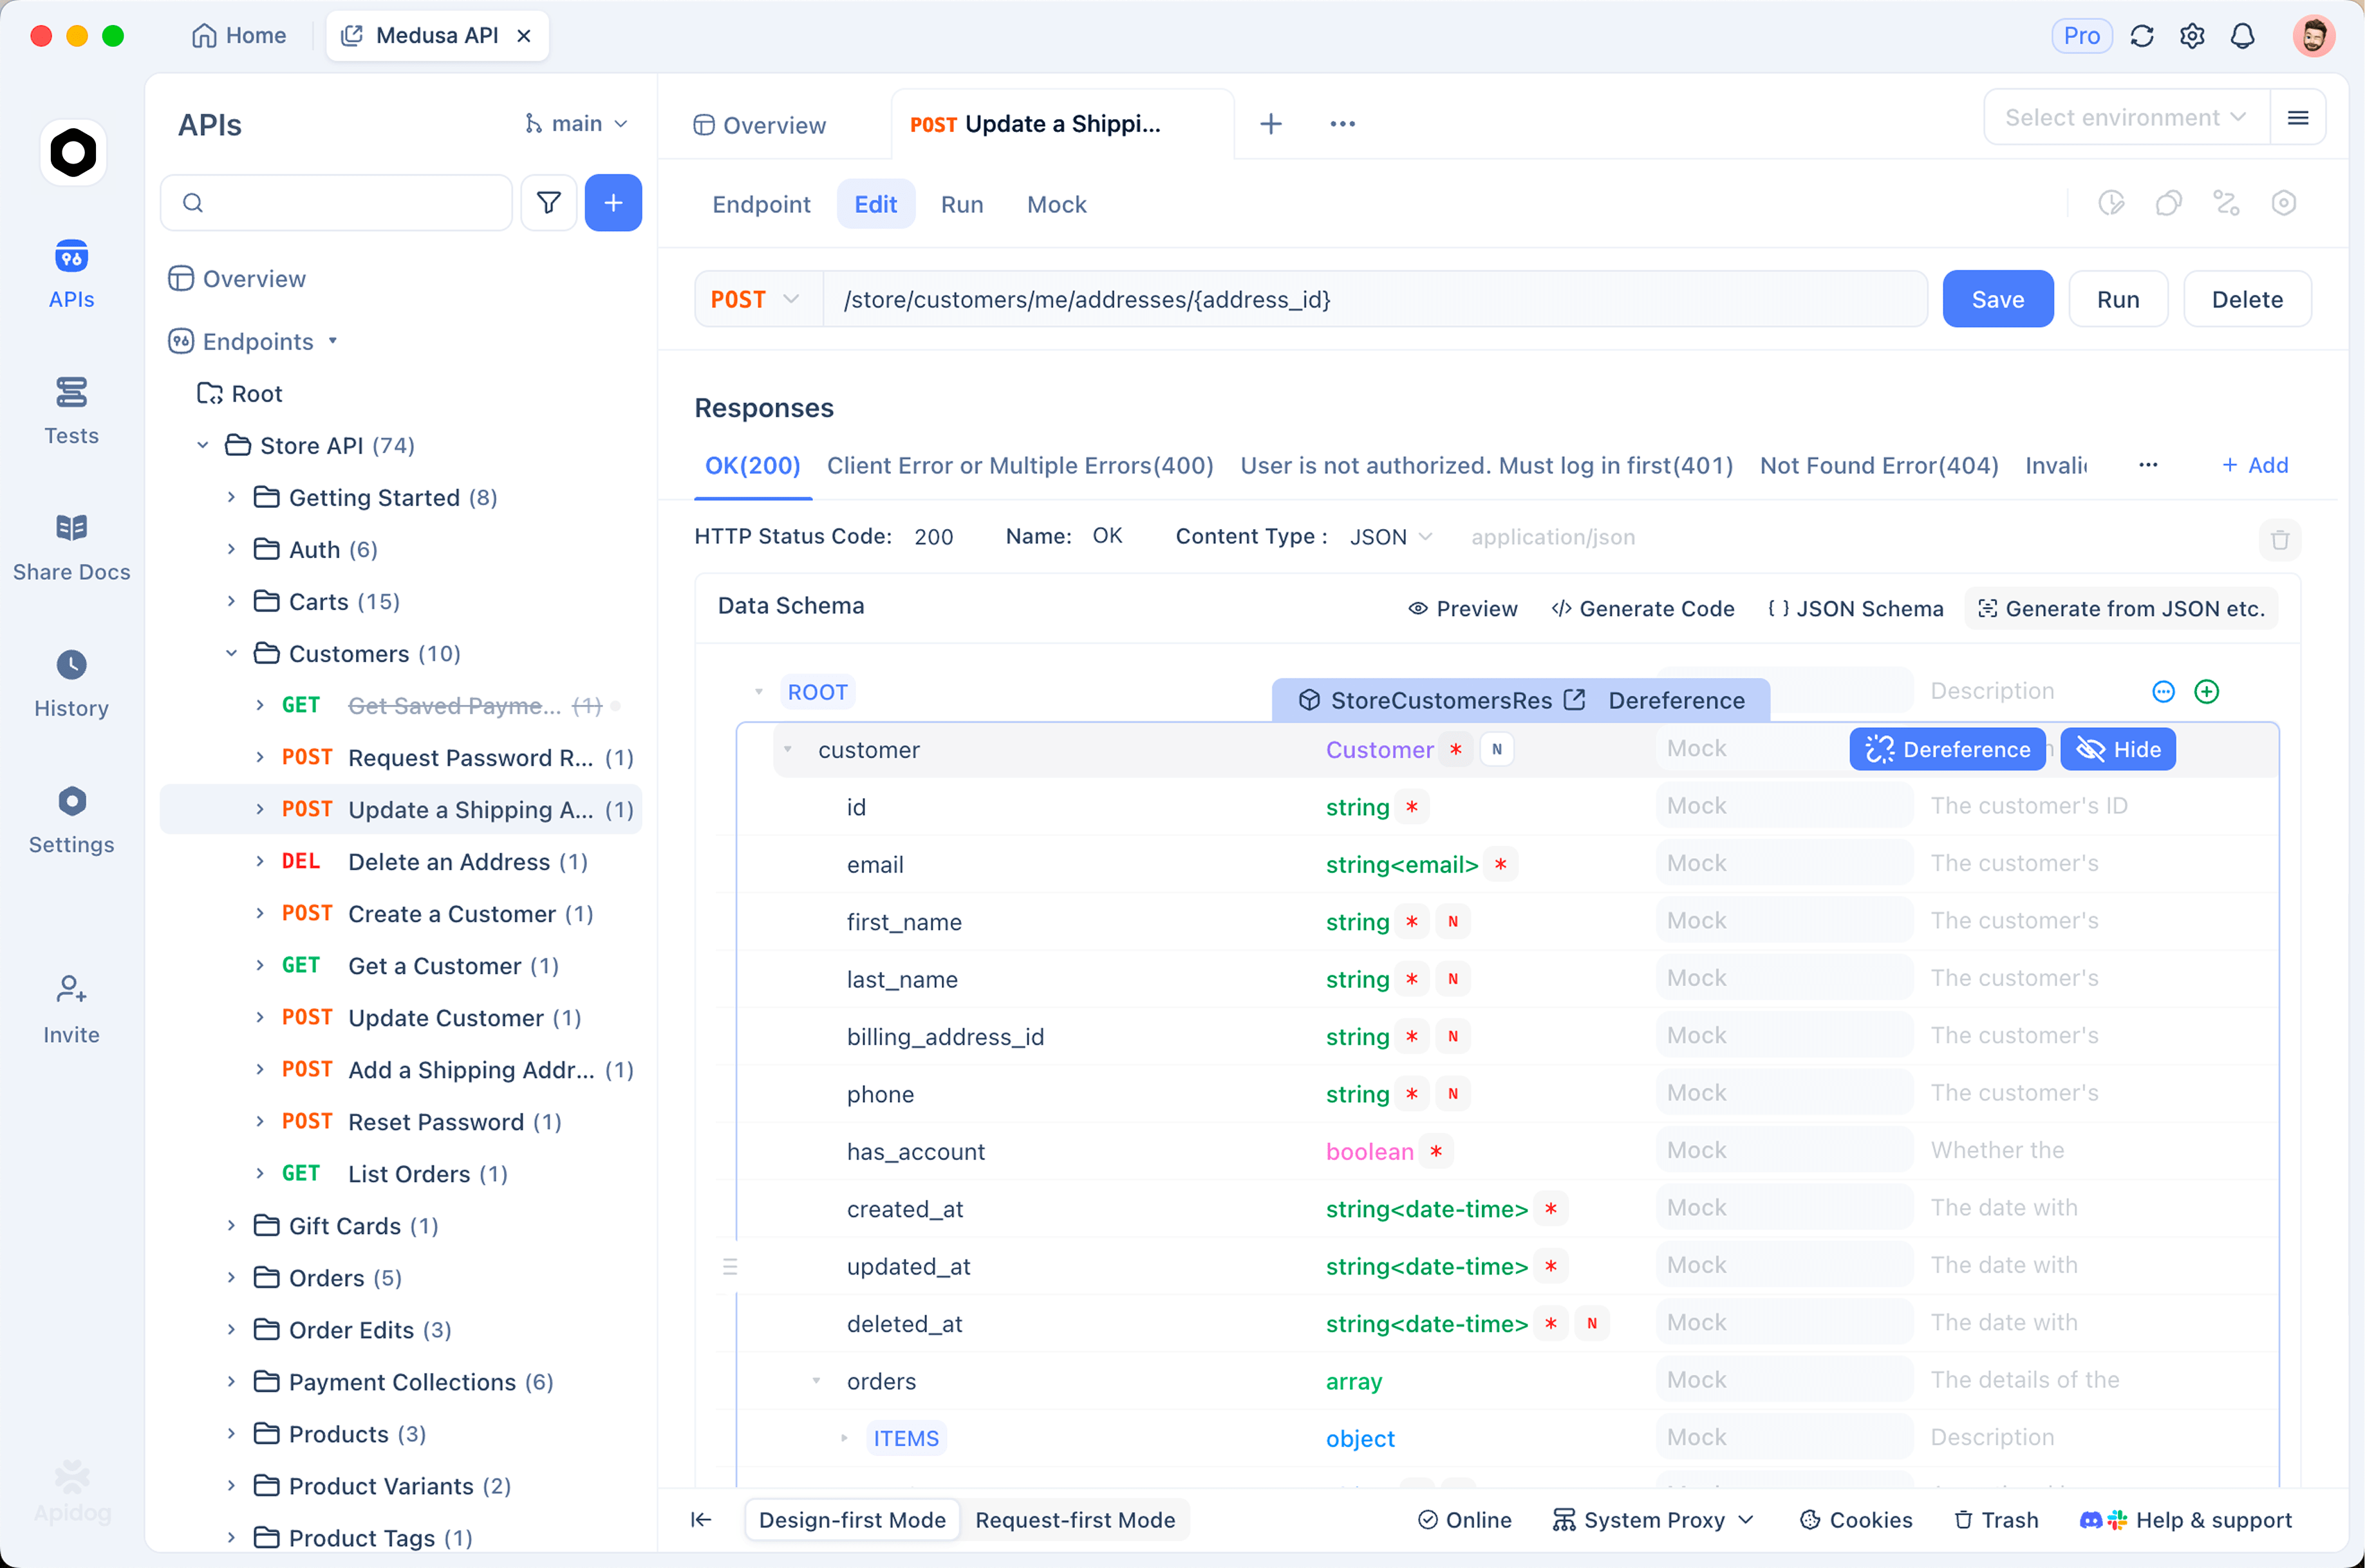
Trong Apidog, cùng một yêu cầu trở thành một điểm cuối đã lưu với ID mô hình là một biến môi trường, vì vậy một bộ sưu tập có thể bao gồm Luna, Sol và Astra mà không cần trùng lặp bất cứ thứ gì. Chạy nó như một kịch bản thử nghiệm và bạn sẽ nhận được thời gian phản hồi và mức sử dụng token cho mỗi lần chạy, cộng với các xác nhận về hình dạng phản hồi, đây là điều nắm bắt được chế độ lỗi thực sự của một mô hình rẻ hơn: không phải một câu trả lời sai, mà là một phản hồi không còn tuân thủ schema JSON mà trình phân tích cú pháp của bạn mong đợi. Chạy cùng một kịch bản ở ba mức độ nỗ lực và bạn sẽ có một bảng chi phí, độ trễ và độ tin cậy cho các lời nhắc của riêng bạn thay vì cho bộ điểm chuẩn của người khác.
Khi nào Luna là lựa chọn đúng đắn
Định tuyến đến Luna khi tải trọng lớn, tác vụ được xác định rõ ràng và bạn có thể xác minh đầu ra bằng lập trình. Trích xuất tài liệu, phân tích đặc tả, phân loại nhật ký, tạo kiểm thử, phân loại khối lượng lớn và bất kỳ công việc xử lý hàng loạt nào mà cửa sổ 1 triệu token giúp bạn tiết kiệm một đường ống phân đoạn đều đủ điều kiện, và ưu đãi bộ nhớ cache sẽ tăng lên khi một tiền tố dài giữ ổn định qua các lệnh gọi.
Giữ hạng đắt tiền cho công việc mà bạn không thể kiểm tra câu trả lời một cách rẻ tiền, và cho bất kỳ điều gì nhạy cảm về độ trễ cho đến khi bạn đã đo thời gian token đầu tiên trên lưu lượng truy cập của riêng bạn. Luna đã dịch chuyển ranh giới. Nó không xóa bỏ nó.