
Google đã làm mới cấp độ Flash của mình vào ngày 21 tháng 7 năm 2026, và Gemini 3.5 Flash-Lite là phiên bản tiết kiệm chi phí nhất trong số đó. Đây là mô hình Gemini rẻ nhất, nhanh nhất mà bạn có thể sử dụng hiện nay, được xây dựng cho các công việc có khối lượng lớn, nhạy cảm về độ trễ: phân loại, trích xuất, trả lời tin nhắn ngắn và các câu trả lời truy xuất đơn giản, nơi mà thông lượng và chi phí quan trọng hơn suy luận sâu sắc. Nếu bạn đang gửi hàng triệu yêu cầu nhỏ mỗi ngày, đây là cấp độ mà Google muốn bạn sử dụng trong quy trình hoạt động chính của mình.
Đợt làm mới đã ra mắt ba mô hình cùng lúc, và cách đặt tên có thể khiến mọi người bối rối, vì vậy hãy làm rõ điều đó một cách nhanh chóng rồi đi sâu vào thông số kỹ thuật, giá cả, điểm chuẩn và cách bạn tự kiểm tra điểm cuối.
Gemini 3.5 Flash-Lite là gì?
Gemini 3.5 Flash-Lite là mô hình nhỏ nhất, rẻ nhất trong dòng Gemini của Google. Nó được tối ưu hóa cho tốc độ và khối lượng, không phải cho các tác vụ suy luận phức tạp nhất. Google ước tính nó có thể tạo ra khoảng 350 token đầu ra mỗi giây, do đó các phản hồi gần như tức thì ngay cả khi tải nặng. Bạn có thể gọi nó thông qua Gemini API với ID mô hình là gemini-3.5-flash-lite.
Hãy nghĩ về nó như cấp độ bạn nhắm đến các công việc tẻ nhạt, lặp đi lặp lại, có tần suất cao. Gắn thẻ các yêu cầu hỗ trợ. Trích xuất các trường từ một tài liệu. Trả lời một câu hỏi ngắn từ một đoạn văn bản được truy xuất. Cung cấp năng lượng cho một tiện ích trò chuyện cần phản hồi trước khi người dùng nhận thấy độ trễ. Trong mỗi trường hợp đó, bạn đang gửi rất nhiều yêu cầu và bạn muốn mỗi yêu cầu đều rẻ và nhanh chóng. Flash-Lite là câu trả lời của Google cho loại khối lượng công việc đó.
Nó ra mắt như một phần của đợt làm mới Flash gồm ba mô hình: mô hình chủ lực mới Gemini 3.6 Flash, Gemini 3.5 Flash-Lite này, và một mô hình bảo mật có kiểm soát gọi là Gemini 3.5 Flash Cyber. Bạn có thể đọc thông tin chi tiết của Google trên blog của Google và chi tiết mô hình trên trang DeepMind Flash. Flash-Lite nằm ở cuối bảng về giá và ở đầu bảng về tốc độ thô.
Khoan đã, tại sao lại là 3.5 mà không phải 3.6?
Đây là phần gây bối rối. Mô hình chủ lực mới là Gemini 3.6 Flash. Nhưng Flash-Lite vẫn giữ phiên bản 3.5, và mô hình bảo mật Cyber có kiểm soát cũng vậy. Vì vậy, một lần ra mắt, một ngày, ba mô hình, hai số phiên bản. Đó không phải là lỗi đánh máy của Google hay sai sót trong bài viết này. Google đã phát hành các phiên bản hỗn hợp: Flash chủ lực đã nhảy lên 3.6, trong khi các biến thể Lite và Cyber vẫn giữ nhãn 3.5.
Tại sao Google lại làm vậy? Số phiên bản theo dõi mô hình, chứ không phải sự kiện ra mắt. Mô hình chủ lực đã có một bước tiến lớn hơn về thế hệ, vì vậy nó có nhãn 3.6. Flash-Lite cũng là một mô hình mới, nhưng Google đã chọn giữ nó cùng dòng với 3.5. Khó theo dõi, nhưng đó là cách các nhãn này được đặt.
Một nguồn gây nhầm lẫn khác đáng được làm rõ ngay bây giờ. Gemini 3.5 Flash-Lite không phải là Gemini 3.1 Flash-Lite cũ từ thế hệ trước. Cùng tên “Flash-Lite”, nhưng là mô hình khác, số khác. Nếu bạn đã xây dựng trên 3.1 Flash-Lite trước đây, đây là phiên bản thay thế mới hơn, nhanh hơn, chứ không phải là đổi tên của những gì bạn đã có. Hãy kiểm tra ID mô hình trước khi bạn giả định: gemini-3.5-flash-lite là phiên bản mới.
Thông số kỹ thuật và giá cả
Dưới đây là chi phí và cách Flash-Lite hoạt động. Tất cả giá đều tính trên mỗi triệu token thông qua Gemini API.
| Thuộc tính | Giá trị |
|---|---|
| ID mô hình | gemini-3.5-flash-lite |
| Giá đầu vào | $0.30 / 1 triệu token |
| Giá đầu ra | $2.50 / 1 triệu token |
| Tốc độ | ~350 token đầu ra/giây |
| Cấp độ miễn phí | Có (Google AI Studio, giới hạn tần suất) |
| Bộ nhớ đệm ngữ cảnh | $0.03 / 1 triệu token + $1.00 / 1 triệu/giờ lưu trữ |
Mức giá đầu vào $0.30 và đầu ra $2.50 đó là mức giá công bố rẻ nhất trong dòng sản phẩm Gemini hiện tại. Để so sánh, mô hình chủ lực 3.6 Flash có giá $1.50 đầu vào và $7.50 đầu ra, vì vậy Flash-Lite có chi phí đầu vào chỉ bằng khoảng một phần năm và chi phí đầu ra bằng một phần ba. Khi bạn xử lý hàng triệu cuộc gọi ngắn, sự khác biệt đó là điều cốt yếu. Bạn có thể xác nhận các con số hiện tại trên tài liệu giá của Gemini API, vì Google cập nhật trang đó trực tiếp.
Bộ nhớ đệm ngữ cảnh giúp giảm chi phí hơn nữa cho các lời nhắc bạn gửi lặp đi lặp lại, chẳng hạn như lời nhắc hệ thống cố định hoặc tài liệu tham khảo dài. Bạn trả một mức phí nhỏ để lưu trữ các token cùng với phí lưu trữ theo giờ, và đầu vào đã được lưu trữ sẽ rẻ hơn nhiều khi được sử dụng lại.
Hiệu suất của nó như thế nào?
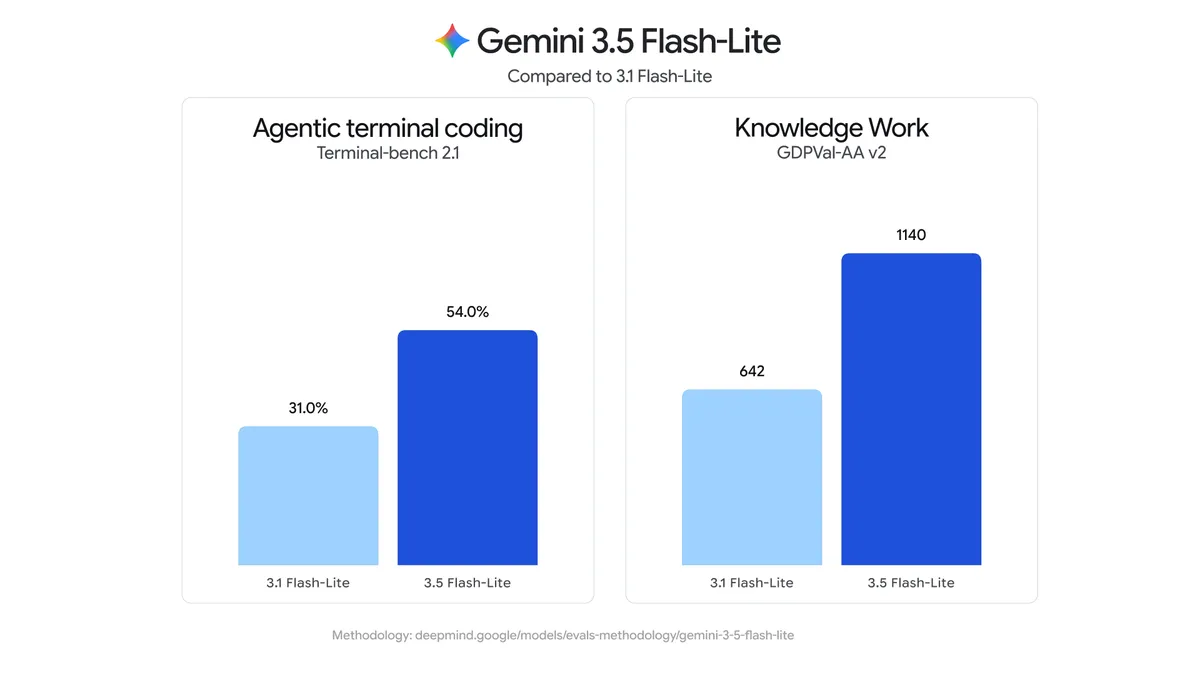
Con số nổi bật: Gemini 3.5 Flash-Lite đạt 54% trên Terminal-Bench 2.1, tăng từ 31% so với phiên bản tiền nhiệm. Đó là một bước nhảy vọt đáng kể đối với một mô hình lớp Lite, và nó có nghĩa là cấp độ nhỏ này hiện thực sự hữu ích cho các tác vụ mà trước đây nó thường bỏ qua.
Những lĩnh vực nó vượt trội: phân loại, trích xuất, phản hồi trò chuyện và các câu trả lời đơn giản được bổ trợ truy xuất. Đó là những công việc mà một mô hình nhanh, rẻ cho thấy giá trị của mình. Sắp xếp đầu vào thành các nhóm, trích xuất dữ liệu có cấu trúc từ văn bản lộn xộn, trả lời một câu hỏi ngắn dựa trên một đoạn văn được truy xuất, duy trì khả năng phản hồi của một trợ lý nhẹ. Flash-Lite xử lý tất cả những điều đó tốt và nhanh chóng.
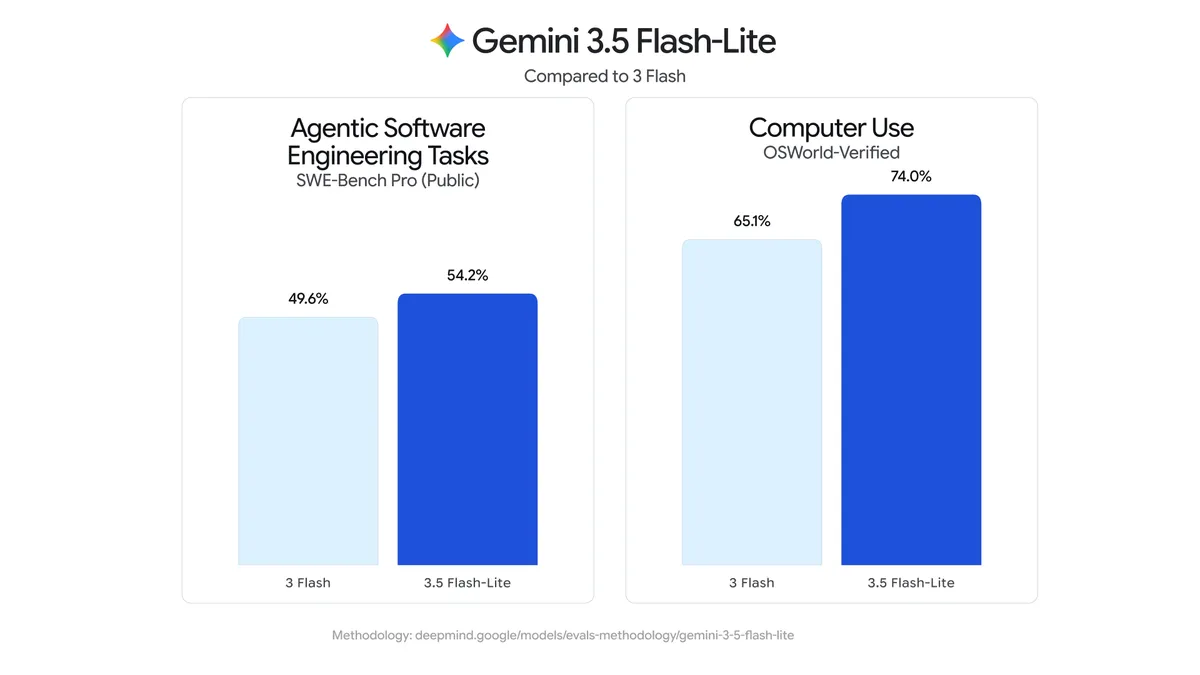
Giờ là giới hạn thực tế. Flash-Lite đánh đổi chất lượng lấy chi phí và tốc độ. Nó không phải là mô hình dành cho các tác vụ lập trình tác tử khó nhất, chuỗi công cụ nhiều bước dài hoặc các vấn đề suy luận sâu sắc. Khi một tác vụ cần lập kế hoạch qua nhiều bước, gọi các công cụ một cách đáng tin cậy theo trình tự hoặc suy luận qua một cơ sở mã phức tạp, bạn sẽ muốn Gemini 3.6 Flash hoặc một mô hình lớn hơn. Chọn Flash-Lite cho công việc đó sẽ giúp tiết kiệm tiền cho đến khi các câu trả lời sai khiến bạn phải trả nhiều hơn số tiền bạn đã tiết kiệm. Hãy chọn cấp độ phù hợp với tác vụ.
Google sử dụng Flash-Lite ở đâu
Google không chỉ bán Flash-Lite cho các nhà phát triển. Họ đang tích hợp mô hình này vào Google Tìm kiếm. Đó là một tín hiệu hữu ích: khi Google đưa một mô hình vào xử lý lưu lượng truy cập quy mô tìm kiếm, họ đang đặt cược rằng mô hình đủ nhanh và đủ rẻ để chạy trên một số lượng lớn truy vấn mà không gặp vấn đề về độ trễ hoặc ngân sách.
Đối với bạn, đó là một bằng chứng. Các đặc tính tương tự khiến Flash-Lite phù hợp với Tìm kiếm, thông lượng cao và chi phí thấp cho mỗi lần gọi, chính xác là những gì khiến nó phù hợp với một điểm cuối sản xuất bận rộn. Nếu nó có thể phục vụ lưu lượng tìm kiếm, nó có thể phục vụ quy trình phân loại của bạn.
Flash-Lite vs Gemini 3.6 Flash: bạn nên chọn cái nào?
Phiên bản ngắn gọn: chọn Flash-Lite khi công việc đơn giản, khối lượng lớn và nhạy cảm về tốc độ. Chọn 3.6 Flash khi công việc yêu cầu suy luận mạnh hơn, lập trình hoặc công việc tác tử nhiều bước.
Flash-Lite vượt trội về giá cả và độ trễ. Đây là mô hình Gemini rẻ nhất và chạy ở tốc độ khoảng 350 token mỗi giây, vì vậy nó là lựa chọn mặc định phù hợp cho phân loại, trích xuất, trò chuyện ngắn và RAG đơn giản ở quy mô lớn. Gemini 3.6 Flash tốn kém hơn mỗi token nhưng suy luận mạnh hơn, lập trình tốt hơn và giữ vững hiệu suất trong các quy trình làm việc tác tử mà Flash-Lite sẽ gặp khó khăn. Giá của 3.6 Flash phản ánh điều đó: bạn trả tiền cho khả năng bổ sung.
Một mô hình thực tế là định tuyến theo độ khó. Gửi các cuộc gọi dễ, thường xuyên đến Flash-Lite và chuyển các cuộc gọi khó đến 3.6 Flash. Bạn nhận được thông lượng rẻ cho phần lớn lưu lượng truy cập và suy luận mạnh hơn chỉ khi nó xứng đáng với chi phí của nó. Để so sánh đầy đủ về tốc độ, giá cả và chất lượng, hãy xem Gemini 3.5 Flash-Lite vs 3.6 Flash.
Cách truy cập và kiểm tra nó
Flash-Lite chạy trên Gemini API. Cách nhanh nhất để bắt đầu là Google AI Studio: lấy một khóa API, và cấp độ miễn phí cho phép bạn thử mô hình trước khi bạn thiết lập thanh toán. Lưu ý rằng cấp độ miễn phí bị giới hạn tần suất, và Google có thể sử dụng dữ liệu cấp độ miễn phí để cải thiện sản phẩm của mình, vì vậy hãy giữ các đầu vào nhạy cảm trên một khóa trả phí. Tài liệu tham khảo đầy đủ có tại tài liệu Gemini API. Đặt mô hình thành gemini-3.5-flash-lite và bạn đang gọi cấp độ rẻ nhất.
Khi các yêu cầu của bạn hoạt động, bạn muốn chúng tiếp tục hoạt động. Giá cả, giới hạn tần suất và cấu trúc phản hồi thay đổi khi Google cập nhật API, và một mô hình Lite nhanh nhưng đôi khi sai cần các khẳng định để phát hiện sai lệch. Đó là lúc một ứng dụng khách API hữu ích. Với Apidog, bạn có thể xây dựng yêu cầu POST đến điểm cuối Gemini, lưu khóa API của bạn dưới dạng biến môi trường để nó không bao giờ nằm trong phần thân yêu cầu, và thêm các khẳng định về mã trạng thái và các trường JSON mà bạn phụ thuộc vào.
Từ đó, bạn có thể biến yêu cầu đó thành một bài kiểm tra hồi quy đã lưu và lên lịch chạy để bạn có thể phát hiện phản hồi bị hỏng hoặc thay đổi giá trước khi người dùng của bạn phát hiện. Apidog không chạy mô hình hoặc thay thế Gemini API; nó là ứng dụng khách bạn sử dụng để gọi, xác thực và giám sát điểm cuối. Tải xuống Apidog nếu bạn muốn kiểm tra điểm cuối gemini-3.5-flash-lite cùng với phần còn lại của ngăn xếp API của bạn.
Câu hỏi thường gặp
Gemini 3.5 Flash-Lite có giống Gemini 3.6 Flash không? Không. Chúng là hai mô hình khác nhau từ cùng đợt làm mới vào ngày 21 tháng 7 năm 2026. Flash-Lite là cấp độ rẻ nhất, nhanh nhất cho các công việc đơn giản, khối lượng lớn. 3.6 Flash là mô hình chủ lực đắt hơn với khả năng suy luận và lập trình mạnh mẽ hơn.
Tại sao lại là 3.5 mà không phải 3.6? Phiên bản hỗn hợp. Google đã nâng cấp mô hình chủ lực Flash lên 3.6, nhưng vẫn giữ Flash-Lite và mô hình Cyber có kiểm soát ở nhãn 3.5 trong cùng một lần ra mắt. Con số này theo dõi dòng mô hình, chứ không phải ngày ra mắt.
Đây có phải là Gemini 3.1 Flash-Lite cũ không? Không. Gemini 3.5 Flash-Lite là một mô hình mới hơn. Gemini 3.1 Flash-Lite cũ là thế hệ trước. Cùng tên họ, nhưng là mô hình và phiên bản khác, vì vậy hãy kiểm tra ID mô hình gemini-3.5-flash-lite để chắc chắn bạn đang sử dụng phiên bản mới.
Gemini 3.5 Flash-Lite có miễn phí không? Có một cấp độ miễn phí thông qua Google AI Studio, và nó bị giới hạn tần suất. Nó tốt cho việc thử nghiệm và sử dụng nhẹ. Đối với khối lượng sản xuất, bạn chuyển sang khóa API trả phí, và Google có thể sử dụng dữ liệu cấp độ miễn phí để cải thiện sản phẩm của mình.
Flash-Lite tốt nhất ở việc gì? Phân loại, trích xuất, trả lời tin nhắn ngắn và các câu trả lời đơn giản được bổ trợ truy xuất ở khối lượng lớn. Nó không phải là lựa chọn cho lập trình tác tử khó hoặc suy luận nhiều bước dài, những tác vụ mà 3.6 Flash phù hợp hơn.