
DeepSeek đã khai tử mô hình hàng đầu của mình bằng mô hình nhỏ nhất. Vào ngày 10 tháng 9 năm 2026, DeepSeek-V4.1-Flash đã được phát hành rộng rãi (GA) trên API, và thông báo phát hành có một dòng mà hầu hết các phòng thí nghiệm sẽ giấu đi: bắt đầu từ ngày 14 tháng 9, mọi yêu cầu tới deepseek-v4-pro sẽ được định tuyến tới V4.1-Flash và tính phí theo giá Flash. Mô hình Flash 552 tỷ tham số, với 8 tỷ tham số hoạt động khi nhập liệu, giờ đây chịu trách nhiệm cho toàn bộ dòng V4.
Đó là câu chuyện đằng sau các tìm kiếm "deepseek v4.1 flash" trong tuần này, và nó quan trọng vì hai lý do. Thứ nhất, kiến trúc này hoàn toàn mới. Sự phân chia Causal Encoder-Decoder, bộ nhớ đệm KV FP4 với 890 byte mỗi token, và khả năng thị giác tự nhiên ngay từ bước huấn luyện trước tiên không phải là những thay đổi nhỏ đối với DeepSeek V4. Thứ hai, bảng giá cũng thay đổi theo. Nếu bạn đang trả mức giá của V4-Pro, hóa đơn của bạn sẽ giảm 70% trở lên vào ngày 14 dù bạn có thay đổi gì hay không.
Hướng dẫn này bao gồm những gì đã được phát hành, kiến trúc hoạt động như thế nào theo thuật ngữ của nhà phát triển, các tiêu chuẩn mà nhà cung cấp công bố, và cách tính giá. Cuối cùng là một quy trình làm việc để kiểm tra mô hình với các câu lệnh của riêng bạn trong Apidog, bởi vì một bảng tiêu chuẩn chỉ là điểm khởi đầu, không phải là phán quyết cuối cùng.
TL;DR
- DeepSeek-V4.1-Flash đã GA kể từ ngày 10 tháng 9 năm 2026. ID mô hình:
deepseek-flash. URL cơ sở không đổi tạihttps://api.deepseek.com. - 552B MoE (763B với bộ mã hóa thị giác), 8B hoạt động cho prefill, 16B hoạt động cho decode. Ngữ cảnh 1M, đầu ra tối đa 384K.
- Theo số liệu của DeepSeek, nó đánh bại V4-Pro về HumanEval, GSM8K, DeepSWE và Terminal-Bench.
- Giá cao điểm: 0,30 đô la mỗi 1 triệu đầu vào cache-miss, 1,20 đô la mỗi 1 triệu đầu ra. Giá thấp điểm bằng một nửa.
- Các yêu cầu V4-Pro sẽ được định tuyến lại đến V4.1-Flash vào ngày 14 tháng 9 lúc 04:00 UTC.
Những gì được phát hành vào ngày 10 tháng 9
DeepSeek đã chạy phiên beta nội bộ kéo dài hai ngày từ ngày 8 tháng 9 với tên mô hình deepseek-v4.1-flash-expires-on-0910, giới hạn 20 yêu cầu đồng thời mỗi tài khoản và có giá tương tự như deepseek-v4-flash. TechNode đã đưa tin về phiên beta đó. Hai ngày sau, mô hình được phát hành rộng rãi (GA), với mục changelog đề ngày 2026-09-10 và một thông báo trên X.
Ba thay đổi tên quan trọng đối với mã của bạn:
- ID mô hình mới là
deepseek-flash. Sử dụng nó cho các tích hợp mới. - Các tên cũ
deepseek-v4-flashvàdeepseek-v4-flash-vision-expvẫn được nhận diện, nhưng chúng được phục vụ bởi V4.1-Flash. V4-Flash và V4-Flash-Vision-Exp đã ngừng hoạt động như các mô hình riêng biệt. deepseek-v4-provẫn hoạt động cho đến ngày 14 tháng 9, sau đó được định tuyến đến V4.1-Flash.
URL cơ sở không thay đổi: https://api.deepseek.com cho định dạng OpenAI, https://api.deepseek.com/anthropic cho định dạng Anthropic. API Responses đã được hỗ trợ trên dòng Flash, vì vậy các tích hợp kiểu Codex vẫn được giữ nguyên. Để biết chi tiết tham số, bao gồm đầu vào hình ảnh và nỗ lực suy luận, hãy xem cách sử dụng API DeepSeek-V4.1-Flash.
Kiến trúc Causal Encoder-Decoder dành cho nhà phát triển
Thẻ mô hình mô tả một thiết kế mà DeepSeek gọi là Causal Encoder-Decoder, hay CED. Đây là ý nghĩa của từng con số khi bạn là người trả tiền cho các token.
552 tỷ tham số, 763 tỷ với tầm nhìn. Xương sống ngôn ngữ là một mô hình chuyên gia hỗn hợp 552 tỷ tham số. Thêm bộ mã hóa DeepSeek-ViT, được huấn luyện từ đầu cho phiên bản này, và mô hình hoàn chỉnh đạt 763 tỷ. Đó là các tham số được lưu trữ, không phải chi phí của một yêu cầu.
8 tỷ hoạt động cho prefill, 16 tỷ hoạt động cho decode. Đây là thay đổi nổi bật. 40 lớp được chia thành 20 lớp bộ mã hóa và 20 lớp bộ giải mã. Đọc câu lệnh của bạn (prefill) kích hoạt khoảng 8 tỷ tham số mỗi token. Viết câu trả lời (decode) kích hoạt khoảng 16 tỷ. Các mô hình DeepSeek MoE trước đây sử dụng một ngân sách tham số hoạt động cho cả hai giai đoạn.
Tại sao sự phân chia đó lại quan trọng? Prefill bị giới hạn bởi tính toán: bạn đẩy một tài liệu 200 nghìn token qua mô hình trong một lần. Decode bị giới hạn bởi bộ nhớ: bạn tạo ra từng token một, và chi phí là đọc trọng số và bộ nhớ đệm KV từ HBM. Ít tham số hơn trong prefill cắt giảm thời gian đến token đầu tiên trên các đầu vào dài. Nhiều hơn trong decode mua chất lượng câu trả lời khi chi phí tính toán bổ sung rẻ hơn so với lưu lượng bộ nhớ. Một tác vụ của tác nhân 1 triệu ngữ cảnh tạo ra phản hồi 2 nghìn token sẽ đi theo con đường rẻ hơn cho 99,8% số token của nó.
384 chuyên gia được định tuyến cộng với 1 chuyên gia chia sẻ mỗi lớp. Bộ định tuyến chọn một vài trong số 384 chuyên gia mỗi token, và chuyên gia chia sẻ chạy mọi lúc. Đó là cách 552 tỷ tham số được lưu trữ trở thành 8 tỷ hoặc 16 tỷ hoạt động.
CSA2 và bộ nhớ đệm KV FP4. Compressed Sparse Attention 2 đi kèm với ba chế độ chú ý tĩnh. Kết hợp với bộ nhớ FP4 cho bộ nhớ đệm KV chính, dấu vết bộ nhớ đệm toàn cầu là 890 byte mỗi token, khoảng một phần tư của DeepSeek-V4-Flash. Thông báo phát hành nói rằng đó là 1/4 HBM và 1/8 dung lượng lưu trữ SSD so với thế hệ trước. Với 890 byte mỗi token, một ngữ cảnh 1M-token hoàn chỉnh cần khoảng 0,9 GB bộ nhớ đệm KV. Đó là một phần lý do tại sao giới hạn đồng thời là 2.500 đối với Flash so với 500 đối với Pro.
Ngữ cảnh 1M, đầu ra 384K. Chú ý thưa thớt được huấn luyện ở 64K và mở rộng lên 1M ở mốc 34T-token của một kho ngữ liệu đa phương thức 45T-token. Nỗ lực suy luận được mô tả là có thể điều khiển liên tục theo thang điểm từ 1 đến 100; hình dạng tham số API chính xác cho thang điểm đó là [XÁC MINH] so với tài liệu.
Điểm chuẩn: DeepSeek báo cáo những gì
Mỗi con số trong phần này là do DeepSeek báo cáo từ thẻ mô hình. Chưa có đánh giá độc lập nào được công bố tính đến ngày 10 tháng 9. Hãy đọc chúng như tuyên bố của nhà cung cấp, sau đó tự chạy thử nghiệm của riêng bạn.
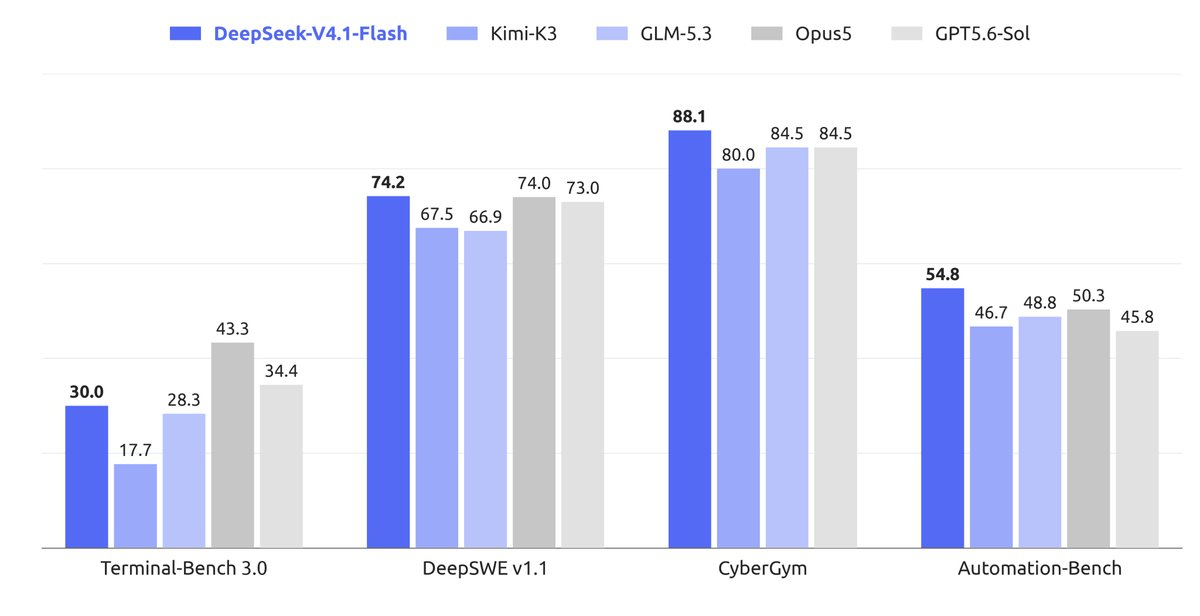
Mô hình nhất quán: V4.1-Flash vượt trội hơn V4-Pro trên mọi hàng, với khoảng cách rộng nhất về mã hóa tác nhân. DeepSWE tăng 11,5 điểm so với Pro và gần 20 điểm so với Flash cũ. GSM8K đã bão hòa, vì vậy lợi thế 0,4 điểm nói lên rất ít.
Điểm thị giác, cũng do nhà cung cấp báo cáo: MMMU-Pro 56.5, CVBench 77.9, DocVQA 95.6, RefCOCO 86.0. DocVQA là con số đáng chú ý, vì phân tích tài liệu là nơi mà hầu hết lưu lượng thị giác sản xuất đi đến.
DeepSeek đã định hình việc định tuyến lại V4-Pro bằng cách cho rằng V4.1-Flash "đã vượt qua V4 Pro một cách toàn diện về hiệu suất, chi phí, tốc độ và tổng thời gian", trích dẫn các thử nghiệm của nhiều bên. Các bên này không được nêu tên. Hãy coi câu nói đó là một tuyên bố mà bạn có thể kiểm chứng.
Giá cả và việc định tuyến lại V4-Pro
Mức giá dưới đây lấy từ trang giá, có hiệu lực từ ngày 10 tháng 9 lúc 04:00 UTC, tính bằng USD trên 1 triệu token.
| deepseek-flash thấp điểm | deepseek-flash cao điểm | deepseek-v4-pro thấp điểm | deepseek-v4-pro cao điểm | |
|---|---|---|---|---|
| Đầu vào, cache hit | $0.003 | $0.006 | $0.022 | $0.044 |
| Đầu vào, cache miss | $0.15 | $0.30 | $0.66 | $1.32 |
| Đầu ra | $0.60 | $1.20 | $1.98 | $3.96 |
Giờ cao điểm là từ 01:00 đến 04:00 và từ 06:00 đến 10:00 UTC vào các ngày trong tuần; giờ thấp điểm bằng 50% giờ cao điểm. Bộ nhớ đệm ngữ cảnh tự động, và một cache hit có giá rẻ hơn 50 lần so với một cache miss ở cả hai cấp.
So với mức giá tháng 8 của V4-Flash, V4.1-Flash cắt giảm đầu vào cache-hit khoảng 57%, đầu vào cache-miss khoảng 32%, và đầu ra khoảng 9%.
Cột V4-Pro là cột đáng chú ý. Sau ngày 14 tháng 9, một yêu cầu được gửi đến deepseek-v4-pro sẽ trả tiền theo cột Flash. Vào giờ cao điểm, đó là 0,30 đô la thay vì 1,32 đô la cho mỗi 1 triệu đầu vào cache-miss (giảm 77%) và 1,20 đô la thay vì 3,96 đô la cho mỗi 1 triệu đầu ra (giảm 70%). Bạn sẽ được giảm giá mà không cần chạm vào mã, mặc dù bạn vẫn nên cập nhật ID mô hình thay vì phụ thuộc vào một biệt danh đã ngừng hoạt động. Hướng dẫn di chuyển sẽ chỉ cho bạn danh sách kiểm tra, và phân tích sâu về giá bao gồm cách tính toán cache-hit cho các phiên tác nhân dài.
Đánh giá V4.1-Flash với các câu lệnh của riêng bạn trong Apidog
Bảng của nhà cung cấp nói rằng mô hình rất tốt ở DeepSWE. Nó không nói liệu nó có xử lý được sơ đồ trích xuất của bạn, định dạng gọi công cụ của bạn hay 300 nghìn bản ghi hỗ trợ của bạn hay không. Dưới đây là một quy trình làm việc trong Apidog giúp trả lời những câu hỏi đó trong một buổi chiều và tiếp tục trả lời chúng sau mỗi lần cập nhật mô hình im lặng.
- Lưu khóa dưới dạng biến môi trường. Tạo một môi trường Apidog và thêm
DEEPSEEK_API_KEYtừ nền tảng DeepSeek. Tham chiếu nó trong tiêu đề Authorization dưới dạngBearer {{DEEPSEEK_API_KEY}}. - Thêm điểm cuối. Tạo
POST https://api.deepseek.com/chat/completions, hoặc nhập một đặc tả OpenAPI. - Lưu một yêu cầu cho mỗi câu lệnh thực tế. Lấy năm đến mười câu lệnh từ nhật ký sản xuất và lưu mỗi câu lệnh dưới dạng yêu cầu riêng với
"model": "deepseek-flash". Giữ một bản sao trỏ tớideepseek-v4-procho đến ngày 14 để bạn có thể so sánh các đầu ra cạnh nhau. - Phát trực tiếp và xem các sự kiện. Đặt
"stream": true. Apidog hiển thị phản hồi SSE từng sự kiện một, vì vậy các thay đổi suy luận và thay đổi câu trả lời xuất hiện riêng biệt thay vì một loạt các dòngdata:. Đây là cách nhanh nhất để xem thời gian đến token đầu tiên trên một prefill dài. - Thêm các xác nhận và xây dựng một kịch bản thử nghiệm. Xác nhận mã trạng thái, trên trường
tool_callsnơi bạn mong đợi một, và trên tính hợp lệ của JSON của đầu ra. Nối các yêu cầu đã lưu thành một kịch bản thử nghiệm. - Chạy lại mỗi khi có cập nhật mô hình. Khi DeepSeek đẩy thay đổi tiếp theo sau
deepseek-flash, hãy chạy kịch bản. Kết nối nó vào CI vớiapidog-cliđể nó chạy mỗi lần triển khai.
Đây là phần thân cho một trong những câu lệnh đã lưu đó, sử dụng OpenAI SDK:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {"role": "system", "content": "Extract the order ID, SKU list, and refund amount as JSON."},
        {"role": "user", "content": "Ticket #48213: customer wants a refund of $42.90 for SKUs KB-220 and MS-114 from order ORD-99117."},
    ],
    stream=True,
)

for chunk in response:
    if chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="")
Tải xuống Apidog và dán phần thân đó vào một yêu cầu đã lưu. Apidog kiểm tra lớp API, không phải máy chủ mô hình, vì vậy những gì bạn thấy là phản hồi mà người dùng của bạn sẽ nhận được.
FAQ
DeepSeek-V4.1-Flash có phải là sự thay thế cho V4-Pro không? Vâng, theo quyết định của DeepSeek. Từ ngày 14 tháng 9 lúc 04:00 UTC, các yêu cầu deepseek-v4-pro sẽ được phục vụ bởi V4.1-Flash với giá Flash. Không còn mô hình nào lớn hơn trong dòng API V4.
Tôi có cần thay đổi ID mô hình của mình không? Không ngay lập tức. deepseek-v4-flash, deepseek-v4-flash-vision-exp, và (sau ngày 14) deepseek-v4-pro đều được phân giải thành V4.1-Flash. Hãy chuyển sang deepseek-flash khi bạn chạm vào tích hợp lần tiếp theo. Hướng dẫn API có đầy đủ tài liệu tham khảo tham số.
8B prefill / 16B decode có ý nghĩa gì đối với độ trễ? Ít tham số hoạt động hơn trên đầu vào có nghĩa là thời gian đến token đầu tiên nhanh hơn trên các lời nhắc dài. Nhiều hơn trên đầu ra có nghĩa là tính toán đi đến nơi chất lượng tạo ra được quyết định. Bộ nhớ đệm KV 890 byte/token giữ cho các phiên dài có chi phí thấp khi lưu trong bộ nhớ.
Tôi có thể chạy nó cục bộ không? Trọng số được cấp phép MIT trên Hugging Face. Riêng phần xương sống đã nặng khoảng 552 GB ở 8-bit hoặc 280 GB ở 4-bit, vì vậy đây là một dự án đa GPU hoặc truyền tải SSD, không phải dự án dành cho máy tính xách tay. Hỗ trợ công cụ suy luận ngày không là [XÁC MINH].
Các điểm chuẩn có độc lập không? Không. Mọi điểm số trên đều đến từ thẻ mô hình của DeepSeek. Báo cáo kỹ thuật có phương pháp luận.
Dòng V4 còn lại những gì
DeepSeek đã gộp một API hai mô hình thành một. Đặt cược là một mô hình 552 tỷ tham số với ngân sách giải mã 16 tỷ, bộ nhớ đệm KV kích thước bằng một phần tư và 2.500 phiên đồng thời mỗi tài khoản sẽ phục vụ các tác vụ tác nhân tốt hơn một mô hình lớn hơn với giá gấp ba đến bốn lần. Các con số của nhà cung cấp ủng hộ sự đặt cược; khối lượng công việc của bạn sẽ quyết định liệu nó có đúng không.
Hãy trỏ SDK của bạn đến deepseek-flash, chạy các câu lệnh của riêng bạn qua nó trước ngày 14, và giữ kịch bản kiểm thử. Nếu bạn đã xây dựng trên API V4-Flash ban đầu, tích hợp của bạn đã hoạt động. Điều thay đổi là mô hình đằng sau nó, và đó là phần đáng để đo lường.