
Cùng Together AI, Fireworks AI và Groq đều đưa ra cùng một luận điểm: hãy trỏ client OpenAI hiện có của bạn đến một URL cơ sở mới, thay đổi key và bạn sẽ có được các mô hình open-weight với chi phí chỉ là một phần. Luận điểm đó là đúng. Điều không đúng là việc so sánh các gói miễn phí của họ lại đơn giản như việc xếp ba con số cạnh nhau, bởi vì hai trong số ba nhà cung cấp không hề công bố một con số cố định nào.
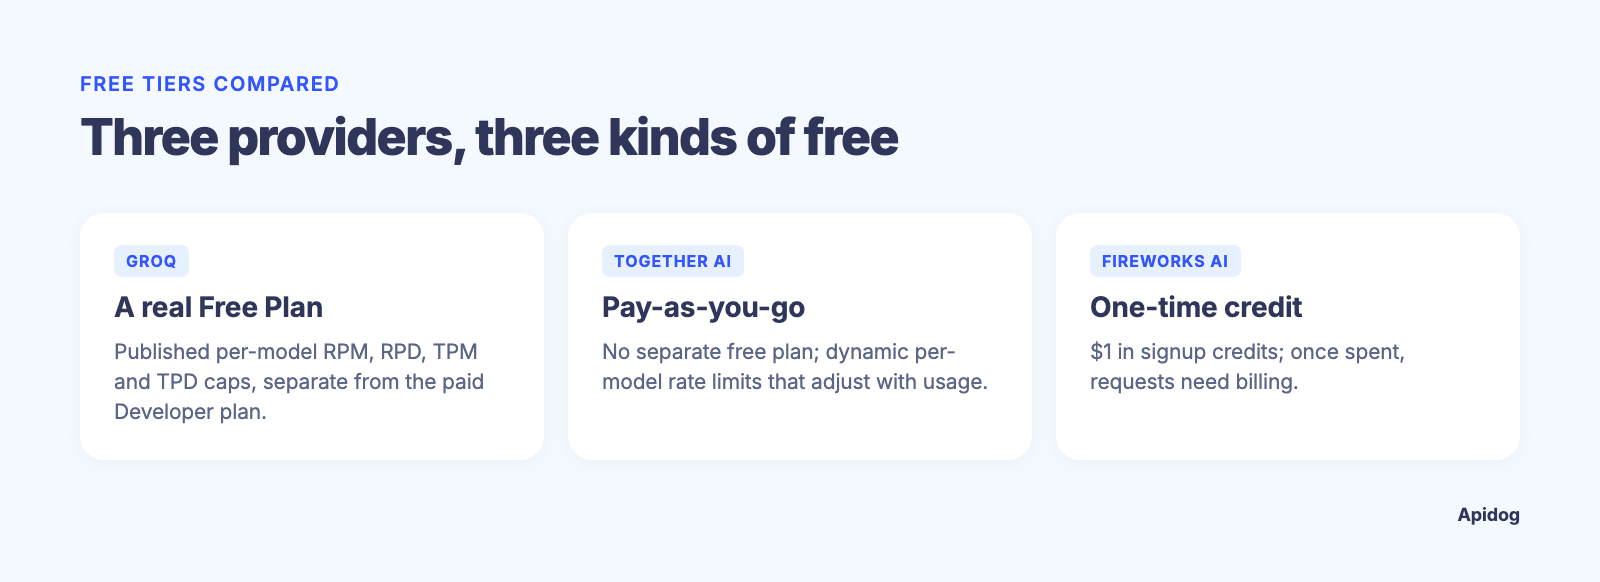
Groq là ngoại lệ: trang giới hạn tốc độ của nó thực sự công bố các con số Kế hoạch Miễn phí thực tế, theo từng mô hình, trong một tab mà hầu hết người đọc sẽ lướt qua trên đường tìm đến tab Kế hoạch Nhà phát triển bên cạnh nó. Together AI đã thẳng thừng nói với chúng tôi trong tài liệu của họ rằng họ không có giới hạn cố định theo mô hình để công bố; giới hạn của bạn sẽ di chuyển theo mức sử dụng của bạn. Fireworks AI liên kết quyền truy cập miễn phí của mình với một số tín dụng sử dụng một lần thay vì một cấp độ gói. Ba thiết kế khác nhau, và một bài viết "gói miễn phí nào lớn hơn" vẫn không thể giảm nó xuống thành một con số duy nhất.
TÓM TẮT (TL;DR)
Groq, Together AI và Fireworks AI đều phơi bày một điểm cuối tương thích với OpenAI, vì vậy việc chuyển đổi giữa chúng chỉ là thay đổi URL cơ sở và khóa API, chứ không phải viết lại toàn bộ code. Groq chia quyền truy cập thành Kế hoạch Miễn phí và Kế hoạch Nhà phát triển trả phí, và không giống như hai bên còn lại, nó công bố các con số miễn phí thực tế theo mô hình, chẳng hạn như 30 RPM / 1K RPD / 8K TPM / 200K TPD trên gpt-oss-120b và gpt-oss-20b. Together AI không công bố các con số gói miễn phí cố định; tài liệu của họ cho biết giới hạn thay đổi một cách linh hoạt theo năng lực hoạt động trực tiếp và mức sử dụng thành công gần đây của bạn. Fireworks AI cung cấp cho các tài khoản mới một số tín dụng dùng một lần ($1, theo trang giá của họ) thay vì một hạn mức miễn phí lặp lại. Quyết định quan trọng hơn con số trên tiêu đề là bạn thực sự cần những mô hình nào và giới hạn của mỗi nhà cung cấp hoạt động như thế nào một khi bạn chạm đến giới hạn đó. Apidog cho phép bạn tiết kiệm một yêu cầu và hoán đổi URL cơ sở và khóa cho từng môi trường, để bạn có thể tự đo lường cả ba thay vì tin vào một bảng so sánh.
CÙNG MỘT CẤU TRÚC API, BA KHÓA KHÁC NHAU
Cả ba nhà cung cấp đều cố tình phản chiếu lược đồ (schema) Chat Completions của OpenAI. Đó là lý do tại sao các hướng dẫn di chuyển sang các công cụ này đều đọc giống nhau mỗi lần: thay đổi base_url, thay đổi header Authorization, giữ nguyên phần còn lại của code. Cơ sở tương thích OpenAI của Groq là https://api.groq.com/openai/v1/. Của Together AI là https://api.together.ai/v1, được xác nhận trực tiếp trong tài liệu quickstart của họ. Của Fireworks AI là https://api.fireworks.ai/inference/v1, theo hướng dẫn tương thích OpenAI của họ.
Cấu trúc chung này là lý do tại sao việc kiểm tra trực tiếp là rất đáng làm: việc thêm nhà cung cấp thứ tư hoặc thứ năm chỉ tốn vài phút, chứ không cần thiết kế lại. Chúng tôi đề cập đến cơ chế quản lý loại thiết lập đa nhà cung cấp đó trong bài viết cách quản lý URL cơ sở giữa các môi trường trong Apidog, và nếu bạn đang xem xét các tùy chọn định tuyến rộng hơn, bài tổng hợp về các giải pháp thay thế OpenRouter của chúng tôi sẽ đề cập đến vị trí của cả ba bên này trong bức tranh đó.
NHỮNG GÌ BẠN THỰC SỰ CÓ THỂ XÁC NHẬN VỀ CÁC GÓI MIỄN PHÍ
Đây là so sánh được xây dựng hoàn toàn từ những gì mỗi nhà cung cấp công bố công khai tính đến tháng 9 năm 2026. Khi một nhà cung cấp không tiết lộ con số, bảng sẽ ghi điều đó thay vì đoán.
| Groq | Together AI | Fireworks AI | |
|---|---|---|---|
| Loại quyền truy cập miễn phí | Kế hoạch Miễn phí (riêng biệt với Kế hoạch Nhà phát triển trả phí) | Thanh toán theo sử dụng ngay khi đăng ký; không có tên "gói miễn phí" riêng | Tín dụng đăng ký một lần |
| Hạn mức miễn phí được ghi lại | Công bố theo mô hình: 30 RPM, 1K RPD, 8K TPM, 200K TPD cho gpt-oss-120b và gpt-oss-20b; compound 30 RPM, 250 RPD, 70K TPM (theo giới hạn tốc độ của Groq, đọc ngày 2026-09-15) |
Không công bố theo con số cố định; mô tả là động theo tổ chức | $1 trong tín dụng miễn phí cho mỗi giá của Fireworks |
| Cách giới hạn được thiết lập | Giới hạn theo mô hình RPM/RPD/TPM/TPD, được thực thi ở cấp độ tổ chức | Tốc độ động cho từng mô hình, điều chỉnh theo năng lực hoạt động thực tế và mức sử dụng thành công gần đây của bạn | Dựa trên chi tiêu; một khi tín dụng được sử dụng hết, các yêu cầu cần kích hoạt thanh toán |
| Nơi kiểm tra con số của riêng bạn | console.groq.com/settings/limits |
Headers phản hồi trên các cuộc gọi trực tiếp, ví dụ: x-ratelimit-reset |
Bảng điều khiển tài khoản và trang thanh toán |
| Token được lưu trong bộ nhớ có tính vào giới hạn không? | Không, theo tài liệu của Groq | Không đề cập trong các trang chúng tôi kiểm tra | Không đề cập trong các trang chúng tôi kiểm tra |
Hai điều nổi bật sau khi bạn thực sự đọc các trang nguồn thay vì đọc bản tóm tắt đặc điểm kỹ thuật. Thứ nhất, các con số của Kế hoạch Miễn phí của Groq ở trên là các giá trị mặc định được công bố; trang đó cũng có một tab Kế hoạch Nhà phát triển với các giới hạn cao hơn, và console.groq.com/settings/limits là thẩm quyền nếu giới hạn của bạn khác. Thứ hai, việc giới hạn tốc độ của Together AI không phải là một bảng. Trang giới hạn tốc độ của họ nói rõ rằng "không có giới hạn cố định nào được công bố cho từng mô hình," và giới hạn của bạn sẽ tăng lên với "lưu lượng truy cập thành công và bền vững." Đó là một mô hình khác biệt hoàn toàn so với một hàng cố định của gói miễn phí, và điều đó có nghĩa là câu trả lời trung thực cho câu hỏi "RPM miễn phí của Together là gì" là "kiểm tra các header phản hồi," chứ không phải một con số được lấy từ bảng.
Nếu bạn muốn các bài phân tích chuyên sâu về từng nhà cung cấp với các con số có thể kiểm chứng cho một sản phẩm tại một thời điểm, hãy xem các bài viết đồng hành của chúng tôi về Gói miễn phí Groq API và Gói miễn phí Cerebras API. Bài viết này là trung tâm; hai bài kia sẽ thực hiện việc đào sâu theo từng nhà cung cấp một cách đầy đủ.
YÊU CẦU VÀ TOKEN, CỐ ĐỊNH VÀ ĐỘNG
Sự khác biệt về thiết kế thực sự giữa ba bên này không phải là kích thước của hạn mức miễn phí, mà là hình dạng của giới hạn.
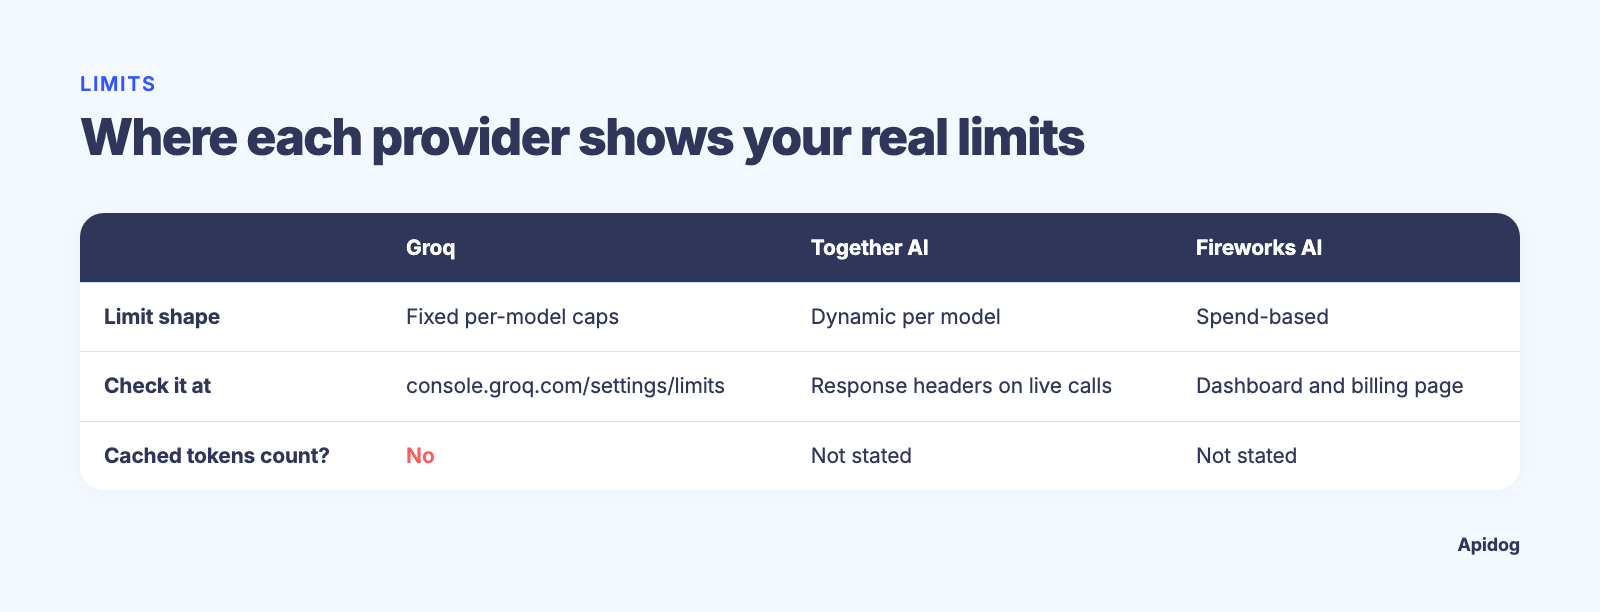
Mô hình của Groq là cái mà hầu hết các nhà phát triển đã biết khi làm việc với giới hạn tốc độ ở nơi khác: một giới hạn cố định cho mỗi cửa sổ thời gian, được chia theo RPM, RPD, TPM và TPD, và nó được áp dụng ở cấp độ tổ chức thay vì theo từng khóa API. Điều đó có nghĩa là nếu bạn tạo ba khóa cho ba dịch vụ dưới một tài khoản Groq, chúng chia sẻ một nhóm. Hướng dẫn chung của chúng tôi về giới hạn tốc độ API GPT đề cập đến cấu trúc RPM/TPM tương tự này một cách sâu hơn nếu bạn chưa làm việc với các giới hạn dựa trên token.
Mô hình của Together AI thưởng cho lưu lượng truy cập ổn định và thành công thay vì trừng phạt lưu lượng đột biến bằng một bức tường cứng. Một tài khoản yên tĩnh và một tài khoản nặng, hoạt động tốt sẽ không có cùng giới hạn, bởi vì giới hạn sẽ điều chỉnh theo lịch sử và năng lực hoạt động thực tế gần đây của tài khoản bạn và năng lực hoạt động của mô hình vào thời điểm đó. Đó là tin tốt nếu khối lượng công việc của bạn là ổn định, và là một điều chưa rõ ràng nếu lưu lượng truy cập của bạn vốn dĩ là đột biến.
Fireworks AI hầu như loại bỏ thiết kế giới hạn tốc độ cho người dùng mới bằng cách liên kết giai đoạn miễn phí với một số tiền thay vì một cửa sổ tốc độ yêu cầu. Bạn không bị giới hạn bởi tốc độ bạn gọi API; bạn bị giới hạn bởi số tiền các cuộc gọi của bạn tốn trước khi số dư hết. Điều này thay đổi câu hỏi lập kế hoạch từ "bao nhiêu yêu cầu mỗi phút" thành "1 đô la có thể mua bao nhiêu token tại mức giá mỗi token của mô hình này," điều này hoàn toàn phụ thuộc vào mô hình bạn chọn.
Chúng là những canh bạc khác nhau về loại sử dụng mà một gói "miễn phí" nên bảo vệ: khối lượng duy trì, các đột biến đột ngột, hay tổng chi tiêu. Dù bạn xây dựng dựa trên cái nào, bạn cuối cùng cũng sẽ gặp lỗi 429, và cách nhà cung cấp báo hiệu thời điểm đó quan trọng như con số đã gây ra nó. Hướng dẫn khắc phục sự cố vượt quá giới hạn tốc độ của chúng tôi sẽ hướng dẫn bạn cách đọc các header phản hồi đó và xây dựng logic thử lại mà không làm vấn đề trở nên tồi tệ hơn.
TỰ KIỂM TRA TRONG NĂM PHÚT
Với việc rất nhiều dữ liệu này nằm sau màn hình đăng nhập hoặc trong header phản hồi trực tiếp, con đường nhanh nhất đến câu trả lời thực sự không phải là một bài viết về bản mô tả kỹ thuật khác, mà là một bài kiểm tra mà agent mã hóa của bạn chạy trên cả ba. Với Apidog CLI đó, chỉ cần một prompt. Thiết lập nó một lần:
npm install -g apidog-cli@latest
apidog login --with-token
npx -y skills add https://apidog.com   # chọn agent của bạn khi được nhắc
Token đến từ Apidog trong mục Cài đặt Tài khoản, API Access Token. Sau đó hãy đưa một prompt cho agent:
Sử dụng Apidog CLI trên dự án . Tạo các môi trường Groq, Together và Fireworks với URL cơ sở tương thích OpenAI từ bài viết này và một id mô hình có thể so sánh trong biến MODEL. Thêm POST /chat/completions với quyền xác thực Bearer từ {{API_KEY}} và một ca kiểm thử với prompt giống hệt và max_tokens. Chạy nó một lần cho mỗi môi trường với key của nhà cung cấp đó, sau đó so sánh trạng thái, độ trễ và các header x-ratelimit.
Các lệnh mà nó chạy, được kiểm tra với Apidog CLI 2.2.7:
apidog environment create Groq --project  --base-url https://api.groq.com/openai/v1
apidog environment create Together --project  --base-url https://api.together.ai/v1
apidog environment create Fireworks --project  --base-url https://api.fireworks.ai/inference/v1
apidog cli-schema validate test-case-create --file chat-case.json
apidog test-case create --project  --file chat-case.json
apidog run --test-case  --project  -e  \
  --env-var "API_KEY=$TOGETHER_API_KEY" -r cli,json
Việc chuyển đổi nhà cung cấp giờ đây là một ID môi trường, không phải một lần viết lại code. Các header là nơi giới hạn động của Together AI thể hiện theo thời gian thực và là nơi bạn có thể xác nhận tổ chức Groq của mình khớp với bảng Kế hoạch Miễn phí đã công bố. Hãy giữ độ trễ trong so sánh: một mô hình về mặt kỹ thuật miễn phí nhưng chậm thì thực sự không rẻ sau khi bạn tính thời gian bỏ ra để xoay xở với nó. Điều này biến ba trang tiếp thị thành một tập dữ liệu có thể so sánh được từ tài khoản của chính bạn. Chạy so sánh liên tục bên trong một build agent lớn hơn? Hướng dẫn của chúng tôi về các công cụ kiểm thử API cho agent AI đề cập đến điều đó, và Apidog CLI trong Cursor cho thấy cách thiết lập agent.
GÓI MIỄN PHÍ NÀO PHÙ HỢP VỚI TRƯỜNG HỢP CỦA BẠN
Chỉ dựa trên những gì có thể kiểm chứng ngày nay, một vài khuyến nghị trung thực:
- Giới hạn cố định theo mô hình bạn có thể đọc mà không cần đăng nhập: Groq công bố các con số Kế hoạch Miễn phí thực tế (30 RPM / 1K RPD / 8K TPM / 200K TPD trên các mô hình
gpt-oss), và cửa sổ ngữ cảnh 131.072 token của nó trên các mô hìnhllama-3.1-8b-instant,llama-3.3-70b-versatilevàopenai/gpt-ossbao quát một phạm vi công việc open-weight rộng trên một điểm cuối. - Lưu lượng truy cập ổn định, hành vi tốt, không muốn theo dõi giới hạn tốc độ: Mô hình động của Together AI phù hợp với quy luật đó; việc sử dụng thành công bền vững sẽ nâng giới hạn của bạn theo thời gian thay vì giới hạn bạn ở một con số được đặt từ ngày đầu tiên.
- Thiết lập không ma sát, thoải mái chạm vào giới hạn chi tiêu: Quyền truy cập miễn phí dựa trên tín dụng của Fireworks AI kiểm tra giá thực tế theo token ngay từ cuộc gọi đầu tiên, hữu ích khi câu hỏi thực sự là chi phí ở quy mô lớn thay vì số lượng yêu cầu.
Cả ba đều lưu trữ các tập hợp con khác nhau của các mô hình open-weight, và một mô hình phù hợp với nhiệm vụ của bạn trên một nhà cung cấp có thể không tồn tại trên nhà cung cấp khác.
HỎI ĐÁP THƯỜNG GẶP (FAQ)
Together AI, Fireworks AI và Groq có đều sử dụng SDK của OpenAI không? Có. Cả ba đều ghi lại các điểm cuối tương thích với OpenAI, vì vậy thư viện client openai tiêu chuẩn hoạt động với bất kỳ bên nào sau khi bạn thay đổi URL cơ sở và key.
Nhà cung cấp nào có gói miễn phí lớn nhất? Không theo cách mà bạn có thể so sánh trực tiếp. Groq công bố các con số Kế hoạch Miễn phí thực tế cho từng mô hình (30 RPM / 1K RPD / 8K TPM / 200K TPD trên gpt-oss-120b/gpt-oss-20b), Together AI không thiết lập một con số cố định nào cả, và Fireworks AI liên kết quyền truy cập miễn phí với một số tín dụng dùng một lần thay vì một hạn mức. Hãy kiểm tra console.groq.com/settings/limits nếu của bạn khác.
Giới hạn tốc độ được áp dụng cho từng key API hay cho từng tài khoản? Đối với Groq, giới hạn được áp dụng ở cấp độ tổ chức, vì vậy nhiều khóa dưới một tài khoản chia sẻ cùng một nhóm, theo tài liệu giới hạn tốc độ của họ. Together AI và Fireworks AI không nêu rõ điều này trong các trang chúng tôi đã kiểm tra; hãy xác minh trong bảng điều khiển của riêng bạn trước khi cho rằng điều ngược lại.
Điều gì xảy ra khi tôi chạm đến giới hạn tốc độ trên bất kỳ nhà cung cấp nào trong số này? Bạn sẽ nhận được phản hồi HTTP 429. Chi tiết khác nhau; hãy xem hướng dẫn vượt quá giới hạn tốc độ của chúng tôi để biết cách đọc các header thử lại mà hầu hết các API tương thích với OpenAI trả về, và xây dựng logic giảm tải (backoff) thay vì đoán.
Có cách nào nhanh hơn để so sánh những điều này thay vì tự mình đọc từng trang tài liệu không? Hãy để agent mã hóa của bạn chạy một ca kiểm thử Apidog CLI trên ba môi trường, như đã mô tả ở trên. Hai mươi phút với Apidog CLI sẽ cho bạn biết nhiều điều về khối lượng công việc thực tế của bạn hơn là bất kỳ bảng so sánh nào, bao gồm cả bảng này.