
Để chạy Qwen 3.8 27B tại chỗ, hãy cài đặt Ollama và chạy ollama pull qwen3.8:27b, sau đó là ollama run qwen3.8:27b. Bản dựng mặc định là bản tải xuống 4-bit dung lượng 18 GB, vì vậy bạn cần một GPU có 24 GB VRAM hoặc một máy Mac có 32 GB bộ nhớ hợp nhất. Trọng số mô hình được phát hành theo giấy phép Apache-2.0, nên bản thân mô hình hoàn toàn miễn phí. Chi phí duy nhất của bạn là phần cứng và điện năng.
Đó là phiên bản tóm tắt. Phần còn lại của bài hướng dẫn này sẽ đề cập đến bốn công cụ chạy mô hình đáng dùng nhất (Ollama, LM Studio, llama.cpp và MLX), mỗi mức lượng tử hóa cần bao nhiêu bộ nhớ, tốc độ dự kiến trên phần cứng thực tế, và cách để agent lập trình của bạn kiểm tra endpoint cục bộ bằng Apidog CLI sau khi mô hình đã khởi chạy.
Mới làm quen với dòng sản phẩm này? Bài viết Qwen 3.8 là gì giới thiệu về phiên bản flagship Max với 2,4 nghìn tỷ tham số. Bài hướng dẫn này tập trung vào "người anh em" nhỏ gọn, dạng dense, vừa vặn trên bàn làm việc của bạn.
Qwen 3.8 27B là gì?
Qwen 3.8 27B là một mô hình ngôn ngữ-thị giác dạng dense với 27 tỷ tham số, do đội ngũ Qwen của Alibaba phát hành vào tháng 8 năm 2026 theo giấy phép Apache-2.0. Nó có thể đọc văn bản, hình ảnh và video, mặc định suy luận trước khi trả lời, và sở hữu cửa sổ ngữ cảnh gốc 262.144 token, có thể mở rộng lên 1 triệu token với YaRN scaling.
Thẻ mô hình chính thức liệt kê các thông số kỹ thuật sau:
| Thông số | Qwen 3.8 27B |
|---|---|
| Tham số | 27B dense (Hub liệt kê 28B bao gồm cả vision encoder) |
| Lớp | 64, kết hợp giữa các khối Gated DeltaNet và Gated Attention |
| Ngữ cảnh | 262.144 gốc, tối đa 1.000.000 với YaRN |
| Đầu vào | Văn bản, hình ảnh, video |
| Suy luận | Bật theo mặc định, reasoning_effort là xhigh, medium hoặc low |
| Tính năng bổ sung | Các lớp dự đoán đa token (MTP) |
| Giấy phép | Apache-2.0 |
Trên bảng benchmark của chính Qwen, nó đạt 61,7 điểm trên SWE-bench Pro, 73,0 trên Terminal Bench 2.1 và 89,2 trên GPQA Diamond. Đây là số liệu từ nhà cung cấp. Bài phân tích benchmark Qwen 3.8 của chúng tôi giải thích cách đọc bảng này, bao gồm cả những dòng số liệu mà Qwen tự thực hiện nội bộ.
Vì sao điều này quan trọng khi chạy tại chỗ: một mô hình dense 27B ở mức 4-bit có thể nằm gọn trên một GPU phổ thông, với gọi công cụ, thị giác và suy luận đều trong cùng một tệp.
Bạn cần bao nhiêu RAM và VRAM cho Qwen 3.8 27B?
Hãy tính theo dung lượng tệp của mức lượng tử hóa bạn chọn cộng thêm 3 đến 6 GB cho KV cache và runtime. Với mức Q4_K_M mặc định, điều đó có nghĩa là cần 24 GB VRAM trên GPU hoặc một máy Mac 32 GB.
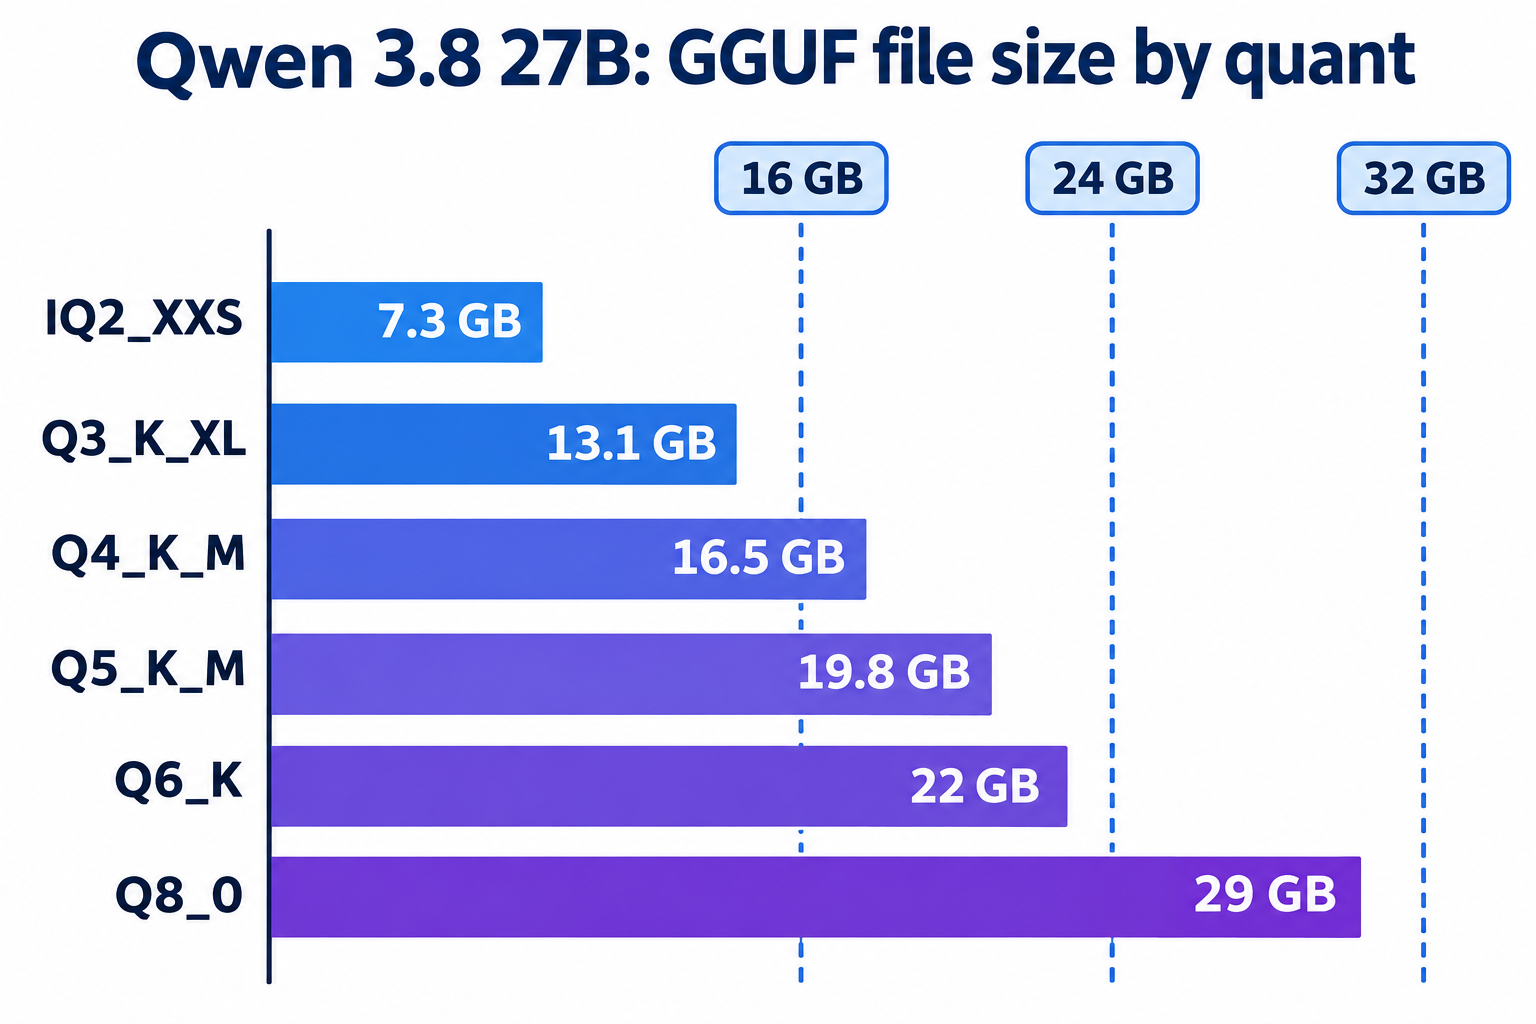
Dưới đây là kích thước tệp GGUF từ kho lượng tử hóa của unsloth, kiểm tra ngày 9 tháng 11 năm 2026:
| Lượng tử hóa | Kích thước tệp | Phần cứng thực tế |
|---|---|---|
| UD-IQ2_XXS | 7,27 GB | Mac 16 GB hoặc GPU 12 GB, chất lượng giảm đáng kể |
| UD-Q3_K_XL | 13,1 GB | GPU 16 GB, Mac 24 GB |
| UD-Q4_K_M | 16,5 GB | GPU 24 GB, Mac 32 GB (lựa chọn tối ưu) |
| UD-Q5_K_M | 19,8 GB | GPU 24 GB với ngữ cảnh ngắn, Mac 32 GB |
| UD-Q6_K | 22 GB | GPU 32 GB, Mac 48 GB |
| Q8_0 | 29 GB | GPU 48 GB, Mac 64 GB |
Bộ chiếu thị giác (mmproj-F16.gguf) bổ sung thêm 928 MB nếu bạn muốn nhập hình ảnh. Thẻ qwen3.8:27b mặc định của Ollama nặng 18 GB vì nó đi kèm khả năng thị giác.
Độ dài ngữ cảnh là chi phí ẩn. Tính toán quy hoạch của llm-speed ước tính Q4_K_M cần khoảng 21,9 GB với ngữ cảnh 32.000 token. Đó là lý do thẻ 24 GB là mức tối thiểu thực tế cho Q4, và vì sao bạn không nên tải toàn bộ cửa sổ 262K trừ khi bạn có dư bộ nhớ.
Trên máy Mac, lưu ý rằng macOS giữ lại một phần bộ nhớ hợp nhất cho hệ thống. Một máy Mac 24 GB về mặt kỹ thuật có thể tải Q4_K_M, nhưng bạn sẽ gần như không còn dung lượng cho ngữ cảnh hay trình duyệt. Ở cấu hình này, chúng tôi khuyên dùng Q3_K_XL.
Tốc độ của Qwen 3.8 27B khi chạy tại chỗ như thế nào?
Khoảng 38 đến 44 token mỗi giây trên RTX 3090 hoặc 4090 ở mức Q4_K_M với llama.cpp, và 65 đến 75 trên RTX 5090. Một Mac Studio với M3 Ultra giải mã khoảng 25 đến 27 token mỗi giây.
Chúng tôi không tự thực hiện benchmark. Đây là các phép đo được llm-speed công bố, kèm theo phần cứng và runtime họ đã nêu:
| Phần cứng | Lượng tử hóa / runtime | Giải mã tok/s | Prefill tok/s |
|---|---|---|---|
| RTX 3090 24 GB | Q4_K_M, llama.cpp | 38,6 (chat ngắn, ngữ cảnh 4K) | 482 |
| RTX 4090 24 GB | Q4_K_M, llama.cpp | 43,4 (chat ngắn, ngữ cảnh 4K) | 448 |
| RTX 5090 32 GB | Q4_K_M, llama.cpp | 75,2 (chat ngắn, ngữ cảnh 4K) | 563 |
| L40S 45 GB | Q4_K_M, llama.cpp | 34,3 (chat ngắn) | 569 |
| M3 Ultra 96 GB | Q4_K_M, llama.cpp | 25,2 (chat ngắn) | 45 |
| M3 Ultra 96 GB | 4-bit, MLX 0.31.3 | 27,3 (chat ngắn) | 12 |
Tốc độ giải mã hầu như không giảm khi ngữ cảnh tăng trên GPU: con 4090 vẫn đạt 39,0 tok/s sau một prompt 33.131 token. Prefill mới là điểm yếu của máy Mac. Với một prompt 11.827 token, M3 Ultra xử lý khoảng 283 tok/s, trong khi 4090 đạt khoảng 2.000 đến 3.000 tok/s, nên một codebase lớn có thể mất hàng chục giây trước khi token đầu tiên xuất hiện.
Chế độ suy luận cũng ngốn ngân sách thời gian của bạn. Khi Simon Willison yêu cầu một bản Qwen 3.8 27B cục bộ nhận diện trò chơi từ trọng số mô hình thô, một câu trả lời mất tới 46 phút và 43.506 token suy luận. Với các tác vụ hằng ngày, hãy hạ reasoning_effort xuống low hoặc tắt hẳn chế độ suy luận.
Chạy Qwen 3.8 27B với Ollama
Ollama là con đường nhanh nhất trên mọi hệ điều hành. Cài đặt từ ollama.com, sau đó:
ollama pull qwen3.8:27b
ollama run qwen3.8:27b
Trên Apple Silicon, hãy thử thẻ qwen3.8:27b-mlx, sử dụng backend MLX với cùng dung lượng 18 GB.
Ngữ cảnh mặc định của Ollama khá nhỏ, điều này làm hỏng các phiên agent dài. Hãy tăng nó trước khi khởi động server:
OLLAMA_CONTEXT_LENGTH=32768 ollama serve
Ollama cũng cung cấp một API tương thích OpenAI tại http://localhost:11434/v1, nên bất kỳ OpenAI SDK nào cũng hoạt động chỉ bằng cách thay đổi base URL:
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8:27b",
       "messages": [{"role": "user", "content": "Write a Python function that validates an email address."}]}'
Muốn dùng nó trong một agent lập trình? Ollama có sẵn các phím tắt khởi chạy: ollama launch claude --model qwen3.8 khởi chạy Claude Code với mô hình cục bộ, và ollama launch opencode --model qwen3.8 làm điều tương tự cho OpenCode.
Chạy với LM Studio
LM Studio là lựa chọn nếu bạn muốn giao diện đồ họa và cài đặt tải riêng cho từng mô hình. Tìm kiếm Qwen 3.8 27B, tải xuống bản dựng lmstudio-community/Qwen3.8-27B-GGUF ở mức Q4_K_M (16,8 GB) và tải mô hình.
Một cài đặt rất quan trọng: hãy tăng độ dài ngữ cảnh khi tải mô hình. Simon Willison phát hiện ngữ cảnh mặc định 8.192 token gặp lỗi với prompt dài của anh ấy và buộc phải tải cửa sổ ngữ cảnh lớn hơn.
Sau đó mở tab Developer và khởi động server cục bộ, hoặc chạy lms server start từ terminal. Endpoint tương thích OpenAI nằm tại http://localhost:1234/v1.
Chạy với llama.cpp
llama.cpp mang lại cho bạn khả năng kiểm soát nhiều nhất và là nền tảng cho hầu hết các lần đo benchmark ở trên. Trên macOS hoặc Linux:
brew install llama.cpp

llama-server -hf unsloth/Qwen3.8-27B-GGUF:UD-Q4_K_M \
  --jinja -c 32768 -ngl 99 \
  --temp 1.0 --top-p 0.95 --top-k 20 \
  --port 8080
-hf tải mức lượng tử hóa trực tiếp từ Hugging Face, --jinja áp dụng chat template của mô hình (cần cho gọi công cụ và suy luận), -c đặt ngữ cảnh và -ngl 99 đặt toàn bộ các lớp lên GPU. Các giá trị sampling là khuyến nghị của Qwen cho chế độ suy luận. Với chế độ không suy luận, thẻ mô hình đề xuất temperature 0,7, top_p 0,8, top_k 20 và presence_penalty 1,5.
Để tắt suy luận cho một yêu cầu cụ thể, hãy gửi "chat_template_kwargs": {"enable_thinking": false} trong phần thân.
Chạy với MLX trên máy Mac
MLX là framework mảng của riêng Apple và thường là runtime nhanh nhất trên Apple Silicon cho giải mã. Cài đặt mlx-lm và sử dụng bản chuyển đổi 4-bit của mlx-community:
pip install mlx-lm

mlx_lm.generate --model mlx-community/Qwen3.8-27B-4bit \
  --prompt "Explain the difference between a mutex and a semaphore." \
  --max-tokens 1024

mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8080
mlx_lm.server cung cấp route /v1/chat/completions tương thích OpenAI. Tổ chức mlx-community cũng phát hành các biến thể 8-bit, mxfp4 và MTP nếu bạn muốn đánh đổi bộ nhớ lấy chất lượng hoặc tốc độ.
Để agent lập trình của bạn kiểm tra endpoint cục bộ bằng Apidog CLI
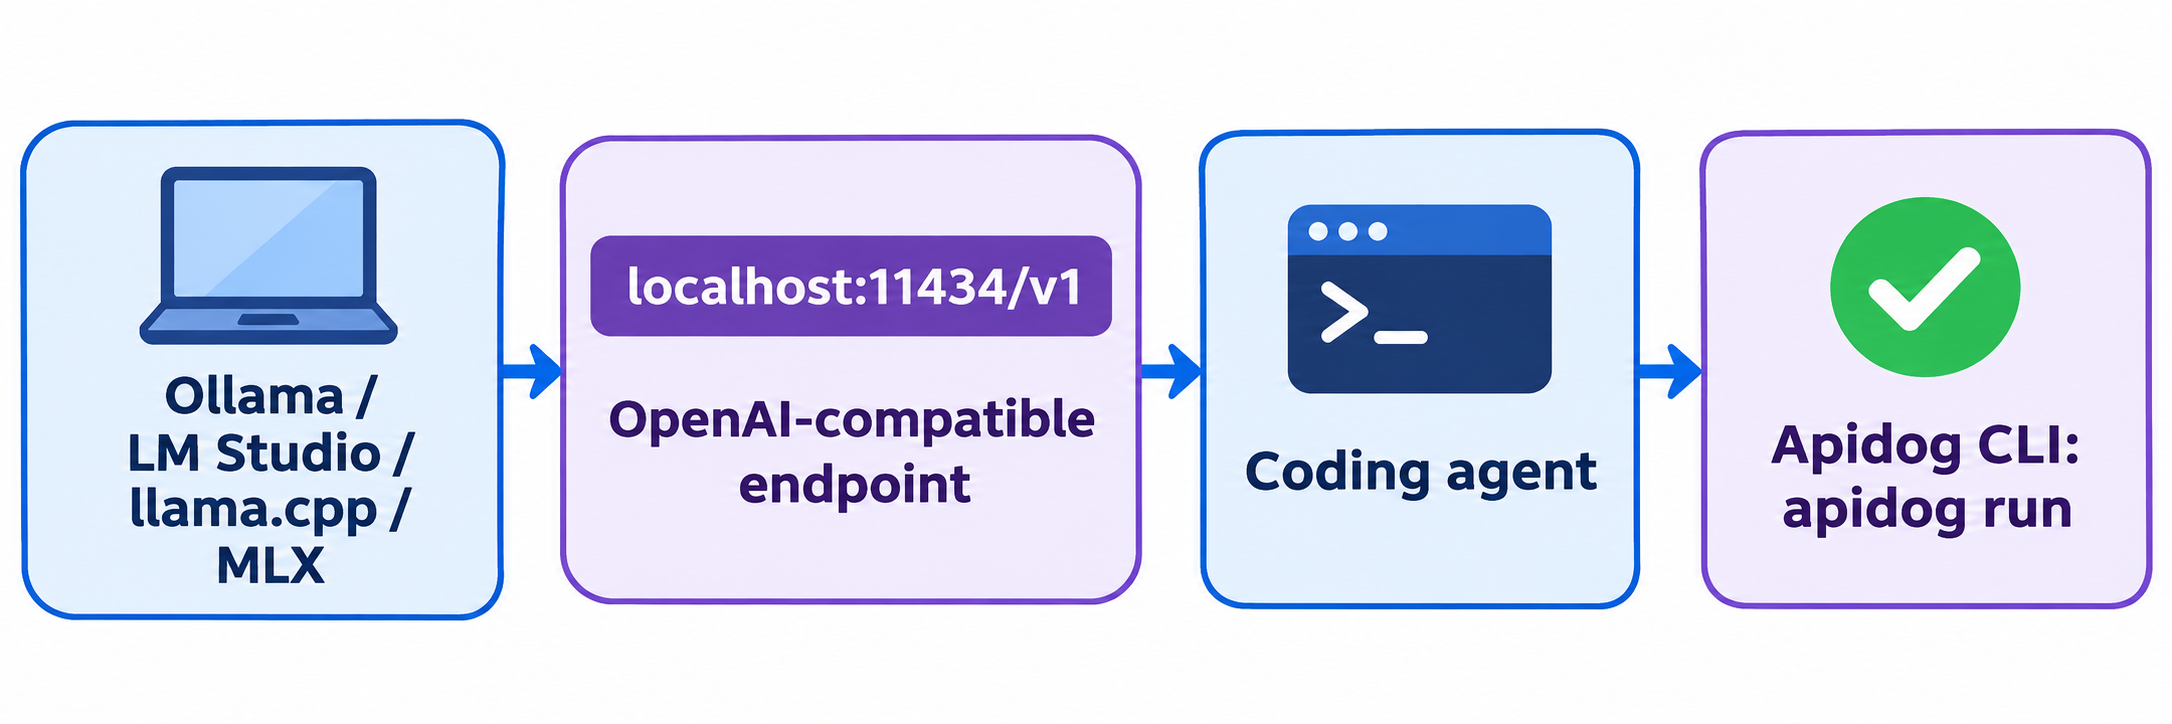
Mỗi công cụ chạy mô hình đều phục vụ cùng một cấu trúc tương thích OpenAI, nhưng mỗi cái lại xử lý khối suy luận, gọi công cụ và timeout khác nhau. Trước khi trỏ ứng dụng của bạn vào localhost, hãy để agent lập trình xây dựng một bộ kiểm tra có thể lặp lại với Apidog CLI, để lỗi template hoặc giới hạn ngữ cảnh hiện ra trong vài giây thay vì giữa chừng khi đang làm việc.
Cài đặt một lần:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Sau đó đưa cho Claude Code, Codex hoặc Cursor một prompt duy nhất:
In Apidog project <projectId>, create an environment "qwen-local" with base URL
http://localhost:11434/v1. Add a POST /chat/completions endpoint for model
qwen3.8:27b, then a test case that asserts status 200, a non-empty
choices[0].message.content, usage.completion_tokens > 0, and a second request
with a tools array that returns a tool_calls entry. Run it and summarize failures.
Agent sẽ đọc schema của từng payload, xác thực JSON, tạo các tài nguyên và chạy bộ kiểm tra:
apidog environment create qwen-local --project <projectId> --base-url http://localhost:11434/v1
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json --timeout-request 300000
Tham số --timeout-request dài rất quan trọng ở đây: một mô hình 27B ở chế độ suy luận có thể mất vài phút trên máy Mac. Đổi base URL sang http://localhost:1234/v1 hoặc :8080/v1 và cùng bộ kiểm tra đó sẽ kiểm tra được LM Studio, llama.cpp hoặc MLX. Để biết thêm các thiết lập agent, xem Apidog CLI trong Claude Code và tài liệu tham khảo lệnh apidog run. Gói Free của Apidog hỗ trợ tối đa 4 người dùng.
Chạy tại chỗ so với API Qwen 3.8-hosted
Chạy tại chỗ giữ mọi prompt trên máy của bạn, hoạt động ngoại tuyến và không tốn chi phí theo token. Đổi lại là tốc độ và khả năng mở rộng: một endpoint hosted phục vụ phiên bản lớn hơn nhiều Qwen 3.8-Max với ngữ cảnh 1M và không phải chờ prefill. Nếu bạn cần bản flagship, hãy đọc hướng dẫn Qwen 3.8 API của chúng tôi hoặc các cách truy cập miễn phí. Với lập trình agentic trên cả hai kích thước, Qwen 3.8 cho lập trình so sánh các thiết lập harness.
Câu hỏi thường gặp
Qwen 3.8 27B có miễn phí khi chạy tại chỗ không? Có. Trọng số được phát hành theo Apache-2.0 trên Hugging Face, và Ollama, LM Studio, llama.cpp cùng MLX đều miễn phí. Bạn chỉ trả tiền cho phần cứng và điện năng.
Có thể chạy Qwen 3.8 27B trên máy Mac 16 GB không? Chỉ ở các mức lượng tử hóa 2-bit như UD-IQ2_XXS (7,27 GB) với ngữ cảnh ngắn, và chất lượng giảm rõ rệt. Một máy Mac 32 GB chạy Q4_K_M là thiết lập thoải mái.
Qwen 3.8 27B có chạy được trên RTX 3090 không? Có. Q4_K_M vừa với 24 GB và còn chỗ cho ngữ cảnh 16K đến 32K, và llm-speed đo được khoảng 38 token mỗi giây trên llama.cpp.
Làm thế nào để tắt chế độ suy luận? Gửi "chat_template_kwargs": {"enable_thinking": false} trên llama.cpp hoặc vLLM, hoặc hạ reasoning_effort xuống low. Qwen khuyến nghị temperature 0,7 và top_p 0,8 cho chế độ không suy luận.
Mô hình cục bộ có hỗ trợ hình ảnh không? Có. Thẻ 18 GB của Ollama đã bao gồm khả năng thị giác. Với llama.cpp, hãy tải tệp mmproj-F16.gguf cùng với mô hình.
Sự khác biệt giữa Qwen 3.8 27B và Qwen 3.8-Max là gì? Max là bản flagship mixture-of-experts với 2,4 nghìn tỷ tham số, được phục vụ qua API của Alibaba. 27B là mô hình dense nhỏ đủ để nằm trên một GPU hoặc một máy Mac 32 GB.